

En la actualidad, existen soluciones listas (propietarias) para el monitoreo de flujos IP(TS), como por ejemplo y , que cuentan con un conjunto bastante completo de funciones y, por lo general, dichas soluciones están disponibles para grandes operadores que trabajan con servicios de TV. Este artículo describe una solución basada en el proyecto de código abierto , diseñado para el control mínimo de los flujos IP(TS) mediante el contador de continuidad (CC) y el bitrate. Una posible aplicación es el monitoreo de la pérdida de paquetes o del flujo completo a través de un canal L2 arrendado (el cual no se puede monitorear adecuadamente, por ejemplo, mediante la lectura de los contadores de pérdida en las colas).
Una breve introducción a TSDuck
TSDuck es un software de código abierto (licencia 2-Clause BSD) que consiste en un conjunto de utilidades de consola y una biblioteca para desarrollar sus propias utilidades o complementos para manipulaciones de flujos TS. En la entrada, puede trabajar con IP (multicast/unicast), http, hls, sintonizadores dvb, demodulador dektec dvb-asi, cuenta con un generador interno de flujo TS y lectura desde archivos. En la salida, puede grabar en un archivo, IP (multicast/unicast), hls, moduladores dektec dvb-asi y HiDes, reproductores (mplayer, vlc, xine) y drop. Entre la entrada y la salida, se pueden incluir varios procesadores de tráfico, como remapeo de PID, realizar scrambling/descrambling, análisis de contadores CC, conteo de bitrate y otras operaciones típicas para flujos TS.
En este artículo, se utilizarán flujos IP (multicast) como entrada y se emplearán los procesadores bitrate_monitor (de su nombre es evidente qué se trata) y continuity (análisis de los contadores CC). Sin problemas, se puede reemplazar IP multicast por otro tipo de entrada soportada por TSDuck.
Existen de TSDuck para la mayoría de los sistemas operativos actuales. Para Debian no hay, pero se logró compilar sin problemas en debian 8 y debian 10.
A continuación, se utiliza la versión TSDuck 3.19-1520, siendo Linux el sistema operativo empleado (para la preparación de la solución se usó debian 10, para el uso real — CentOS 7)
Preparación de TSDuck y el sistema operativo
Antes de monitorear flujos reales, es necesario asegurarse de que TSDuck funcione correctamente y que no haya pérdidas a nivel de la tarjeta de red o del sistema operativo (socket). Esto es necesario para no tener que adivinar dónde ocurrieron las pérdidas: en la red o "dentro del servidor". Para verificar las pérdidas a nivel de la tarjeta de red, se puede utilizar el comando ethtool -S ethX, la optimización se realiza con el mismo ethtool (generalmente, es necesario aumentar el buffer RX (-G) y, a veces, desactivar algunos offloads (-K)). Como recomendación general, se sugiere utilizar un puerto separado para recibir el tráfico analizado, si es posible, esto minimiza las falsas alarmas relacionadas con pérdidas que ocurren concretamente en el puerto del analizador debido a la existencia de otro tráfico. Si no hay tal posibilidad (se utiliza un mini-computador/NUC con un solo puerto), es muy recomendable configurar la priorización del tráfico analizado en relación con el resto del dispositivo al que está conectado el analizador. En lo que respecta a entornos virtuales, se debe tener precaución y saber encontrar las pérdidas de paquetes desde el puerto físico hasta la aplicación dentro de la máquina virtual.
Generación y recepción de flujo dentro del host
Como primer paso en la preparación de TSDuck, generaremos y recibiremos tráfico dentro de un único host utilizando netns.
Preparando el entorno:
ip netns add P #creamos netns P, donde se analizará el tráfico
ip link add type veth #creamos un par veth - veth0 se deja en netns por defecto (en esta interfaz se generará tráfico)
ip link set dev veth1 netns P #veth1 - se coloca en netns P (en esta interfaz se recibirá tráfico)
ip netns exec P ifconfig veth1 192.0.2.1/30 up #levantamos IP en veth1, no importa cuál sea
ip netns exec P ip ro add default via 192.0.2.2 #configuramos la ruta por defecto dentro de netns P
sysctl net.ipv6.conf.veth0.disable_ipv6=1 #desactivamos IPv6 en veth0 - esto se hace para que en el contador TX no entre basura ajena
ifconfig veth0 up #levantamos la interfaz veth0
ip route add 239.0.0.1 dev veth0 #creamos una ruta para que el sistema operativo dirija el tráfico hacia 239.0.0.1 a través de veth0
El entorno está listo. Iniciamos el analizador de tráfico:
ip netns exec P tsp --realtime -t
 -I ip 239.0.0.1:1234
 -P continuity
 -P bitrate_monitor -p 1 -t 1
 -O drop
donde "-p 1 -t 1" significa que se debe calcular la tasa de bits cada segundo y mostrar información sobre la tasa de bits cada segundo
Iniciamos el generador de tráfico a una velocidad de 10Mb/s:
tsp -I craft
 -P regulate -b 10000000
 -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
donde «-p 7 -e» significa que se deben empaquetar 7 paquetes TS en 1 paquete IP y hacerlo de forma estricta (-e), es decir, siempre esperar 7 paquetes TS del último procesador antes de enviar la formación del paquete IP.
El analizador comienza a mostrar los mensajes esperados:
* 2020/01/03 14:55:44 - bitrate_monitor: 2020/01/03 14:55:44, tasa de bits TS: 9,970,016 bits/s
* 2020/01/03 14:55:45 - bitrate_monitor: 2020/01/03 14:55:45, tasa de bits TS: 10,022,656 bits/s
* 2020/01/03 14:55:46 - bitrate_monitor: 2020/01/03 14:55:46, tasa de bits TS: 9,980,544 bits/s
Ahora agregamos un poco de pérdidas:
ip netns exec P iptables -I INPUT -d 239.0.0.1 -m statistic --mode random --probability 0.001 -j DROPy aparecen mensajes de este tipo:
* 2020/01/03 14:57:11 - continuity: índice de paquete: 80,745, PID: 0x0000, faltan 7 paquetes
* 2020/01/03 14:57:11 - continuity: índice de paquete: 83,342, PID: 0x0000, faltan 7 paquetes
lo cual es esperado. Desactivamos la pérdida de paquetes (ip netns exec P iptables -F) y tratamos de aumentar la tasa de bits del generador a 100Mbit/s. El analizador informa un montón de errores CC y alrededor de 75 Mbit/s en lugar de 100. Intentamos averiguar quién es el culpable: si el generador no es capaz o si el problema no está en él, para esto ejecutamos la generación de una cantidad fija de paquetes (700000 paquetes TS = 100000 paquetes IP):
# ifconfig veth0 | grep TX
       TX packets 151825460  bytes 205725459268 (191.5 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
# tsp -I craft -c 700000 -P regulate -b 100000000 -P count -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
* count: PID    0 (0x0000):    700,000 packets
# ifconfig veth0 | grep TX
        TX packets 151925460  bytes 205861259268 (191.7 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
Como se puede ver, se generaron exactamente 100000 paquetes IP (151925460-151825460). Entonces investigamos qué está pasando con el analizador, para esto comparamos con el contador RX en veth1, que es estrictamente igual al contador TX en veth0, luego observamos lo que sucede a nivel de socket:
# ip netns exec P cat /proc/net/udp
  sl  local_address rem_address   st tx_queue rx_queue tr tm->when retrnsmt   uid  timeout inode ref pointer drops
  133: 010000EF:04D2 00000000:0000 07 00000000:00000000 00:00000000 00000000     0        0 72338 2 00000000e0a441df 24355
Aquí se puede ver la cantidad de pérdidas = 24355. En paquetes TS esto es 170485 o 24.36% de 700000, así que vemos que esos 25% de pérdida de tasa de bits son pérdidas en el socket UDP. Las pérdidas en el socket UDP suelen ocurrir por falta de memoria buffer, observamos cuál es el tamaño del buffer del socket por defecto y el tamaño máximo del buffer del socket:
# sysctl net.core.rmem_default
net.core.rmem_default = 212992
# sysctl net.core.rmem_max
net.core.rmem_max = 212992
Por lo tanto, si las aplicaciones no solicitan el tamaño del buffer explícitamente, los sockets se crean con un buffer de tamaño 208 KB, pero si piden más, de todos modos no obtendrán lo solicitado. Dado que en tsp para la entrada IP se puede establecer el tamaño del buffer (—buffer-size), no tocaremos el tamaño del socket por defecto, sino que solo estableceremos el tamaño máximo del socket y especificaremos el tamaño del buffer explícitamente a través de los argumentos de tsp:
sysctl net.core.rmem_max=8388608
ip netns exec P tsp --realtime -t -I ip 239.0.0.1:1234 -b 8388608 -P continuity -P bitrate_monitor -p 1 -t 1 -O drop
Con esta configuración del buffer del socket, la tasa de bits reportada ahora es aproximadamente 100Mbit/s, sin errores CC.
Por el consumo de CPU de la propia aplicación tsp. En relación con un núcleo i5-4260U CPU @ 1.40GHz, para analizar un flujo de 10 Mbps se requerirán entre el 3-4% de CPU, 100 Mbps — 25%, 200 Mbps — 46%. Al establecer el % de pérdida de paquetes, la carga en el CPU prácticamente no aumenta (pero puede disminuir).
En hardware más potente, se pudo generar y analizar flujos de más de 1 Gbps sin problemas.
Pruebas en tarjetas de red reales
Después de las pruebas en un par de veth, es necesario tomar dos hosts o dos puertos de un mismo host, conectar los puertos entre sí, en uno ejecutar el generador y en el otro el analizador. Aquí no hubo sorpresas, pero en realidad todo depende del hardware; cuanto más débil, más interesante será la situación.
Uso de los datos obtenidos por el sistema de monitoreo (Zabbix)
Tsp no tiene ninguna API legible por máquina tipo SNMP o similar. Los mensajes de CC deben agregarse al menos cada 1 segundo (con un alto porcentaje de pérdida de paquetes, pueden haber cientos/miles/decenas de miles por segundo, dependiendo de la tasa de bits).
Por lo tanto, para guardar tanto la información como dibujar gráficos de errores de CC y tasa de bits, y tratar algún tipo de fallos, las siguientes opciones podrían ser:
- Analizar y agregar (por CC) la salida de tsp, es decir, convertirla en el formato necesario.
- Modificar el mismo tsp y/o los plugins de procesamiento bitrate_monitor y continuity, para que el resultado se entregue en un formato legible por máquina, adecuado para el sistema de monitoreo.
- Escribir su propia aplicación sobre la biblioteca tsduck.
Es evidente que, en términos de esfuerzo, la opción 1 es la más sencilla, especialmente considerando que el mismo tsduck está escrito en un lenguaje de bajo nivel (según los estándares modernos) (C++).
Un simple prototipo de analizador + agregador en bash mostró que, en un flujo de 10 Mbps y 50% de pérdida de paquetes (el peor escenario), el proceso de bash consumía de 3 a 4 veces más CPU que el propio proceso tsp. Esta variante de desarrollo no es aceptable. A continuación, un fragmento de este prototipo.
Fideos en bash
#!/usr/bin/env bash

missingPackets=0
ccErrorSeconds=0
regexMissPackets='^* (.+) - continuity:.*missing ([0-9]+) packets$'
missingPacketsTime=""

ip netns exec P tsp --realtime -t -I ip -b 8388608 "239.0.0.1:1234" -O drop -P bitrate_monitor -p 1 -t 1  -P continuity 2>&1 |
while read i
do
    #line example:* 2019/12/28 23:41:14 - continuity: packet index: 6,078, PID: 0x0100, missing 5 packets
    #line example 2: * 2019/12/28 23:55:11 - bitrate_monitor: 2019/12/28 23:55:11, TS bitrate: 4,272,864 bits/s
    if [[ "$i" == *continuity:* ]]
    then
        if [[ "$i" =~ $regexMissPackets ]]
        then
            missingPacketsTimeNew="${BASH_REMATCH[1]}" #timestamp (seconds)
            if [[ "$missingPacketsTime" != "$missingPacketsTimeNew" ]] #new second with CC error
            then
                ((ccErrorSeconds += 1))
            fi
            missingPacketsTime=$missingPacketsTimeNew
            packets=${BASH_REMATCH[2]} #TS missing packets
            ((missingPackets += packets))
        fi
    elif [[ "$i" == *bitrate_monitor:* ]]
    then
        : #...
    fi
done
Además de que funciona de manera inaceptablemente lenta, bash carece de buenos hilos, los trabajos en bash son procesos independientes y se tuvo que hacer un registro cada segundo del valor missingPackets en el efecto secundario (al recibir el mensaje de bitrate, que llega cada segundo). Como resultado, bash fue dejado de lado y se decidió escribir un wrapper (parser + agregador) en golang. El consumo de CPU del código equivalente en golang es de 4 a 5 veces menor que el del propio proceso tsp. La aceleración del wrapper al reemplazar bash por golang fue aproximadamente de 16 veces y en general el resultado es aceptable (sobrecarga de CPU del 25% en el peor de los casos). El archivo fuente en golang se encuentra .
Iniciar el wrapper
Para iniciar el wrapper, se creó una plantilla de servicio muy básica para systemd (). Se supone que el wrapper mismo está compilado en un archivo binario (go build tsduck-stat.go), ubicado en /opt/tsduck-stat/. Se asume que se utiliza golang con soporte para monotonic clock (>=1.9).
Para crear una instancia del servicio, hay que ejecutar el comando systemctl enable tsduck-stat@239.0.0.1:1234, y luego iniciar con systemctl start tsduck-stat@239.0.0.1:1234.
Discovery desde Zabbix
Para que Zabbix pueda hacer el descubrimiento de servicios en ejecución, se creó un (discovery.sh), en un formato necesario para el descubrimiento de Zabbix, se supone que está ubicado allí mismo — en /opt/tsduck-stat. Para ejecutar el descubrimiento a través del zabbix-agent, es necesario agregar en el directorio de configuraciones del zabbix-agent para agregar el parámetro del usuario.
Plantilla de Zabbix
(tsduck_stat_template.xml) contiene la regla de auto-descubrimiento, prototipos de elementos de datos, gráficos y triggers.
Lista de verificación breve (por si alguien decide aprovecharse)
- Asegurarse de que tsp no esté perdiendo paquetes en condiciones "ideales" (el generador y el analizador están conectados directamente), si hay pérdidas, ver p.2 o el texto del artículo al respecto.
- Realizar el ajuste del tamaño máximo del buffer del socket (net.core.rmem_max=8388608).
- Compilar tsduck-stat.go (go build tsduck-stat.go).
- Colocar la plantilla del servicio en /lib/systemd/system.
- Iniciar los servicios con systemctl, verificar que comiencen a aparecer contadores (grep "" /dev/shm/tsduck-stat/*). La cantidad de servicios corresponde al número de flujos multicast. Aquí puede ser necesario crear una ruta hacia el grupo multicast, posiblemente desactivar rp_filter o crear una ruta hacia la IP de origen.
- Ejecutar discovery.sh, asegurarse de que genera json.
- Colocar la configuración del zabbix-agent, reiniciar el zabbix-agent.
- Sube la plantilla a Zabbix, aplícala al host que está siendo monitoreado y donde está instalado el zabbix-agent, espera unos 5 minutos y verifica que hayan aparecido nuevos elementos de datos, gráficos y disparadores.
Resultado
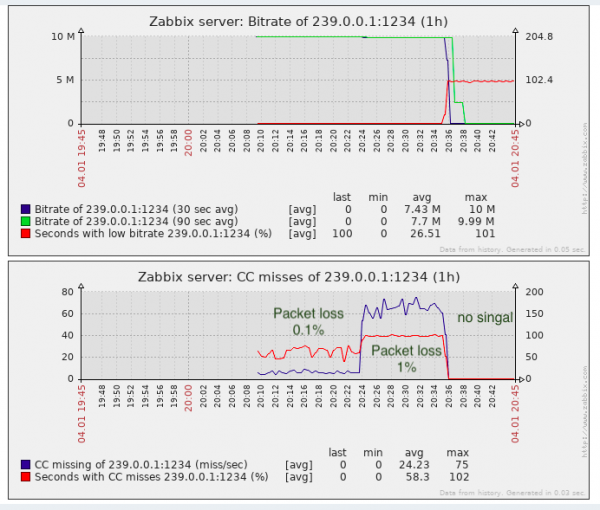
Para la tarea de detección de pérdida de paquetes, casi es suficiente; en realidad, es mejor que no tener monitoreo.
De hecho, las CC de "pérdidas" pueden ocurrir al unir fragmentos de video (hasta donde sé, así se realizan los insertos en los centros de televisión locales en Rusia, es decir, sin recalcular el contador CC), esto hay que tenerlo en cuenta. En soluciones propietarias, este problema se elude parcialmente al detectar etiquetas SCTE-35 (si son añadidas por el generador de flujo).
Desde el punto de vista del monitoreo de calidad de transporte, falta el monitoreo de jitter (IAT), ya que el equipo de TV (ya sean moduladores o dispositivos finales) tiene requisitos para este parámetro y no siempre se puede expandir el jitbuffer indefinidamente. Además, el jitter puede variar cuando en el tránsito se usa equipo con grandes búferes y no se tiene una QoS adecuada o no suficientemente bien configurada para el tráfico en tiempo real similar.
Fuente: habr.com
