

Estoy seguro de que el título ha provocado una reacción saludable: "¡de nuevo esto de nuevo...!" Pero permítanme captar su atención durante 5-10 minutos y trataré de no decepcionarlos.
La estructura del artículo será la siguiente: se tomará una afirmación estereotipada y se revelará la "naturaleza" del origen de este estereotipo. Espero que esto permita ver la elección de la paradigma de intercambio de datos en sus proyectos desde una nueva perspectiva.
Para aclarar qué es RPC, propongo considerar el estándar . Con REST no hay claridad. Y no debería haber. Lo único que se necesita saber sobre REST es que es indistinguible de .
Las solicitudes RPC son más rápidas y eficientes porque permiten realizar solicitudes por lotes.
Se trata de que en RPC se puede invocar varias funciones en una sola solicitud. Por ejemplo, crear un usuario, agregarle un avatar y suscribirlo a algunos temas en la misma solicitud. ¡Una sola solicitud y cuántos beneficios!
De hecho, si solo tienes un nodo de backend, parecerá más rápido con una solicitud por lotes. Porque tres solicitudes REST requerirán tres veces más recursos de un nodo para establecer conexiones.
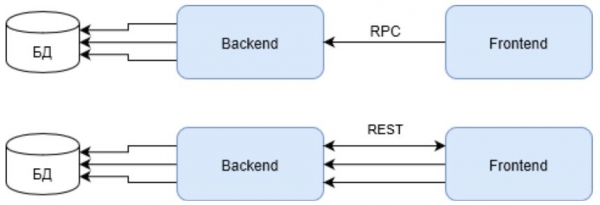
Ten en cuenta que la primera solicitud en el caso de REST debe devolver la identificación del usuario para realizar las solicitudes posteriores. Esto también afecta negativamente al resultado general.
Pero tales infraestructuras solo se pueden encontrar, en la mejor de las situaciones, en soluciones internas y empresarial. En el peor de los casos, en pequeños proyectos WEB. Sin embargo, no es recomendable construir soluciones WEB completas, y aún así denominadas HighLoad, de esa manera. Su infraestructura debe cumplir con los criterios de alta disponibilidad y carga. Y la situación cambia.
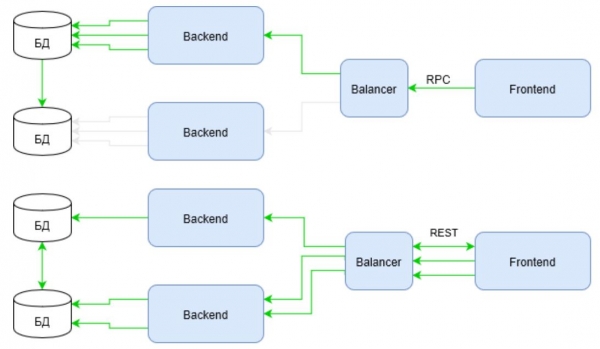
Los canales de actividad de la infraestructura se marcan en verde en el mismo escenario. Observa cómo se comporta RPC ahora. La solicitud utiliza la infraestructura solo por un lado del balanceador hacia el backend. Mientras que REST sigue perdiendo en la primera solicitud, pero recupera el tiempo perdido utilizando toda la infraestructura.
Basta con introducir en el escenario no dos solicitudes para el enriquecimiento, sino, digamos, cinco o diez... y la respuesta a la pregunta "¿quién gana ahora?" se vuelve poco clara.
Les propongo mirar el problema desde una perspectiva más amplia. En el diagrama se puede ver cómo se utilizan los canales de infraestructura, pero la infraestructura no se limita a los canales. Un componente importante de la infraestructura de alta carga son las cachés. Ahora obtengamos algún artefacto del usuario. Varias veces. Digamos 32 veces.
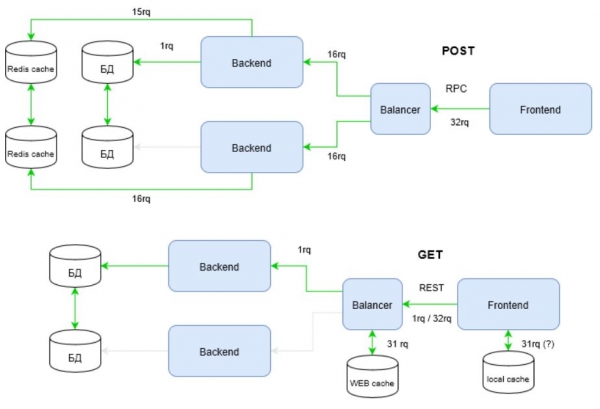
Observad cómo ha mejorado notablemente la infraestructura en RPC para atender las demandas de alta carga. La cuestión es que REST utiliza todo el poder del protocolo HTTP, a diferencia de RPC. En el diagrama presentado, este poder se manifiesta a través del método de solicitud: GET.
Los métodos HTTP, entre otras cosas, tienen estrategias de caché. Pueden consultarse en la documentación en . Para RPC se utilizan solicitudes POST, que no se consideran idempotentes, es decir, repetir varias veces las mismas solicitudes POST puede traer diferentes resultados (por ejemplo, después de cada envío de un comentario, se generará una nueva copia de ese comentario) ().
Por lo tanto, RPC no puede utilizar eficientemente las cachés de infraestructura. Esto lleva a que deban “importarse” cachés de software. En el diagrama, Redis se presenta en este rol. A su vez, la caché de software requiere de un código adicional por parte del desarrollador y cambios significativos en la arquitectura.
Ahora contemos cuántas solicitudes generó REST y RPC en la infraestructura analizada.
Consultas
Entrantes
al backend
a la base de datos
a la caché de software (Redis)
TOTAL
REST
1/32*
1
1
0
3 / 35
RPC
32
32
1
31
96
[*] en el mejor de los casos (si se utiliza la caché local) 1 solicitud (¡uno!), en el peor 32 solicitudes entrantes.
En comparación con el primer diagrama, la diferencia es notable. Ahora se hace evidente la ventaja de REST. Pero propongo no detenernos aquí. Una infraestructura avanzada incluye CDN. A menudo también resuelve el problema de contrarrestar los ataques DDoS y DoS. Obtengamos:
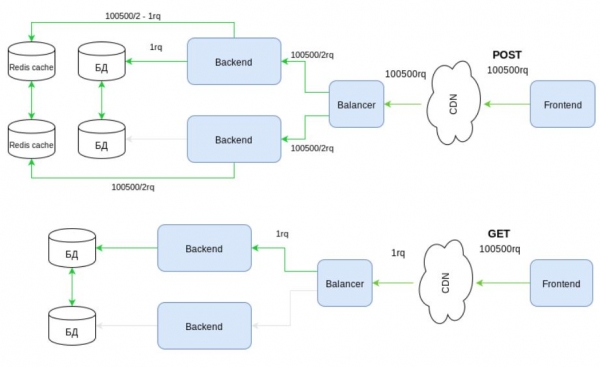
Aquí para RPC todo se vuelve bastante lamentable. RPC simplemente no puede delegar el manejo de la carga al CDN. Solo queda confiar en los sistemas de mitigación de ataques.
¿Se puede terminar con esto? Y de nuevo, no. Los métodos HTTP, como se mencionó anteriormente, tienen su propia "magia". Y no es casualidad que el método GET sea el más utilizado en Internet. Tenga en cuenta que este método puede acceder a partes del contenido, puede establecer condiciones que interpretan los elementos de infraestructura incluso antes de transferir el control a su código, etc. Todo esto permite crear infraestructuras flexibles y manejables, capaces de procesar realmente grandes flujos de solicitudes. Y en RPC, este método... se ignora.
¿Por qué persiste el mito de que las solicitudes por lotes (RPC) son más rápidas? Personalmente, creo que la mayoría de los proyectos simplemente no alcanzan el nivel de desarrollo en el que REST puede demostrar su poder. Además, en proyectos pequeños, es más probable que muestre su debilidad.
La elección entre REST o RPC no es una decisión de voluntad de una sola persona en el proyecto. Esta elección debe ajustarse a los requisitos del proyecto. Si el proyecto puede aprovechar al máximo lo que REST realmente puede ofrecer y eso es realmente necesario, entonces REST será una excelente opción.
Pero si para obtener todos los beneficios de REST se requiere contratar DevOps para escalar la infraestructura de manera rápida, administradores para gestionar la infraestructura, un arquitecto para diseñar todas las capas del servicio WEB... y el proyecto, además, solo vende tres paquetes de margarina al día... yo me quedaría con RPC, ya que este protocolo es más utilitario. No requiere un profundo conocimiento del funcionamiento de cachés e infraestructura, y se enfoca en que el desarrollador realice llamadas simples y claras a los procedimientos que necesita. El negocio estará satisfecho.
Las solicitudes RPC son más confiables porque pueden realizar solicitudes por lotes dentro de una sola transacción.
Esta característica de RPC es sin duda una ventaja, ya que facilita mantener la base de datos en un estado consistente. Con REST, las cosas son más complicadas. Las solicitudes pueden llegar de manera no secuencial a diferentes nodos en el backend.
Este "desventaja" de REST es el reverso de su ventaja mencionada anteriormente: la capacidad de utilizar eficientemente todos los recursos de la infraestructura. Si la infraestructura está mal diseñada, y mucho más, si la arquitectura del proyecto y de la base de datos en particular están mal diseñadas, entonces esto realmente se convierte en un gran problema.
¿Son realmente confiables las solicitudes batch como parecen? Consideremos un caso: creamos un usuario, enriquecemos su perfil con alguna descripción y le enviamos un SMS con un secreto para completar su registro. Es decir, tres llamadas en una sola solicitud batch.
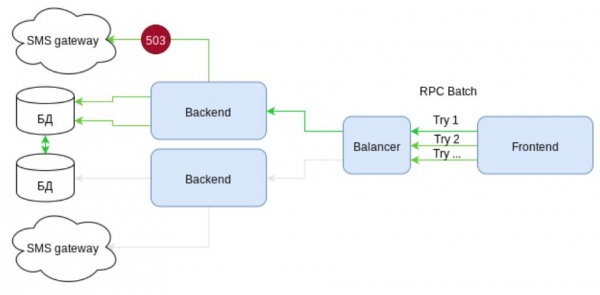
Veamos el esquema. En él se presenta la infraestructura con elementos de alta disponibilidad. Hay dos canales independientes de conexión con las puertas de enlace de SMS. Pero… ¿qué vemos? Al enviar el SMS, se produce un error 503: servicio temporalmente no disponible. Dado que el envío de SMS está empaquetado en una solicitud batch, toda la solicitud debe revertirse. Las acciones en la base de datos son anuladas. El cliente recibe un error.
El siguiente intento es como una lotería. O la solicitud caerá de nuevo en el mismo nodo y volverá a devolver un error, o tendrá suerte y se ejecutará correctamente. Pero lo principal es que, al menos una vez, nuestra infraestructura ya trabajó en vano. Hubo carga, pero no beneficios.
Bien, imaginemos que nos esforzamos (!) y pensamos en una opción donde la solicitud pueda ejecutarse con éxito de forma parcial. Y el resto, intentaremos ejecutarlo nuevamente después de algún intervalo de tiempo (¿Cuál? Lo decide el frontend). Pero la lotería sigue ahí. La solicitud para enviar el SMS, con una probabilidad del 50/50, volverá a fallar.
Estés de acuerdo, desde el punto de vista del cliente, el servicio no parece tan confiable como se desearía... ¿y qué hay de REST?
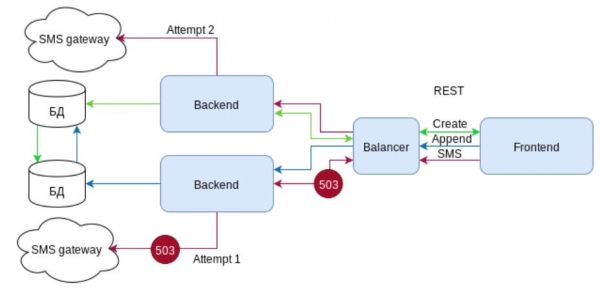
REST nuevamente utiliza la "magia" de HTTP, pero ahora con códigos de respuesta. Al ocurrir un error 503 en la puerta de enlace de SMS, el backend traduce este error al equilibrador de carga. El equilibrador, al recibir este error y sin romper la conexión con el cliente, dirige la solicitud a otro nodo, que procesa la solicitud con éxito. Es decir, el cliente recibe el resultado esperado, y la infraestructura confirma su alto título de "alta disponibilidad". El usuario está feliz.
Y nuevamente, esto no es todo. El equilibrador no solo recibió un código de respuesta 503. Este código, al responder, debe ser idealmente complementado con el encabezado "Retry-After". El encabezado indica al equilibrador que no debe molestar a este nodo por esta ruta durante un tiempo determinado. Y las siguientes solicitudes para enviar SMS se dirigirán inmediatamente al nodo que no tiene problemas con la puerta de enlace de SMS.
Como podemos ver, la confiabilidad de JSON-RPC está sobreestimada. De hecho, es más fácil organizar la consistencia en la base de datos. Pero en tal caso, la confiabilidad del sistema en su conjunto se verá comprometida.
La salida es muy similar a la anterior. Cuando la infraestructura es simple, la claridad de JSON-RPC es, sin duda, una ventaja. Si el proyecto requiere alta disponibilidad con alta carga, REST parece ser una solución más adecuada, aunque también más compleja.
El umbral de entrada para REST es más bajo.
Creo que el análisis anterior, que desacredita los mitos establecidos sobre RPC, demuestra claramente que el umbral de entrada para REST es sin duda más alto que para RPC. Esto está relacionado con la necesidad de una comprensión profunda de cómo funciona HTTP, así como con la necesidad de tener suficientes conocimientos sobre los elementos de infraestructura existentes que se pueden y deben utilizar en proyectos WEB.
Entonces, ¿por qué muchos piensan que REST es más sencillo? Mi opinión personal es que esta aparente simplicidad proviene de los propios manifiestos de REST. Es decir, REST no es un protocolo, sino un concepto... no hay un estándar para REST, solo algunas recomendaciones... REST no es más complicado que HTTP. La aparente libertad y anarquía atrae a los 'artistas libres'.
Sin duda, REST no es más complicado que HTTP. Pero HTTP en sí es un protocolo bien diseñado que ha demostrado su validez durante décadas. Si no hay una comprensión profunda de HTTP, no se puede juzgar sobre REST.
Pero sobre RPC se puede. Solo hay que tomar su especificación. Entonces, ¿necesitas ? Или все же хитрый REST? Решать вам.
Sinceramente, espero no haber perdido su tiempo.
Fuente: habr.com
