

Las nubes son como una caja mágica: pides lo que necesitas y los recursos simplemente aparecen de la nada. Máquinas virtuales, bases de datos, redes: todo esto te pertenece solo a ti. Existen otros inquilinos en la nube, pero en tu universo tú eres el único gobernante. Estás seguro de que siempre obtendrás los recursos requeridos, no cuentas con nadie y decides por ti mismo cómo será la red. ¿Cómo funciona esta magia que hace que la nube asigne recursos de manera elástica y aísle completamente a los inquilinos entre sí?
La nube de AWS es un sistema megasúper complejo que ha estado evolucionando desde 2006. Parte de esta evolución fue Vasili Pantiukhyn — arquitecto de Amazon Web Services. Como arquitecto, ve no solo el resultado final, sino también las complejidades que AWS supera. Cuanto más entiendes cómo funciona el sistema, más confianza tienes. Por eso, Vasili compartirá secretos sobre los servicios de la nube de AWS. Más abajo, la estructura de los servidores físicos de AWS, la escalabilidad elástica de las bases de datos, la base de datos personalizada de Amazon y métodos para aumentar el rendimiento de las máquinas virtuales mientras se reduce su costo. Conocer los enfoques arquitectónicos de Amazon ayudará a utilizar los servicios de AWS de manera más eficaz y, posiblemente, aportará nuevas ideas para construir tus propias soluciones.
Sobre el ponente: Vasili Pantiukhyn () comenzó como administrador de Unix en empresas .ru, pasó 6 años trabajando con grandes equipos de Sun Microsystems y 11 años abogando por un mundo centrado en los datos en EMC. Evolucionó naturalmente hacia nubes privadas y, en 2017, se unió a las públicas. Ahora ayuda a vivir y desarrollarse en la nube de AWS con consejos técnicos.
Descargo de responsabilidad: todo lo que sigue es la opinión personal de Vasili y puede no coincidir con la posición de Amazon Web Services. discurso en el que se basa este artículo está disponible en nuestro canal de YouTube.
Por qué hablo sobre la estructura de Amazon
Mi primer auto era con 'cambio manual' — en una transmisión mecánica. Era genial porque sentía que podía controlar el coche y tenía el control total de él. También me gustaba que al menos entendía aproximadamente cómo funcionaba. Naturalmente, concebía la estructura de la caja de cambios de manera bastante primitiva — más o menos como la de una bicicleta.
Todo fue maravilloso, excepto por una cosa: estar atrapado en el tráfico. Pasas tiempo sentado sin hacer nada, pero constantemente cambias de marcha, presionas el clutch, acelera, frenas; de verdad se cansa uno. El problema del tráfico se solucionó parcialmente cuando en la familia apareció un coche automático. Al volante, ahora tengo tiempo para pensar en algo o escuchar un audiolibro.
También apareció un misterio en mi vida, porque dejé de entender cómo funciona mi coche. Un coche moderno es un dispositivo complejo. Se adapta simultáneamente a decenas de parámetros diferentes: la presión del acelerador, el freno, el estilo de conducción, la calidad de la carretera. Ya no entiendo cómo funciona.
Cuando empecé a trabajar con la nube de Amazon, para mí también era un secreto. Solo que este secreto es mucho más grande, porque en un coche hay un conductor, y en AWS hay millones. Todos los usuarios maniobran al mismo tiempo, aceleran y frenan. Es sorprendente que lleguen a donde quieren — para mí eso es un milagro. El sistema se adapta automáticamente, se escala y se ajusta de manera elástica a cada usuario, de tal manera que parece que está solo en este universo.
La magia se desvaneció un poco cuando más tarde vine a trabajar como arquitecto en Amazon. Vi los problemas que enfrentamos, cómo los resolvemos, cómo desarrollamos los servicios. A medida que crece la comprensión del funcionamiento del sistema, aumenta la confianza en el servicio. Por eso, quiero compartir la imagen de lo que hay bajo el capó de la nube de AWS.
De qué hablaremos
Elegí un enfoque diversificado — seleccioné 4 servicios interesantes de los que vale la pena hablar.
Optimización de servidores. Nubes efímeras con representación física: centros de datos físicos donde hay servidores físicos que zumban, se calientan y parpadean.
Funciones sin servidor (Lambda) — probablemente, el servicio más escalable en la nube.
Escalabilidad de bases de datos. Hablaré sobre cómo construimos nuestras propias bases de datos escalables.
Escalabilidad de red. La última parte, en la que abriré la estructura de nuestra red. Es una maravilla: cada usuario de la nube siente que está solo en la nube y en realidad no ve a otros inquilinos.
Nota. En este artículo se abordará la optimización de servidores y el escalado de bases de datos. El escalado de la red se tratará en el próximo artículo. ¿Dónde están las funciones serverless? Acerca de esto se publicó una transcripción separada «». En ella se comentan varios métodos de escalado y se detalla la solución Firecracker: la simbiosis de las mejores cualidades de las máquinas virtuales y los contenedores.
Servidores
La nube es efímera. Pero esta efímera existencia tiene una representación física: los servidores. Inicialmente, su arquitectura era clásica. Chipset x86 estándar, tarjetas de red, Linux, hipervisor Xen, en el que se ejecutaban las máquinas virtuales.
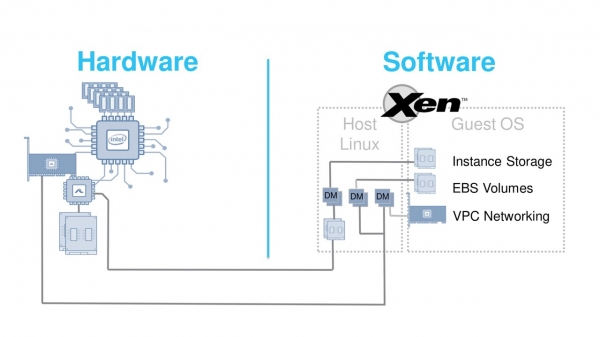
En 2012, esta arquitectura cumplía adecuadamente con sus tareas. Xen es un gran hipervisor, pero tiene una desventaja importante. Tiene un costo alto en la emulación de dispositivos.Con la llegada de nuevas tarjetas de red más rápidas o discos SSD, estos costos se vuelven demasiado altos. ¿Cómo se puede solucionar este problema? Decidimos trabajar en dos frentes: optimizar tanto el hardware como el hipervisor.La tarea es muy seria.
Optimización del hardware y del hipervisor
No se puede hacer todo a la vez y bien. Lo que significa "bien" no estaba claro al principio.
Decidimos aplicar un enfoque evolutivo: cambiamos un elemento importante de la arquitectura y lo lanzamos a producción.
Cometemos errores, escuchamos quejas y sugerencias. Luego cambiamos otro componente. Así, mediante pequeños incrementos, transformamos toda la arquitectura basándonos en la retroalimentación de usuarios y soporte.
Las transformaciones comenzaron en 2013 con lo más complicado: la red. En C3 se añadieron a la tarjeta de red estándar una tarjeta especial llamada Network Accelerator. Se conectaba mediante un corto cable loopback en el panel frontal. No es bonito, pero en la nube no se ve. Sin embargo, la conexión directa con el hardware mejoró significativamente el jitter y la capacidad de la red.
Luego decidimos mejorar el acceso al almacenamiento en bloque EBS — Elastic Block Storage. Esta es una combinación de red y almacenamiento. La dificultad radica en que, aunque en el mercado había tarjetas Network Accelerator, no había forma de comprar hardware Storage Accelerator. Por eso nos dirigimos a la startup Annapurna Labs, que desarrolló para nosotros chips ASIC especiales. Esto permitió conectar volúmenes EBS remotos como dispositivos NVMe.
En las instancias C4 resolvimos dos problemas. El primero fue preparar el camino para una tecnología NVMe prometedora pero nueva en ese momento. El segundo fue aliviar significativamente la carga del procesador central trasladando el procesamiento de las solicitudes a EBS a una nueva tarjeta. Resultó exitoso, por lo que ahora Annapurna Labs es parte de Amazon.
Para noviembre de 2017, entendimos que era hora de cambiar el hipervisor.
El nuevo hipervisor fue desarrollado sobre la base de módulos del núcleo KVM mejorados.
Permitió reducir radicalmente los costos de emulación de dispositivos y trabajar directamente con los nuevos ASIC. Las instancias C5 fueron las primeras máquinas virtuales que operan con el nuevo hipervisor. Lo llamamos Nitro.
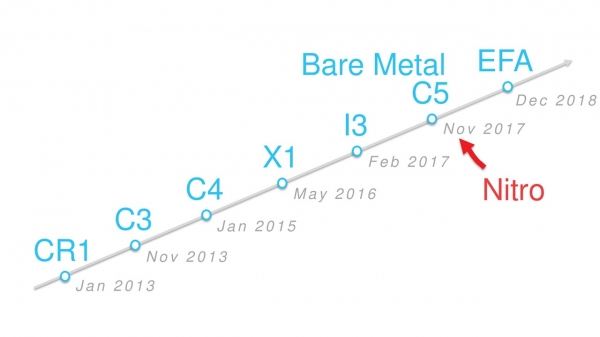 Evolución de las instancias en la línea de tiempo.
Todos los nuevos tipos de máquinas virtuales que surgieron desde noviembre de 2017 funcionan en este hipervisor. Las instancias Bare Metal no tienen hipervisor, pero también se les llama Nitro, ya que utilizan tarjetas Nitro especializadas.
En los siguientes dos años, el número de tipos de instancias Nitro superó la docena: A1, C5, M5, T3 y otros.
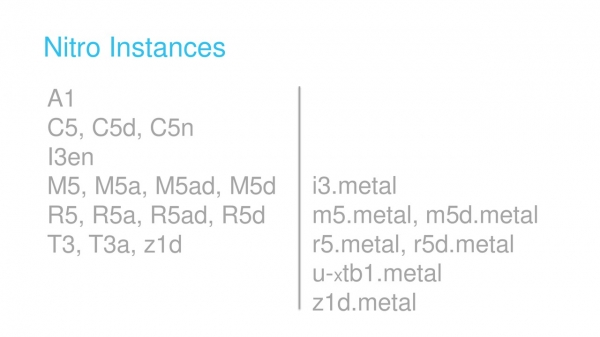
Tipos de instancias.
Cómo están construidas las modernas máquinas Nitro
Tienen tres componentes principales: el hipervisor Nitro (mencionado anteriormente), un chip de seguridad y tarjetas Nitro.
El chip de seguridad está integrado directamente en la placa base. Controla muchas funciones importantes, como el control de arranque del sistema operativo host.
Las tarjetas Nitro son de cuatro tipos. Todas fueron desarrolladas por Annapurna Labs y se basan en ASIC comunes. Parte de su firmware también es común.
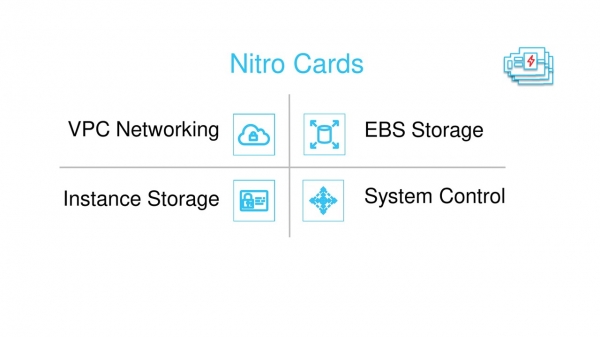
Cuatro tipos de tarjetas Nitro.
Una de las tarjetas está destinada a trabajar con la redVPC. Es la que se ve en las máquinas virtuales como una tarjeta de red ENA — Elastic Network Adaptor. También encapsula el tráfico al transferirlo a través de la red física (hablaremos de esto en la segunda parte del artículo), controla el firewall de Security Groups, se encarga del enrutamiento y otras cuestiones de red.
Tarjetas separadas trabajan con almacenamiento en bloque EBS y discos que están integrados en el servidor. Para la máquina virtual huésped, se presentan como adaptadores NVMe. También se encargan del cifrado de datos y la supervisión de discos.
El sistema de las tarjetas Nitro, el hipervisor y el chip de seguridad está integrado en una red SDN o Software Defined Network. La gestión de esta red (Control Plane) está a cargo de la tarjeta controladora.
Por supuesto, seguimos desarrollando nuevos ASIC. Por ejemplo, a finales de 2018 lanzamos el chip Inferentia, que permite trabajar de manera más eficiente con tareas de aprendizaje automático.
Chip Inferentia Procesador de Aprendizaje Automático.
Base de datos escalable
Una base de datos tradicional tiene una estructura en capas. Si simplificamos bastante, podemos identificar los siguientes niveles.
- SQL — en él operan los gestores de clientes y solicitudes.
- Aseguramiento de transacciones — aquí todo es claro, ACID y todo eso.
- Cacheo, que es proporcionado por los grupos de búferes.
- Registro — maneja los redo-logs. En MySQL se llaman Bin Logs, en PostgreSQL — Write Ahead Logs (WAL).
- Almacenamiento – la escritura directa en disco.
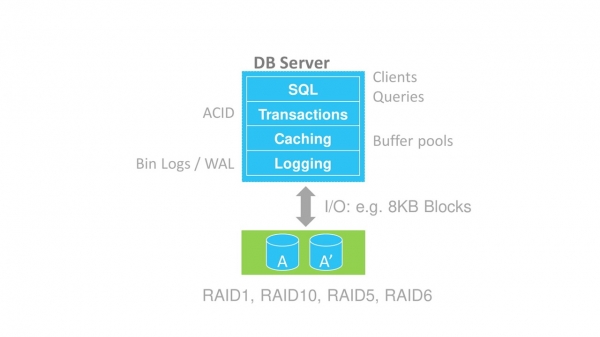
Estructura en capas de la base de datos.
Existen diferentes formas de escalar bases de datos: sharding, arquitectura Shared Nothing, discos compartidos.
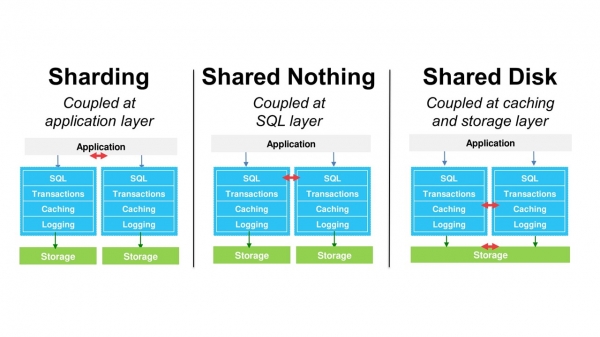
Sin embargo, todos estos métodos mantienen la misma estructura monolítica de la base de datos. Esto limita notablemente la escalabilidad. Para resolver este problema, hemos desarrollado nuestra propia base de datos — Amazon Aurora. Es compatible con MySQL y PostgreSQL.
Amazon Aurora
La idea arquitectónica principal es separar los niveles de almacenamiento y registro de la base de datos principal.
Anticipándome, puedo decir que también hicimos que el nivel de cacheo fuera independiente. La arquitectura deja de ser monolítica, y obtenemos grados adicionales de libertad en la escalabilidad de bloques individuales.
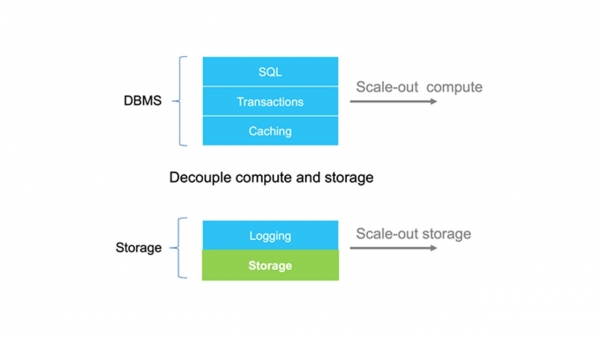
Los niveles de registro y almacenamiento están separados de la base de datos.
Una base de datos tradicional registra los datos en el sistema de almacenamiento en forma de bloques. En Amazon Aurora, hemos creado un almacenamiento "inteligente" que puede comunicarse en el idioma de redo-logs. Dentro de sí, el almacenamiento convierte los registros en bloques de datos, monitorea su integridad y hace copias de seguridad automáticamente.
Este enfoque permite implementar cosas interesantes como clonación. Funciona fundamentalmente más rápido y de manera más económica porque no requiere crear una copia completa de todos los datos.
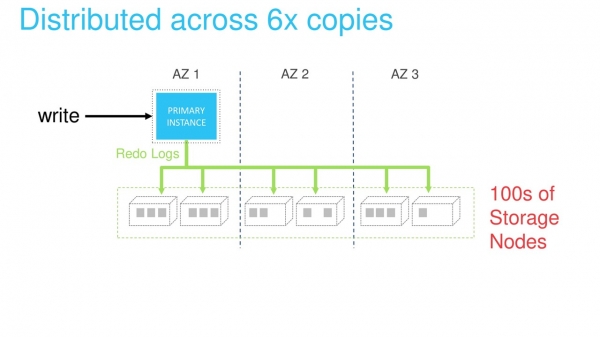
El nivel de almacenamiento se implementa como un sistema distribuido. Consiste en una gran cantidad de servidores físicos. Cada redo-log es procesado y guardado simultáneamente por seis nodos. Esto asegura la protección de datos y la distribución de la carga.
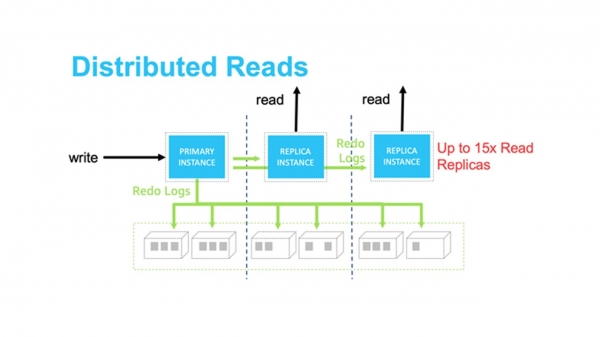
El escalado para lectura se puede lograr mediante réplicas adecuadas. El almacenamiento distribuido elimina la necesidad de sincronización entre la instancia principal de la base de datos, a través de la cual escribimos datos, y las demás réplicas. Los datos actuales están garantizados y disponibles para todas las réplicas.
El único problema es la caché de datos antiguos en las réplicas de lectura. Pero esta tarea se resuelve transfiriendo todos los registros de redo a las réplicas a través de la red interna. Si el registro está en la caché, se marca como incorrecto y se reescribe. Si no está en la caché, simplemente se descarta.
Ya hemos aclarado el almacenamiento.
Cómo escalar niveles de bases de datos
Aquí, escalar horizontalmente es mucho más complicado. Por lo tanto, tomaremos el camino tradicional del escalado vertical clásico..
Supongamos que tenemos una aplicación que se comunica con la base de datos a través de un nodo maestro.
Al escalar verticalmente, asignamos un nuevo nodo que tendrá más procesadores y memoria.
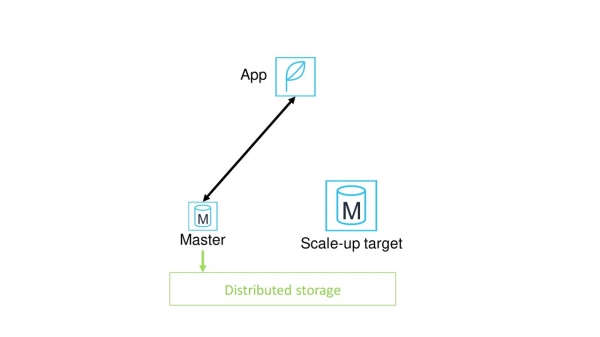
Luego, cambiamos la aplicación del antiguo nodo maestro al nuevo. Surgen problemas.
- Esto requerirá un tiempo de inactividad notable para la aplicación.
- El nuevo nodo maestro tendrá una caché fría. El rendimiento de la base de datos será máximo solo después de calentar la caché.
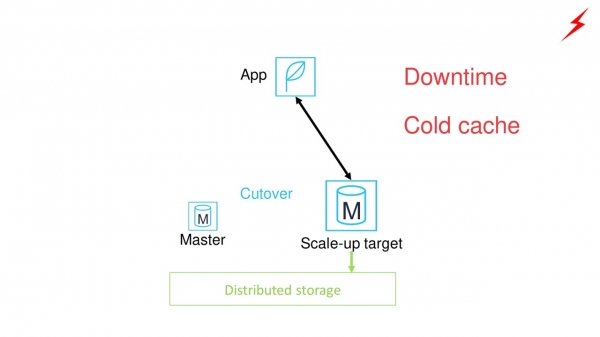
¿Cómo mejorar la situación? Colocar un proxy entre la aplicación y el nodo maestro.
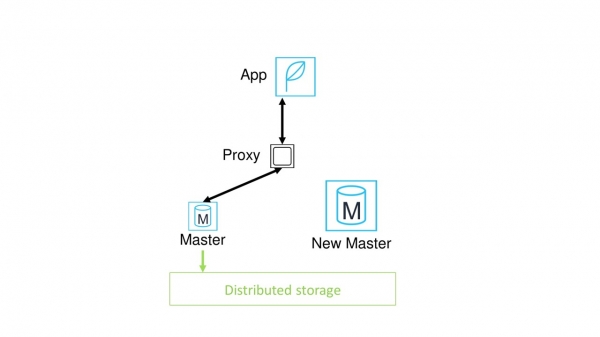
¿Qué nos dará esto? Ahora no es necesario redirigir manualmente todas las aplicaciones al nuevo nodo. El cambio se puede realizar bajo el proxy y será significativamente más rápido.
Parece que el problema está resuelto. Pero no, todavía sufrimos la necesidad de calentar la caché. Además, surge un nuevo problema: ahora el proxy es un punto de fallo potencial.
Solución final con Amazon Aurora serverless
¿Cómo resolvimos estos problemas?
Mantenemos el proxy. No es una instancia separada, sino una flota distribuida de proxies a través de la cual las aplicaciones se conectan a la base de datos. Cualquiera de los nodos se puede reemplazar prácticamente al instante en caso de fallo.
Añadimos un grupo de nodos cálidos de diversos tamaños. Por lo tanto, cuando es necesario asignar un nuevo nodo de mayor o menor tamaño, está disponible de inmediato. No hay que esperar a que se inicie.
Todo el proceso de escalado es controlado por un sistema de monitoreo especial. La monitorización supervisa constantemente el estado del nodo maestro actual. Si detecta, por ejemplo, que la carga de la CPU ha alcanzado niveles críticos, informa al grupo de instancias cálidas sobre la necesidad de provisionar un nuevo nodo.
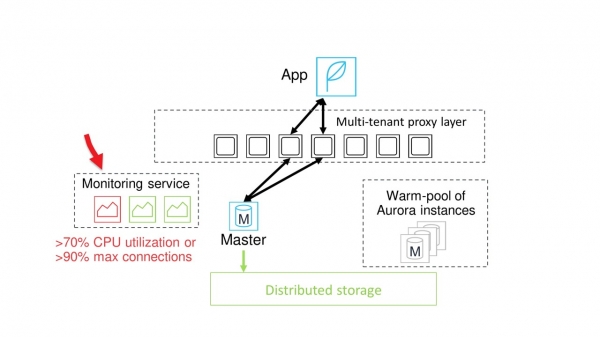
Proxies distribuidos, instancias cálidas y monitorización.
El nodo de la capacidad requerida está disponible. Se copian los grupos de almacenamiento en búfer y el sistema comienza a esperar un momento seguro para el cambio.
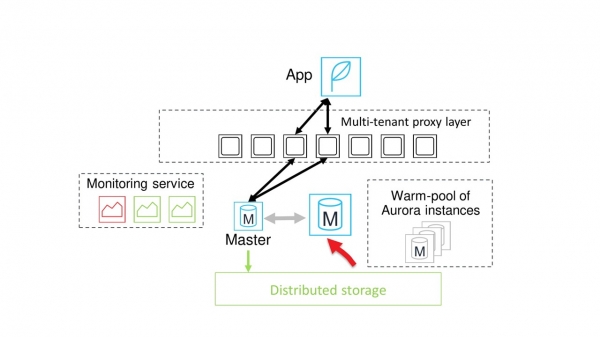
Generalmente, el momento para el cambio llega bastante rápido. Entonces, la comunicación entre el proxy y el antiguo nodo maestro se detiene, y todas las sesiones se transfieren al nuevo nodo.
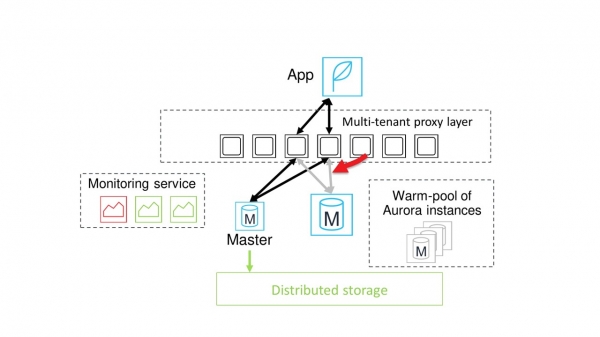
El trabajo con la base de datos se reanuda.
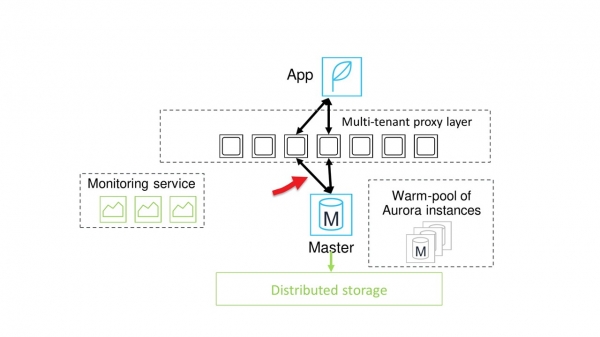
En el gráfico se puede ver que la pausa es realmente muy corta. En el gráfico azul está la carga, y en las escaleras rojas, los momentos de escalado. Los breves descensos en el gráfico azul son precisamente la breve latencia.
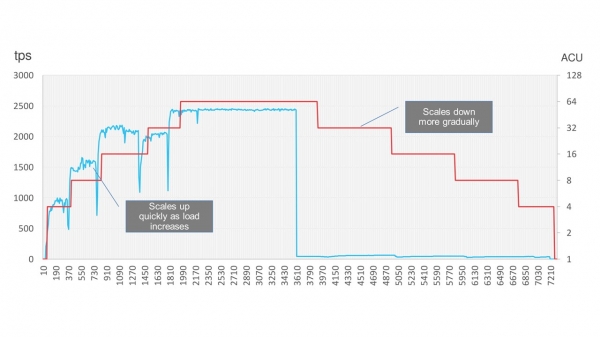
Por cierto, Amazon Aurora permite ahorrar significativamente y apagar la base de datos cuando no se utiliza, por ejemplo, durante los fines de semana. Después de detener la carga, la base de datos reduce gradualmente su capacidad y se apaga durante un tiempo. Cuando la carga regresa, se vuelve a aumentar suavemente.
En la siguiente parte de la historia sobre la arquitectura de Amazon, hablaremos sobre la escalabilidad de la red. Suscríbete y sigue las actualizaciones para no perderte el artículo.
En Vasiliy Pantyukhin dará una conferencia titulada "". ¿Qué patrones de diseño de sistemas distribuidos utilizan los desarrolladores de Amazon, cuáles son las causas de las fallas de los servicios, qué es la arquitectura basada en celdas, el Trabajo Constante, el Shuffle Sharding? Será interesante. Menos de un mes para la conferencia — . El 24 de octubre, el precio aumentará definitivamente.
Fuente: habr.com
