

¡Hola, Habr! En este momento, OTUS está aceptando inscripciones para una nueva edición del curso . A medida que se acerca el inicio del curso, hemos preparado para ustedes una traducción de un material interesante.
Cada día, más de cien millones de personas visitan Twitter para enterarse de lo que sucede en el mundo y discutirlo. Cada tuit y cualquier otra acción del usuario generan un evento, disponible para el análisis interno de datos en Twitter. Cientos de empleados analizan y visualizan estos datos, y mejorar su experiencia es una de las principales prioridades del equipo de Twitter Data Platform.
Creemos que los usuarios con una amplia gama de habilidades técnicas deben poder encontrar datos y tener acceso a herramientas de análisis y visualización que funcionen bien basadas en SQL. Esto permitiría a un nuevo grupo de usuarios con menor inclinación técnica, incluidos analistas de datos y gerentes de producto, extraer información de los datos, permitiéndoles comprender y utilizar mejor las oportunidades de Twitter. Así es como democratizamos el análisis de datos en Twitter.
A medida que perfeccionamos nuestras herramientas y capacidades para el análisis interno de datos, hemos sido testigos de la mejora del servicio de Twitter. Sin embargo, aún queda mucho por hacer. Las herramientas actuales, como Scalding, requieren experiencia en programación. Las herramientas de análisis basadas en SQL, como Presto y Vertica, enfrentan problemas de rendimiento a gran escala. También tenemos un problema con la distribución de datos a través de múltiples sistemas sin acceso constante a ellos.
El año pasado anunciamos , en la cual trasladamos partes de nuestra a Google Cloud Platform (GCP). Concluimos que las herramientas de Google Cloud pueden ayudarnos en nuestras iniciativas para democratizar el análisis, la visualización y el aprendizaje automático en Twitter:
- : un almacén de datos empresariales con un motor SQL basado en , conocido por su rapidez, simplicidad y capacidad para manejar .
- una herramienta para la visualización de grandes datos con funciones de colaboración, como en Google Docs.
En este artículo, aprenderás sobre nuestra experiencia con estas herramientas: lo que hicimos, lo que aprendimos y lo que haremos a continuación. Ahora nos centraremos en la analítica por lotes e interactiva. La analítica en tiempo real la discutiremos en el siguiente artículo.
Historia de los almacenes de datos en Twitter
Antes de profundizar en BigQuery, vale la pena hacer un breve resumen sobre la historia de los almacenes de datos en Twitter. En 2011, el análisis de datos en Twitter se realizaba en Vertica y Hadoop. Para crear el MapReduce del trabajo de Hadoop, utilizamos Pig. En 2012, reemplazamos Pig por Scalding, que tenía una API de Scala con ventajas como la capacidad de crear tuberías complejas y la facilidad de pruebas. Sin embargo, para muchos analistas de datos y gerentes de producto, que se sentían más cómodos trabajando con SQL, esta tenía una curva de aprendizaje bastante pronunciada. Aproximadamente en 2016, comenzamos a usar Presto como interfaz SQL para los datos de Hadoop. Spark ofrecía una interfaz de Python, lo que lo convierte en una buena opción para investigaciones de datos ad hoc y aprendizaje automático.
Desde 2018, hemos utilizado las siguientes herramientas para el análisis y la visualización de datos:
- Scalding para tuberías de producción
- Scalding y Spark para análisis de datos ad hoc y aprendizaje automático
- Vertica y Presto para análisis SQL ad hoc e interactivo
- Druid para acceso interactivo, exploratorio y con baja latencia a métricas de series temporales
- Tableau, Zeppelin y Pivot para visualización de datos
Hemos descubierto que, aunque estas herramientas ofrecen capacidades muy potentes, hemos enfrentado dificultades para hacer que estas capacidades estén disponibles para una audiencia más amplia en Twitter. Al expandir nuestra plataforma con Google Cloud, nos estamos enfocando en simplificar nuestras herramientas analíticas para toda la comunidad de Twitter.
Almacén de datos BigQuery de Google
Varios equipos en Twitter ya han integrado BigQuery en algunos de sus flujos de trabajo de producción. Aprovechando su experiencia, comenzamos a evaluar las capacidades de BigQuery para todos los casos de uso en Twitter. Nuestro objetivo era ofrecer BigQuery a toda la empresa, así como estandarizarlo y mantenerlo dentro del conjunto de herramientas de la Data Platform. Esto resultó complicado por muchas razones. Necesitamos desarrollar una infraestructura para recibir grandes volúmenes de datos de manera confiable, soportar la gestión de datos a nivel empresarial, garantizar el control adecuado de acceso y mantener la privacidad de los clientes. También tuvimos que crear sistemas para la distribución de recursos, monitoreo y reembolso, para que los equipos pudieran utilizar BigQuery de manera efectiva.
En noviembre de 2018, lanzamos la versión alfa de BigQuery y Data Studio para toda la empresa. Ofrecimos a los empleados de Twitter algunas de nuestras tablas más utilizadas con datos personales limpiados. Más de 250 usuarios de diversos equipos, incluyendo ingeniería, finanzas y marketing, utilizaron BigQuery. Recientemente, realizaron alrededor de 8,000 consultas, procesando cerca de 100 PB al mes, sin incluir solicitudes programadas. Tras recibir comentarios muy positivos, decidimos avanzar y ofrecer BigQuery como recurso principal para la interacción con los datos en Twitter.
Aquí está el esquema de alto nivel de nuestra arquitectura de almacenamiento de datos en Google BigQuery.
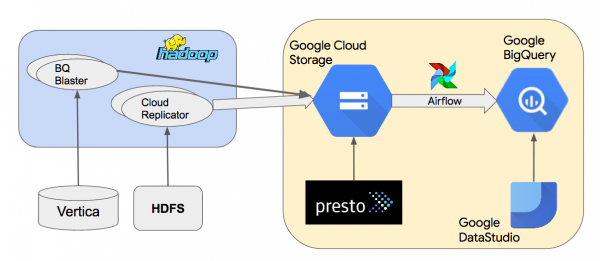
Copiamos datos de clústeres locales de Hadoop a Google Cloud Storage (GCS), utilizando una herramienta interna llamada Cloud Replicator. Luego utilizamos Apache Airflow para crear flujos de trabajo que utilizan «» para cargar datos desde GCS a BigQuery. Usamos Presto para consultar conjuntos de datos Parquet o Thrift-LZO en GCS. BQ Blaster es una herramienta interna de Scalding para cargar conjuntos de datos HDFS, Vertica y Thrift-LZO en BigQuery.
En las siguientes secciones, discutiremos nuestro enfoque y conocimientos sobre la facilidad de uso, el rendimiento, la gestión de datos, la operatividad del sistema y el coste.
Facilidad de uso
Hemos descubierto que los usuarios encontraron fácil comenzar con BigQuery, ya que no requería instalación de software y podían acceder a él a través de una interfaz web intuitiva. Sin embargo, los usuarios necesitaban familiarizarse con algunas características de GCP y sus conceptos, incluyendo recursos como proyectos, conjuntos de datos y tablas. Hemos desarrollado materiales de capacitación y tutoriales para ayudar a los usuarios a empezar. Con una comprensión básica, a los usuarios les resultó fácil navegar por los conjuntos de datos, revisar el esquema y los datos de las tablas, realizar consultas simples y visualizar los resultados en Data Studio.
Nuestro objetivo respecto a la carga de datos en BigQuery era asegurar la carga fluida de conjuntos de datos HDFS o GCS con un solo clic. Consideramos (Airflow administrado), pero no pudimos usarlo debido a nuestro modelo de seguridad de «Domain Restricted Sharing» (más sobre esto en la sección de «Gestión de datos» a continuación). Experimentamos utilizando Google Data Transfer Service (DTS) para organizar tareas de carga en BigQuery. Aunque DTS se configuraba rápidamente, no era flexible para construir tuberías con dependencias. Para nuestra versión alfa, creamos nuestro propio entorno Apache Airflow en GCE y lo estamos preparando para producción, pudiendo soportar más fuentes de datos, como Vertica.
Para transformar datos en BigQuery, los usuarios crean simples tuberías de datos SQL utilizando consultas programadas. Para tuberías complejas de múltiples etapas con dependencias, planeamos usar nuestra propia infraestructura de Airflow o Cloud Composer junto con .
Rendimiento
BigQuery está diseñado para consultas SQL de propósito general que procesan grandes volúmenes de datos. No está destinado a consultas de baja latencia, alta capacidad necesarias para bases de datos transaccionales, o para el análisis de series temporales de baja latencia implementadas en . Para consultas analíticas interactivas, nuestros usuarios esperan un tiempo de respuesta de menos de un minuto. Debimos diseñar el uso de BigQuery de manera que se ajustara a estas expectativas. Para garantizar un rendimiento predecible para nuestros usuarios, utilizamos la funcionalidad de BigQuery disponible para clientes con tarifa fija, que permite a los propietarios de proyectos reservar slots mínimos para sus consultas. BigQuery es una unidad de potencia de cálculo necesaria para ejecutar consultas SQL.
Analizamos más de 800 consultas, procesando alrededor de 1 TB de datos cada una, y descubrimos que el tiempo medio de ejecución fue de 30 segundos. También aprendimos que el rendimiento depende en gran medida del uso de nuestro slot en diferentes proyectos y tareas. Debimos delinear claramente nuestras reservas de slots de producción y ad hoc para mantener el rendimiento para los escenarios de uso de producción y el análisis interactivo. Esto afectó significativamente nuestro diseño para la reserva de slots y la jerarquía de proyectos.
Hablaremos sobre la gestión de datos, la funcionalidad y el costo de los sistemas en los próximos días en la segunda parte de la traducción, pero por ahora, invitamos a todos los interesados a un , donde podrán conocer más sobre el curso y hacer preguntas a nuestro experto, Yegor Mateshchuk (Ingeniero de Datos Senior, MaximaTelecom).
Leer más:
Fuente: habr.com
