

¡Hola, Habr!
Hoy quiero hablar sobre nuestra experiencia en la automatización de copias de seguridad de grandes volúmenes de datos en las instalaciones de Nextcloud en diferentes configuraciones. Soy CTO en 'Molniya AK', donde nos dedicamos a la gestión de configuraciones de sistemas de TI, utilizando Nextcloud para el almacenamiento de datos. Esto incluye estructuras distribuidas con respaldo.
Los problemas que surgen de las particularidades de las instalaciones son que hay muchos datos. La versionado que ofrece Nextcloud, el respaldo, razones subjetivas y otras crean muchas duplicaciones.
Antecedentes
Al administrar Nextcloud, surge una aguda problemática relacionada con la organización de un respaldo eficaz que debe ser cifrado, ya que los datos son valiosos.
Ofrecemos opciones para almacenar copias de seguridad en nuestras instalaciones o en las de los clientes en máquinas separadas de Nextcloud, lo que requiere un enfoque automatizado y flexible para la administración.
Hay muchos clientes, todos con diferentes configuraciones, y cada uno en sus propias plataformas con sus particularidades. Aquí, la metodología estándar funciona mal cuando toda la plataforma te pertenece, y las copias de seguridad se realizan desde cron.
Para empezar, veamos los requisitos iniciales. Necesitamos:
- Escalabilidad en términos de una o varias nodos. Para instalaciones grandes, utilizamos minio como almacenamiento.
- Identificar problemas con la ejecución de las copias de seguridad.
- Es necesario almacenar la copia de seguridad en los clientes y/o en nuestras instalaciones.
- Resolver problemas de manera rápida y sencilla.
- Los clientes y las instalaciones difieren mucho entre sí: no conseguimos alcanzar la uniformidad.
- La velocidad de recuperación debe ser mínima en dos escenarios: recuperación completa (desastre), una carpeta — borrada por error.
- Es obligatoria la función de deduplicación.
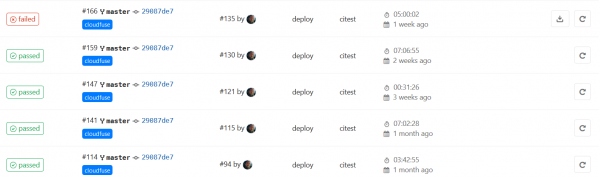
Para gestionar las copias de seguridad, hemos integrado GitLab. Más detalles a continuación.
Sin duda, no somos los primeros en abordar este tipo de problema, pero creemos que nuestra experiencia práctica, dura y probada puede ser interesante y estamos listos para compartirla.
Dado que en nuestra empresa se sigue una política de código abierto, buscamos una solución específicamente de código abierto. A su vez, compartimos nuestros desarrollos y los publicamos. Por ejemplo, en GitHub hay , que instalamos a los clientes, mejorando la seguridad de los datos en caso de eliminación accidental o intencionada.
Herramientas de copia de seguridad
Comenzamos a buscar métodos para soluciones eligiendo una herramienta para crear copias de seguridad.
El tar normal + gzip funciona mal: los datos se duplican. La copia incremental a menudo contiene muy pocos cambios en realidad, y gran parte de los datos dentro de un archivo se repite.
Hay otro problema: la redundancia del almacenamiento distribuido de datos. Estamos utilizando minio y sus datos son redundantes en principio. O bien teníamos que hacer la copia de seguridad a través del mismo minio, lo que lo carga y hace uso de todos los intermediarios entre el sistema de archivos, y lo que es igual de importante, hay riesgo de olvidar partes de los buckets y la metainformación. O utilizar la deduplicación.
Existen herramientas de copias de seguridad con deduplicación en código abierto (en Habré hubo ) y nuestros finalistas fueron y . A continuación, nuestra comparación de dos aplicaciones, pero antes contaremos cómo organizamos todo el esquema.
Gestión de la creación de copias de seguridad
Borg y Restic son buenos, pero ninguno de los dos productos tiene un mecanismo de gestión centralizado. Para el objetivo de gestión y control, elegimos una herramienta que ya teníamos implementada, sin la cual no concebimos nuestro trabajo, incluyendo la automatización: el conocido CI/CD – GitLab.
La idea es la siguiente: en cada nodo que almacena datos de Nextcloud se instala un gitlab-runner. El runner ejecuta programáticamente un script que sigue el proceso de copia de seguridad, y este ejecuta Borg o Restic.
¿Qué obtuvimos? Retroalimentación de la ejecución, control conveniente de los cambios, detalles en caso de error.
Aquí hemos publicado ejemplos de scripts para diferentes tareas, y al final los conectamos a la copia de seguridad no solo de Nextcloud, sino también de muchos otros servicios. Allí también se encuentra el programador, si no queremos configurarlo manualmente (y no queremos) y .gitlab-ci.yml.
En la API de GitLab todavía no hay posibilidad de cambiar el tiempo de espera del CI/CD, y es pequeño. Debe aumentarse, digamos a 1d.
Afortunadamente, GitLab puede ejecutarse no solo por commits, sino también por programación, que es exactamente lo que necesitamos.
Ahora sobre el script envoltorio.
Hemos establecido las siguientes condiciones para este script:
- Debe ejecutarse tanto como un runner como manualmente desde la consola con la misma funcionalidad.
- Debe haber controladores de errores obligatorios:
- código de retorno.
- búsqueda de cadenas en el registro. Por ejemplo, para nosotros, un error puede ser un mensaje que el programa no considera fatal.
- Manejo de tiempo de espera. El tiempo de ejecución debe ser razonable.
- Necesitamos un registro detallado. Pero solo en caso de error.
- También se realiza una serie de pruebas antes del inicio.
- Pequeñas ventajas para mayor comodidad que hemos encontrado útiles en el proceso de soporte:
- El inicio y el final se registran en el syslog de la máquina local. Esto ayuda a vincular errores del sistema con el funcionamiento de la copia de seguridad.
- Parte del registro de errores, cuando los hay, se envía a stdout, y todo el registro se escribe en un archivo separado. Es conveniente revisar CI inmediatamente y evaluar el error si es trivial.
- Modos para depuración.
El registro completo se guarda como un artefacto en GitLab; si no hay errores, se elimina el registro. El script se escribe en bash.
Cualquier sugerencia y comentario sobre el código abierto será bienvenido.
¿Cómo funciona?
En el nodo que se respalda, se ejecuta un runner con el ejecutor de bash. En el programador, se lanza un job CI/CD en un repositorio especial. El runner ejecuta un script como envoltura universal para tales tareas; en él se realizan verificaciones de validez del repositorio de la copia de seguridad, puntos de montaje y todo lo que queramos, luego se realiza la copia de seguridad y se limpia lo antiguo. La copia de seguridad final se envía a S3.
Trabajamos con este esquema: es un proveedor externo de AWS o su equivalente ruso (esto es más rápido y los datos no salen de Rusia). O bien, instalamos un clúster minio separado en el sitio del cliente para estos fines. Normalmente hacemos esto por razones de seguridad, cuando el cliente no quiere que los datos salgan de su entorno.
No utilizamos la función de envío de la copia de seguridad por ssh. Esto no agrega seguridad, y las capacidades de red del proveedor S3 son mucho más altas que las de nuestra única máquina ssh.
Para protegerse de un hacker en la máquina local, ya que puede borrar los datos en S3, es necesario habilitar la versionado.
El respaldador siempre cifra la copia de seguridad.
Borg tiene un modo sin cifrado ninguno, pero no recomendamos encarecidamente activarlo. En este modo no solo no habrá cifrado, sino que no se calculará la suma de verificación de lo que se escribe, por lo que la integridad solo se puede verificar de forma indirecta, mediante los índices.
Se realiza una verificación de las copias de seguridad para la integridad de los índices y contenido mediante un programador separado. La verificación es lenta y prolongada, por lo que la ejecutamos por separado una vez al mes. Puede tardar varios días.
Readme en ruso
Funciones principales
preparepreparacióntestcheckverificación de disponibilidadmaincommandcomando principalforcepostscriptuna función que se ejecuta al final o en caso de error. Se utiliza para desmontar la partición.
Funciones del servicio
cleanupregistramos errores o borramos el archivo de registro.checkloganalizamos el registro para encontrar la cadena de error.retcontrolador de salida.checktimeoutverificación de tiempo de espera.
Entorno
VERBOSE=1mostramos errores en la pantalla de inmediato (stdout).SAVELOGSONSUCCES=1guardamos el registro en caso de éxito.INIT_REPO_IF_NOT_EXIST=1Creamos el repositorio si no existía. Por defecto, está desactivado.TIMEOUTel tiempo máximo para la operación principal. Puedes configurarlo como ‘m’, ‘h’ o ‘d’ al final.
Modo de almacenamiento de copias antiguas. Por defecto:
KEEP_DAILY=7KEEP_WEEKLY=4KEEP_MONTHLY=6
Variables dentro del script
ERROR_STRING— cadena para la verificación en el registro por error.EXTRACT_ERROR_STRING— expresión para mostrar la cadena si hay error.KILL_TIMEOUT_SIGNAL— señal para matar si hay tiempo de espera.TAIL— cuántas cadenas con errores mostrar en pantalla.COLORMSG— color del mensaje (por defecto amarillo).
El script que se llama wordpress lleva este nombre de manera condicional, su característica es que también hace copias de seguridad de la base de datos mysql. Por lo tanto, puede aplicarse a instalaciones temporales de Nexcloud, donde también se puede hacer una copia de seguridad de la base de datos. La comodidad radica no solo en tener todo en un solo lugar, sino que el contenido de la base de datos está cerca del contenido de los archivos, ya que la diferencia de tiempo es mínima.
Restic vs Borg
Las comparaciones entre Borg y Restic están disponibles, entre otras cosas, , y no teníamos la tarea de hacer simplemente otra más, sino la nuestra. Lo que nos importaba era cómo se vería con nuestros datos, con nuestra especificidad. Las llevamos.
Nuestros criterios de selección, además de los ya mencionados (deduplicación, recuperación rápida, etc.):
- Resistencia al trabajo interrumpido. Verificación en kill -9.
- Tamaño en disco.
- Exigencia de recursos (CPU, memoria).
- Tamaño de los blobs almacenados.
- Trabajo con S3.
- Verificación de integridad.
Para la prueba, tomamos un cliente con datos reales y un tamaño total de 1,6 Tbyte.
Condiciones.
Borg no puede trabajar directamente con S3, y lo montamos como un disco fuse, a través de . Restic enviaba directamente a S3.
Goofys funciona muy rápido y bien, y tiene un , que acelera aún más la operación. Está en fase beta, y, para ser sincero, se nos cayó con pérdida de datos en las pruebas (otras). Pero la comodidad radica en que el procedimiento de copia de seguridad no requiere mucha lectura, principalmente escritura, por lo que usamos la caché solo durante la verificación de integridad.
Para reducir la influencia de la red, usamos un proveedor local: Yandex Cloud.
Resultados de la prueba de comparación.
- Kill -9 con posterior reinicio ambos pasaron con éxito.
- Tamaño en disco. Borg puede comprimir, así que los resultados son esperados.
Backuper
Tamaño
Borg
562Gb
Restic
628Gb
- Por CPU
Borg consume poco por sí mismo, con compresión por defecto, pero debe evaluarse junto con el proceso goofys. En conjunto son comparables y utilizan alrededor de 1,2 núcleos en la misma máquina virtual de prueba. - Memoria. Restic aproximadamente 0,5Gb, Borg alrededor de 200Mb. Pero esto es insignificante en comparación con la caché de archivos del sistema. Así que es recomendable asignar más memoria.
- La diferencia en el tamaño de los blobs resultó ser sorprendente.
Backuper
Tamaño
Borg
alrededor de 500Mb
Restic
alrededor de 5Mb
- El trabajo con S3 de Restic es excelente. El trabajo de Borg a través de goofys no plantea problemas, pero se ha observado que es recomendable hacer umount al finalizar la copia de seguridad para vaciar completamente la caché. Una particularidad del trabajo con S3 es que los bloques no cargados nunca se enviarán al bucket, lo que significa que los datos no completamente cargados provocan grandes daños.
- La verificación de integridad funciona bien en ambos casos, pero la velocidad difiere significativamente.
Restic - 3,5 horas.
Borg, con caché de archivos de 100Gb SSD - 5 horas. Resultado aproximadamente igual en velocidad si los datos están en un disco local.
Borg lee directamente de S3 sin caché 33 horas. Terriblemente largo.
En resumen, Borg puede comprimir y tiene blobs más grandes — lo que hace que el almacenamiento y las operaciones GET/PUT en S3 sean más baratos. Pero esto se compensa con una verificación más compleja y lenta. En cuanto a la velocidad de recuperación, no notamos diferencias. Las copias de seguridad posteriores (después de la primera) restic tarda un poco más, pero no significativamente.
El tamaño de la comunidad no fue un aspecto menor en la elección.
Y elegimos borg.
Un par de palabras sobre la compresión
Borg tiene en su arsenal un excelente nuevo algoritmo de compresión — zstd. En calidad de compresión no es peor que gzip, pero es significativamente más rápido. Y es comparable en velocidad al lz4 por defecto.
Por ejemplo, el volcado de una base de datos MySQL se comprime dos veces mejor que lz4 a la misma velocidad. Sin embargo, la experiencia con datos reales muestra una diferencia muy pequeña en la tasa de compresión de los nodos de Nextcloud.
Borg tiene un modo bastante adicional de compresión — si el archivo tiene alta entropía, no se aplica compresión en absoluto, lo que aumenta la velocidad de funcionamiento. Se activa con una opción al crear
-C auto,zstd
para el algoritmo zstd
Con esta opción en comparación con la compresión por defecto obtuvimos
560Gb y 562Gb respectivamente. Los datos del ejemplo anterior, recordemos, sin compresión, dan como resultado 628Gb. El resultado de 2Gb de diferencia nos sorprendió un poco, pero decidimos que elegiremos aun así. auto,zstd.
Método de verificación de copias de seguridad
La máquina virtual se inicia directamente en el proveedor o en el cliente mediante el programador, lo que reduce considerablemente la carga de red. Al menos, esto es más barato que configurar en casa y manejar el tráfico.
goofys --cache "--free:5%:/mnt/cache" -o allow_other --endpoint https://storage.yandexcloud.net --file-mode=0666 --dir-mode=0777 xxxxxxx.com /mnt/goofys
export BORG_PASSCOMMAND="cat /home/borg/.borg-passphrase"
borg list /mnt/goofys/borg1/
borg check --debug -p --verify-data /mnt/goofys/borg1/
De la misma manera, verificamos los archivos con un antivirus (post facto). Los usuarios suben diferentes archivos a Nextcloud y no todos tienen antivirus. Realizar la verificación en el momento de la carga demora demasiado tiempo y dificulta el negocio.
La escalabilidad se logra ejecutando runners en diferentes nodos con diferentes etiquetas.
En nuestro monitoreo, recopilamos los estados de las copias de seguridad a través de la API de GitLab en una sola ventana, y si es necesario, los problemas se detectan fácilmente y también se localizan fácilmente.
Conclusión
Como resultado, sabemos con certeza que hacemos copias de seguridad, que nuestras copias de seguridad son válidas, y los problemas que surgen con ellas requieren poco tiempo y se resuelven a nivel de administrador de guardia. Las copias de seguridad realmente ocupan poco espacio en comparación con tar.gz o Bacula.
Fuente: habr.com
