

En este artículo hablaremos sobre cómo y por qué desarrollamos – un mecanismo que transmite información entre las aplicaciones cliente y los servidores de 1C:Enterprise – desde la formulación de la tarea hasta el diseño de la arquitectura y los detalles de implementación.
El Sistema de Interacción (en adelante – SI) es un sistema distribuido y tolerante a fallos para el intercambio de mensajes con entrega garantizada. SI está diseñado como un servicio de alta carga con gran escalabilidad, disponible tanto como servicio en línea (ofrecido por la empresa 1C) como un producto empaquetado que se puede implementar en sus propios servidores.
SI utiliza un almacenamiento distribuido y un sistema de búsqueda . También hablaremos sobre Java y sobre cómo escalamos horizontalmente PostgreSQL.
Planteamiento del problema
Para entender por qué hicimos el Sistema de Interacción, contaré un poco sobre cómo se desarrolla el software de negocio en 1C.
Primero, un poco sobre nosotros para aquellos que aún no saben qué hacemos :) Creamos la plataforma tecnológica "1C:Enterprise". La plataforma incluye una herramienta de desarrollo de aplicaciones empresariales, así como un entorno de ejecución que permite a las aplicaciones empresariales funcionar en un entorno multiplataforma.
La paradigma cliente-servidor de desarrollo
Las aplicaciones empresariales creadas en "1C:Enterprise" funcionan en una arquitectura de tres niveles con la disposición “SGBD – servidor de aplicaciones – cliente”. El código de aplicación, escrito en , se puede ejecutar en el servidor de aplicaciones o en el cliente. Todo el trabajo con objetos de aplicación (referencias, documentos, etc.), así como la lectura y escritura de la base de datos, se realiza únicamente en el servidor. La funcionalidad de los formularios y la interfaz de comandos también se realiza en el servidor. En el cliente se realizan la obtención, apertura y visualización de formularios, la "comunicación" con el usuario (advertencias, preguntas…), cálculos pequeños en formularios que requieren una respuesta rápida (por ejemplo, multiplicar el precio por la cantidad), trabajo con archivos locales, trabajo con hardware.
En el código de aplicación, en los encabezados de procedimientos y funciones, es necesario indicar explícitamente dónde se ejecutará el código — mediante las directivas &EnCliente / &EnServidor (&AtClient / &AtServer en la versión en inglés del lenguaje). Los desarrolladores en 1C ahora me corregirán, diciendo que las directivas en realidad , pero para nosotros esto no es relevante en este momento.
El código del cliente puede llamar al código del servidor, pero no se puede hacer lo contrario. Esta es una limitación fundamental que hemos implementado por varias razones. En particular, porque el código del servidor debe estar escrito para ejecutarse de la misma manera, sin importar desde dónde se llame, ya sea desde el cliente o desde el servidor. Y en el caso de que el código del servidor sea llamado desde otro código del servidor, el cliente no está presente como tal. Además, debido a que durante la ejecución del código del servidor, el cliente que lo llamó podría haberse cerrado o haber salido de la aplicación, y ya no habría a quién llamar desde el servidor.

El código que maneja la pulsación de un botón: llamar a un procedimiento del servidor desde el cliente funcionará, pero llamar a un procedimiento del cliente desde el servidor no funcionará.
Esto significa que si queremos enviar algún mensaje desde el servidor a la aplicación cliente, por ejemplo, que ha finalizado la generación de un informe "de larga duración" y que el informe puede consultarse, no tenemos tal método. Tenemos que recurrir a trucos, como que el código del cliente consulte periódicamente al servidor. Pero este enfoque carga el sistema con llamadas innecesarias y, en general, no se ve muy elegante.
Y también hay una necesidad, por ejemplo, al recibir una llamada telefónica, - notificar a la aplicación cliente sobre esto, para que encuentre en la base de datos de contrapartes el número del llamante y muestre al usuario la información sobre la contraparte que llama. O, por ejemplo, al recibir un pedido en el almacén, notificar a la aplicación cliente del solicitante. En general, hay muchos casos donde tal mecanismo sería útil.
La propia formulación
Crear un mecanismo de intercambio de mensajes. Rápido, confiable, con entrega garantizada y con capacidad de búsqueda flexible de mensajes. Basado en este mecanismo, implementar un mensajero (mensajes, videollamadas) que funcione dentro de las aplicaciones 1C.
Diseñar un sistema escalable horizontalmente. La carga creciente debe ser manejada aumentando el número de nodos.
Implementación
Decidimos no integrar la parte del servidor de SV directamente en la plataforma 1C:Enterprise, sino implementarla como un producto separado, cuyo API se puede invocar desde el código de las soluciones aplicativas de 1C. Esto se hizo por varias razones, siendo la principal la necesidad de permitir el intercambio de mensajes entre diferentes aplicaciones de 1C (por ejemplo, entre Gestión Comercial y Contabilidad). Las diferentes aplicaciones de 1C pueden operarse en distintas versiones de la plataforma 1C:Enterprise, estar en diferentes servidores, etc. En tales condiciones, implementar SV como un producto separado, que esté "al lado" de las instalaciones de 1C, es la solución óptima.
Por lo tanto, decidimos desarrollar SV como un producto separado. A las pequeñas empresas les recomendamos utilizar el servidor SV que hemos instalado en nuestra nube (wss://1cdialog.com) para evitar los costos asociados con la instalación y configuración local del servidor. Los clientes más grandes, sin embargo, podrían considerar conveniente la instalación de su propio servidor SV en sus instalaciones. Utilizamos un enfoque similar en nuestro producto SaaS en la nube. – se lanza como un producto comercial para la instalación en los clientes y también está desplegado en nuestra nube. .
Aplicación
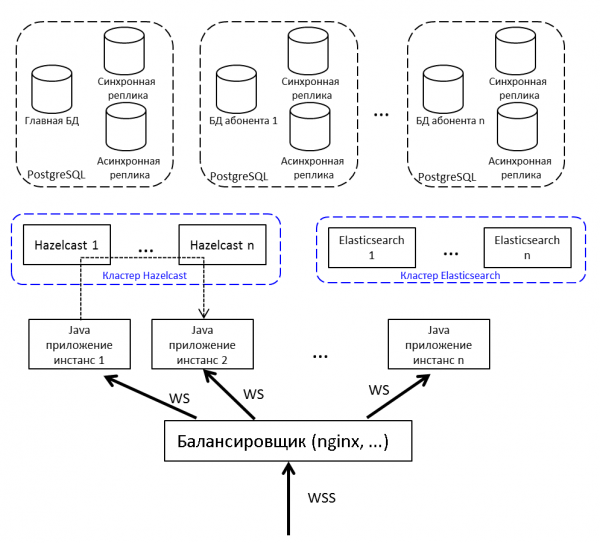
Para distribuir la carga y garantizar la tolerancia a fallos, no desplegaremos una sola aplicación Java, sino varias, colocándole un equilibrador de carga. Si se necesita enviar un mensaje de nodo a nodo, utilizaremos publish/subscribe en Hazelcast.
La comunicación del cliente con el servidor será a través de websocket. Este es adecuado para sistemas en tiempo real.
Caché distribuido
Elegimos entre Redis, Hazelcast y Ehcache. En 2015, Redis acababa de lanzar un nuevo clúster (demasiado nuevo, daba miedo), hay Sentinel con muchas limitaciones. Ehcache no puede agruparse en clúster (esa funcionalidad llegó más tarde). Decidimos probar con Hazelcast 3.4.
Hazelcast se agrupa en un clúster "listo para usar". En modo de un solo nodo no es muy útil y solo puede servir como caché – no puede volcar datos en disco; si perdemos el único nodo, perdemos los datos. Desplegamos varios Hazelcast entre los cuales hacemos copias de seguridad de datos críticos. No respaldamos la caché; no la lamentamos.
Para nosotros, Hazelcast es:
- Almacenamiento de sesiones de usuario. Ir a la base de datos cada vez para obtener la sesión es lento, por lo que almacenamos todas las sesiones en Hazelcast.
- Caché. Si buscas el perfil de un usuario, verifica en la caché. Escribiste un nuevo mensaje, ponlo en la caché.
- Temas para la comunicación de instancias de aplicación. El nodo genera un evento y lo coloca en el tema de Hazelcast. Otros nodos de la aplicación suscritos a este tema reciben y procesan el evento.
- Bloqueos en clúster. Por ejemplo, creamos una discusión con una clave única (discusión singleton dentro de la base de datos 1C):
conversationKeyChecker.check("БЕНЗОКОЛОНКА");

      doInClusterLock("БЕНЗОКОЛОНКА", () -> {

          conversationKeyChecker.check("БЕНЗОКОЛОНКА");

          createChannel("БЕНЗОКОЛОНКА");
      });
Verificamos que no haya canal. Tomamos el bloqueo, verificamos de nuevo, creamos. Si después de tomar el bloqueo no verificamos, hay una posibilidad de que otro hilo también haya verificado y ahora intente crear la misma discusión - y ya existe. No se puede hacer bloqueo a través de synchronized o un java Lock normal. A través de la base de datos es lento, y también es una pena para la base, a través de Hazelcast - es lo que necesitamos.
Elegimos el SGBD
Tenemos una amplia y exitosa experiencia con PostgreSQL y la colaboración con los desarrolladores de este SGBD.
Con el clúster, PostgreSQL no es sencillo, existen , , , pero, en general, no es noSQL, que se escalan de inmediato. NoSQL no se consideró como almacenamiento principal, fue suficiente con adoptar Hazelcast, con el que nunca antes habíamos trabajado.
Ya que necesitamos escalar una base de datos relacional - significa que . Como saben, al shardear, dividimos la base de datos en partes individuales para que cada una de ellas pueda ser trasladada a un servidor separado.
La primera opción de nuestro sharding contemplaba la posibilidad de distribuir cada una de las tablas de nuestra aplicación en diferentes servidores en diferentes proporciones. Muchos mensajes en el servidor A - por favor, traslademos parte de esta tabla al servidor B. Tal solución sencillamente gritaba por optimización prematura, así que decidimos limitarnos al enfoque multi-tenant.
Puedes leer sobre multi-tenant en el sitio .
En SV, existen los conceptos de aplicación y suscriptor. La aplicación es una instalación concreta de una aplicación empresarial, como ERP o Contabilidad, con sus usuarios y datos comerciales. El suscriptor es una organización o persona física que registra la aplicación en el servidor SV. Un suscriptor puede tener varias aplicaciones registradas, y estas aplicaciones pueden intercambiar mensajes entre sí. El suscriptor se convierte en inquilino (tenant) en nuestro sistema. Los mensajes de varios suscriptores pueden estar en una misma base de datos física; si notamos que algún suscriptor genera mucho tráfico, lo trasladamos a una base de datos física separada (o incluso a un servidor de base de datos separado).
Tenemos una base de datos principal donde se almacena una tabla de enrutamiento con información sobre la ubicación de todas las bases de datos de suscriptores.
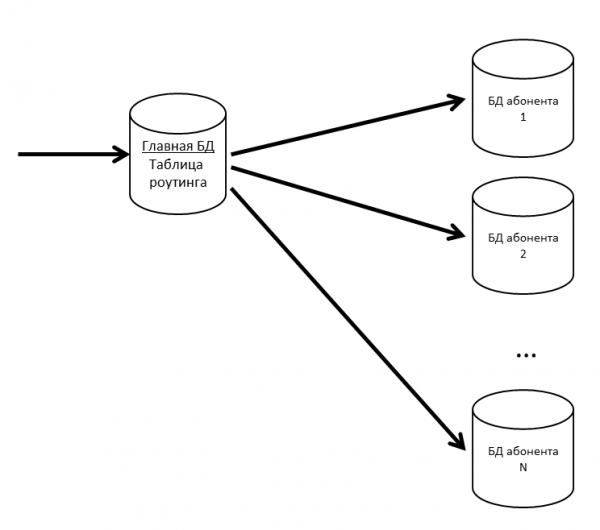
Para que la base de datos principal no sea un cuello de botella, mantenemos la tabla de enrutamiento (y otros datos frecuentemente solicitados) en caché.
Si la base de datos del suscriptor comienza a desacelerarse, particionaremos internamente. En otros proyectos, para la partición de tablas grandes utilizamos .
Dado que perder los mensajes de los usuarios es malo, mantenemos nuestras bases de datos con réplicas. La combinación de réplicas síncronas y asíncronas nos permite asegurarnos en caso de pérdida de la base de datos principal. La pérdida de un mensaje ocurrirá solo en caso de una falla simultánea de la base de datos principal y su réplica síncrona.
Si se pierde la réplica síncrona, la réplica asíncrona se convierte en síncrona.
Si se pierde la base de datos principal, la réplica síncrona se convierte en la base de datos principal, y la réplica asíncrona se convierte en la réplica síncrona.
Elasticsearch para búsqueda
Dado que, además de todo, SV también es un mensajero, se necesita una búsqueda rápida, conveniente y flexible, teniendo en cuenta la morfología y las coincidencias imperfectas. Decidimos no reinventar la rueda y utilizar el sistema de búsqueda de código abierto Elasticsearch, desarrollado a partir de la biblioteca . También implementamos Elasticsearch en un clúster (master – data – data) para evitar problemas en caso de que fallen nodos de la aplicación.
En github encontramos para Elasticsearch y lo utilizamos. En el índice de Elasticsearch almacenamos las raíces de las palabras (definidas por el plugin) y N-gramas. A medida que el usuario introduce texto en la búsqueda, buscamos el texto ingresado entre los N-gramas. Al guardar en el índice, la palabra "textos" se descompondrá en los siguientes N-gramas:
[te, tek, teks, texto, textos, ek, eks, ekst, ekstos, ks, kst, ksty, st, sty, ty],
También se guardará la raíz de la palabra "texto". Este enfoque permite buscar tanto por el principio, como por el medio y el final de la palabra.
Visión general
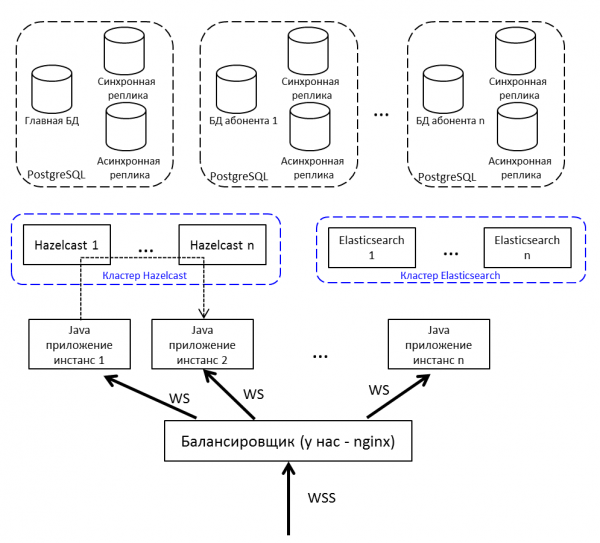
Repetición de la imagen al inicio del artículo, pero ya con explicaciones:
- El balanceador de carga expuesto a Internet; tenemos - nginx, puede ser cualquier otro.
- Las instancias de la aplicación Java se comunican entre sí a través de Hazelcast.
- Para trabajar con el websocket usamos .
- La aplicación Java está escrita en Java 8, consta de bundles . Está previsto migrar a Java 10 y pasar a módulos.
Desarrollo y pruebas
En el proceso de desarrollo y pruebas del SV, nos encontramos con una serie de características interesantes de los productos que utilizamos.
Pruebas de carga y fugas de memoria
La publicación de cada versión del SV implica pruebas de carga. Se considera que se han superado con éxito cuando:
- La prueba se ejecutó durante varios días sin fallos en el servicio
- El tiempo de respuesta para operaciones clave no superó un umbral cómodo
- El empeoramiento del rendimiento en comparación con la versión anterior no es mayor al 10%
Llenamos la base de prueba con datos: para ello, obtenemos del servidor de producción información sobre el abonado más activo, multiplicamos sus cifras por 5 (número de mensajes, discusiones, usuarios) y así lo probamos.
Realizamos pruebas de carga del sistema de interacción en tres configuraciones:
- Prueba de estrés
- Solo conexiones
- Registro de abonados
En la prueba de estrés, ejecutamos varios cientos de hilos que continuamente cargan el sistema: envían mensajes, crean discusiones, reciben la lista de mensajes. Simulamos las acciones de usuarios comunes (obtener la lista de mis mensajes no leídos, escribirle a alguien) y soluciones programáticas (enviar un paquete a otra configuración, procesar una notificación).
Por ejemplo, así es como se ve una parte de la prueba de estrés:
- Un usuario inicia sesión en el sistema
- Solicita sus discusiones no leídas
- Con un 50% de probabilidad lee los mensajes
- Con un 50% de probabilidad escribe mensajes
- A continuación el usuario:
- Con un 20% de probabilidad crea una nueva discusión
- Selecciona al azar cualquiera de sus discusiones
- Entra en
- Solicita mensajes, perfiles de usuarios
- Crea cinco mensajes dirigidos a usuarios al azar de esta discusión
- Sale de la discusión
- Repite 20 veces
- Cierra sesión, regresa al inicio del escenario
- Un chatbot inicia sesión (emulando el intercambio de mensajes del código de soluciones aplicadas)
- Con un 50% de probabilidad crea un nuevo canal para intercambio de datos (discusión especial)
- Con un 50% de probabilidad escribe un mensaje en cualquiera de los canales existentes
El escenario 'Solo conexiones' no surgió por casualidad. Hay situaciones en las que los usuarios conectan el sistema pero aún no se involucran. Cada usuario en la mañana a las 09:00 enciende la computadora, establece conexión con el servidor y guarda silencio. Estos chicos son peligrosos, son muchos: de los paquetes solo tienen PING/PONG, pero mantienen la conexión con el servidor (no pueden no mantenerla - ¿y si hay un nuevo mensaje?). La prueba reproduce la situación en la que en media hora intenta autorizarse un gran número de estos usuarios en el sistema. Se parece a una prueba de estrés, pero su enfoque está precisamente en este primer acceso - para que no haya fallas (la persona no utiliza el sistema, pero ya se cae - es difícil imaginar algo peor).
El escenario de registro de abonados comienza con el primer arranque. Hicimos una prueba de estrés y estábamos seguros de que la mensajería no se ralentizaba. Pero comenzaron los usuarios y la registración empezó a fallar por tiempo de espera. Al registrarse utilizamos , que está vinculado a la entropía del sistema. El servidor no lograba acumular suficiente entropía y al solicitar un nuevo SecureRandom se quedaba parado durante decenas de segundos. Hay muchas salidas de esta situación, por ejemplo: pasar a un menos seguro /dev/urandom, instalar una tarjeta especial que genera entropía, generar números aleatorios de antemano y almacenarlos en un pool. Temporalmente cerramos el problema con un pool, pero desde entonces realizamos una prueba separada para el registro de nuevos abonados.
Como generador de carga utilizamos . No sabe trabajar con websockets, se necesita un plugin. Los primeros en los resultados de búsqueda para la consulta 'jmeter websocket' son , en los que se recomiendan .
Con este decidimos comenzar.
Casi de inmediato después de comenzar las pruebas exhaustivas, descubrimos que comenzaban fugas de memoria en JMeter.
El plugin es una historia completamente diferente; con 176 estrellas, tiene 132 forks en github. El autor no ha hecho commits desde 2015 (lo tomamos en 2015, entonces no suscitó sospechas), hay varios issues en github relacionados con fugas de memoria y 7 pull requests abiertos.
Si decides realizar pruebas de carga con este plugin, presta atención a las siguientes discusiones:
- En un entorno multihilo se utilizó un LinkedList normal, resultando en en tiempo de ejecución. Esto se soluciona ya sea pasando a ConcurrentLinkedDeque o utilizando bloques synchronized. Nosotros elegimos la primera opción ().
- Fuga de memoria, la información sobre la conexión no se elimina al desconectar ().
- En modo streaming (cuando el websocket no se cierra al final de la muestra, sino que se usa más adelante en el plan) no funcionan los patrones de respuesta ().
Esto es de los que hay en github. Lo que hicimos fue:
- Tomamos (@elyrank) – en él se corrigieron los problemas 1 y 3
- Se resolvió el problema 2
- Actualizamos jetty de 9.2.14 a 9.3.12
- Envolvimos SimpleDateFormat en ThreadLocal; SimpleDateFormat no es seguro para hilos, lo que provocaba NPE en tiempo de ejecución
- Eliminamos otra fuga de memoria (la conexión no se cerraba correctamente al desconectar)
¡Y aún así sigue goteando!
La memoria ya no se agotaba en un día, sino en dos. No quedaba tiempo, decidimos ejecutar menos hilos, pero en cuatro agentes. Eso debería ser suficiente, al menos, por una semana.
Pasaron dos días...
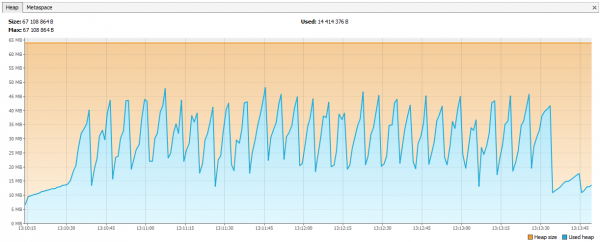
Ahora la memoria comenzó a agotarse en Hazelcast. En los logs se veía que después de un par de días de pruebas, Hazelcast comenzaba a quejarse de falta de memoria, y después de un tiempo el clúster colapsaba y los nodos continuaban cayendo uno a uno. Conectamos JVisualVM a Hazelcast y vimos una 'sierra ascendente' – llamaba regularmente a GC, pero no podía limpiar la memoria.
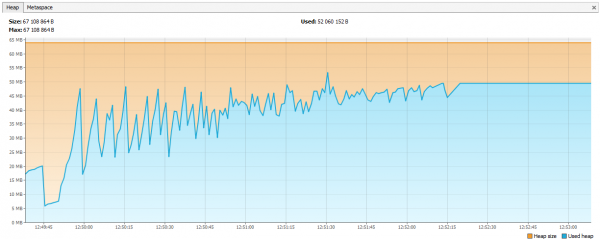
Resultó que en hazelcast 3.4, al eliminar map / multiMap (map.destroy()), la memoria no se libera completamente:
Ahora el error está corregido en 3.5, pero en ese momento era un problema. Creábamos nuevos multiMap con nombres dinámicos y los eliminábamos según nuestra lógica. El código se veía algo así:
public void join(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.put(auth.getUserId(), auth);
}

public void leave(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.remove(auth.getUserId(), auth);

    if (sessions.size() == 0) {
        sessions.destroy();
    }
}
Llamada:
service.join(auth1, "NUEVOS_MENSAJES_EN_EL_TEMA_UUID1");
service.join(auth2, "NUEVOS_MENSAJES_EN_EL_TEMA_UUID1");
multiMap se creaba para cada suscripción y se eliminaba cuando ya no era necesario. Decidimos que utilizaremos un Map, teniendo como clave el nombre de la suscripción y como valores los identificadores de las sesiones (que luego se pueden usar para obtener los identificadores de los usuarios, si es necesario).
public void join(Authentication auth, String sub) {
    addValueToMap(sub, auth.getSessionId());
}

public void leave(Authentication auth, String sub) {
    removeValueFromMap(sub, auth.getSessionId());
}
Los gráficos se han estabilizado.
¿Qué más aprendimos sobre pruebas de carga?
- JSR223 debe escribirse en groovy y activar la caché de compilación: es mucho más rápido. .
- Los gráficos de Jmeter-Plugins son más fáciles de entender que los estándar. .
Sobre nuestra experiencia con Hazelcast
Hazelcast era un producto nuevo para nosotros, comenzamos a trabajar con él desde la versión 3.4.1, ahora en nuestro servidor de producción tenemos la versión 3.9.2 (en el momento de la redacción, la última versión de Hazelcast es 3.10).
Generación de ID
Comenzamos con identificadores numéricos. Supongamos que necesitamos otro Long para una nueva entidad. Una secuencia en la base de datos no es adecuada, las tablas participan en el sharding; resulta que hay un mensaje ID=1 en BD1 y un mensaje ID=1 en BD2, en Elasticsearch no puedes poner un ID así, tampoco en Hazelcast, pero lo más grave es que si deseas combinar datos de dos bases de datos en una (por ejemplo, decidiendo que una base de datos es suficiente para esos abonados). Puedes establecer varios AtomicLong en Hazelcast y mantener un contador allí, entonces la velocidad para obtener un nuevo ID sería incrementAndGet más el tiempo de la solicitud a Hazelcast. Pero en Hazelcast hay algo más óptimo: FlakeIdGenerator. A cada cliente se le asigna un rango de ID al solicitarlo, por ejemplo, al primero – de 1 a 10,000, al segundo – de 10,001 a 20,000, y así sucesivamente. Ahora el cliente puede emitir nuevos identificadores por sí mismo, hasta que se agote el rango asignado. Funciona rápido, pero al reiniciar la aplicación (y el cliente de Hazelcast) comienza una nueva secuencia, de ahí vienen los saltos, etc. Además, a los desarrolladores no les resulta claro por qué los ID son numéricos, pero aparecen tan desordenados. Lo evaluamos todo y decidimos cambiar a UUIDs.
Por cierto, para aquellos que quieren ser como Twitter, existe una biblioteca llamada Snowcast: es una implementación de Snowflake sobre Hazelcast. Puedes verlo aquí:
Pero ya no hemos tenido tiempo para ello.
TransactionalMap.replace
Otra sorpresa: TransactionalMap.replace no funciona. Aquí tienes una prueba:
@Test
public void replaceInMap_putsAndGetsInsideTransaction() {

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            context.getMap("map").put("key", "oldValue");
            context.getMap("map").replace("key", "oldValue", "newValue");

            String value = (String) context.getMap("map").get("key");
            assertEquals("newValue", value);

            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}

Esperado: newValue
Real: oldValue
Tuve que escribir mi propio replace usando getForUpdate:
protected  boolean replaceInMap(String mapName, K key, V oldValue, V newValue) {
    TransactionalTaskContext context = HazelcastTransactionContextHolder.getContext();
    if (context != null) {
        log.trace("[CACHE] Replacing value in a transactional map");
        TransactionalMap map = context.getMap(mapName);
        V value = map.getForUpdate(key);
        if (oldValue.equals(value)) {
            map.put(key, newValue);
            return true;
        }

        return false;
    }
    log.trace("[CACHE] Replacing value in a not transactional map");
    IMap map = hazelcastInstance.getMap(mapName);
    return map.replace(key, oldValue, newValue);
}
Prueba no solo las estructuras de datos normales, sino también sus versiones transaccionales. A veces, IMap funciona, pero TransactionalMap ya no.
Sustituir un nuevo JAR sin tiempo de inactividad
Primero decidimos registrar en Hazelcast objetos de nuestras propias clases. Por ejemplo, tenemos una clase Application, queremos guardarla y leerla. Guardamos:
IMap map = hazelcastInstance.getMap("application");
map.set(id, application);
Leemos:
IMap map = hazelcastInstance.getMap("application");
return map.get(id);
Todo funciona. Luego decidimos construir un índice en Hazelcast para poder buscar en él:
map.addIndex("subscriberId", false);Y al registrar una nueva entidad comenzamos a recibir ClassNotFoundException. Hazelcast intentó complementar el índice, pero no sabía nada de nuestra clase y quería que le proporcionáramos un JAR con esa clase. Así lo hicimos, todo funcionó, pero surgió un nuevo problema: ¿cómo actualizar el JAR sin detener completamente el clúster? Hazelcast no detecta el nuevo JAR durante la actualización en vivo. En ese momento decidimos que realmente podríamos vivir sin búsqueda por índice. Después de todo, si usamos Hazelcast como un almacén tipo clave-valor, ¿todo funcionará? No del todo. Aquí nuevamente hay un comportamiento diferente entre IMap y TransactionalMap. Allí donde a IMap no le importa, TransactionalMap lanza un error.
IMap. Guardamos 5000 objetos, leemos. Todo es lo esperado.
@Test
void get5000() {
    IMap map = hazelcastInstance.getMap("application");
    UUID subscriberId = UUID.randomUUID();

    for (int i = 0; i < 5000; i++) {
        UUID id = UUID.randomUUID();
        String title = RandomStringUtils.random(5);
        Application application = new Application(id, title, subscriberId);

        map.set(id, application);
        Application retrieved = map.get(id);
        assertEquals(id, retrieved.getId());
    }
}
En la transacción no funciona, obtenemos ClassNotFoundException:
@Test
void get_transaction() {
    IMap map = hazelcastInstance.getMap("application_t");
    UUID subscriberId = UUID.randomUUID();
    UUID id = UUID.randomUUID();

    Application application = new Application(id, "qwer", subscriberId);
    map.set(id, application);

    Application retrievedOutside = map.get(id);
    assertEquals(id, retrievedOutside.getId());

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            TransactionalMap transactionalMap = context.getMap("application_t");
            Application retrievedInside = transactionalMap.get(id);

            assertEquals(id, retrievedInside.getId());
            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}
En 3.8 apareció el mecanismo User Class Deployment. Puede designar un nodo principal y actualizar el archivo JAR en él.
Ahora hemos cambiado completamente de enfoque: nosotros mismos serializamos a JSON y guardamos en Hazelcast. Hazelcast no necesita conocer la estructura de nuestras clases, y nosotros podemos actualizar sin tiempo de inactividad. La versión de los objetos de dominio la gestiona la aplicación. Diferentes versiones de la aplicación pueden estar en ejecución al mismo tiempo, y puede ocurrir que una nueva aplicación escriba objetos con nuevos campos, mientras que la antigua aún no es consciente de esos campos. Al mismo tiempo, una nueva aplicación lee objetos escritos por la antigua, que no tienen los nuevos campos. Tratamos estas situaciones dentro de la aplicación, pero para simplificar, no cambiamos ni eliminamos campos, solo ampliamos las clases mediante la adición de nuevos campos.
Cómo garantizamos un alto rendimiento
Cuatro accesos a Hazelcast – bien, dos a la base de datos – mal
Siempre es mejor obtener datos del caché que de la base de datos, pero tampoco queremos mantener registros no utilizados. La decisión sobre qué caché implementar la posponemos hasta la última etapa del desarrollo. Cuando la nueva funcionalidad está codificada, habilitamos el registro de todas las consultas en PostgreSQL (log_min_duration_statement en 0) y realizamos pruebas de carga durante unos 20 minutos. Con los registros recopilados, herramientas como pgFouine y pgBadger pueden generar informes analíticos. En los informes, buscamos primero consultas lentas y frecuentes. Para las consultas lentas, construimos un plan de ejecución (EXPLAIN) y evaluamos si es posible acelerar dicha consulta. Las consultas frecuentes con los mismos datos de entrada se almacenan bien en el caché. Tratamos de mantener las consultas "planas", realizando una consulta por tabla.
Explotación
SV como servicio en línea se lanzó en la primavera de 2017, como producto separado, SV salió en noviembre de 2017 (en ese momento en versión beta).
Durante más de un año de operación, no ha habido problemas serios con el funcionamiento del servicio en línea SV. Monitoreamos el servicio en línea a través de , recopilamos y desplegamos desde .
El paquete del servidor SV se distribuye en forma de paquetes nativos: RPM, DEB, MSI. Además, para Windows ofrecemos un instalador único en forma de un único EXE, que instala el servidor, Hazelcast y Elasticsearch en una sola máquina. Inicialmente llamábamos a esta versión de instalación "demostrativa", pero ahora está claro que esta es la opción de despliegue más popular.
Fuente: habr.com
