

¡Hola, Habr!
Trabajo en el equipo de Tinkoff, que se encarga del desarrollo de nuestro propio centro de notificaciones. Principalmente desarrollo en Java utilizando Spring Boot y resuelvo varios problemas técnicos que surgen en el proyecto.
La mayoría de nuestros microservicios interactúan de manera asíncrona entre sí a través de un bróker de mensajes. Anteriormente, utilizábamos IBM MQ como bróker, que dejó de manejar la carga, pero que tenía altas garantías de entrega.
Como reemplazo, nos propusieron Apache Kafka, que tiene un alto potencial de escalabilidad, pero que, desafortunadamente, requiere un enfoque casi personalizado para la configuración en diferentes escenarios. Además, el mecanismo de entrega al menos una vez que funciona en Kafka de forma predeterminada, no permitía mantener el nivel necesario de consistencia desde el principio. A continuación, compartiré nuestra experiencia configurando Kafka, en particular cómo configurar y trabajar con la entrega exactamente una vez.
Entrega garantizada y más
Los parámetros que se mencionarán a continuación ayudarán a prevenir una serie de problemas con la configuración de conexión predeterminada. Pero primero, quiero centrarme en un parámetro que facilitará el posible depurado.
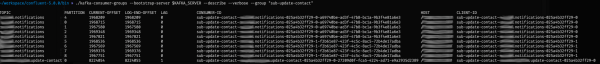
Esto ayudará client.id para Producer y Consumer. A primera vista, se puede usar el nombre de la aplicación como valor, y en la mayoría de los casos funcionará. Sin embargo, la situación en la que se utilizan varios Consumers en la aplicación y se les asigna el mismo client.id provoca la siguiente advertencia:
org.apache.kafka.common.utils.AppInfoParser — Error registrando AppInfo mbean javax.management.InstanceAlreadyExistsException: kafka.consumer:type=app-info,id=kafka.test-0Si deseas usar JMX en una aplicación con Kafka, esto puede ser un problema. Para este caso, es mejor usar como valor para client.id una combinación del nombre de la aplicación y, por ejemplo, el nombre del tópico. Puedes ver el resultado de nuestra configuración en la salida del comando kafka-consumer-groups de las utilidades de Confluent:
Ahora analicemos el escenario de la entrega garantizada de mensajes. Un Kafka Producer tiene el parámetro acks, que permite configurar después de cuántas confirmaciones el líder del clúster debe considerar el mensaje como grabado correctamente. Este parámetro puede tomar los siguientes valores:
- 0 — las confirmaciones no se contarán.
- 1 — parámetro predeterminado, se necesita confirmación solo de 1 réplica.
- −1 — se requieren acknowledgments de todas las réplicas sincronizadas (configuración del clúster min.insync.replicas).
De los valores enumerados, se nota que acks igual a −1 brinda las garantías más fuertes de que el mensaje no se perderá.
Como todos sabemos, los sistemas distribuidos son poco fiables. Para protegerse contra fallas temporales, el Kafka Producer proporciona el parámetro retries, que permite establecer el número de intentos de reenvío durante delivery.timeout.ms. Dado que el parámetro retries tiene el valor predeterminado Integer.MAX_VALUE (2147483647), el número de reenvíos de mensajes se puede regular cambiando solo delivery.timeout.ms.
Pasamos a la entrega exactamente una vez
La configuración mencionada permite que nuestro Producer entregue mensajes con una alta garantía. Ahora hablemos de cómo garantizar que se registre solo una copia de un mensaje en el tema de Kafka. En el caso más simple, para esto el Producer debe establecer el parámetro enable.idempotence en verdadero. La idempotencia garantiza el registro de solo un mensaje en una partición específica de un tema. Un requisito previo para habilitar la idempotencia son los valores acks = all, retry > 0, max.in.flight.requests.per.connection ≤ 5. Si estos parámetros no son especificados por el desarrollador, se establecerán automáticamente los valores mencionados anteriormente.
Cuando la idempotencia está configurada, es necesario asegurarse de que los mensajes idénticos vayan siempre a las mismas particiones. Esto se puede lograr configurando la clave y el parámetro partitioner.class en el Producer. Comencemos con la clave. Para cada envío, debe ser la misma. Esto se puede lograr fácilmente utilizando algún identificador de negocio del mensaje original. El parámetro partitioner.class tiene el valor predeterminado — . Con esta estrategia de partición predeterminada, procede de la siguiente manera:
- Si la partición se indica explícitamente al enviar el mensaje, se utiliza.
- Si no se indica la partición, pero se especifica la clave, se elige la partición por el hash de la clave.
- Si no se especifican ni la partición ni la clave, las particiones se eligen de forma secuencial (round-robin).
Además, el uso de una clave y el envío idempotente con el parámetro max.in.flight.requests.per.connection = 1 le proporciona un procesamiento ordenado de mensajes en el Consumer. También debe recordar que, si su clúster tiene habilitada la gestión de acceso, necesitará permisos para registrar idempotentemente en el tema.
Si de repente le faltan las capacidades de envío idempotente por clave o la lógica del lado del Producer requiere mantener la consistencia de los datos entre diferentes particiones, las transacciones vienen al rescate. Además, mediante una transacción encadenada, puede sincronizar condicionalmente la escritura en Kafka, por ejemplo, con la escritura en la base de datos. Para habilitar el envío transaccional en el Producer, es necesario que sea idempotente y también definir transactional.id. Si en su clúster de Kafka se ha configurado la gestión de acceso, también se necesitarán derechos de escritura para el registro transaccional, los cuales pueden ser otorgados mediante una máscara usando el valor almacenado en transactional.id.
Formalmente, se puede usar cualquier cadena como identificador de transacción, por ejemplo, el nombre de la aplicación. Pero si está ejecutando varias instancias de la misma aplicación con el mismo transactional.id, la primera instancia que se inicie se detendrá con un error, ya que Kafka la considerará un proceso zombi.
org.apache.kafka.common.errors.ProducerFencedException: El Producer intentó realizar una operación con una época antigua. Ya sea que haya un producer más nuevo con el mismo transactionalId, o que la transacción del producer haya expirado por el broker.Para resolver este problema, añadimos un sufijo al nombre de la aplicación en forma del nombre del host, que obtenemos de las variables de entorno.
El Producer está configurado, pero las transacciones en Kafka solo gestionan el ámbito de visibilidad del mensaje. Independientemente del estado de la transacción, el mensaje llega inmediatamente al tema, pero posee atributos adicionales del sistema.
Para que el Consumer no lea tales mensajes antes de tiempo, debe establecer el parámetro isolation.level en el valor read_committed. Dicho Consumer podrá leer mensajes no transaccionales como antes, y los transaccionales solo después del commit.
Si ha configurado todas las configuraciones mencionadas anteriormente, ha configurado exactly once delivery. ¡Felicidades!
Pero hay otro matiz. El transactional.id, que configuramos arriba, es en realidad un prefijo de la transacción. Al gerente de transacciones se le añade un número secuencial. El identificador obtenido se emite en transactional.id.expiration.ms, que se configura en el clúster de Kafka y tiene un valor por defecto de «7 días». Si durante este tiempo la aplicación no recibe ningún mensaje, al intentar el siguiente envío transaccional recibirás InvalidPidMappingException. Después de esto, el coordinador de transacciones emitirá un nuevo número secuencial para la siguiente transacción. Sin embargo, el mensaje puede perderse si InvalidPidMappingException no se maneja correctamente.
En lugar de resultados
Como se puede notar, no es suficiente simplemente enviar mensajes a Kafka. Es necesario elegir una combinación de parámetros y estar listo para realizar cambios rápidos. En este artículo he intentado mostrar en detalle la configuración de entrega exactly once y he descrito algunos problemas de configuración con client.id y transactional.id que encontramos. A continuación, se presentan brevemente los ajustes de Producer y Consumer.
Productor:
- acks = all
- retries > 0
- enable.idempotence = true
- max.in.flight.requests.per.connection ≤ 5 (1 — para envío ordenado)
- transactional.id = ${application-name}-${hostname}
Consumidor:
- isolation.level = read_committed
Para minimizar errores en futuras aplicaciones, hemos creado un wrapper sobre la configuración de spring, donde ya se han establecido valores para algunos de los parámetros mencionados.
Y aquí hay un par de materiales para el autoestudio:
Fuente: habr.com
