

Hemos desarrollado un diseño de red de centros de datos que permite implementar clústeres computacionales de más de 100 mil servidores con un ancho de banda de bisectores (bisection bandwidth) superior a un petabyte por segundo.
En la presentación de Dmitry Afanasyev, conocerás los principios básicos del nuevo diseño, la escalabilidad de las topologías, los problemas que surgen, las opciones para resolverlos, las particularidades de enrutamiento y escalabilidad de las funciones del plano de reenvío de los modernos dispositivos de red en topologías 'densas' (densely connected) con un gran número de rutas ECMP. Además, Dima hizo un breve resumen sobre la organización de la conectividad externa, el nivel físico, el sistema de cableado y las formas de aumentar aún más la capacidad.
— ¡Buenos días a todos! Mi nombre es Dmitry Afanasyev, soy arquitecto de redes en Yandex y me dedico principalmente al diseño de redes de centros de datos.
Mi charla será sobre la red actualizada de centros de datos de Yandex. En gran medida, es una evolución del diseño que teníamos, pero al mismo tiempo hay algunos elementos nuevos. Esta es una presentación general, ya que tuvimos que condensar una cantidad considerable de información en poco tiempo. Comenzaremos con la selección de la topología lógica. Luego habrá una visión general del control de plano y los problemas de escalabilidad del plano de datos, la elección de lo que ocurrirá en el nivel físico, y veremos algunas características de los dispositivos. También abordaremos brevemente lo que sucede en el centro de datos con MPLS, del que hablamos hace algún tiempo.
Entonces, ¿qué es Yandex en términos de cargas y servicios? Yandex es un hiperescalador típico. Si miramos desde la perspectiva de los usuarios, nuestra principal actividad es procesar las solicitudes de los usuarios. También ofrecemos diversos servicios de streaming y entrega de datos, ya que también contamos con servicios de almacenamiento. Más cerca del backend, surgen cargas y servicios de infraestructura, como almacenamiento de objetos distribuidos, replicación de datos y, por supuesto, colas persistentes. Uno de los tipos de carga principales es MapReduce y sistemas similares, procesamiento de flujos, aprendizaje automático, etc.
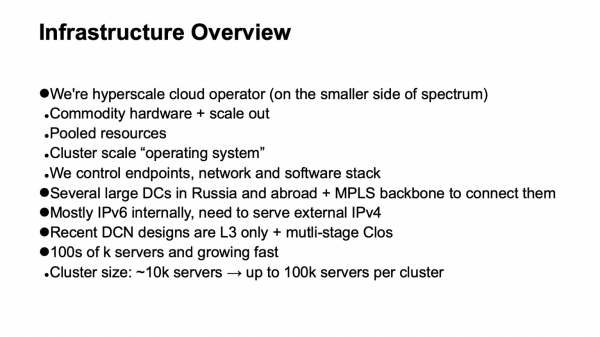
¿Cómo está organizada la infraestructura sobre la que todo esto sucede? De nuevo, somos un hiperescalador bastante típico, aunque quizás estamos un poco más cerca del lado del espectro donde se encuentran los hiperescaladores más pequeños. Pero tenemos todas las características. Utilizamos hardware común y escalado horizontal en todas partes donde es posible. Contamos con un agrupamiento completo de recursos: no trabajamos con máquinas individuales o racks individuales, sino que las agrupamos en un gran conjunto de recursos intercambiables con algunos servicios adicionales que se ocupan de la planificación y asignación, y trabajamos con todo este conjunto.
Así que surge el siguiente nivel: el sistema operativo a nivel del clúster de computación. Es muy importante que controlamos completamente la pila de tecnologías que utilizamos. Controlamos los puntos finales (hosts), la red y la pila de software.
Tenemos varios grandes centros de datos en Rusia y en el extranjero. Están conectados por un backbone que utiliza tecnología MPLS. Nuestra infraestructura interna está prácticamente construida completamente sobre IPv6, pero dado que necesitamos atender el tráfico externo, que aún llega principalmente por IPv4, debemos encontrar una manera de llevar las solicitudes que llegan por IPv4 hasta el front-end,servidores, y un poco más de navegación en el internet externo de IPv4, por ejemplo, para la indexación.
Las últimas iteraciones del diseño de redes de centros de datos utilizan topologías Clos de múltiples niveles, y solo se aplica L3. Nos alejamos de L2 hace algún tiempo y respiramos aliviados. Finalmente, nuestra infraestructura incluye cientos de miles de instancias de computación (servidores). El tamaño máximo del clúster hace algún tiempo era de aproximadamente 10,000 servidores. Esto se debe en gran medida a cómo pueden funcionar esos sistemas operativos a nivel de clúster, planificadores, asignación de recursos, etc. Dado que ha habido avances en el software de infraestructura, ahora el objetivo es un tamaño de alrededor de 100,000 servidores en un solo clúster de computación, y hemos enfrentado la tarea de ser capaces de construir fábricas de red que permitan una eficiente agrupación de recursos en un clúster de este tipo.
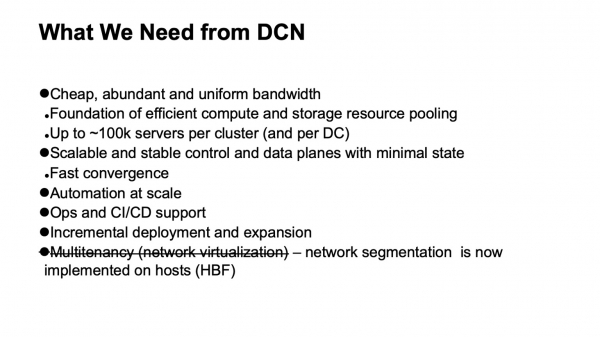
¿Qué queremos de la red del centro de datos? En primer lugar, mucho ancho de banda barato y suficientemente homogéneamente distribuido. Porque la red es la base sobre la cual podemos hacer agrupamiento de recursos. El nuevo tamaño objetivo es alrededor de 100 mil servidores en un solo clúster.
Por supuesto, también deseamos un control plane escalable y estable, porque en una infraestructura tan grande surgen muchos inconvenientes incluso por eventos aleatorios, y no queremos que el control plane nos cause más problemas. Además, queremos minimizar el estado en él. Cuanto menos estado haya, mejor y más estable funcionará todo, y será más fácil diagnosticar.
Por supuesto, necesitamos automatización, porque gestionar manualmente una infraestructura así es imposible, algo que ya no era factible desde hace un tiempo. Necesitamos, en la medida de lo posible, soporte para la operación y soporte para CI/CD, en la medida en que se pueda proporcionar.
Con el tamaño de los centros de datos y clústeres, ya se ha vuelto bastante urgente la tarea de apoyar el despliegue incremental y la expansión sin interrumpir el servicio. Si en clústeres del tamaño de mil máquinas, cerca de diez mil se pueden implementar como una sola operación — es decir, planeamos la expansión de la infraestructura, y varios miles de máquinas se añaden como una sola operación — entonces un clúster del tamaño de cien mil máquinas no surge de inmediato, se construye durante un tiempo. Y es deseable que durante todo este tiempo, lo que ya se ha implementado, la infraestructura que ha sido desplegada, esté disponible.
Y un requisito que tuvimos y que se ha ido: es el soporte para multitenancy, es decir, virtualización o segmentación de la red. Ahora ya no lo necesitamos hacer a nivel de fábrica de red, porque la segmentación se ha trasladado a los hosts, lo que nos facilitó mucho la escalabilidad. Gracias a IPv6 y al gran espacio de direcciones, no tuvimos que utilizar direcciones duplicadas dentro de la infraestructura, toda la direccionamiento era única. Y gracias a que hemos movido la filtración y segmentación de la red a los hosts, no necesitamos crear entidades de red virtuales en las redes del centro de datos.
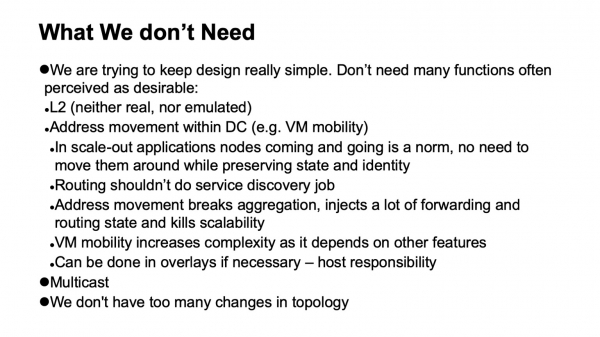
Una cosa muy importante es que no necesitamos. Si algunas funciones pueden eliminarse de la red, esto facilita la vida en gran medida y, generalmente, amplía la selección de hardware y software disponibles, simplificando mucho el diagnóstico.
Entonces, ¿qué es lo que no necesitamos, de qué nos hemos podido deshacer, no siempre con alegría en el momento en que ocurría, pero con gran alivio cuando el proceso finalizaba?
En primer lugar, la renuncia a L2. No necesitamos L2, ni real ni emulado. No se utiliza en gran medida porque controlamos la pila de aplicaciones. Nuestras aplicaciones escalan horizontalmente, funcionan con direccionamiento L3, no les preocupa que alguna instancia se apague, simplemente implementan una nueva; no necesita implementarse en la antigua dirección, porque existe un nivel separado de descubrimiento de servicios y monitoreo de máquinas que están en el clúster. No delegamos esta tarea a la red. La tarea de la red es entregar paquetes de un punto A a un punto B.
Tampoco tenemos situaciones en las que las direcciones se mueven dentro de la red y esto necesita ser rastreado. En muchos diseños, esto suele ser necesario para mantener la movilidad de las VM. No utilizamos la movilidad de máquinas virtuales en la infraestructura interna del gran Yandex, y además creemos que, incluso si se hace, no debería ocurrir con el apoyo de la red. Si realmente es necesario hacer esto, debe hacerse a nivel de hosts y encerrar direcciones que pueden migrar en overlays, para no tocar y no introducir demasiados cambios dinámicos en el sistema de enrutamiento de la propia red subyacente.
Otra tecnología que no usamos es el multicast. Para quienes lo deseen, puedo explicar en detalle por qué. Esto facilita la vida en gran medida porque, si alguien ha tenido que lidiar con él y ha visto cómo se ve realmente el plano de control del multicast, en todas las instalaciones, excepto las más simples, es un gran dolor de cabeza. Y, además, es difícil encontrar una implementación abierta que funcione bien, por ejemplo.
Y, por último, diseñamos nuestras redes de tal manera que no se produzcan demasiados cambios. Podemos contar con que el flujo de eventos externos en el sistema de enrutamiento es limitado.
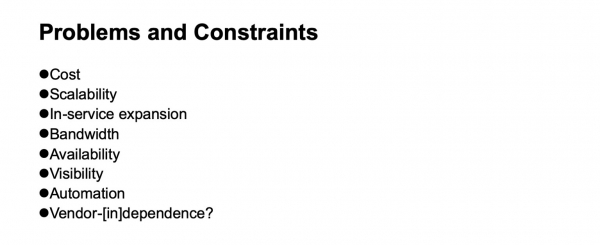
¿Qué problemas surgen y qué limitaciones debemos tener en cuenta al desarrollar una red de centros de datos? Por supuesto, el costo. La escalabilidad, hasta qué nivel queremos crecer. La necesidad de expansión sin detener el servicio. El ancho de banda y la disponibilidad. La visibilidad de lo que sucede en la red para los sistemas de monitoreo y los equipos operativos. El soporte de la automatización, nuevamente, en la medida en que sea posible, ya que diferentes tareas pueden resolverse a diferentes niveles, incluyendo la introducción de capas adicionales. Y la independencia de los proveedores, en la medida de lo posible. Aunque en diferentes períodos históricos, dependiendo de la perspectiva, esta independencia ha sido más fácil o más difícil de lograr. Si tomamos el caso de los chips de dispositivos de red, hasta hace poco hablar de independencia de los proveedores cuando queríamos chips con un gran ancho de banda era muy condicional.
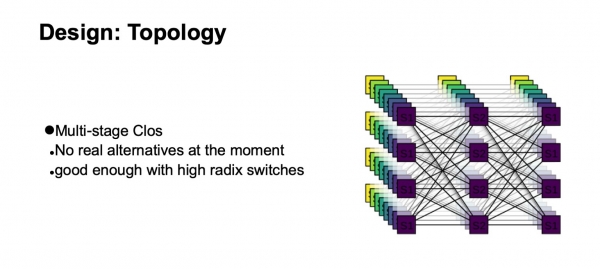
¿Qué topología lógica estaremos utilizando para construir nuestra red? Será un Clos de múltiples niveles. De hecho, actualmente no hay alternativas reales. Y la topología Clos es bastante buena, incluso si la comparamos con diversas topologías avanzadas que en su mayoría están en el ámbito del interés académico, cuando tenemos conmutadores con un alto radix.
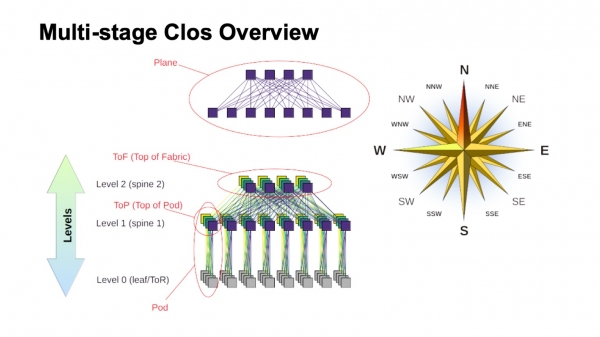
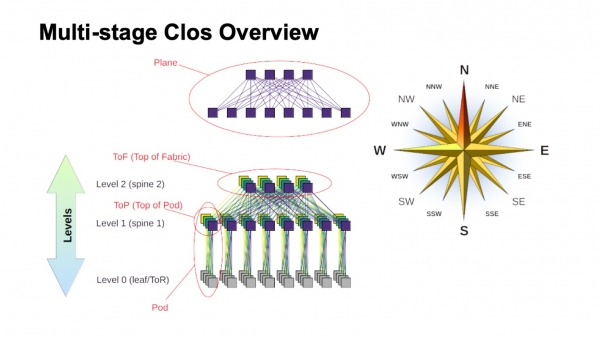
¿Cómo está estructurada aproximadamente una red Clos de múltiples niveles y cómo se llaman los diferentes elementos en ella? En primer lugar, la rosa de los vientos, para orientarnos en el norte, sur, este y oeste. Este tipo de redes generalmente son construidas por aquellos que tienen un tráfico muy alto de oeste a este. En cuanto a los otros elementos, en la parte superior se muestra un conmutador virtual, construido a partir de conmutadores más pequeños. Esta es la idea principal de la construcción recursiva de redes Clos. Tomamos elementos con un cierto radix y los conectamos de tal manera que lo que resulta se puede considerar como un conmutador con un radix más grande. Si se necesita aún más, se puede repetir el proceso.
En el caso, por ejemplo, de Clos de dos niveles, donde se pueden distinguir claramente los componentes que en mi esquema son verticales, se les suele llamar planos. Si construyéramos un Clos con tres niveles de switches spine (todos los que no son bordes y no son ToR, y que se utilizan solo para tránsito), entonces los planos se verían más complejos; los de dos niveles se ven así. El bloque de switches ToR o leaf y los switches spine de primer nivel asociados se llaman Pod. Los switches spine de nivel spine-1 en la parte superior del Pod son el top of Pod, la cima del Pod. Los switches que se encuentran en la parte superior de toda la red son la capa superior del tejido, Top of fabric.
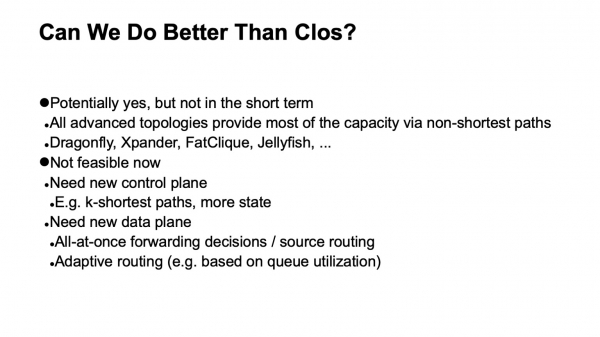
Por supuesto, surge la pregunta: las redes Clos se han construido durante algún tiempo; la idea en sí proviene de la época de la telefonía clásica y las redes TDM. ¿Quizás ha aparecido algo mejor, o se puede hacer algo de una mejor manera? Tanto sí como no. Teóricamente, sí; en la práctica, no en el corto plazo. Porque hay una serie de topologías interesantes, algunas de las cuales incluso se utilizan en producción, por ejemplo, Dragonfly se utiliza en aplicaciones HPC; también hay topologías interesantes como Xpander, FatClique, Jellyfish. Si se revisan los informes de conferencias como SIGCOMM o NSDI en tiempos recientes, se puede encontrar una cantidad bastante considerable de trabajos sobre topologías alternativas que poseen mejores características (de alguna u otra manera) que Clos.
Pero todas estas topologías tienen una propiedad interesante. Esta dificulta su implementación en las redes de centros de datos que intentamos construir sobre hardware común y que tienen un costo razonable. En todas estas topologías alternativas, la mayor parte del ancho de banda, desafortunadamente, no está disponible por los caminos más cortos. Por lo tanto, de inmediato nos privamos de la posibilidad de utilizar un planeamiento de control tradicional.
Teóricamente, la solución al problema es conocida. Estas son, por ejemplo, modificaciones del link state utilizando k-shortest path, pero, de nuevo, no existen protocolos de este tipo que estén implementados en producción y disponibles en masa en el equipamiento.
Además, dado que la mayor parte de la capacidad no está disponible a través de las rutas más cortas, necesitamos modificar no solo el plano de control para que elija todas esas rutas (y, por cierto, esto es un estado significativamente mayor en el plano de control). También necesitamos modificar el plano de reenvío, y generalmente se requieren al menos dos características adicionales. Esta es la capacidad de tomar todas las decisiones de reenvío de paquetes de una sola vez, por ejemplo, en el host. De hecho, esto es enrutamiento por fuente, que a veces en la literatura sobre redes de interconexión se denomina decisiones de reenvío de una vez. Y el enrutamiento adaptativo es ya una función que necesitamos en los elementos de red, que se reduce, por ejemplo, a elegir el siguiente salto basándose en la información sobre la menor carga de la cola. Por ejemplo, pueden existir otras variantes.
Por lo tanto, la dirección es interesante, pero, desafortunadamente, no podemos aplicarla directamente en este momento.
Bueno, nos hemos detenido en la topología lógica de Clos. ¿Cómo la escalaremos? Echemos un vistazo a cómo está configurada y qué se puede hacer.
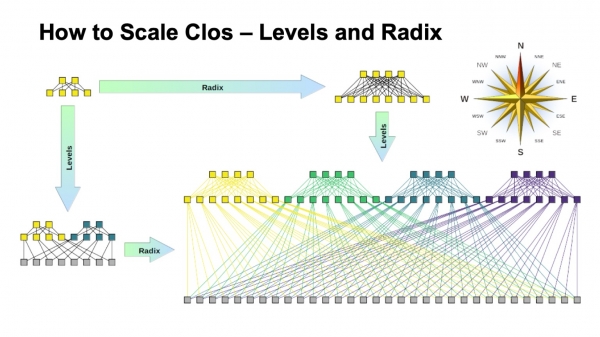
En una red Clos hay dos parámetros principales que podemos variar de alguna manera y obtener diferentes resultados: el radix de los elementos y la cantidad de niveles en la red. He representado esquemáticamente cómo ambos afectan el tamaño. En ideal combinamos ambos.
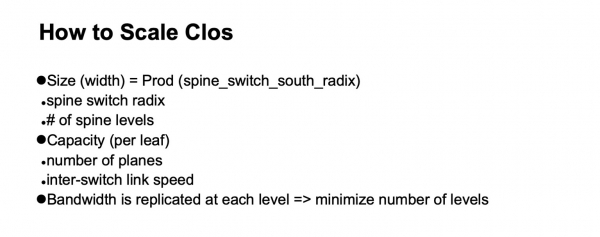
Es evidente que el ancho final de la red Clos es el producto de todos los niveles de los switches de espina del radix sur, cuántos enlaces tenemos hacia abajo, cómo se ramifica. Así es como escalamos el tamaño de la red.
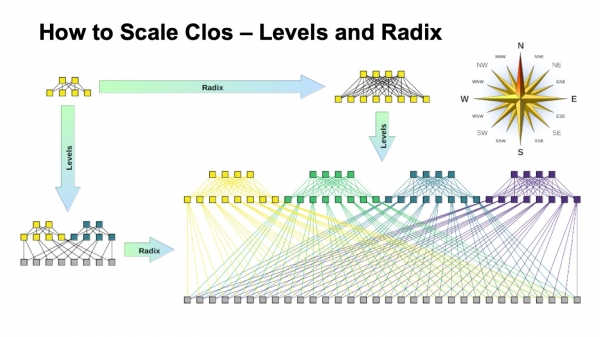
En cuanto a la capacidad, especialmente en los switches ToR, hay dos opciones de escalado. O podemos, manteniendo la topología general, utilizar enlaces de mayor velocidad, o podemos agregar un mayor número de planos.
Si miramos la versión desplegada de la red Clos (en la esquina inferior derecha) y regresamos a esta imagen de la red Clos en la parte inferior...
… entonces es exactamente la misma topología, pero en esta diapositiva está comprimida más compactamente y los planos de la fábrica están superpuestos. Es lo mismo.
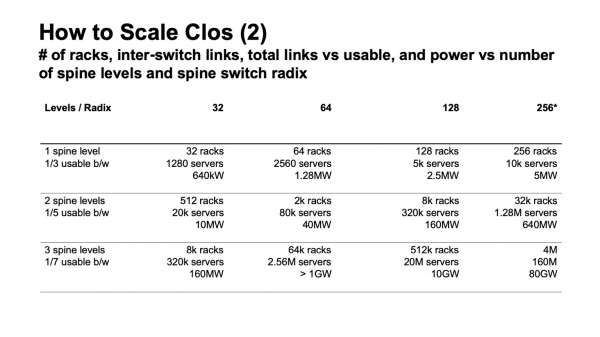
¿Cómo se ve el escalamiento de la red Clos en números? Aquí tengo datos sobre qué ancho máximo puede alcanzar la red, cuántas estanterías, switches ToR o switches leaf, si no están en estanterías, podemos obtener en función de cuál sea el radix de los switches utilizados para los niveles de espina y cuántos niveles utilizamos.
Aquí se muestra cuántos racks podemos tener, cuántos servidores y aproximadamente cuánto pueden consumir en base a 20 kW por rack. Mencioné anteriormente que nuestro objetivo es un tamaño de clúster de alrededor de 100,000 servidores.
Se puede observar que en toda esta configuración hay dos variantes y media que son interesantes. Hay una opción con dos capas de spine y switches de 64 puertos, que se queda un poco corta. Luego, hay variantes que se integran perfectamente para switches de spine de 128 puertos (con radix 128) con dos niveles, así como switches con radix 32 con tres niveles. En todos los casos, donde hay un mayor radix y más niveles, se puede crear una red muy grande, pero si se observa el consumo esperado, generalmente estamos hablando de gigavatios. Se pueden tender cables, pero es poco probable que obtengamos tanta electricidad en un solo lugar. Si miramos las estadísticas, los datos públicos sobre centros de datos muestran que hay muy pocos centros de datos con una potencia estimada superior a 150 MW. Lo que hay más son, por lo general, campus de centros de datos, varios centros de datos grandes ubicados bastante cercanos entre sí.
Hay otro parámetro importante. Si miras la columna de la izquierda, allí se indica el ancho de banda usable. No es difícil notar que en una red Clos, una parte notable de los puertos se utiliza para conectar switches entre sí. El ancho de banda usable es lo que se puede entregar hacia afuera, hacia los servidores. Naturalmente, hablo de puertos condicionales y específicamente del ancho de banda. Por lo general, los enlaces dentro de la red son más rápidos que los enlaces hacia los servidores, pero por cada unidad de ancho de banda que podemos entregar a nuestro equipo de servidores, hay que tener en cuenta algo de ancho de banda dentro de la red misma. Y cuanto más niveles creamos, mayores son los gastos específicos para proporcionar este ancho de banda hacia afuera.
Además, incluso este ancho de banda adicional no es del todo uniforme. Mientras que los tramos son cortos, podemos utilizar algo como DAC (cobre de conexión directa, es decir, cables twinax) o fibra multimodo, que todavía tienen un costo razonable. Tan pronto como pasamos a tramos más largos, generalmente se trata de fibra monomodo, y el costo de este ancho de banda adicional aumenta significativamente.
Y de nuevo, volviendo a la diapositiva anterior, si construimos una red Clos sin redistribución, no es difícil observar el esquema y ver cómo se construye la red: al añadir cada nivel de conmutadores de espina, repetimos todo ese ancho que estaba en la parte inferior. Más un nivel significa sumar el mismo ancho, más puertos en los conmutadores, más transceptores. Por lo tanto, es muy deseable minimizar la cantidad de niveles de conmutadores de espina.
A partir de esta imagen, se puede ver que realmente queremos basarnos en algo como conmutadores con un radix de 128.
Aquí, en principio, es lo mismo que acabo de explicar; esta diapositiva es más bien para considerar después.
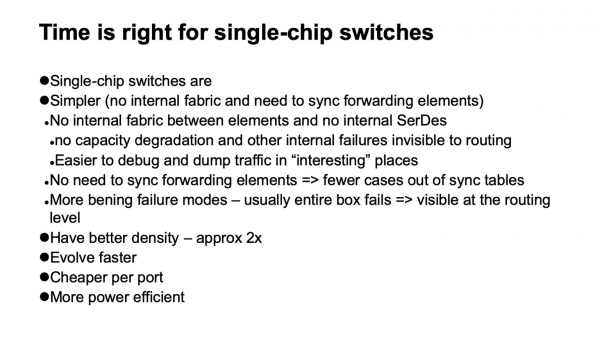
¿Qué opciones tenemos para elegir como estos conmutadores? Una muy buena noticia para nosotros es que ahora es posible construir estas redes con conmutadores de un solo chip. Y eso es genial, ya que tienen muchas características agradables. Por ejemplo, casi no tienen estructura interna. Esto significa que son más propensos a fallar. Se rompen, cómo no, pero, afortunadamente, lo hacen completamente. En los dispositivos modulares, hay una gran cantidad de fallas (muy molestas), donde desde la perspectiva de los vecinos y el plano de control parece que funciona, pero, por ejemplo, ha fallado parte de la fábrica, y no opera a plena capacidad. El tráfico se equilibra como si estuviera completamente funcional, y podemos afrontar sobrecargas.
O, por ejemplo, surgen problemas con el backplane, porque dentro del dispositivo modular también hay SerDes de alta velocidad: realmente está complicado por dentro. O las tablas se sincronizan o no entre los elementos de reenvío. En general, cualquier dispositivo modular de alto rendimiento que consta de un gran número de elementos contiene, como regla, esa misma red Clos, solo que es muy difícil de diagnosticar. A menudo, incluso al proveedor le resulta complicado diagnosticarlo.
Y tiene muchos escenarios de falla en los que el dispositivo se degrada, pero no sale completamente de la topología. Dado que nuestra red es grande, se utiliza activamente el balanceo entre elementos idénticos, la red es muy regular, es decir, un camino en el que todo está bien no se diferencia de otro camino, nos conviene simplemente perder parte de los dispositivos de la topología que caer en una situación donde algunos de ellos parecen funcionar, pero no lo hacen.
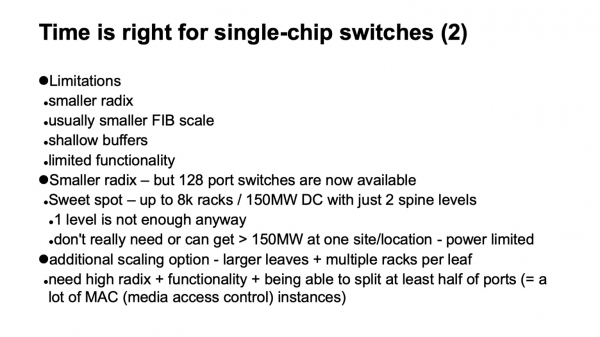
Una siguiente ventaja agradable de los dispositivos de chip único es que evolucionan mejor y más rápido. Además, generalmente tienen una mejor capacidad. Si consideramos grandes construcciones ensambladas, la capacidad por unidad de rack en los puertos de la misma velocidad resulta casi dos veces mejor que en los dispositivos modulares. Los dispositivos construidos alrededor de un solo chip son notablemente más económicos que los modulares y consumen menos energía.
Pero, por supuesto, todo esto tiene sus desventajas. En primer lugar, casi siempre un radix menor que en los dispositivos modulares. Si podemos obtener un dispositivo construido alrededor de un solo chip con 128 puertos, el modular podemos obtenerlo con varios cientos de puertos sin problemas significativos.
Esto resulta en un tamaño notablemente más pequeño de las tablas de reenvío y, en general, de todo lo relacionado con la escalabilidad del plano de datos. Buffers poco profundos. Y, en general, una funcionalidad bastante limitada. Pero resulta que si conocemos estas limitaciones y nos preocupamos por superarlas a tiempo o simplemente tenerlas en cuenta, no es tan aterrador. El hecho de que el radix sea menor ya no es un problema en los nuevos dispositivos con radix 128, podemos construir en dos capas de spine. Y no se puede construir nada interesante en tamaños menores a dos. Con un solo nivel se obtienen clústeres muy pequeños. Incluso nuestros diseños y requisitos anteriores ya los superaban.
De hecho, si la solución está al borde de un límite, hay otra forma de escalar. Dado que el último (o primero) nivel más bajo, al que se conectan los servidores, son los switches ToR o switches leaf, no estamos obligados a conectar solo un rack a ellos. Por lo tanto, si la solución no alcanza el nivel en un factor de dos, se puede considerar simplemente utilizar un switch con un mayor radix en el nivel inferior y conectar, por ejemplo, dos o tres racks a un switch. Esta también es una opción, que tiene sus propios costos, pero funciona bien y puede ser una buena solución cuando es necesario extender el tamaño en un factor de dos.
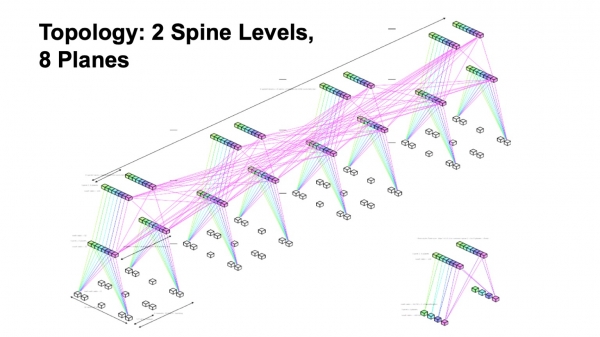
En resumen, estamos construyendo una topología con dos niveles de spine y ocho capas de fábrica.
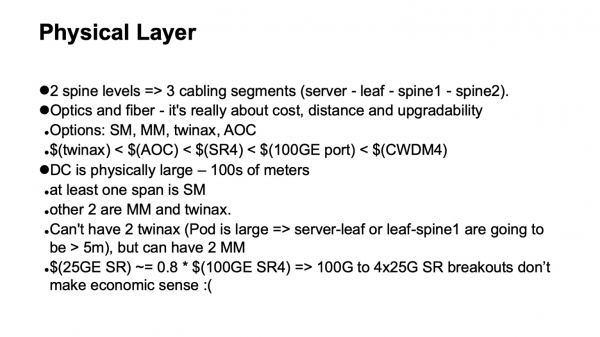
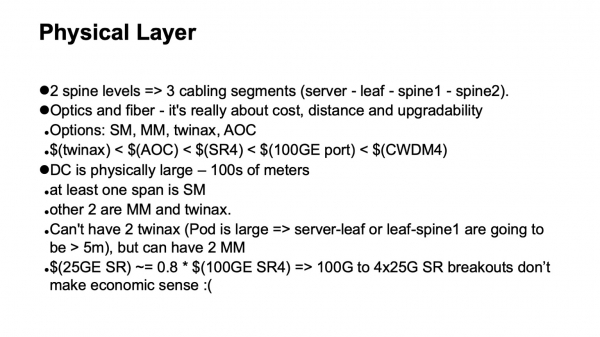
¿Qué pasará con la física? Cálculos muy simples. Si tenemos dos niveles de spine, significa que tenemos un total de tres niveles de switches, y esperamos que haya tres segmentos de cable en la red: desde los servidores hasta los switches leaf, hacia el spine 1, hacia el spine 2. Las opciones que podemos utilizar son twinax, multimodo y modo único. Y aquí hay que considerar cuánta banda está disponible, cuánto costará, cuáles son las dimensiones físicas, qué tramos podemos atravesar y cómo vamos a realizar las mejoras.
En cuanto a costos, se puede estructurar todo en una línea. Los twinax son significativamente más baratos que la óptica activa, más baratos que los transceptores multimodo, si se considera el tramo desde el final, un poco más baratos que el puerto de 100 gigabits del switch. Y, atención, es más barato que la óptica de modo único, porque en los tramos donde se requiere modo único, tiene sentido utilizar CWDM en los centros de datos por varias razones. Trabajar con single mode paralelo (PSM) no es muy conveniente, se obtienen paquetes de fibra muy grandes, y si nos detenemos en estas tecnologías, resulta que hay una jerarquía de precios.
Un comentario más: desafortunadamente, no es muy factible utilizar puertos multimodo descompuestos de 100 a 4x25. Debido a las características de diseño de los transceptores, el SFP28 no cuesta mucho menos que el QSFP28 de 100 Gbps. Y esta descomposición para multimodo no funciona muy bien.
Otra limitación es que, debido al tamaño de los clústeres de computación y la cantidad de servidores, nuestros centros de datos resultan ser físicamente grandes. Esto significa que al menos un tramo deberá hacerse con modo simple. Nuevamente, debido al tamaño físico de los Pods, no será posible pasar dos tramos con twinax (cables de cobre).
En resumen, si optimizamos por precio y consideramos la geometría de esta construcción, obtenemos un tramo con twinax, un tramo con multimodo y un tramo con modo simple utilizando CWDM. Esto tiene en cuenta posibles caminos de actualización.
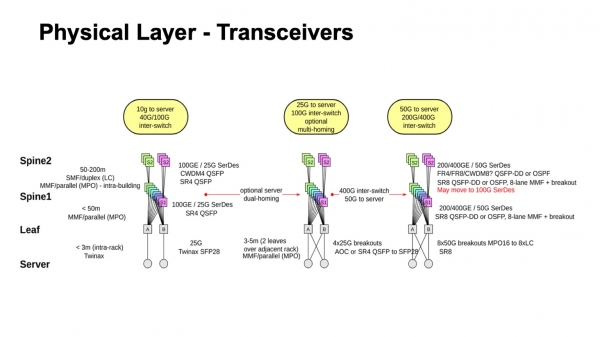
Así es como se ve lo que ha sido recientemente, hacia dónde nos dirigimos y lo que es posible. Está claro, al menos, cómo avanzar hacia los SerDes de 50 gigabits tanto para multimodo como para modo simple. Además, si miramos lo que hay en los transceptores de modo simple ahora y en perspectiva para 400G, a menudo, incluso cuando llegan los SerDes de 50G del lado eléctrico, en óptica pueden estar ya enviando 100 Gbps por canal. Por lo tanto, es bastante posible que en lugar de pasar a 50 se realice una transición a SerDes de 100 gigabits y 100 Gbps por canal, porque según promesas de muchos proveedores, su disponibilidad se espera bastante pronto. El período en que los SerDes de 50G fueron los más rápidos parece que no durará mucho, porque los SerDes de 100G se lanzarán casi el próximo año en sus primeras versiones. Y después de un tiempo, es posible que cuesten precios razonables.
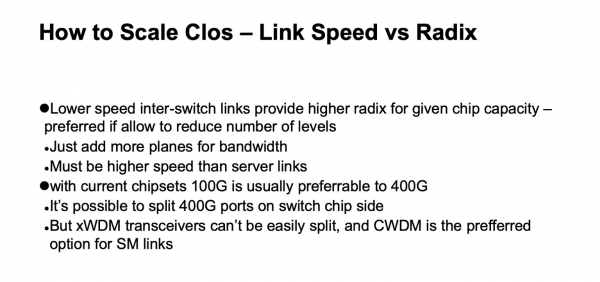
Otro matiz sobre la elección de la física. En principio, ya podemos utilizar puertos de 400 o 200 gigabits con SerDes de 50G. Pero resulta que esto no tiene mucho sentido, porque, como mencioné anteriormente, queremos un radix bastante grande en los conmutadores, dentro de lo razonable, por supuesto. Queremos 128. Y si la capacidad del chip está limitada y aumentamos la velocidad del enlace, entonces, naturalmente, el radix disminuye, no hay milagros.
Y podemos aumentar la capacidad total mediante planos, y para ello no hay costos especiales, se puede aumentar la cantidad de planos. Si perdemos el radix, tendremos que introducir un nivel adicional, por lo que con los cálculos actuales, con la capacidad máxima disponible en un chip, resulta que es más eficiente utilizar puertos de 100 gigabits, porque permiten obtener un mayor radix.
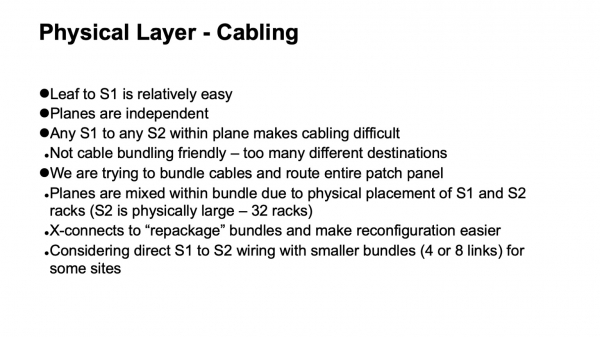
La siguiente cuestión es cómo se organiza la física, pero ya desde la perspectiva de la infraestructura de cableado. Resulta que está organizada de una manera bastante interesante. El cableado entre los switches leaf y los spine switches de primer nivel no tiene tantos enlaces; todo se construye de manera relativamente simple. Pero si tomamos un plano, lo que ocurre en el interior es que es necesario conectar todos los spine switches de primer nivel con todos los spine switches de segundo nivel.
Además, generalmente hay ciertos deseos en cuanto a cómo debería verse el interior del centro de datos. Por ejemplo, teníamos muchas ganas de agrupar los cables en un conjunto y tirarlos de tal manera que un panel de parcheo de alta densidad se conectara completamente a otro panel de parcheo, evitando así el 'zoológico' de longitudes. Logramos resolver este problema. Si miramos inicialmente la topología lógica, se puede ver que los planos son independientes; cada plano puede construirse por sí mismo. Pero cuando añadimos tal agrupación y queremos llevar completamente un panel de parcheo a otro, es necesario mezclar diferentes planos dentro de un solo conjunto e introducir una estructura intermedia en forma de conexiones cruzadas ópticas, para reorganizarlos desde cómo fueron ensamblados en un segmento hasta cómo serán ensamblados en otro segmento. Gracias a esto, obtenemos una característica agradable: toda la conmutación compleja no sale del límite de los racks. Cuando es necesario entrelazar algo muy intensamente, 'desplegar planos', como a veces se llama en las redes Clos, todo se concentra dentro de un solo rack. No tenemos conmutaciones muy desordenadas, hasta el punto de individualizar enlaces, entre los racks.
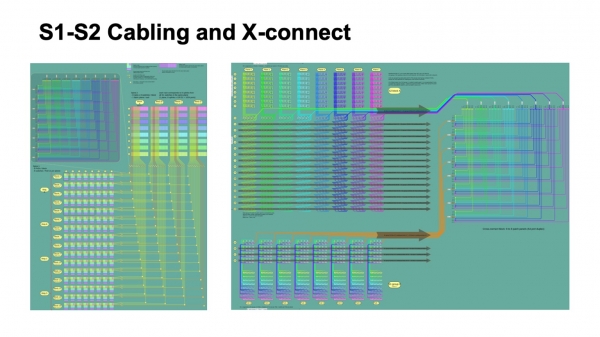
Así es como se ve desde la perspectiva de la organización lógica de la infraestructura de cableado. En la imagen a la izquierda, los bloques de colores representan los bloques de spine switches de primer nivel, ocho en total, y los cuatro conjuntos de cables que salen de ellos, que se cruzan con los conjuntos que provienen de los bloques de spine-2 switches.
Pequeños cuadrados representan intersecciones. En la parte superior izquierda se muestra el desglose de cada intersección; esto es, en realidad, un módulo de cruce de 512 a 512 puertos, que reorganiza los cables para llegar completamente a un rack, donde solo hay un plano de spine-2. Y a la derecha, el desglose de esta imagen es un poco más detallada en relación a varios Pods a nivel spine-1, y cómo se empaqueta en el cruce, cómo llega al nivel spine-2.
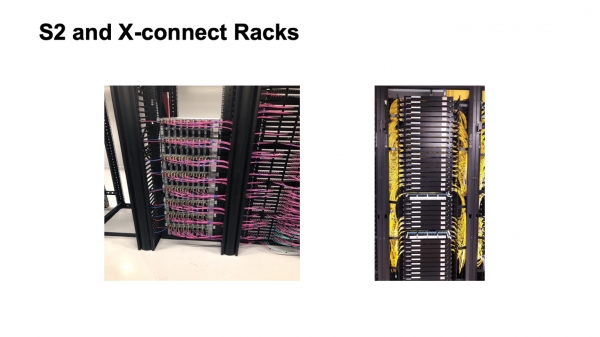
Así es como se ve. Un rack spine-2 aún no completamente montado (a la izquierda) y un rack de cruce. Desafortunadamente, no hay mucho visible. Toda esta construcción se está desplegando en este momento en uno de nuestros grandes centros de datos, que está en expansión. Es un trabajo en proceso, se verá mejor, estará mejor lleno.
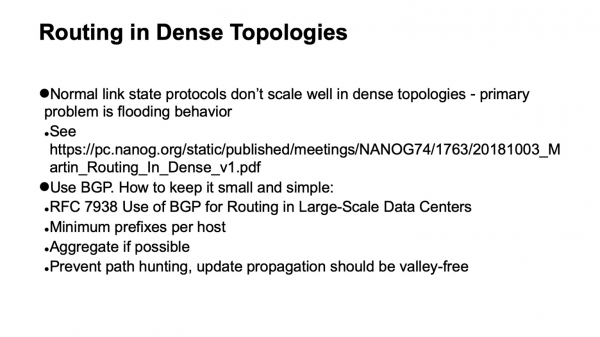
Una cuestión importante: se eligió la topología lógica, se construyó la física. ¿Qué pasará con el plano de control? Se sabe bastante bien por experiencia operativa, hay cierta cantidad de presentaciones que dicen que los protocolos de estado de enlace son buenos, son agradables de trabajar, pero, desafortunadamente, en una topología densamente cableada, no se escalan bien. Y hay un factor principal que lo impide: así es como funciona la difusión en los protocolos de estado de enlace. Si simplemente tomamos el algoritmo de difusión y miramos cómo está estructurada nuestra red, se ve que en cada paso habrá un gran fanout, y simplemente inundará el plano de control con actualizaciones. Específicamente, tales topologías con el algoritmo tradicional de difusión en los protocolos de estado de enlace se mezclan muy mal.
La elección es usar BGP. Cómo prepararlo correctamente se describe en el RFC 7938 sobre el uso de BGP en grandes centros de datos. Las ideas básicas son simples: el mínimo número de prefijos por host y, en general, el mínimo número de prefijos en la red, usar agregación si es posible, y suprimir la búsqueda de rutas. Queremos una propagación de actualizaciones muy cuidadosa y muy controlada, lo que se llama valley free. Queremos que las actualizaciones, al pasar por la red, se desplieguen exactamente una vez. Si se originan en la parte inferior, se dirigen hacia arriba, y se despliegan no más de una vez. No debe haber zigzagueos. Los zigzagueos son muy malos.
Para hacerlo, utilizamos un esquema bastante simple para usar los mecanismos básicos de BGP. Es decir, utilizamos eBGP, que opera en el enlace local, y las sistemas autónomos se asignan de la siguiente manera: una sistema autónomo en ToR, una sistema autónomo para todo el bloque de switches spine-1 de un Pod, y un sistema autónomo compartido para todo el Top of Fabric. No es difícil ver y comprobar que incluso el comportamiento normal de BGP nos proporciona la distribución de actualizaciones que deseamos.
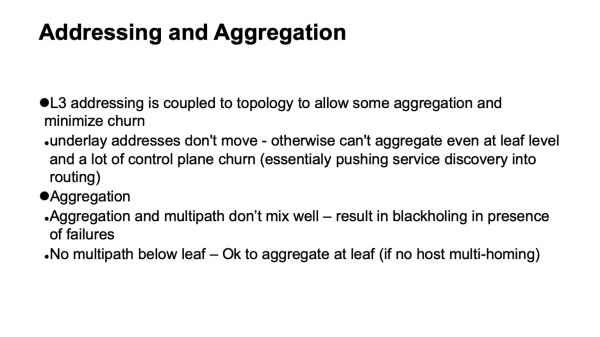
Naturalmente, hay que diseñar la direccionamiento y la agregación de direcciones para que sea compatible con cómo se construye el enrutamiento, para garantizar la estabilidad del control de planes. La direccionamiento L3 en el transporte está ligado a la topología, porque sin eso no se puede lograr la agregación, de lo contrario, las direcciones individuales se colarán en el sistema de enrutamiento. Y otra cosa es que la agregación, lamentablemente, no se mezcla muy bien con el multi-path, porque cuando tenemos multi-path y agregación, todo va bien cuando toda la red está operativa y no hay fallos. Desafortunadamente, tan pronto como hay fallos en la red y se pierde la simetría de la topología, podemos llegar a un punto desde el que se anunció el agregado al que no se puede avanzar hacia donde necesitamos. Por lo tanto, es mejor agregar donde no haya multi-path, en nuestro caso, son los switches ToR.
De hecho, se puede agregar, pero con precaución. Si podemos hacer una desagregación controlada ante fallos en la red. Pero esta es una tarea bastante complicada, incluso evaluamos si sería posible hacerlo, si se podría implementar automatismos adicionales, y autómatas finales que patearían BGP correctamente para obtener el comportamiento deseado. Desafortunadamente, el manejo de casos extremos es muy poco claro y complicado, y en la incorporación de equipos externos a BGP, esta tarea no se resuelve bien.
Un trabajo muy interesante en este sentido se ha hecho en el marco del protocolo RIFT, que se presentará en la siguiente conferencia.
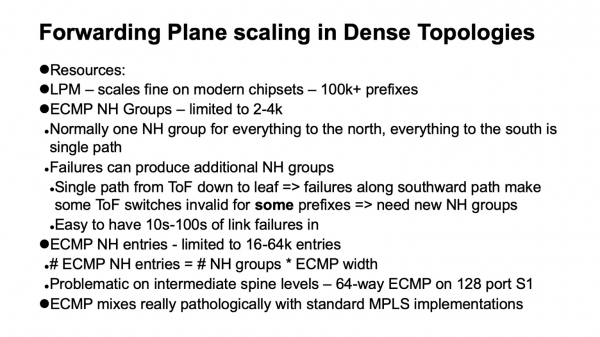
Otra cosa importante es cómo se escalan los data planes en topologías densas, donde hay una gran cantidad de caminos alternativos. Para esto se utilizan varias estructuras de datos adicionales: grupos de ECMP, que describen a su vez los grupos de Next Hop.
En una red que funciona normalmente, sin fallos, cuando ascendemos por la topología Clos, es suficiente utilizar solo un grupo, porque todo lo que no es local se describe por defecto, se puede subir. Cuando vamos de arriba hacia abajo hacia el sur, todos los caminos no son ECMP, son caminos de un solo trayecto. Todo va bien. El problema, y la peculiaridad de la topología Clos clásica, es que si miramos en la parte superior de la tela, cualquier elemento, hasta cualquier elemento en la parte inferior tiene un solo camino. Si a lo largo de este camino ocurren fallos, entonces ese elemento en la parte superior de la tela se vuelve inválido específicamente para aquellos prefijos que están detrás del camino roto. Pero para los demás es válido, y tenemos que descomponer los grupos ECMP y introducir un nuevo estado.
¿Cómo se ve la escalabilidad del plano de datos en los dispositivos modernos? Si hacemos LPM (coincidencia del prefijo más largo), todo va bastante bien, por encima de 100k prefijos. Si hablamos de grupos de Next Hop, la situación es peor, de 2 a 4 mil. Si hablamos de la tabla que contiene la descripción de los Next Hops (o adyacencias), esto es de aproximadamente 16k a 64k. Y esto puede convertirse en un problema. Y aquí llegamos a un interesante aparte: ¿qué sucedió con MPLS en los centros de datos? En principio, queríamos implementarlo.
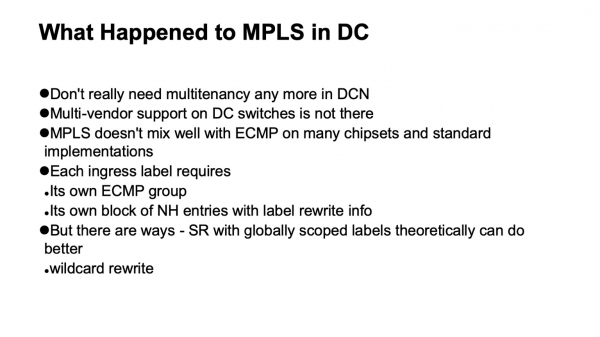
Pasaron dos cosas. Hicimos microsegmentación en los hosts, y ya no necesitábamos hacerlo en la red. No fue muy bueno recibir soporte de diferentes proveedores y mucho menos de implementaciones abiertas en cajas blancas con MPLS. Además, MPLS, al menos sus implementaciones tradicionales, desafortunadamente, se combina muy mal con ECMP. Y esta es la razón.
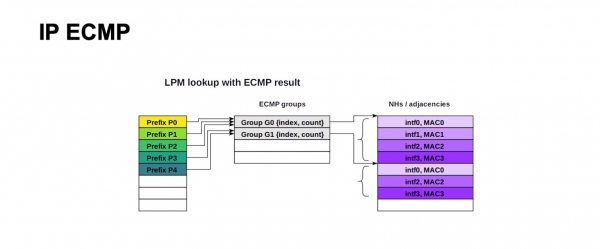
Así es como se ve la estructura de reenvío ECMP para IP. Un gran número de prefijos puede usar el mismo grupo y el mismo bloque de Next Hops (o adyacencias, en diferentes documentos para diferentes dispositivos esto puede llamarse de diferentes maneras). La idea es que esto se describe como el puerto de salida y cómo reescribir la dirección MAC para llegar al Next Hop correcto. Para IP todo se ve sencillo, se puede usar para una gran cantidad de prefijos en el mismo grupo, el mismo bloque de Next Hops.
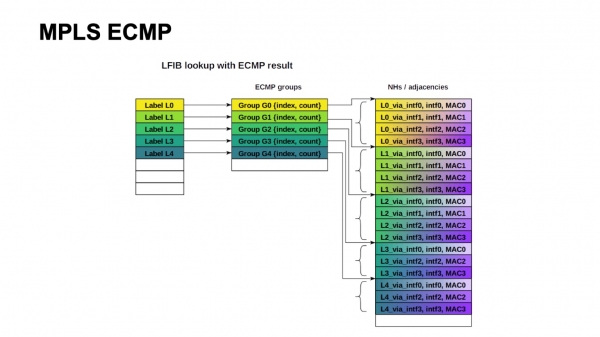
La arquitectura clásica de MPLS implica que, dependiendo de la interfaz de salida, la etiqueta puede reescribirse en diferentes valores. Por lo tanto, necesitamos mantener un grupo y un bloque de Next Hops para cada etiqueta de entrada. Y esto, lamentablemente, no escala.
No es difícil ver que en nuestra construcción necesitábamos alrededor de 4000 interruptores ToR, con una máxima anchura de 64 caminos ECMP, si nos alejamos del spine-1 hacia el spine-2. Apenas logramos encajar, en el límite, en una tabla de grupos ECMP, si solo un prefijo con ToR se va, y de hecho no encajamos en la tabla Next Hops.
Todo no está perdido, porque las arquitecturas como Segment Routing implican etiquetas globales. Formalmente, se podrían nuevamente compactar todos estos bloques Next Hops. Para esto se necesita una operación de tipo wild card: tomar una etiqueta y reescribirla a la misma sin un valor específico. Pero, desafortunadamente, esto no está muy presente en las implementaciones disponibles.
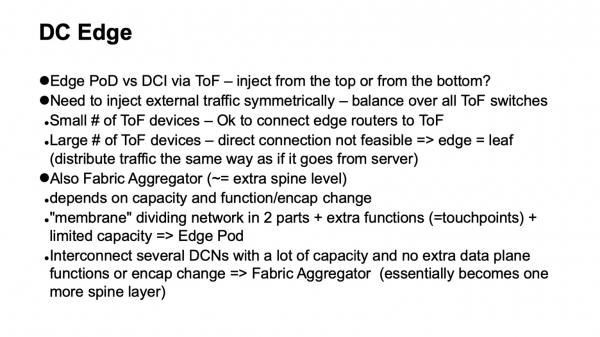
Y finalmente, necesitamos llevar tráfico externo al centro de datos. ¿Cómo hacerlo? Anteriormente, el tráfico se introducía en las redes Clos desde arriba. Es decir, había enrutadores de frontera que se conectaban a todos los dispositivos en la parte superior de la tela. Esta solución funciona bastante bien en tamaños pequeños y medianos. Desafortunadamente, para introducir tráfico de esta manera de manera simétrica en toda la red, es necesario llegar a todos los elementos de la parte superior de la tela a la vez, y cuando su número supera el centenar, se descubre que necesitamos un gran radix también en los enrutadores de frontera. En general, esto cuesta dinero, porque los enrutadores de frontera son más funcionales, los puertos en ellos serán más caros, y el resultado no es una construcción muy estética.
Otra opción es introducir ese tráfico desde abajo. No es difícil comprobar que la topología Clos está construida de tal manera que el tráfico que entra desde abajo, es decir, desde el lado de ToR, se distribuye uniformemente por los niveles en toda la parte superior de la tela en dos iteraciones, cargando toda la red. Por lo tanto, introducimos un tipo especial de Pod, Edge Pod, que proporciona conectividad externa.
Hay otra opción. Por ejemplo, así lo hace Facebook. Ellos lo llaman Fabric Aggregator o HGRID. Se introduce un nivel adicional de backbone para conectar varios centros de datos. Esta construcción es posible si no tenemos funciones adicionales o cambios de encapsulación en las interfaces. Si los hay, son puntos de contacto adicionales, lo que complica el proceso. Generalmente, esto implica más funciones y una especie de membrana que separa diferentes partes del centro de datos. No es recomendable hacer esta membrana demasiado grande, y si es realmente necesaria, tiene sentido considerar la posibilidad de moverla, ampliarla y trasladarla a los hosts. Esto es lo que hacen muchos operadores en la nube. Tienen superposiciones que comienzan con los hosts.
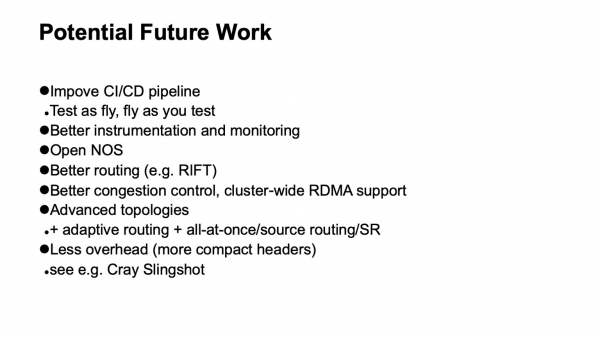
¿Cuáles son las oportunidades de desarrollo que vemos? Primero que nada, la mejora del soporte para el pipeline de CI/CD. Queremos volar como probamos y probar como volamos. Esto no se logra adecuadamente debido a que la infraestructura es grande, y duplicarla para realizar pruebas es imposible. Necesitamos entender cómo integrar elementos de prueba en la infraestructura operativa sin que se caiga.
Un mejor instrumentación y mejores monitoreos nunca son de más. La cuestión es el equilibrio entre esfuerzo y resultado. Si se puede añadir de manera razonable, es muy bueno.
Sistemas operativos abiertos para dispositivos de red. Los mejores protocolos y los mejores sistemas de enrutamiento, como RIFT. También son necesarias investigaciones sobre la aplicación de los mejores esquemas de control de congestión y, posiblemente, la introducción, al menos en algunos puntos, de soporte para RDMA dentro del clúster.
Si miramos hacia un futuro más lejano, se necesitan topologías avanzadas y, posiblemente, redes que utilicen menos overhead. De las novedades, recientemente se publicaron artículos sobre la tecnología de fábricas para HPC Cray Slingshot, que se basa en Ethernet comercial, pero con la opción de utilizar encabezados mucho más cortos. Como resultado, se reduce el overhead.
Todo debe hacerse tan simple como sea posible, pero no más. La complejidad es enemiga de la escalabilidad. La simplicidad y las estructuras regulares son nuestras aliadas. Si se puede hacer scale out en alguna parte, háganlo. Y en general, es un buen momento para trabajar en tecnologías de red. Hay muchas cosas interesantes sucediendo. Gracias.
Fuente: habr.com
