

Cada servicio cuyos usuarios pueden crear su propio contenido (UGC - Contenido generado por el usuario) se ve obligado a no solo abordar los desafíos comerciales, sino también a organizar el UGC. Una moderación deficiente o de mala calidad del contenido puede, en última instancia, disminuir la atractividad del servicio para los usuarios, hasta el punto de que podría dejar de funcionar.
Hoy les contaremos sobre la sinergia entre Yula y Odnoklassniki, que nos ayuda a moderar eficientemente los anuncios en Yula.
La sinergia es algo muy útil, y en el mundo actual, donde las tecnologías y las tendencias cambian muy rápidamente, puede convertirse en una varita mágica. ¿Por qué gastar recursos escasos y tiempo en inventar lo que ya se ha inventado y perfeccionado antes?
Así lo pensamos nosotros también, cuando se nos presentó el desafío de moderar el contenido generado por los usuarios: imágenes, texto y enlaces. Nuestros usuarios cargan millones de unidades de contenido en Yula todos los días, y sin un procesamiento automático, moderar todos esos datos manualmente es completamente irreal.
Por eso, utilizamos una plataforma de moderación ya existente, que para entonces nuestros colegas de Odnoklassniki habían perfeccionado hasta un estado de "casi perfección".
¿Por qué Odnoklassniki?
Diariamente, la red social recibe decenas de millones de usuarios que publican miles de millones de unidades de contenido: desde fotos hasta videos y textos. La plataforma de moderación de Odnoklassniki ayuda a verificar volúmenes muy grandes de datos y a contrarrestar a los spammers y bots.
El equipo de moderación de OК ha acumulado una gran experiencia, ya que ha estado perfeccionando su herramienta durante 12 años. Es importante que no solo podían compartir sus soluciones ya preparadas, sino también adaptar la arquitectura de su plataforma a nuestras tareas específicas.
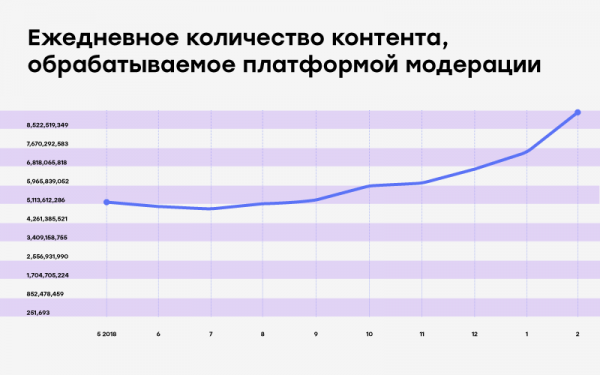
A partir de ahora, por brevedad, llamaremos a la plataforma de moderación de OК simplemente "plataforma".
Cómo funciona todo
Entre Yula y Odnoklassniki, el intercambio de datos se lleva a cabo a través de .
Por qué elegimos esta herramienta:
- En Yula, todos los anuncios pasan por post-moderación, por lo que inicialmente no se requería una respuesta sincrónica.
- Si ocurre un grave inconveniente y Yula u Odnoklassniki no están disponibles, incluso debido a una carga máxima, los datos de Kafka no se perderán y se podrán leer más tarde.
- La plataforma ya se había integrado con Kafka, por lo que la mayoría de las cuestiones de seguridad se habían resuelto.
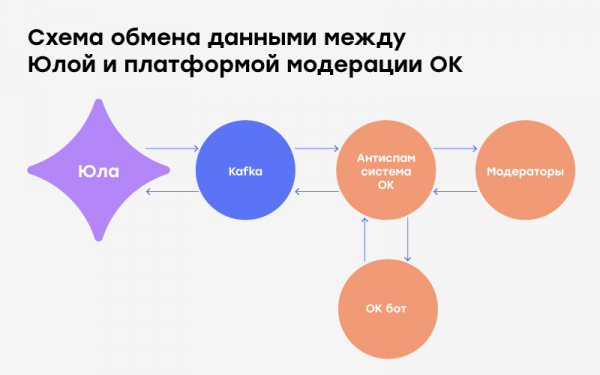
Para cada anuncio creado o modificado por el usuario en Yula, se genera un JSON con los datos, que se coloca en Kafka para su posterior moderación. Desde Kafka, los anuncios se cargan en la plataforma, donde se toman decisiones automáticamente o manualmente. Los anuncios malos se bloquean con la indicación de la razón, mientras que aquellos en los que la plataforma no encontró violaciones se marcan como "buenos". Luego, todas las decisiones se envían de vuelta a Yula y se aplican en el servicio.
En resumen, para Yula todo se reduce a acciones simples: enviar el anuncio a la plataforma de Odnoklassniki y recibir de vuelta la resolución "ok", o explicaciones de por qué no es "ok".
Procesamiento automático
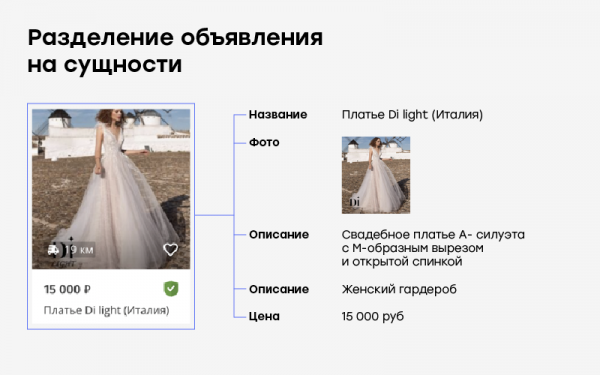
¿Qué sucede con el anuncio después de que llega a la plataforma? Cada anuncio se descompone en varias entidades:
- título,
- descripción,
- fotografías,
- categoría y subcategoría seleccionadas por el usuario del anuncio,
- precio.
Luego, la plataforma realiza una agrupación por cada entidad para encontrar duplicados. El texto y las fotografías se agrupan según diferentes esquemas.
Los textos se normalizan antes de la agrupación para eliminar caracteres especiales, letras alteradas y otros desechos. Los datos obtenidos se dividen en N-gramas, cada uno de los cuales se hashea. Al final, se obtiene un conjunto de hashes únicos. La similitud entre los textos se determina según entre los dos conjuntos obtenidos. Si la similitud es superior al umbral, los textos se combinan en un solo clúster. Para acelerar la búsqueda de clústeres similares se utiliza MinHash y hashing sensible a la localidad.
Para las fotografías se han ideado varias opciones de combinación de imágenes, desde la comparación de pHash de las imágenes hasta la búsqueda de duplicados mediante redes neuronales.
El último método es el más "estricto". Para entrenar el modelo, se seleccionaron tríos de imágenes (N, A, P), donde N no se parece a A, y P se parece a A (es un semiduplicado). Luego, la red neuronal se entrenó para que A y P estuvieran lo más cerca posible, y A y N lo más lejos posible. De este modo, se obtienen menos falsos positivos en comparación con simplemente tomar las incrustaciones de una red preentrenada.
Cuando una red neuronal recibe imágenes, genera un vector N(128)-dimensional para cada una de ellas y realiza una consulta para evaluar la proximidad de la imagen. Luego, se calcula un umbral, a partir del cual las imágenes cercanas se consideran duplicados.
El modelo es experto en detectar spammers que fotografían intencionadamente el mismo producto desde diferentes ángulos para eludir la comparación por pHash.
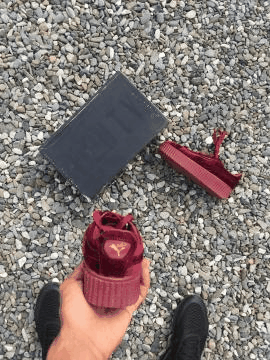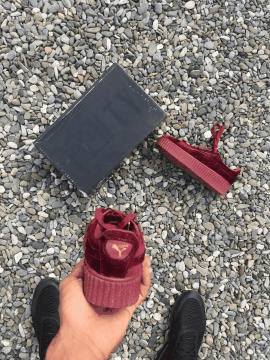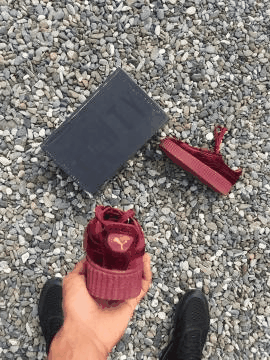
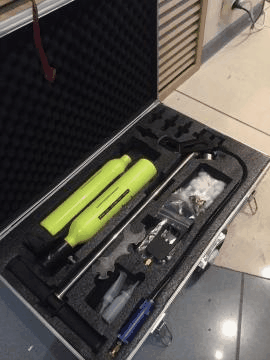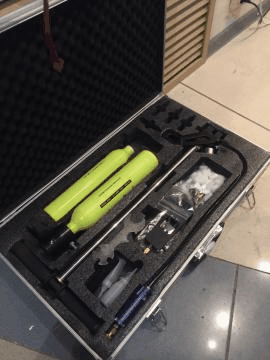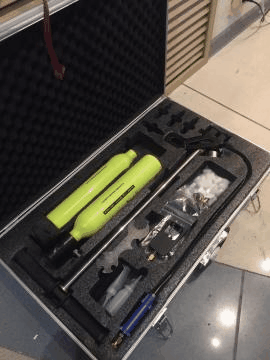
Ejemplo de fotos de spammers, unidas por una red neuronal como duplicados.
En la etapa final, se buscan duplicados de anuncios simultáneamente tanto por el texto como por la imagen.
Si en el clúster se combinan dos o más anuncios, el sistema inicia un bloqueo automático que, según ciertos algoritmos, elige qué duplicados eliminar y cuáles dejar. Por ejemplo, si dos usuarios tienen las mismas fotos en sus anuncios, el sistema bloqueará el anuncio más reciente.
Después de su creación, todos los clústeres pasan por una serie de filtros automáticos. Cada filtro asigna a un clúster una cantidad de puntos (score): la probabilidad de que contenga la amenaza identificada por ese filtro.
Por ejemplo, el sistema analiza la descripción del anuncio y elige posibles categorías para él. Luego toma aquella con la mayor probabilidad y la compara con la categoría que indicó el autor del anuncio. Si no coinciden, el anuncio se bloquea por categoría incorrecta. Y dado que somos amables y honestos, le decimos directamente al usuario qué categoría debe elegir para que su anuncio pase la moderación.
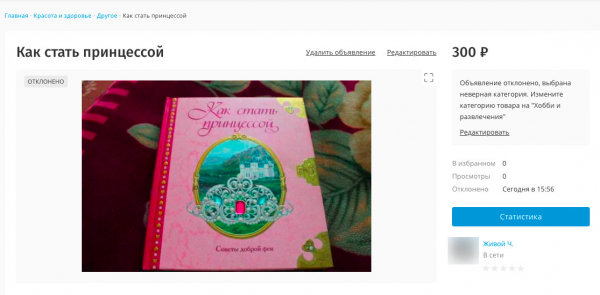
Notificación de bloqueo por categoría incorrecta.
En nuestra plataforma, el aprendizaje automático se siente como en casa. Por ejemplo, con su ayuda, buscamos productos prohibidos en títulos y descripciones en la Federación Rusa. Los modelos de redes neuronales inspeccionan minuciosamente las imágenes en busca de URLs, textos de spam, números de teléfono y todo tipo de productos 'prohibidos'.
Para los casos en los que se intenta vender un producto prohibido disfrazándolo de algo legal, y no hay texto alguno ni en el título ni en la descripción, utilizamos la etiquetación de imágenes. Se pueden asignar hasta 11,000 distintas etiquetas a cada imagen, describiendo lo que hay en ella.
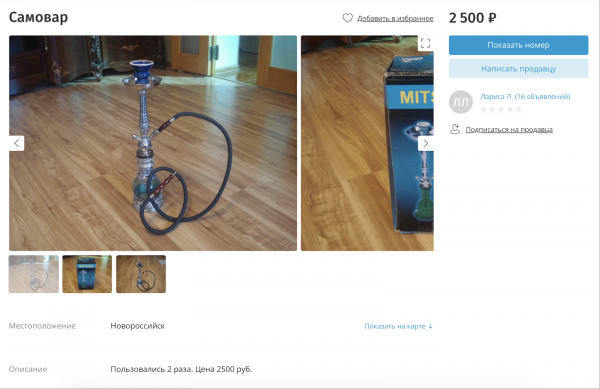
Se intenta vender un cachimba disfrazándolo de samovar.
Junto a los filtros complejos, también funcionan los simples, que resuelven tareas evidentes relacionadas con el texto:
- anti-mat;
- detector de URL y números de teléfono;
- mención de mensajeros y otros contactos;
- precio subestimado;
- anuncios en los que no se vende nada, etc.
Hoy en día, cada anuncio pasa a través de un fino tamiz de más de 50 filtros automáticos que intentan encontrar algo negativo en el anuncio.
Si ninguno de los detectores se activa, Yula recibe una respuesta de que, "probablemente", todo está en orden con el anuncio. Aplicamos esta respuesta, y los usuarios que se han suscrito al vendedor reciben una notificación sobre la aparición de un nuevo producto.
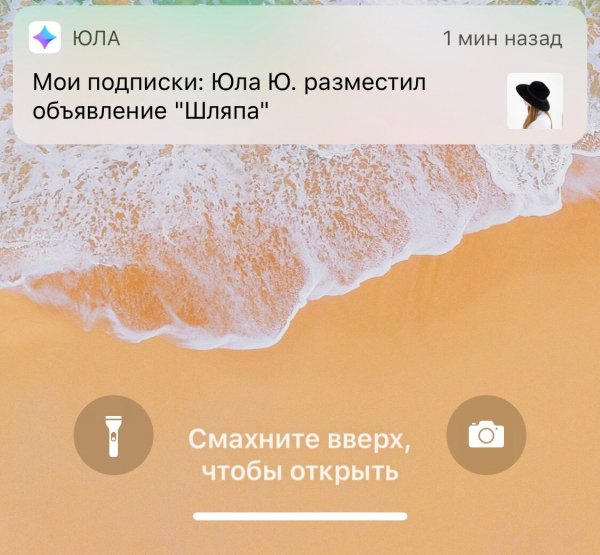
Notificación de que el vendedor ha agregado un nuevo producto.
Como resultado, cada anuncio "se adorna" con metadatos, parte de los cuales se generan al crear el anuncio (la dirección IP del autor, user-agent, plataforma, geolocalización, etc.), y lo demás son puntos otorgados por cada filtro.
Colas de anuncios
Cuando un anuncio ingresa a la plataforma, el sistema lo coloca en una de las colas. Cada cola se forma mediante una fórmula matemática que combina los metadatos del anuncio de tal manera que se detecte algún patrón negativo.
Por ejemplo, se puede crear una cola de anuncios en la categoría "Teléfonos móviles" de usuarios de Yula supuestamente de San Petersburgo, pero con direcciones IP de Moscú u otras ciudades.
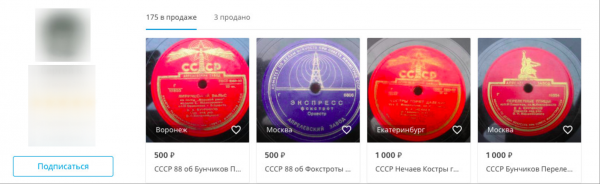
Ejemplo de anuncios publicados por un mismo usuario en diferentes ciudades.
O se pueden formar colas basadas en los puntos que la red neuronal asigna a los anuncios, clasificándolos en orden descendente.
Cada cola, de acuerdo con su fórmula, asigna una puntuación final al anuncio. Luego se puede actuar de diferentes maneras:
- indicar un umbral en el que el anuncio recibirá un cierto tipo de bloqueo;
- enviar todos los anuncios en la cola a moderadores para revisión manual;
- o combinar las opciones anteriores: establecer un umbral de bloqueo automático y enviar a los moderadores aquellos anuncios que no alcanzaron ese umbral.
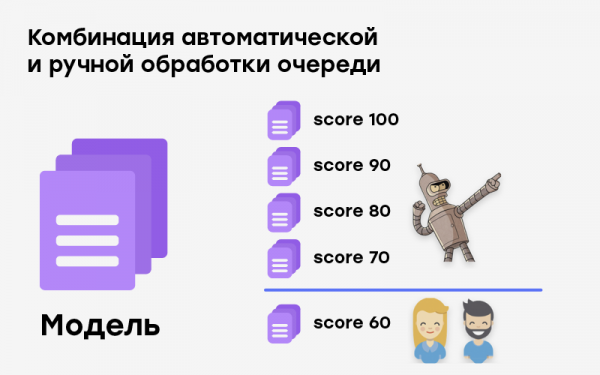
¿Por qué son necesarias estas colas? Supongamos que un usuario sube una foto de un arma de fuego. La red neuronal le asigna un score de entre 95 y 100 y determina con un 99% de precisión que en la imagen hay un arma. Pero si el score es inferior al 95 %, la precisión del modelo comienza a disminuir (esta es una característica de los modelos de redes neuronales).
Como resultado, se forma una cola basada en el score del modelo, y aquellos anuncios que reciben entre 95 y 100 se bloquean automáticamente como "Producto prohibido". Los anuncios con un score inferior a 95 se envían a moderación manual.
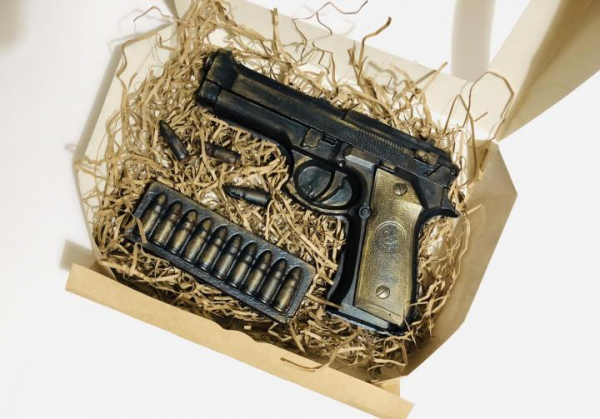
Beretta de chocolate con balas. ¡Solo para moderación manual! 🙂
Moderación manual
A principios de 2019, aproximadamente el 94 % de todos los anuncios en YuLa se moderan automáticamente.
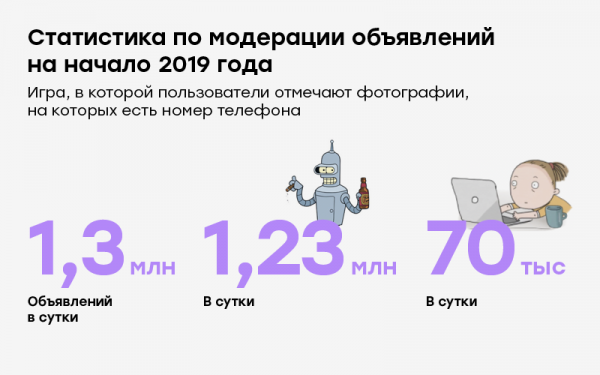
Si la plataforma no puede determinar sobre ciertos anuncios, los envía a moderación manual. Odnoklassniki desarrolló su propia herramienta: en las tareas para moderadores se muestra toda la información necesaria para tomar una decisión rápida: si el anuncio es válido o debe ser bloqueado, indicando la razón.
Y para que la calidad del servicio no se vea afectada en la moderación manual, el trabajo de las personas es constantemente controlado. Por ejemplo, en el flujo de tareas se muestran "trampas" al moderador: anuncios para los cuales ya hay soluciones listas. Si la decisión del moderador no coincide con la solución lista, se le registra un error.
De media, un moderador dedica 10 segundos a revisar un anuncio. Además, la cantidad de errores no supera el 0,5 % de todos los anuncios revisados.
Moderación comunitaria
Los colegas de Odnoklassniki han ido aún más allá, utilizando la "ayuda del público": han creado una aplicación-juego para la red social, donde se puede etiquetar rápidamente una gran cantidad de datos, destacando algún rasgo negativo: Moderador de Odnoklassniki (). Una buena forma de aprovechar la ayuda de los usuarios de OK, que buscan hacer el contenido más agradable.
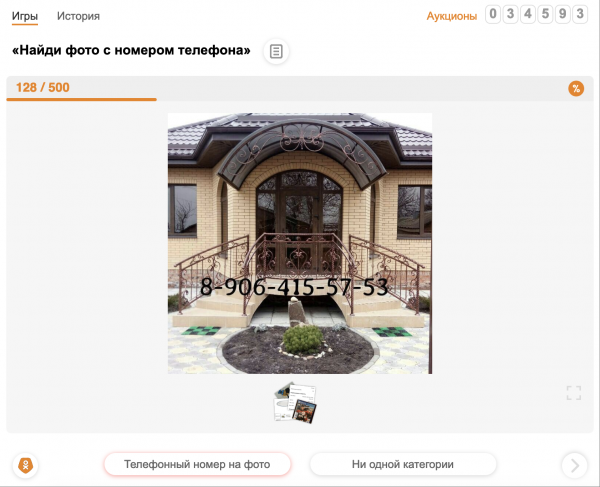
Juego en el que los usuarios marcan fotos que contienen un número de teléfono.
Cualquier cola de anuncios en la plataforma se puede redirigir al juego Moderador de Odnoklassniki. Todo lo que etiquetan los usuarios del juego se envía luego a los moderadores internos para su revisión. Este esquema permite bloquear anuncios para los que aún no se han creado filtros y, a su vez, crear muestras de entrenamiento.
Almacenamiento de los resultados de la moderación
Almacenamos todas las decisiones tomadas durante la moderación, para no tener que procesar nuevamente aquellos anuncios sobre los que ya se ha tomado una decisión.
Diariamente se crean millones de clústeres para los anuncios. Con el tiempo, cada clúster recibe una etiqueta de "bueno" o "malo". Cada nuevo anuncio o su edición, al entrar en un clúster con etiqueta, recibe automáticamente la resolución del clúster. Se generan alrededor de 20,000 resoluciones automáticas al día.
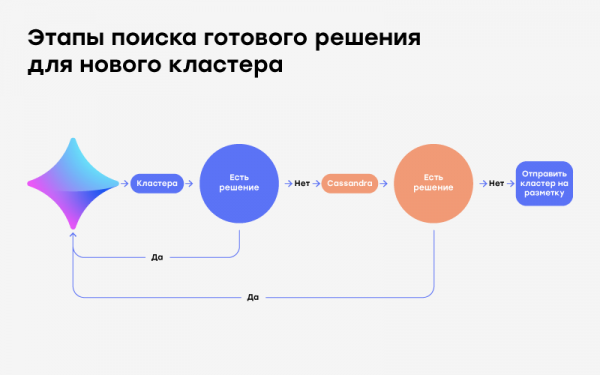
Si no llegan nuevos anuncios al clúster, se elimina de la memoria, y su hash y resolución se graban en Apache Cassandra.
Cuando la plataforma recibe un nuevo anuncio, primero intenta encontrar un clúster similar entre los ya creados y toma la decisión de este. Si no hay tal clúster, la plataforma va a Cassandra y busca allí. ¿Lo encontró? Perfecto, aplica la decisión al clúster y lo envía a Yula. Diariamente se generan en promedio unas 70,000 "decisiones repetidas", que representan el 8% del total.
Resumiendo
Hemos estado usando la plataforma de moderación Odnoklassniki durante dos años y medio. Nos gustan los resultados:
- Moderamos automáticamente el 94% de todos los anuncios en un día.
- Hemos reducido el costo de moderar un anuncio de 2 rublos a 7 kopecks.
- Gracias a la herramienta lista, nos olvidamos de los problemas de gestión de moderadores.
- Aumentamos 2.5 veces la cantidad de anuncios tratados manualmente manteniendo la misma cantidad de moderadores y presupuesto. Además, la calidad de la moderación manual ha mejorado gracias al control automatizado, y se mantiene en alrededor del 0.5% de errores.
- Cubriendo rápidamente nuevos tipos de spam con filtros.
- Conectamos rápidamente nuevas divisiones a la moderación. . Desde 2017, han surgido en Yula las verticales de Inmuebles, Ofertas de trabajo y Autos.
Fuente: habr.com
