

Me llamo Anton Baderin. Trabajo en el Centro de Altas Tecnologías y me dedico a la administración de sistemas. Hace un mes, concluyó nuestra conferencia corporativa, donde compartimos nuestra experiencia acumulada con la comunidad IT de nuestra ciudad. Hablé sobre la monitorización de aplicaciones web. El material estaba destinado a niveles junior o medio, quienes no han desarrollado este proceso desde cero.
La piedra angular de cualquier sistema de monitorización es la resolución de problemas de negocio. La monitorización por la monitorización no interesa a nadie. ¿Qué quiere el negocio? Que todo funcione rápido y sin errores. El negocio desea proactividad, para que identifiquemos problemas en el servicio y los resolvamos lo más rápido posible. Esa, en esencia, es la tarea que he estado resolviendo durante todo el año pasado en el proyecto de uno de nuestros clientes.
Sobre el proyecto
El proyecto es uno de los programas de fidelización más grandes del país. Ayudamos a las cadenas minoristas a aumentar la frecuencia de ventas mediante diversas herramientas de marketing como las tarjetas de bonificación. En total, el proyecto incluye 14 aplicaciones que operan en diez servidores.
Durante las entrevistas, he notado repetidamente que los administradores no siempre abordan correctamente la monitorización de aplicaciones web: muchos todavía se detienen en las métricas del sistema operativo y ocasionalmente monitorizan los servicios.
En mi caso, antes el sistema de monitorización del cliente estaba basado en Icinga. Este no resolvía las tareas mencionadas anteriormente. A menudo, el cliente nos notificaba sobre problemas y no menos veces nos faltaban datos para llegar a la raíz del problema.
Además, había una clara comprensión de la falta de perspectivas para su desarrollo futuro. Creo que quienes conocen Icinga me entenderán. Así que decidimos rehacer completamente el sistema de monitorización de aplicaciones web en el proyecto.
Prometheus
Elegimos Prometheus, basándonos en tres indicadores clave:
- Una enorme cantidad de métricas disponibles. En nuestro caso, son 60 mil. Por supuesto, hay que destacar que la gran mayoría de ellas no las usamos (probablemente alrededor del 95%). Sin embargo, todas son relativamente baratas. Para nosotros, esta es la otra extrema, en comparación con Icinga que usábamos anteriormente. En ella, agregar métricas era especialmente doloroso: las existentes eran costosas (basta con mirar el código fuente de cualquier complemento). Cualquier complemento era un script en Bash o Python, cuya ejecución no es barata en términos de recursos consumidos.
- Este sistema consume relativamente pocos recursos. Para todas nuestras métricas, son suficientes 600 MB de memoria RAM, el 15% de un núcleo y un par de docenas de IOPS. Por supuesto, hay que ejecutar los exportadores de métricas, pero todos están escritos en Go y tampoco son muy exigentes. No creo que esto sea un problema en las realidades modernas.
- Permite la migración a Kubernetes. Dado los planes del cliente, la elección es obvia.
ELK
Antes no recolectábamos ni procesábamos logs. Las desventajas son evidentes para todos. Elegimos ELK, ya que teníamos experiencia previa con este sistema. Allí almacenamos solo los logs de las aplicaciones. Los principales criterios de selección fueron la búsqueda de texto completo y su velocidad.
Clickhouse
Inicialmente, la elección recayó en InfluxDB. Éramos conscientes de la necesidad de recolectar logs de Nginx, estadísticas de pg_stat_statements, y almacenar datos históricos de Prometheus. No nos gustó Influx, ya que, de vez en cuando, comenzaba a consumir mucha memoria y fallaba. Además, queríamos agrupar solicitudes por remote_addr, y la agrupación en esta base de datos solo es posible por etiquetas. Las etiquetas son caras (en términos de memoria), y su número está limitadamente restringido.
Comenzamos la búsqueda de nuevo. Necesitábamos una base analítica con un mínimo consumo de recursos, preferiblemente con compresión de datos en disco.
Clickhouse cumple con todos estos criterios, y no nos hemos arrepentido de la elección ni una vez. No escribimos volúmenes notables de datos en él (el número de inserciones es de aproximadamente cinco mil por minuto).
NewRelic
NewRelic ha estado con nosotros históricamente, ya que fue la elección del cliente. Lo usamos como APM.
Zabbix
Usamos Zabbix exclusivamente para el monitoreo de Black Box de diversas API.
Definición del enfoque para el monitoreo
Queríamos descomponer la tarea y, así, sistematizar el enfoque al monitoreo.
He dividido nuestro sistema en los siguientes niveles:
- «hardware» y VMS;
- sistema operativo;
- servicios del sistema, pila de software;
- aplicación;
- lógica de negocio.
Las ventajas de este enfoque son:
- sabemos quién es responsable del funcionamiento de cada uno de los niveles y, a partir de esto, podemos enviar alertas;
- podemos utilizar la estructura al suprimir alertas: sería extraño enviar una alerta sobre la inaccesibilidad de la base de datos cuando en general la máquina virtual está fuera de servicio.
Dado que nuestra tarea es identificar fallos en el funcionamiento del sistema, debemos en cada nivel destacar un conjunto de métricas en las que vale la pena enfocarse al redactar las reglas de alerta. A continuación, analizaremos los niveles de «VMS», «Sistema operativo» y «Servicios del sistema, pila de software».
con procesadores gráficos también son necesarias en instituciones médicas que recopilan y analizan datos sobre pacientes y enfermedades. Trabajan con GPU y "
Hosting nos asigna CPU, disco, memoria y red. Y tuvimos problemas con los dos primeros. Así que, las métricas:
CPU stolen time: cuando compras una máquina virtual en Amazon (por ejemplo, t2.micro), debes entender que no se te asigna un núcleo completo de CPU, sino solo una cuota de su tiempo. Y cuando lo agotes, comenzarán a robarte el procesador.
Esta métrica permite rastrear esos momentos y tomar decisiones. Por ejemplo, si es necesario optar por un plan más robusto o distribuir el procesamiento de tareas de fondo y solicitudes de API en diferentes servidores.
IOPS + CPU iowait time: por alguna razón, muchos hostings en la nube cometen el error de no proporcionar suficientes IOPS. Además, un gráfico con bajos IOPS para ellos no es argumento suficiente. Por lo tanto, vale la pena recopilar también CPU iowait. Con esta pareja de gráficos —bajos IOPS y alta espera de entrada-salida— se puede empezar a conversar con el hosting y solucionar el problema.
Sistema operativo
Métricas del sistema operativo:
- porcentaje de memoria disponible;
- actividad en el uso de swap: vmstat swapin, swapout;
- número de inodes disponibles y espacio libre en el sistema de archivos en %;
- carga media;
- número de conexiones en estado tw;
- ocupación de la tabla conntrack;
- la calidad del trabajo de la red se puede monitorizar utilizando la utilidad ss, con el paquete iproute2 — obtener de su salida la métrica RTT de las conexiones y agrupar por destino de puerto.
Además, a nivel del sistema operativo, tenemos una entidad como los procesos. Es importante destacar en el sistema un conjunto de procesos que juegan un papel clave en su funcionamiento. Si, por ejemplo, tienes varios pgpool, es necesario recopilar información sobre cada uno de ellos.
El conjunto de métricas es el siguiente:
- CPU;
- la memoria es, ante todo, residente;
- IO — preferiblemente en IOPS;
- FileFd — abiertos y límite;
- los fallos significativos de la página — así podrás entender qué proceso se swap.
Todo nuestro monitoreo está desplegado en Docker, utilizamos Cadvisor para recopilar datos de métricas. En otras máquinas aplicamos process-exporter.
Servicios del sistema, pila de software
Cada aplicación tiene su propia especificidad, y es difícil destacar un conjunto de métricas.
Un conjunto universal es:
- tasa de solicitudes;
- número de errores;
- latencia;
- saturación.
Los ejemplos más destacados de monitoreo de este nivel en nuestro caso son Nginx y PostgreSQL.
El servicio más cargado en nuestro sistema es la base de datos. Antes, teníamos problemas bastante frecuentes para averiguar qué estaba haciendo la base de datos.
Vimos una alta carga en los discos, pero los slowlogs no mostraban nada relevante. Resolvímos este problema con pg_stat_statements, una vista donde se recopila estadística sobre las consultas.
Eso es todo lo que necesita un administrador.
Construimos gráficos de la actividad de solicitudes de lectura y escritura:
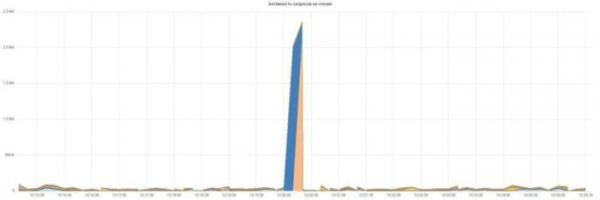
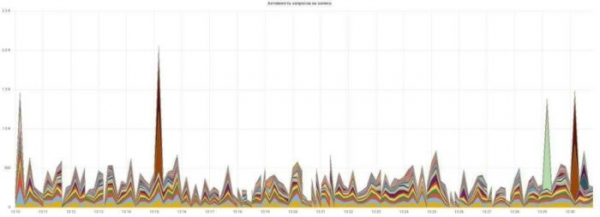
Todo es simple y claro, cada solicitud tiene su propio color.
Otro ejemplo notable son los registros de Nginx. No es sorprendente que pocos los analicen o los mencionen en la lista de los obligatorios. El formato estándar no es muy informativo y necesita ser ampliado.
Personalmente, añadí request_time, upstream_response_time, body_bytes_sent, request_length, request_id. Construimos gráficos del tiempo de respuesta y el número de errores:
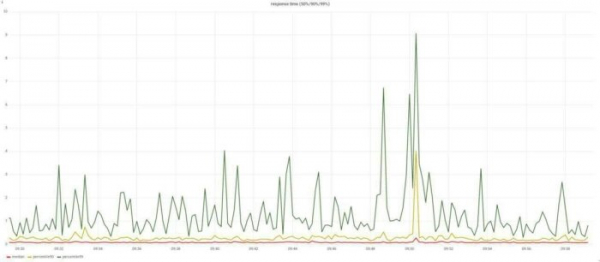
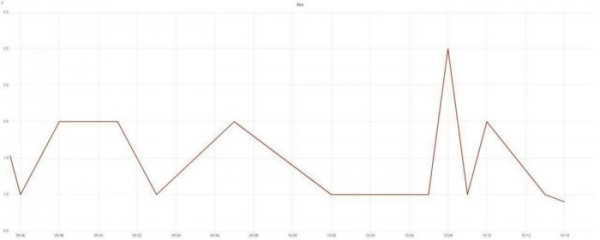
Construimos gráficos del tiempo de respuesta y el número de errores. ¿Recuerdas? Hablé sobre las tareas del negocio. Para hacerlo rápido y sin errores. Ya hemos cerrado estas cuestiones con dos gráficos. Y con ellos ya se puede llamar a los administradores de guardia.
Pero aún queda un problema: asegurar la rápida eliminación de las causas del incidente.
Eliminación de incidentes
Todo el proceso desde la detección hasta la resolución del problema se puede desglosar en una serie de pasos:
- detección del problema;
- notificación del administrador de guardia;
- reacción al incidente;
- eliminación de las causas.
Es importante que debemos hacerlo lo más rápido posible. Y aunque en las etapas de detección del problema y envío de la notificación no podemos ganar mucho tiempo — nos llevarán dos minutos en cualquier caso, las etapas posteriores son un campo fertil para mejoras.
Imaginemos que el teléfono del operador suena. ¿Qué va a hacer? ¿Buscar respuestas a las preguntas: qué se rompió, dónde se rompió, cómo reaccionar? Así es como respondemos a estas preguntas:
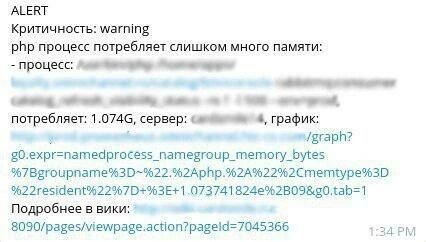
Simplemente incluimos toda esta información en el texto de la notificación, proporcionamos un enlace a la página de la wiki donde se describe cómo reaccionar ante este problema, cómo resolverlo y escalarlo.
Todavía no he mencionado nada sobre el nivel de la aplicación y la lógica empresarial. Desafortunadamente, nuestras aplicaciones aún no tienen métricas implementadas. La única fuente de información de estos niveles son los registros.
Un par de puntos.
Primero, escriban registros estructurados. No incluyan el contexto en el texto del mensaje. Esto dificulta su agrupación y análisis. Logstash requiere mucho tiempo para normalizar todo esto.
En segundo lugar, utilicen correctamente los niveles de gravedad. Cada lenguaje tiene su propio estándar. Personalmente, distingo cuatro niveles:
- no hay error;
- error del lado del cliente;
- error de nuestra parte, no estamos perdiendo dinero, no asumimos riesgos;
- error de nuestra parte, estamos perdiendo dinero.
En resumen. Debemos esforzarnos por construir el monitoreo desde la lógica empresarial. Intentar monitorear la propia aplicación y trabajar con métricas como el número de ventas, el número de nuevas registraciones de usuarios, el número de usuarios activos en ese momento, y así sucesivamente.
Si todo su negocio es un solo botón en el navegador, es necesario monitorear si se presiona, si funciona correctamente. Todo lo demás no es importante.
Si no tiene esto, puede intentar compensarlo en los registros de la aplicación, los registros de Nginx, etc., como hicimos nosotros. Debe estar lo más cerca posible de la aplicación.
Las métricas del sistema operativo son, por supuesto, importantes, pero no interesan al negocio; no nos pagan por ellas.
Fuente: habr.com
