

En los últimos años, las bases de datos de series temporales (Time-series databases) han pasado de ser una curiosidad (aplicadas de manera muy especializada, ya sea en sistemas de monitoreo abiertos, ligados a soluciones específicas, o en proyectos de Big Data) a un "producto de consumo masivo". En Rusia, debemos dar las gracias a Yandex y ClickHouse por esto. Hasta ese momento, si necesitabas almacenar una gran cantidad de datos de series temporales, tenías que resignarte a levantar un monstruoso stack de Hadoop y mantenerlo, o interactuar con protocolos específicos de cada sistema.
Puede parecer que en 2019 el artículo sobre qué TSDB usar se reduciría a una sola frase: "simplemente utiliza ClickHouse". Pero... hay matices.
Ciertamente, ClickHouse está en activo desarrollo, la base de usuarios está creciendo y el soporte se brinda de manera muy activa, pero ¿no nos hemos convertido en rehenes del éxito público de ClickHouse, que ha eclipsado otras soluciones que podrían ser más efectivas/confiables?
A principios del año pasado, comenzamos a rediseñar nuestro propio sistema de monitoreo, durante el cual surgió la cuestión de elegir la base adecuada para el almacenamiento de datos. Quiero contarles la historia de esta elección aquí.
Planteamiento del problema
Primero que nada, una introducción necesaria. ¿Por qué necesitamos un sistema de monitoreo propio y cómo estaba estructurado?
Comenzamos a ofrecer servicios de soporte en 2008, y para 2010 se hizo evidente que agregar datos sobre los procesos en la infraestructura del cliente con las soluciones que existían en ese momento había comenzado a ser complicado (estamos hablando de, Dios nos libre, Cacti, Zabbix y el emergente Graphite).
Nuestros principales requisitos eran:
- soporte (en ese momento, decenas, y a futuro, cientos) de clientes dentro de un mismo sistema y, además, un sistema centralizado para la gestión de alertas;
- flexibilidad en la gestión del sistema de alertas (escalamiento de alertas entre los de guardia, consideración de horarios, base de conocimientos);
- opción de una detallada visualización de gráficos (Zabbix en ese momento representaba los gráficos como imágenes);
- almacenamiento a largo plazo de una gran cantidad de datos (un año o más) y la posibilidad de una rápida recuperación de los mismos.
En este artículo, nos interesa el último punto.
Hablando de almacenamiento, los requisitos fueron los siguientes:
- el sistema debe funcionar rápidamente;
- es deseable que el sistema tenga una interfaz SQL;
- el sistema debe ser estable y tener una base de usuarios activa y soporte (en algún momento nos enfrentamos a la necesidad de mantener sistemas como MemcacheDB, que dejaron de desarrollarse, o el almacenamiento distribuido MooseFS, cuyo seguimiento de errores se llevaba a cabo en chino: no queríamos repetir esta historia para nuestro proyecto);
- conformidad con el teorema CAP: Consistencia (necesaria) — los datos deben estar actualizados, no queremos que el sistema de gestión de alertas no reciba nuevos datos y emita alertas sobre la falta de datos en todos los proyectos; Tolerancia a particiones (necesaria) — no queremos tener un sistema de cerebro dividido; Disponibilidad (no crítica, en caso de existir una réplica activa) — podemos cambiar nosotros mismos a un sistema de respaldo en caso de emergencia, mediante código.
Curiosamente, en ese momento la solución ideal para nosotros resultó ser MySQL. Nuestra estructura de datos era sumamente simple: id del servidor, id del contador, timestamp y valor; la rápida consulta de datos actuales se aseguraba con un gran tamaño de buffer pool, y la consulta de datos históricos — con SSD.
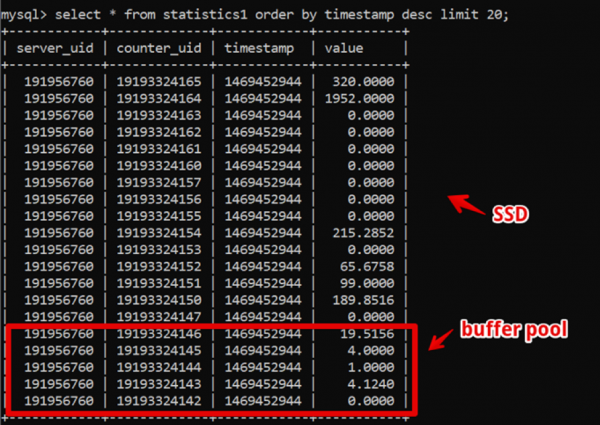
Así, logramos obtener datos frescos de dos semanas, con una precisión de hasta un segundo, en 200 ms antes de completar la visualización de los datos, y vivimos en este sistema bastante tiempo.
Mientras tanto, el tiempo pasó y la cantidad de datos creció. Para 2016, los volúmenes de datos alcanzaban decenas de terabytes, lo que representaba un gasto significativo en almacenamiento SSD alquilado.
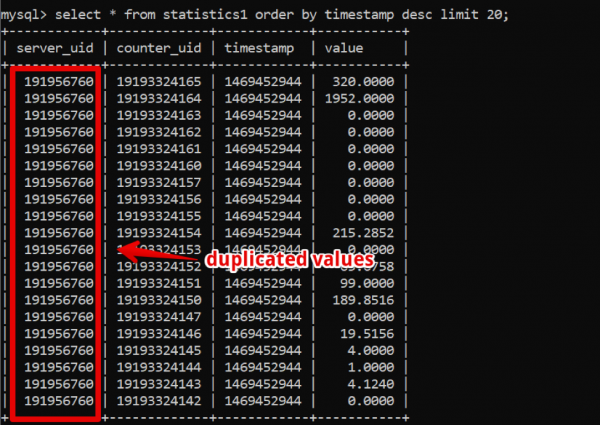
Para ese momento, las bases de datos en columna habían ganado gran popularidad, y comenzamos a pensar activamente en ellas: en las BD en columna, los datos se almacenan, como se puede entender, en columnas, y si miramos nuestros datos, es fácil ver una gran cantidad de duplicados, que podrían comprimirse si hubiéramos utilizado una BD en columna.
Sin embargo, el sistema clave para el funcionamiento de la empresa continuó funcionando de manera estable, y no queríamos experimentar con la transición a algo diferente.
En 2017, en la conferencia Percona Live en San José, los desarrolladores de Clickhouse probablemente se dieron a conocer por primera vez. A simple vista, el sistema estaba listo para producción (bueno, Yandex.Metrica es un entorno de producción serio), el soporte era rápido y sencillo, y lo más importante, la operación era fácil. Desde 2018 iniciamos el proceso de transición. Pero para entonces, había muchas más soluciones TSDB 'maduras' y probadas, por lo que decidimos dedicar un tiempo considerable a comparar alternativas para asegurarnos de que no había soluciones alternativas a Clickhouse que cumplieran con nuestros requisitos.
Además de los requisitos ya mencionados para el almacenamiento, surgieron nuevos:
- el nuevo sistema debe proporcionar, como mínimo, el mismo rendimiento que MySQL, con el mismo hardware;
- el almacenamiento del nuevo sistema debe ocupar significativamente menos espacio;
- la base de datos aún debe ser fácil de administrar;
- se deseaba cambiar lo menos posible la aplicación al cambiar de base de datos.
Qué sistemas comenzamos a considerar
Apache Hive/Apache Impala
Una pila de Hadoop probada en batalla. Esencialmente, es una interfaz SQL construida sobre el almacenamiento de datos en formatos propios en HDFS.
Ventajas.
- Con un funcionamiento estable, es muy fácil escalar los datos.
- Existen soluciones de almacenamiento columnar (menos espacio).
- Ejecuciones muy rápidas de tareas paralelizadas con los recursos disponibles.
Desventajas.
- Es Hadoop, y es complicado de operar. Si no estamos dispuestos a adoptar una solución lista en la nube (y no lo estamos por el costo), toda la pila tendrá que ser ensamblada y mantenida por los administradores, lo cual no es algo que deseemos.
- Los datos se agregan .
Sin embargo:
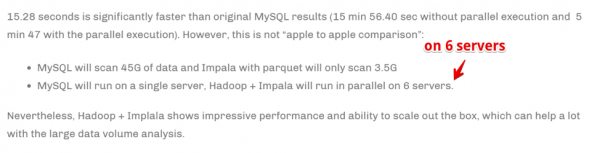
La velocidad se logra escalando el número de servidores de cálculo. En otras palabras, si somos una gran empresa, estamos involucrados en análisis, y es crucial para el negocio agregar información de la manera más rápida posible (incluso a costa de utilizar una gran cantidad de recursos computacionales), esto puede ser nuestra elección. Pero no estábamos dispuestos a aumentar drásticamente nuestro equipo de hardware para acelerar la ejecución de tareas.
Druid/Pinot
Ya se trata mucho más de TSDB en concreto, pero una vez más, una pila de Hadoop.
Hay .
Si en pocas palabras: Druid/Pinot parecen mejores que Clickhouse en los casos en que:
- Usted tiene un carácter de datos heterogéneo (en nuestro caso, solo registramos series temporales de métricas del servidor, y, de hecho, esto es una sola tabla. Pero pueden existir otros casos: series temporales de equipos, series temporales económicas, etc., cada uno con su propia estructura, que deben ser agregadas y procesadas).
- Sin embargo, hay una gran cantidad de estos datos.
- Las tablas y los datos con series temporales aparecen y desaparecen (es decir, un conjunto de datos llegó, fue analizado y eliminado).
- No hay un criterio claro por el cual los datos puedan ser particionados.
En casos opuestos, ClickHouse se desempeña mejor, que es nuestro caso.
ClickHouse
- Similar a SQL.
- Fácil de administrar.
- La gente dice que funciona.
Llega a la lista corta de pruebas.
InfluxDB
Alternativa extranjera a ClickHouse. Entre sus desventajas: la alta disponibilidad está presente solo en la versión comercial, pero hay que comparar.
Llega a la lista corta de pruebas.
Cassandra
Por un lado, sabemos que se utiliza para almacenar series temporales métricas en sistemas de monitoreo como, por ejemplo, o OkMeter. Sin embargo, hay especificidades.
Cassandra no es una base de datos columna en el sentido tradicional. Se asemeja más a una base de datos de filas, pero en cada fila puede haber una cantidad variable de columnas, lo que facilita la organización de una presentación en columnas. En este sentido, está claro que con un límite de 2 mil millones de columnas, se pueden almacenar algunos datos precisamente en columnas (como las mismas series temporales). Por ejemplo, en MySQL hay un límite de 4096 columnas y es fácil encontrarse con un error de código 1117 si se intenta hacer lo mismo.
El motor de Cassandra está diseñado para almacenar grandes volúmenes de datos en un sistema distribuido sin maestro, y en el mencionado teorema CAP, Cassandra se centra más en AP, es decir, en la disponibilidad de datos y la resiliencia a la partición. Por lo tanto, esta herramienta puede ser ideal si se necesita escribir en la base de datos y leer de ella con poca frecuencia. Aquí sería lógico utilizar Cassandra como un almacenamiento 'frío', es decir, como un lugar de almacenamiento confiable a largo plazo para grandes volúmenes de datos históricos que rara vez se requieren, pero que se pueden recuperar si es necesario. Sin embargo, para ser completos, también la probaremos. Pero como mencioné anteriormente, no tengo ganas de reescribir activamente el código para la solución de base de datos elegida, así que la probaremos de manera algo limitada, sin adaptar la estructura de la base a las especificidades de Cassandra.
Prometheus
Y por pura curiosidad decidimos probar el rendimiento del almacenamiento de Prometheus, simplemente para entender si somos más rápidos o más lentos que las soluciones actuales y en qué medida.
Metodología y resultados de las pruebas
Así que probamos 5 bases de datos en las siguientes 6 configuraciones: ClickHouse (1 nodo), ClickHouse (tabla distribuida en 3 nodos), InfluxDB, Mysql 8, Cassandra (3 nodos) y Prometheus. El plan de prueba es el siguiente:
- cargamos datos históricos de una semana (840 millones de valores por día; 208 mil métricas);
- generamos carga de escritura (consideramos 6 modos de carga, ver más abajo);
- simultáneamente con la escritura, hacemos muestreos periódicos, emulando consultas de un usuario que trabaja con gráficos. Para no complicarlo demasiado, seleccionamos datos de 10 métricas (justo las que están en el gráfico de CPU) durante una semana.
Cargamos, emulando el comportamiento del agente de monitorización que envía valores a cada métrica cada 15 segundos. Al hacerlo, nos interesa variar:
- el número total de métricas a las que se envían datos;
- el intervalo de envío de valores a una métrica;
- el tamaño del lote.
Sobre el tamaño del lote. Dado que casi todas nuestras bases de datos probadas no se recomiendan para cargas de inserciones individuales, necesitaremos un relay que recoja las métricas entrantes y las agrupe en lotes y las escriba en la base mediante inserciones por lotes.
Además, para entender mejor cómo interpretar los datos obtenidos, supongamos que no solo estamos enviando un montón de métricas, sino que las métricas están organizadas en servidores, con 125 métricas por servidor. Aquí, el servidor es simplemente una entidad virtual, solo para entender que, por ejemplo, 10,000 métricas corresponden aproximadamente a 80 servidores.
Y así, teniendo esto en cuenta, nuestros 6 modos de carga de la base en escritura:
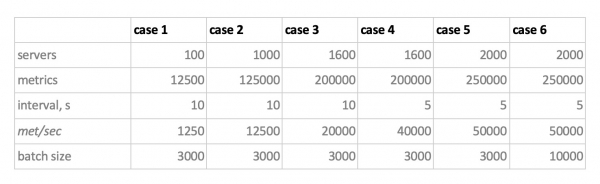
Hay dos aspectos a considerar. Primero, para Cassandra, estos tamaños de lotes resultaron ser demasiado grandes; allí utilizamos valores de 50 o 100. Y en segundo lugar, dado que Prometheus funciona estrictamente en modo pull, es decir, busca y recoge datos de las fuentes de métricas (y aunque el pushgateway, a pesar de su nombre, no cambia la situación en esencia), las cargas correspondientes se implementaron mediante una combinación de configuraciones estáticas.
Los resultados de las pruebas son los siguientes:
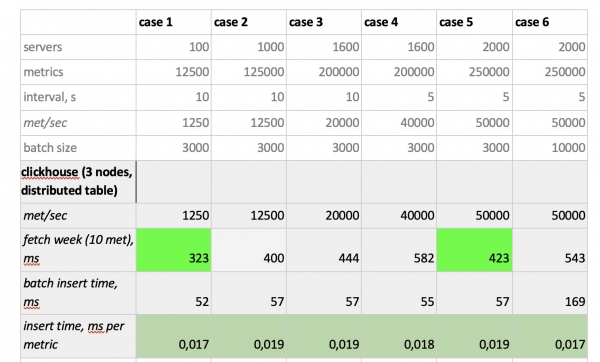
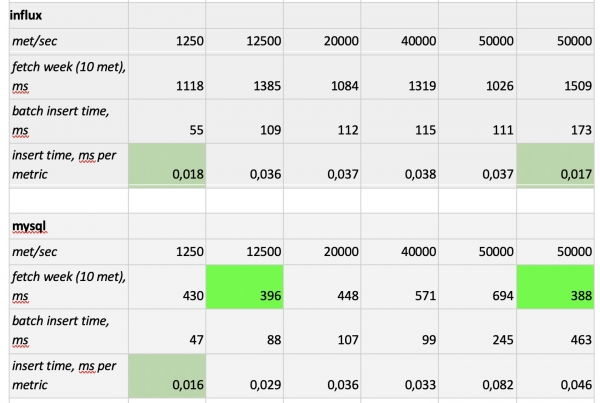
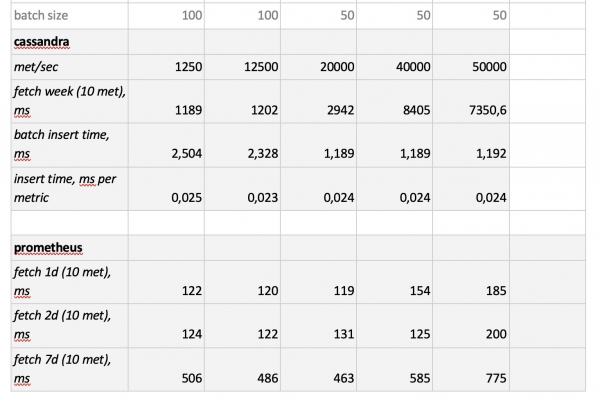
Lo que vale la pena señalar: selecciones increíblemente rápidas de Prometheus, selecciones horriblemente lentas de Cassandra, selecciones inaceptablemente lentas de InfluxDB; en cuanto a velocidad de escritura, ClickHouse ganó sin duda, y Prometheus no participa en la competencia porque realiza las inserciones internamente y no medimos nada.
En resumen: ClickHouse e InfluxDB se desempeñaron mejor, pero un clúster de Influx solo se puede construir sobre la versión Enterprise, que cuesta dinero, mientras que ClickHouse es gratuito y desarrollado en Rusia. Lógicamente, en EE. UU. la elección es probablemente a favor de InfluxDB, mientras que aquí, a favor de ClickHouse.
Fuente: habr.com
