

¡Hola! Me llamo Alexey Pyankov, soy desarrollador en la empresa Sportmaster. En este relato, conté cómo comenzó el trabajo en el sitio de Sportmaster en 2012, qué iniciativas logramos "empujar" y, por el contrario, qué obstáculos encontramos.
Hoy quiero compartir mis pensamientos sobre otro tema: la elección del sistema de caché para el backend de Java en el panel de administración del sitio. Este tema tiene un significado especial para mí; aunque la historia se desarrolló en solo 2 meses, durante esos 60 días trabajamos entre 12 y 16 horas al día sin un solo día de descanso. Nunca antes había pensado ni imaginado que se podía trabajar tanto.
Por lo tanto, dividiré el texto en 2 partes para no sobrecargarlo por completo. De hecho, la primera parte será muy ligera: una preparación, una introducción y algunas reflexiones sobre qué es la caché. Si ya eres un desarrollador experimentado o has trabajado con cachés, desde el punto de vista técnico, probablemente no encontrarás nada nuevo en este artículo. Pero para un junior, una pequeña revisión puede indicar en qué dirección mirar si se encuentra en tal encrucijada.
Cuando se lanzó la nueva versión del sitio de Sportmaster en producción, los datos llegaban de una manera, por decirlo suavemente, no muy conveniente. La base eran tablas preparadas para la versión anterior del sitio (Bitrix), que debían ser extraídas en ETL, transformadas a una nueva forma y enriquecidas con diferentes detalles de otras diez sistemas. Para que una nueva imagen o descripción del producto apareciera en el sitio, había que esperar hasta el día siguiente: la actualización solo se realizaba por la noche, una vez al día.
Al principio había tantas preocupaciones durante las primeras semanas de lanzamiento que estas incomodidades para los gestores de contenido eran una trivialidad. Pero, tan pronto como todo se estabilizó, el desarrollo del proyecto continuó: unos meses después, a comienzos de 2015, comenzamos a desarrollar activamente el panel de administración. En 2015 y 2016 todo iba bien, publicamos con regularidad, el panel de administración abarcaba una parte cada vez mayor de la preparación de datos y nos estábamos preparando para que pronto se confiara a nuestro equipo lo más importante y complicado: el contorno de productos (preparación completa y manejo de datos de todos los productos). Pero en el verano de 2017, justo antes del lanzamiento del contorno de productos, el proyecto se encontraría en una situación muy complicada, precisamente debido a problemas con la caché. Sobre este episodio quiero hablar en la segunda parte de esta publicación de dos partes.
Pero en este post empezaré desde lejos, reuniré algunas ideas — consideraciones sobre la caché, revisar las cuales antes de un gran proyecto sería un buen paso.
Cuando surge la tarea de caching
La tarea de caching no aparece sin motivo. Somos desarrolladores, escribimos un producto de software y queremos que sea demandado. Si el producto tiene demanda y es exitoso, los usuarios llegan. Y llegan más y más. Y así, hay muchos usuarios, y el producto se vuelve muy cargado.
En las primeras etapas no pensamos en la optimización y el rendimiento del código. Lo principal es la funcionalidad, lanzar rápidamente un piloto y verificar las hipótesis. Y si la carga aumenta, mejoramos el hardware. Incrementamos entre dos y tres veces, cinco, incluso diez veces. En algún momento, las finanzas no lo permitirán. ¿Y cuántos usuarios más habrá? No serán solo 2-5-10, sino que en caso de éxito, será de 100-1000 hasta 100,000 veces más. Es decir, tarde o temprano, tendremos que abordar la optimización.
Supongamos que una parte del código (llamemos a esta parte una función) funciona indebidamente lento y queremos reducir el tiempo de ejecución. La función puede ser el acceso a una base de datos o la ejecución de alguna lógica compleja; lo importante es que se tarda mucho. ¿Cuánto se puede reducir el tiempo de ejecución? En teoría, se puede reducir hasta cero, no más allá. ¿Y cómo se puede reducir el tiempo de ejecución a cero? Respuesta: simplemente evitar la ejecución. En vez de eso, devolver el resultado de inmediato. ¿Y cómo se sabe el resultado? Respuesta: se puede calcular o mirarlo en algún lado. Calcular lleva tiempo. Y mirar, por ejemplo, es recordar el resultado que la función devolvió la última vez que fue llamada con los mismos parámetros.
Es decir, la implementación de la función no nos importa. Solo necesitamos saber de qué parámetros depende el resultado. Entonces, si representamos los valores de los parámetros como un objeto que se puede usar como clave en un cierto almacén, podemos guardar el resultado del cálculo y, en el próximo acceso, recuperarlo. Si estas operaciones de guardar y recuperar el resultado son más rápidas que la ejecución de la función, tendremos una mejora en la velocidad. La magnitud de la mejora puede alcanzar hasta 100, 1000 o incluso 100,000 veces (10^5 es más bien una excepción, pero en caso de una base de datos bastante lenta, es bastante posible).
Requisitos básicos para el sistema de caché
Lo primero que puede ser un requisito para el sistema de caché es una rápida velocidad de lectura y, en un grado ligeramente menor, velocidad de escritura. Esto es cierto, pero solo hasta que implementemos el sistema en producción.
Presentemos un caso.
Supongamos que hemos proporcionado el hardware para la carga actual y ahora estamos implementando gradualmente el caché. El número de usuarios aumenta un poco, la carga crece - añadimos un poco de caché, implementamos aquí y allá. Esto continúa durante un tiempo, y ya las funciones pesadas casi no se llaman; toda la carga principal recae en el caché. El número de usuarios ha crecido en N veces durante este tiempo.
Y si la reserva inicial de hardware podía ser de 2 a 5 veces, con la ayuda del caché podríamos aumentar el rendimiento hasta 10 veces o, en el mejor de los casos, 100 veces, y, en ocasiones, incluso 1000 veces. Es decir, en el mismo hardware tratamos 100 veces más solicitudes. Genial, ¡merecemos un premio!
Pero ahora, en un buen momento, accidentalmente, el sistema falló y el caché colapsó. Nada especial, ya que el caché fue elegido bajo la exigencia de 'alta velocidad de lectura y escritura, lo demás no importa'.
En relación con la carga inicial, la reserva de hardware que teníamos era de 2 a 5 veces, mientras que la carga ha aumentado entre 10 y 100 veces. Con la ayuda del caché, habíamos evitado las llamadas a funciones pesadas y, por lo tanto, todo funcionaba sin problemas. Ahora, sin el caché, ¿cuántas veces caerá nuestro sistema? ¿Qué nos sucederá? El sistema colapsará.
Incluso si nuestro caché no colapsó, sino que solo se limpió por un tiempo, necesitará ser calentado, y esto tomará un tiempo. Y durante ese tiempo, la carga principal recaerá en la funcionalidad.
Conclusión: los proyectos de alta carga en producción requieren del sistema de caché no solo alta velocidad de lectura y escritura, sino también integridad de datos y resistencia a fallos.
Los tormentos de la elección
En el proyecto con panel de administración, la elección fue la siguiente: primero instalamos Hazelcast, ya que teníamos experiencia con este producto del sitio principal. Sin embargo, esta elección resultó ser inadecuada: bajo nuestro perfil de carga, Hazelcast no solo funciona lentamente, sino increíblemente lento. Y en cuanto a los plazos de producción, ya estábamos comprometidos en ese momento.
Spoiler: cómo se desarrollaron las circunstancias que nos hicieron pasar por esta dificultad y cómo nos encontramos en una situación tensa y complicada - lo contaré en la segunda parte, y cómo llegamos a ello y cómo salimos. Pero por ahora, solo diré que fue un gran estrés, y 'pensar - de alguna manera no se puede pensar, agitamos la botella'. 'Agitamos la botella' - esto es también un spoiler, sobre esto un poco más adelante.
Lo que hicimos:
- Hicimos una lista de todos los sistemas que sugiere Google y StackOverflow. Un poco más de 30.
- Escribimos pruebas con la carga característica de producción. Para ello, registramos los datos que pasan a través del sistema en el entorno de producción, una especie de sniffer para datos no en red, pero dentro del sistema. En las pruebas, usamos exactamente esos datos.
- Todo el equipo, cada uno elige el siguiente sistema de la lista, lo configura y ejecuta las pruebas. Si la prueba no pasa, no soporta la carga, lo descartamos y pasamos al siguiente en la lista.
- En el sistema 17, quedó claro que todo estaba más que perdido. Ya basta de 'agitar la botella', es hora de pensar seriamente.
Pero esta es una opción cuando se necesita elegir un sistema que 'pase por velocidad' en pruebas previamente realizadas. ¿Y si no hay tales pruebas y queremos elegir más rápido?
Simulemos tal opción (es difícil imaginar que un desarrollador medio o avanzado vive en el vacío, y en el momento de la elección aún no ha definido su preferencia sobre qué producto probar primero - por lo tanto, las reflexiones posteriores son más bien teóricas/filosóficas/sobre juniors).
Una vez definidos los requisitos, comenzaremos a elegir una solución lista para usar. ¿Para qué inventar la rueda? Iremos y tomaremos un sistema de caché existente.
Si recién estás comenzando y vas a buscar en Google, la secuencia más o menos es la siguiente, pero en general, los puntos de referencia serán así. Primero te encontrarás con Redis, que está muy en boga. Luego descubrirás que existe EhCache, el sistema más antiguo y probado. Después, se mencionará Tarantool, un desarrollo nacional que tiene un aspecto único en su solución. Y también Ignite, que está en auge y cuenta con el apoyo de SberTech. Al final, también se mencionará Hazelcast, pues a menudo aparece en el mundo empresarial en grandes compañías.
Este listado no es exhaustivo, existen decenas de sistemas. Pero solo analizaremos uno. Tomaremos cinco sistemas seleccionados para un 'concurso de belleza' y realizaremos una selección. ¿Quién será el ganador?
Redis
Leemos lo que dicen en el sitio oficial.
— proyecto de código abierto. Ofrece almacenamiento de datos en memoria, la posibilidad de guardado en disco, particionado automático, alta disponibilidad y recuperación tras cortes de red.
Parece que todo está excelente, se puede usar y conectar; hace todo lo necesario. Pero veamos, solo por curiosidad, a los demás candidatos.
EhCache
— 'el caché más utilizado para Java' (traducción del eslogan del sitio oficial). También es de código abierto. Y aquí entendemos que Redis no es para Java, es universal, y para interactuar con él se necesita un wrapper. EhCache resulta ser más conveniente. ¿Qué más promete el sistema? Fiabilidad, validación, funcionalidad completa. Y además, es el más difundido. Y cachea teras de datos.
Olvidé Redis, estoy listo para elegir EhCache.
Pero un sentimiento de patriotismo me empuja a ver qué tiene de bueno Tarantool.
Tarantool
— se presenta como 'Plataforma de integración de datos en tiempo real'. Suena muy complicado, por lo que leemos la página detenidamente y encontramos una declaración llamativa: 'Cachea el 100% de los datos en memoria'. Esto debería generar preguntas, ya que los datos pueden ser significativamente más que la memoria. La aclaración es que aquí se entiende que, para escribir datos en disco desde la memoria, Tarantool no utiliza serialización. En su lugar, hace uso de características de bajo nivel del sistema, donde la memoria se mapea simplemente en el sistema de archivos con muy buenos índices de I/O. En general, lo han hecho de manera bastante notable y genial.
Veamos las implementaciones: Mail.ru, la autoría corporativa, Avito, Beeline, Megafon, Alfa-Banco, Gazprom…
Si aún quedaban dudas sobre Tarantool, el caso de implementación en Mastercard me convence. Elijo Tarantool.
Pero aún así...
Ignite
... hay más , declarado como "plataforma de computación in-memory... velocidades in-memory en petabytes de datos". Aquí también hay muchas ventajas: caché in-memory distribuido, el almacenamiento y caché key-value más rápido, escalabilidad horizontal, alta disponibilidad, estricta integridad. En resumen, resulta que el más rápido es Ignite.
Implementaciones: Sberbank, American Airlines, Yahoo! Japan. Y luego descubro que Ignite no solo está implementado en Sberbank, sino que el equipo de SberTech envía a sus personas al equipo de Ignite para mejorar el producto. Esto me convence completamente y estoy listo para elegir Ignite.
Es completamente incomprensible por qué, miro el quinto punto.
Hazelcast
Entro en el sitio web , lo leo. Y resulta que la solución más rápida para el almacenamiento en caché distribuido es Hazelcast. Es órdenes de magnitud más rápido que cualquier otra solución y, en general, es el líder en el campo de grids de datos in-memory. En comparación con esto, elegir otra cosa sería no respetarse a uno mismo. Además, utiliza almacenamiento redundante para mantener el funcionamiento continuo del clúster sin pérdida de datos.
Eso es, estoy listo para elegir Hazelcast.
Comparación
Pero si miramos, los cinco candidatos están descritos de tal manera que cada uno de ellos es el mejor. ¿Cómo elegir? Podemos ver cuál es el más popular, buscar comparativas, y el dolor de cabeza se desvanecerá.
Encontramos uno así , elegimos nuestros 5 sistemas.
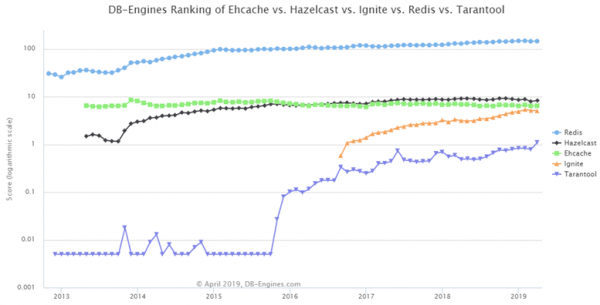
Aquí están ordenados: en la parte superior Redis, en segundo lugar — Hazelcast, Tarantool e Ignite ganan popularidad, EhCache se mantiene igual.
Pero echemos un vistazo a : enlaces a sitios web, interés general en el sistema, ofertas de trabajo — ¡genial! Es decir, cuando mi sistema se caiga, diré: "No, ¡es confiable! ¡Mira cuántas ofertas de trabajo hay...". Esa comparación tan sencilla no servirá.
Todos estos sistemas no son solo sistemas para almacenamiento en caché. También tienen muchas más funcionalidades, incluyendo – cuando no son los datos los que se transfieren al cliente para su procesamiento, sino al contrario: el código que necesita ejecutarse sobre los datos se traslada al servidor, se ejecuta allí, y se devuelve el resultado. Y como un sistema separado para almacenamiento en caché, no se consideran tan a menudo.
Está bien, no nos rendimos, buscaremos una comparación directa entre sistemas. Tomemos las dos mejores opciones — Redis y Hazelcast. Nos interesa la velocidad, y compararemos según ese parámetro.
Hz vs Redis
Encontramos uno así :
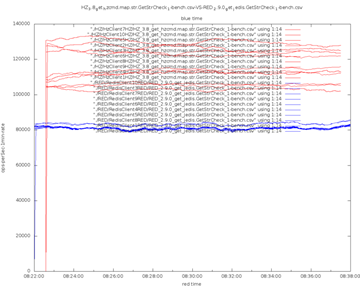
El azul es Redis, el rojo es Hazelcast. Hazelcast gana en todas partes, y esto se justifica: es multihilo, altamente optimizado, cada hilo trabaja con su propia partición, por lo que no hay bloqueos. En cambio, Redis es de un solo hilo y no aprovecha la ventaja de las CPU modernas multinúcleo. Hazelcast utiliza E/S asíncrona, mientras que Redis-Jedis utiliza sockets bloqueantes. Al final, Hazelcast usa un protocolo binario, mientras que Redis está orientado a texto, lo que significa que es ineficiente.
Por si acaso, consultemos otra fuente de comparación. ¿Qué nos mostrará?
Redis vs Hz
Otra cosa más :
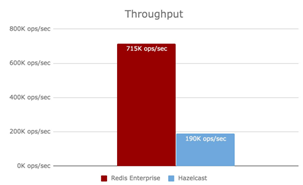
Aquí es al revés, el rojo es Redis. Es decir, Redis gana en rendimiento a Hazelcast. En la primera comparación, ganó Hazelcast, en la segunda, Redis. se explicó muy claramente por qué ganó Hazelcast en la comparación anterior.
Resulta que el resultado del primero estaba, de hecho, manipulado: tomaron Redis en su caja básica, mientras que ajustaron Hazelcast para el caso de prueba. Entonces, resulta que: en primer lugar, no se puede confiar en nadie, y en segundo lugar, cuando finalmente elijamos un sistema, también necesitamos configurarlo correctamente. Estas configuraciones incluyen decenas, casi cientos de parámetros.
Agitamos la botella
Y todo el proceso que acabamos de realizar, puedo explicarlo con la metáfora "Agitamos la botella". Es decir, ahora no se puede programar, lo principal es saber leer stackoverflow. Y tengo en mi equipo a un profesional que trabaja exactamente así en momentos críticos.
¿Qué hace? Ve un dispositivo que no funciona, observa el stack trace, toma algunas palabras (cuáles exactamente es su experiencia en el programa), busca en Google, encuentra stackoverflow entre las respuestas. Sin leer ni pensar, entre las respuestas a la pregunta, elige algo que se parezca a la sugerencia "hacer esto y aquello" (elegir esa respuesta es su talento, ya que no siempre es la que ha recibido más 'me gusta'), aplica, observa: si algo ha cambiado, genial. Si no ha cambiado, retrocedemos. Y repetimos inicio-verificación-búsqueda. Y de esta manera intuitiva, logra que después de un tiempo el código funcione. No sabe por qué, no sabe qué hizo, no puede explicarlo. ¡Pero! Esa cosa funciona. Y "el incendio está apagado". Ahora revisemos qué hicimos. Cuando el programa funciona, es un orden de magnitud más fácil. Y ahorra significativamente tiempo.
Este método se explica muy bien con este ejemplo.
Hace tiempo era muy popular construir un velero dentro de una botella. El velero es grande y frágil, mientras que el cuello de la botella es muy estrecho, no se puede meter por dentro. ¿Cómo se arma?
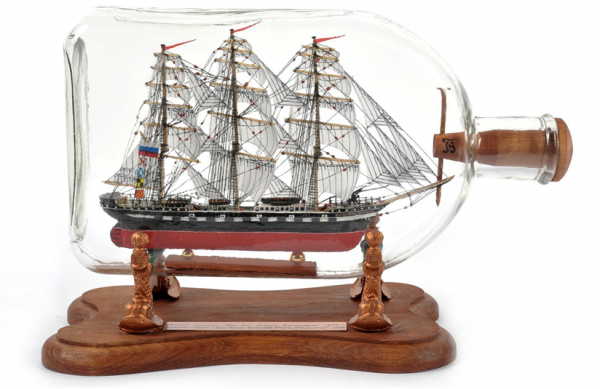
Hay un método que es muy rápido y muy efectivo.
El barco consta de un montón de pequeñas cosas: palitos, cuerdas, velas, pegamento. Todo esto lo metemos en la botella.
Tomamos la botella con ambas manos y comenzamos a sacudir. La agitamos, la agitamos. Y normalmente, el resultado es un desastre, claro. Pero a veces, a veces sale un barco. Más bien, algo que se parece a un barco.
Le mostramos eso a alguien: "¡Serge, ¿ves!?". Y realmente, desde lejos, parece un barco. Pero no se puede dejar así.
También hay otra forma. La utilizan chicos más avanzados, como hackers.
Le di una tarea a un chico así, lo hizo todo y se fue. Y miras, parece que está hecho. Pero después de un tiempo, cuando hay que modificar el código, comienza a haber problemas por su culpa... Menos mal que ya se había alejado. Estos chicos, que aplican el ejemplo de la botella, hacen lo siguiente: ven que donde está el fondo, el vidrio se curva. Y no está del todo claro si es transparente o no. Entonces, los "hackers" cortan ese fondo, insertan el barco, vuelven a pegar el fondo y parece que así debe ser.
Desde el punto de vista de la formulación del problema, parece que todo está bien. Pero, en el caso de los barcos: ¿para qué se hace este barco, a quién realmente le sirve? No tiene ninguna funcionalidad. Normalmente, tales barcos son regalos para personas de alto rango, que lo ponen en una estantería como un símbolo, como un signo. Y si para una persona así, un líder de un gran negocio o un funcionario de alto rango, como bandera, está esta chapuza con el cuello cortado, ¿no es mejor que nunca se entere de eso? Entonces, ¿cómo se hacen al final estos barcos que se pueden regalar a una persona importante?
El único lugar, crucial, con el que realmente no se puede hacer nada es el casco. Y el casco del barco pasa justo por el cuello de la botella. Mientras que el barco se ensambla fuera de la botella. Pero no es solo armar el barco, es un verdadero arte joyero. Se agregan a las piezas elementos especiales que permiten levantarlos después. Por ejemplo, las velas se pliegan, se introducen cuidadosamente en el interior, y luego, con unas pinzas, se levantan y ajustan con gran precisión. Como resultado, se obtiene una obra de arte que se puede regalar con la conciencia tranquila y con orgullo.
Y si queremos que el proyecto sea exitoso, debe haber al menos una persona joyera en el equipo. Aquella que se preocupa por la calidad del producto y considera todos los aspectos, sin sacrificar ninguno, incluso en momentos de estrés, cuando las circunstancias requieren hacer algo urgente en detrimento de lo importante. Todos los proyectos exitosos que son sostenibles y han soportado la prueba del tiempo se basan en este principio. En ellos hay algo muy preciso y único, algo que utiliza todas las posibilidades disponibles. En el ejemplo del barco en la botella, se juega con el hecho de que el casco del barco pasa por el cuello.
Volviendo a la tarea de elegir nuestro servidor de caché, ¿cómo se podría aplicar este método? Propongo una manera de elegir entre todos los sistemas que hay: no mover la botella, no elegir, sino ver qué hay en ellos que deberíamos tener en cuenta al elegir un sistema.
Dónde buscar el cuello de botella
Intentemos no mover la botella, no revisar todo lo que hay por turnos, sino ver qué tareas surgirán si, de repente, tuviéramos que diseñar un sistema similar a medida. Por supuesto, no vamos a inventar la rueda, pero utilizaremos este esquema para orientarnos sobre qué aspectos prestar atención en las descripciones de productos. Haremos un borrador de este esquema.
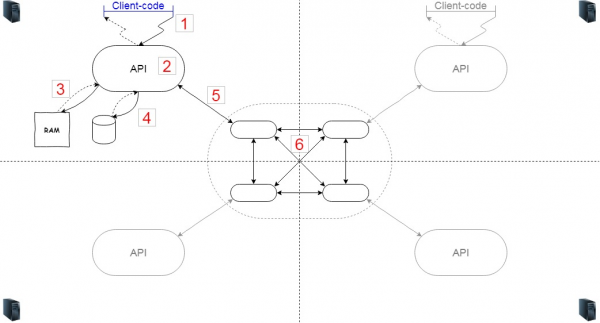
Si el sistema es distribuido, entonces tendremos varios servidores (6). Supongamos que cuatro (es conveniente colocarlos en la imagen, pero, por supuesto, pueden ser tantos como se desee). Si los servidores están en diferentes nodos, significa que en todos ellos hay algún código ejecutándose que se encarga de hacer que estos nodos formen un clúster y, en caso de desconexión, se reconozcan entre sí.
También se necesita un código lógico (2), que hable sobre la caché. Con este código, los clientes interactúan a través de alguna API. El código del cliente (1) puede estar tanto dentro de la misma JVM como comunicarse con él por la red. La lógica implementada internamente consiste en las decisiones sobre qué objetos mantener en la caché y cuáles desechar. Para almacenar la caché usamos la memoria (3), pero si es necesario, podemos guardar parte de los datos en el disco (4).
Veamos en qué partes se generará carga. En realidad, cada flecha y cada nodo se verán afectados. Primero, entre el código del cliente y la API, si se trata de una interacción en red, la caída puede ser bastante notable. En segundo lugar, dentro de la propia API: si complicamos demasiado la lógica, podríamos toparnos con el CPU. Y sería bueno que la lógica no utilizara la memoria innecesariamente. Y queda la interacción con el sistema de archivos: en una variante normal, esto implica serializar / restaurar y escribir / leer.
A continuación, la interacción con el clúster. Lo más probable es que esté en este mismo sistema, pero también puede estar separado. Aquí también es necesario tener en cuenta la transmisión de datos hacia él, la velocidad de serialización de datos y la interacción entre clústeres.
Ahora, por un lado, podemos imaginar 'qué engranajes girarán' en el sistema de caché al procesar solicitudes de nuestro código, y por otro lado, podemos estimar cuántas y qué solicitudes generará nuestro código hacia este sistema. Esto es suficiente para hacer una elección más o menos sensata: seleccionar un sistema que se ajuste a nuestro caso de uso.
Hazelcast
Veamos cómo aplicar esta descomposición a nuestra lista. Por ejemplo, Hazelcast.
Para añadir/quitar datos de Hazelcast, el código del cliente se dirige (1) a la API. Hz permite iniciar un servidor como embebido, y en este caso, llamar a la API es una invocación de un método dentro de la JVM, se puede considerar gratuito.
Para que la lógica funcione en (2), Hz se basa en el hash de un arreglo de bytes de la clave serializada, es decir, la serialización de la clave se llevará a cabo de todos modos. Este es un overhead inevitable para Hz.
Las estrategias de desalojo están bien implementadas, pero para casos especiales, se pueden conectar las propias. No hay que preocuparse por esta parte.
El almacenamiento (4) se puede conectar. Excelente. La interacción (5) para embedded puede considerarse instantánea. El intercambio de datos entre nodos en el clúster (6) – sí, existe. Esto contribuye a la resistencia a fallos a costa de la velocidad. La característica de Hz Near-cache permite reducir el precio: los datos obtenidos de otros nodos del clúster serán almacenados en caché.
¿Qué se puede hacer en tales condiciones para aumentar la velocidad?
Por ejemplo, para evitar la serialización de la clave en (2) – añadir otra caché sobre Hazelcast, para los datos más calientes. En Sportmaster, para este propósito, eligieron Caffeine.
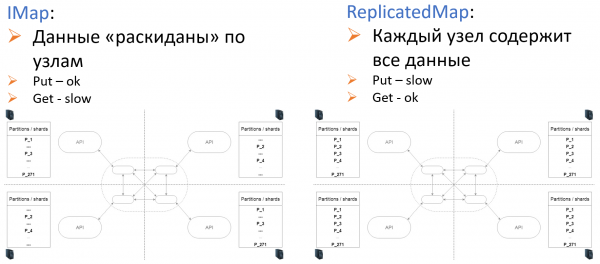
Para ajustar al nivel (6), en Hz se propusieron dos tipos de almacenamiento: IMap y ReplicatedMap.
Vale la pena mencionar cómo Hazelcast llegó al stack tecnológico de Sportmaster.
En 2012, cuando trabajábamos en el primer piloto del futuro sitio web, Hazelcast resultó ser el primer enlace que arrojó el motor de búsqueda. La conexión se estableció "desde el primer momento" — nos convenció que solo dos horas después de integrar Hz en el sistema, ya estaba funcionando. Y funcionaba bien. Hasta el final del día escribimos algunas pruebas, nos alegramos. Y esa reserva de energía fue suficiente para superar las sorpresas que Hz iba presentando con el tiempo. Actualmente, el equipo de Sportmaster no tiene razones para renunciar a Hazelcast.
Pero argumentos como "el primer enlace en el motor de búsqueda" y "armamos rápidamente HelloWorld" son, por supuesto, una excepción y una particularidad del momento en que se realizó la elección. Las verdaderas pruebas para el sistema elegido comienzan con el despliegue en producción, y es precisamente en esta etapa donde se debe prestar atención al elegir cualquier sistema, incluso la caché. De hecho, en nuestro caso se puede decir que elegimos Hazelcast por casualidad, pero luego resultó que elegimos correctamente.
Para producción, es mucho más importante: monitoreo, manejo de fallos en nodos individuales, replicación de datos, costo de escalado. Es decir, se debe prestar atención a las tareas que surgirán precisamente en el mantenimiento del sistema – cuando la carga supere por decenas de veces lo planificado, cuando accidentalmente subamos algo incorrecto y en el lugar equivocado, cuando se requiera desplegar una nueva versión del código, cambiar datos y hacerlo sin que los clientes lo noten.
Para todos estos requisitos, Hazelcast, sin duda, es adecuado.
Continuará
Pero Hazelcast no es una panacea. En 2017, elegimos Hazelcast para el caché en el panel de administración, simplemente basándonos en la buena impresión de experiencias pasadas. Esto jugó un papel clave en una muy amarga broma, lo que nos llevó a una situación complicada de la que «heroicamente» salimos después de 60 días. Pero sobre esto, en la próxima parte.
Y mientras tanto… ¡Feliz nuevo código!
Fuente: habr.com
