

A todos nos gustan las historias. Nos gusta, sentados junto al fuego, contar sobre nuestras viejas victorias, batallas o simplemente sobre nuestra experiencia laboral.
Hoy es un día así. Y aunque no estés junto al fuego, tenemos una historia para ti. Una historia sobre cómo comenzamos a trabajar con el almacenamiento en Tarantool.
Hace mucho tiempo, en nuestra empresa había un par de «monolitos» y un único «techo» que estos monolitos se acercaban lentamente, limitando el vuelo de nuestra empresa, nuestro desarrollo. Y había una comprensión clara: un día nos golpearíamos con fuerza contra ese techo.
Ahora mismo, nuestra ideología se basa en la separación de todo y de todos, desde el hardware hasta la lógica empresarial. Como resultado, por ejemplo, tenemos dos centros de datos prácticamente independientes a nivel de red. Pero en aquel entonces, todo era muy diferente.
Hoy en día, hay un montón de herramientas y medios para realizar cambios, como CI/CD, K8S, etc. En la época «monolítica», no necesitábamos tantas palabras extranjeras. Era suficiente con simplemente corregir la «almacenista» en la base de datos.
Pero el tiempo avanzó, y la cantidad de solicitudes creció junto con él, disparando los RPS a veces más allá de nuestras capacidades. Al ingresar al mercado de los países de la CEI, la carga en el procesador de la base de datos del primer monolito no bajaba del 90 %, y los RPS se mantenían en 2400. Y no eran solo pequeñas selecciones, eran grandes solicitudes con un montón de verificaciones y JOINs que podían recorrer casi la mitad de los datos en un gran IO.
Cuando las verdaderas ventas comenzaron a aparecer en «Black Friday», y Wildberries comenzó a realizarlas como uno de los primeros en Rusia, la situación se volvió bastante triste. La carga en esos días aumenta tres veces.
¡Ah, esos «tiempos monolíticos»! Estoy seguro de que tú también te has enfrentado a algo así, y aún no puedes entender cómo pudo suceder eso contigo.
No se puede evitar, la moda también afecta a las tecnologías. Hace unos 5 años, tuvimos que replantear una de esas modas, como el sitio web existente en .NET y MS SQL Server, que guardaba celosamente toda la lógica de funcionamiento del propio sitio. Lo guardaba de tal manera que cortar un monolito así resultó ser un placer largo y nada fácil.
Una pequeña digresión.
En diferentes eventos, digo: «¡si no has descompuesto el monolito, entonces no has crecido!» Estoy interesado en tu opinión al respecto, por favor, compártela en los comentarios.
Y estalló el trueno
Volvamos a nuestro «hoguera». Para distribuir la carga de la funcionalidad «monolítica», decidimos dividir el sistema en microservicios basados en tecnologías de código abierto. Porque, como mínimo, su escalabilidad es más económica. Y éramos 100% conscientes de que habría que escalar (y mucho). Ya en ese momento habíamos logrado acceder a los mercados de países vecinos, y tanto la cantidad de registros como la de pedidos empezaron a crecer aún más.
Al analizar los primeros candidatos para salir del monolito hacia los microservicios, entendimos que el 80 % de las escrituras en ellos provenía en un 99 % de sistemas back office, mientras que las lecturas venían de la línea del frente. Esto se refería en primer lugar a un par de subsistemas importantes para nosotros: datos de usuarios y el sistema de cálculo del precio final de los productos basado en la información sobre descuentos adicionales para clientes y cupones.
A modo de paréntesis. Ahora es difícil de imaginar, pero además de los subsistemas mencionados, también se extrajeron del nuestro monolito catálogos de productos, el carrito de usuario, el sistema de búsqueda de productos, el sistema de filtrado de catálogos de productos y varios sistemas de recomendaciones. Para el funcionamiento de cada uno de ellos, existen clases separadas de sistemas especializados, pero en su momento todos vivían en una sola “casita”.
Decidimos extraer los datos sobre nuestros clientes a un sistema de shard. Sin embargo, extraer la funcionalidad para calcular el precio final de los productos requería una buena escalabilidad en cuanto a lectura, ya que esta generaba la mayor carga en RPS y era la más difícil de implementar para la base de datos (muchos datos estaban involucrados en el proceso de cálculos).
Como resultado, surgió un esquema que se ajusta bien a Tarantool.
En ese momento, para el funcionamiento de los microservicios se eligieron esquemas de trabajo con varios centros de datos en máquinas virtuales y físicas. Como se muestra en las ilustraciones, se aplicaron variantes de replicaciones de Tarantool tanto en modo master-master como master-slave.
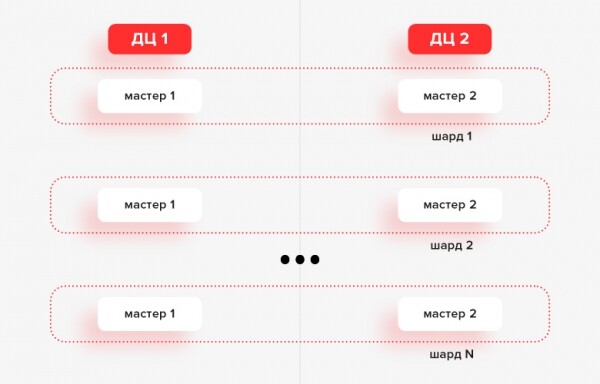
Arquitectura. Opción 1. Servicio de usuarios
En la actualidad, hay 24 shards, en cada uno de los cuales hay 2 instancias (una en cada DC), todas en modo master-master.
Sobre la base de datos se encuentran aplicaciones que acceden a las réplicas de la base de datos. Las aplicaciones funcionan con Tarantool a través de nuestra biblioteca personalizada, que implementa la interfaz del controlador Go de Tarantool. Ella ve todas las réplicas y puede trabajar con el maestro en lectura y escritura. En esencia, implementa un modelo de conjunto de réplicas, al que se le ha añadido la lógica de selección de réplicas, ejecución de reintentos, cortacircuitos y límite de tasa.
Además, existe la posibilidad de configurar la política de selección de réplicas en el contexto de la partición. Por ejemplo, utilizando round-robin.
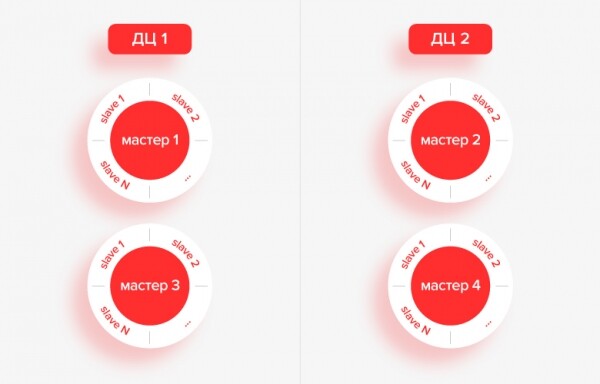
Arquitectura. Opción 2. Servicio de cálculo del costo final del producto.
Hace varios meses, la mayor parte de las solicitudes para calcular el costo final de los productos se trasladaron a un nuevo servicio, que en principio funciona sin bases de datos, pero hace un tiempo el 100% era procesado por un servicio con Tarantool detrás.
La base de datos del servicio consta de 4 maestros, en los que el sincronizador recopila datos, y cada uno de estos maestros distribuye datos a las réplicas de solo lectura a través de replicación. Cada maestro tiene aproximadamente 15 de tales réplicas.
Tanto en el primer como en el segundo esquema, en caso de que un centro de datos no esté disponible, la aplicación puede obtener datos desde el segundo.
Cabe destacar que en Tarantool la replicación es bastante flexible y se configura en tiempo de ejecución. En otros sistemas, a veces surgían dificultades. Por ejemplo, en PostgreSQL, cambiar los parámetros max_wal_senders y max_replication_slots requiere reiniciar el maestro, lo que en algunos casos puede llevar a la desconexión entre la aplicación y la base de datos.
¡Buscar y encontrarás!
¿Por qué no hicimos "como la gente normal", sino que elegimos un enfoque atípico? Dependerá de lo que se considere normal. Muchos crean clústeres de Mongo y los distribuyen entre tres centros de datos geográficamente dispersos.
En ese momento ya teníamos dos proyectos en Redis. El primero era un caché, y el segundo representaba un almacenamiento persistente para datos no demasiado críticos. Con este último fue bastante complicado, en parte debido a nuestra culpa. A veces, volúmenes bastante grandes estaban en la clave, y de vez en cuando el sitio experimentaba problemas. Usamos este sistema en un modo maestro-esclavo. Y hubo muchos casos en los que algo sucedía con el maestro y la replicación fallaba.
Es decir, Redis es bueno para tareas sin estado, no para las que requieren estado. En principio, resolvía la mayoría de los problemas, pero solo si se trataba de soluciones clave-valor con un par de índices. Sin embargo, en ese momento Redis tenía serias limitaciones en cuanto a persistencia y replicación. Además, hubo quejas sobre su rendimiento.
Consideramos MySQL y PostgreSQL. Pero el primero no encajó bien con nosotros, mientras que el segundo es un producto bastante sofisticado, y construir servicios simples sobre él sería poco práctico.
Probamos RIAK, Cassandra, e incluso bases de datos gráficas. Todo esto son soluciones bastante nicho, que no eran adecuadas como una herramienta universal para crear servicios.
En última instancia, nos decidimos por Tarantool.
Nos acercamos a él cuando estaba en la versión 1.6. Nos interesó la combinación de funcionalidades key-value y de base de datos relacional. Tiene índices secundarios, transacciones y espacios, que son como tablas, pero no simples, se puede almacenar en ellas una cantidad variable de columnas. Pero la característica más destacada de Tarantool fueron los índices secundarios combinados con la funcionalidad de clave-valor y transacciones.
También jugó un papel importante la comunidad de habla rusa, que estaba dispuesta a ayudar en el chat. Aprovechamos esto activamente y realmente vivíamos en el chat. No se debe olvidar la buena persistencia sin fallos evidentes. Si miramos nuestra historia con Tarantool, tuvimos muchos dolores y contratiempos con la replicación, ¡pero nunca perdimos datos por su culpa!
La implementación comenzó con dificultades.
En ese momento, nuestro stack de desarrollo principal era .NET, para el cual no había un conector para Tarantool. Así que comenzamos a hacer algo en Go. También funcionó bastante bien con Lua. El mayor problema en ese momento era la depuración: en .NET todo estaba bien, pero luego nos sumergimos en el mundo de Lua embebido, donde no tenías más que registros y ninguna posibilidad de depurar, lo que resultó complicado. Además, la replicación se rompía de vez en cuando, tuvimos que profundizar en la arquitectura del motor Tarantool. El chat ayudó en esto, y en menor medida la documentación, a veces consultábamos el código. En ese momento, la documentación dejaba mucho que desear.
Así, durante varios meses, logré adquirir experiencia y obtener resultados satisfactorios trabajando con Tarantool. Documentamos en git los desarrollos de referencia que ayudaron en la creación de nuevos microservicios. Por ejemplo, cuando surgía la tarea de crear un nuevo microservicio, el desarrollador consultaba el código fuente de la solución de referencia en el repositorio, y la creación de uno nuevo no tomaba más de una semana.
Eran tiempos especiales. En aquella época, podías acercarte al administrador en la mesa de al lado y pedir: "Dame una máquina virtual". En unos treinta minutos, ya la tenías. Te conectabas, instalabas todo y te comenzaban a dirigir tráfico hacia ella.
Hoy en día eso ya no es posible: hay que configurar el monitoreo del servicio, la registración, cubrir la funcionalidad con pruebas, solicitar una máquina virtual o hacer la implementación en Kubernetes, etc. En general, así será mejor, aunque más largo y complicado.
Divide y conquistarás. ¿Cómo están las cosas con Lua?
Hubo una seria dilema: algunos equipos no lograban desplegar cambios de manera confiable en un servicio con mucha lógica escrita en Lua. Muchas veces esto resultaba en la inoperatividad del servicio.
Es decir, los desarrolladores preparan algún cambio. Tarantool comienza a hacer la migración, pero la réplica todavía tiene el código antiguo; llega algún DDL por replicación, algo más, y el código simplemente se desmorona porque no se tenía en cuenta. Como resultado, el procedimiento de actualización para los administradores estaba escrito en una hoja A4: detener la replicación, actualizar esto, reiniciar la replicación, apagar aquí, actualizar allá. ¡Un desastre!
Al final, ahora intentamos no hacer nada en Lua la mayoría de las veces. Simplemente a través de iproto (protocolo binario para interactuar con el servidor), y eso es todo. Tal vez sea una falta de conocimiento por parte de los desarrolladores, pero por este punto de vista el sistema es complicado.
No siempre seguimos este guion ciegamente. Hoy en día no tenemos un blanco y negro: o todo en Lua o todo en Go. Ya entendemos cómo se puede combinar para no tener problemas con la migración en el futuro.
¿Dónde se encuentra ahora Tarantool?
Tarantool se utiliza en el servicio de cálculo del precio final de los productos, teniendo en cuenta los cupones de descuento, conocido como «Promodaizer». Como mencioné anteriormente, actualmente se está desvinculando: lo reemplaza un nuevo servicio de catálogo con precios precalculados, pero hace seis meses, todos los cálculos se realizaban en «Promodaizer». Anteriormente, la mitad de su lógica estaba escrita en Lua. Hace dos años, se convirtió en un almacenamiento, y la lógica fue reescrita en Go, porque la mecánica de funcionamiento de los descuentos cambió un poco y al servicio le faltaba rendimiento.
Uno de los servicios más críticos es el perfil de usuario. Es decir, todos los usuarios de Wildberries se almacenan en Tarantool, y son alrededor de 50 millones. Un sistema shardeado por ID de usuario, distribuido en varios centros de datos con un enlace en servicios de Go.
En cuanto a RPS, anteriormente «Promodaizer» era el líder, alcanzando hasta 6,000 solicitudes. En algún momento teníamos de 50 a 60 instancias. Ahora, el líder en RPS son los perfiles de usuarios, aproximadamente bajo 12,000. Este servicio utiliza un sharding personalizado con divisiones por rangos de ID de usuario. El servicio da soporte a más de 20 máquinas, pero eso es demasiado, planeamos reducir los recursos dedicados porque suficientes capacidades son proporcionadas por 4-5 máquinas.
El servicio de sesiones es nuestro primer servicio en vshard y Cartridge. La configuración de vshard y la actualización de Cartridge requirieron un esfuerzo considerable, pero al final todo salió bien.
El servicio para mostrar diferentes banners en el sitio web y en la aplicación móvil fue uno de los primeros en lanzarse en Tarantool. Este servicio es notable por su antigüedad, tiene alrededor de 6-7 años, sigue funcionando y nunca se ha reiniciado. Se utilizó replicación master-master. Nunca se ha roto nada.
Hay un ejemplo de uso de Tarantool para la funcionalidad de directorios rápidos en el sistema de almacenes, para verificar rápidamente la información en ciertos casos. Intentamos usar Redis para esto, pero los datos en memoria ocupaban más espacio que en Tarantool.
Los servicios de lista de espera, suscripciones de clientes, las populares historias y los productos pendientes también funcionan con Tarantool. El último servicio ocupa aproximadamente 120 GB en memoria. Es el servicio más voluminoso de los mencionados.
Conclusión
Gracias a los índices secundarios en combinación con key-value y la transaccionabilidad, Tarantool es ideal para arquitecturas basadas en microservicios. Sin embargo, nos encontramos con dificultades al implementar cambios en los servicios que contenían una lógica extensa en Lua; los servicios a menudo dejaban de funcionar. No logramos superar esto, y con el tiempo llegamos a diferentes combinaciones de Lua y Go: sabemos cuándo es conveniente usar un lenguaje y cuándo el otro.
Lecturas adicionales sobre el tema
- Creamos desde cero una aplicación de alta carga en Tarantool.
- La elección confiable del líder en Tarantool Cartridge.
- Canal de Telegram de Tarantool con noticias sobre el producto.
- Discute Tarantool en el chat de la comunidad.
Fuente: habr.com
