

Nota de traducción.: Le presentamos los detalles técnicos sobre las causas de la reciente inactividad en el servicio de nube administrado por los creadores de Grafana. Este es un ejemplo clásico de cómo una nueva y aparentemente útil funcionalidad, diseñada para mejorar la calidad de la infraestructura... puede causar problemas si no se consideran los numerosos matices de su aplicación en entornos de producción. Es fantástico cuando surgen materiales como este que permiten aprender no solo de nuestros propios errores. Los detalles están en la traducción de este texto del vicepresidente de producto de Grafana Labs.
El viernes 19 de julio, el servicio Hosted Prometheus en Grafana Cloud dejó de funcionar durante aproximadamente 30 minutos. Pido disculpas a todos los clientes afectados por la interrupción. Nuestra misión es proporcionar las herramientas necesarias para la monitorización, y entendemos que su falta dificulta su trabajo. Tomamos este incidente muy en serio. En esta nota se explica lo que ocurrió, cómo respondimos y qué estamos haciendo para asegurarnos de que no vuelva a ocurrir.
Antecedentes
El servicio Grafana Cloud Hosted Prometheus se basa en — el proyecto CNCF para crear un servicio Prometheus escalable horizontalmente, altamente disponible y multitenant. La arquitectura de Cortex consiste en un conjunto de microservicios individuales, cada uno de los cuales cumple su función: replicación, almacenamiento, consultas, etc. Cortex se está desarrollando activamente, constantemente se añaden nuevas capacidades y se aumenta su rendimiento. Desplegamos regularmente nuevas versiones de Cortex en los clústeres para que los clientes puedan aprovechar estas funciones, ya que Cortex puede actualizarse sin tiempos de inactividad.
Para actualizaciones sin inactividad, el servicio Ingester de Cortex requiere una réplica adicional de Ingester durante el proceso de actualización. (Nota de traducción.: — el componente base de Cortex. Su tarea es recopilar un flujo constante de muestras, agruparlas en chunks de Prometheus y guardarlas en bases de datos como DynamoDB, BigTable o Cassandra.) Esto permite que los antiguos Ingester envíen datos actuales a los nuevos Ingester. Cabe destacar que los Ingester son exigentes en recursos. Para su funcionamiento, se necesitan 4 núcleos y 15 GB de memoria por pod, es decir, el 25% de la potencia de procesamiento y la memoria de la máquina base en el caso de nuestros clústeres de Kubernetes. En general, normalmente tenemos muchos más recursos no utilizados en el clúster que solo 4 núcleos y 15 GB de memoria, por lo que podemos ejecutar fácilmente estos Ingester adicionales durante las actualizaciones.
Sin embargo, a menudo ocurre que durante el funcionamiento normal no hay esos 25% de recursos no utilizados en ninguna de las máquinas. Además, no estamos buscando eso: la CPU y la memoria siempre son útiles para otros procesos. Para solucionar este problema, decidimos utilizar . La idea es dar a los Ingester una prioridad más alta que a otros microservicios (sin estado). Cuando necesitamos iniciar un Ingester adicional (N+1), temporalmente desalojamos otros pods más pequeños. Estos pods se trasladan a los recursos libres en otras máquinas, dejando un "hueco" lo suficientemente grande para iniciar un Ingester adicional.
El jueves 18 de julio, desplegamos cuatro nuevos niveles de prioridad en nuestros clústeres: crítico, un alto, medio y bajo. Fueron probados en un clúster interno sin tráfico de clientes durante aproximadamente una semana. Por defecto, los pods sin prioridad asignada recibían medio prioridad, mientras que a los Ingester se les asignó una clase de alta prioridad. El Crítico fue reservado para la monitorización (Prometheus, Alertmanager, node-exporter, kube-state-metrics, etc.). Nuestra configuración es pública, y se puede ver el PR .
Fallo
El viernes 19 de julio, uno de los ingenieros lanzó un nuevo clúster de Cortex dedicado para un gran cliente. La configuración para este clúster no incluía las nuevas prioridades de los pods, por lo que a todos los nuevos pods se les asignó la prioridad por defecto — medio.
No había suficientes recursos en el clúster de Kubernetes para el nuevo clúster de Cortex, y el clúster de producción existente de Cortex no se había actualizado (los Ingester se quedaron sin alta prioridad). Dado que los Ingester del nuevo clúster tenían por defecto medio prioridad, y los pods existentes en producción operaban sin prioridad, los Ingester del nuevo clúster desplazaron a los Ingester del clúster de producción existente de Cortex.
El ReplicaSet para el Ingester desplazado en el clúster de producción detectó el pod desplazado y creó uno nuevo para mantener el número de copias requerido. Al nuevo pod se le asignó por defecto medio prioridad, y el siguiente "antiguo" Ingester en producción perdió recursos. El resultado fue un proceso avalancha, que llevó al desplazamiento de todos los pods con Ingester para los clústeres de producción de Cortex.
Los Ingester son persistentes y almacenan datos de las últimas 12 horas. Esto nos permite comprimirlos de manera más eficiente antes de escribirlos en el almacenamiento a largo plazo. Para ello, Cortex realiza un sharding de datos por series, utilizando una tabla hash distribuida (Distributed Hash Table, DHT), y replica cada serie en tres Ingester a través de un consenso de quórum al estilo Dynamo. Cortex no escribe datos en los Ingester que están desconectados. Así, cuando un gran número de Ingester abandona la DHT, Cortex no puede asegurar una replicación adecuada de las entradas y estas "fallan".
Detección y resolución
Las nuevas alertas de Prometheus basadas en el "presupuesto de errores" (error-budget-based — los detalles aparecerán en un futuro artículo) empezaron a sonar la alarma 4 minutos después del inicio de la desconexión. Durante los siguientes cinco minutos aproximadamente, realizamos un diagnóstico y aumentamos el clúster de Kubernetes subyacente para alojar tanto los nuevos como los existentes clústeres de producción.
Otros cinco minutos después, los antiguos Ingester registraron con éxito sus datos, y los nuevos se iniciaron, y los clústeres de Cortex volvieron a estar disponibles.
Otros 10 minutos se dedicaron al diagnóstico y la corrección de errores de falta de memoria (OOM) de los servidores proxy reversos de autenticación, situados delante de Cortex. Los errores OOM fueron causados por un aumento de diez veces en el QPS (lo que creemos que se debió a solicitudes excesivamente agresivas de los servidores clientes de Prometheus).
Consecuencias
La duración total del tiempo de inactividad fue de 26 minutos. Los datos no se perdieron. Los Ingester lograron cargar todos los datos en memoria en el almacenamiento a largo plazo. Durante la desconexión, los servidores Prometheus de los clientes mantuvieron en búfer las entradas (remotas) con apoyo del basado en WAL (desarrollado por de Grafana Labs) y repitieron las entradas fallidas después de la caída.
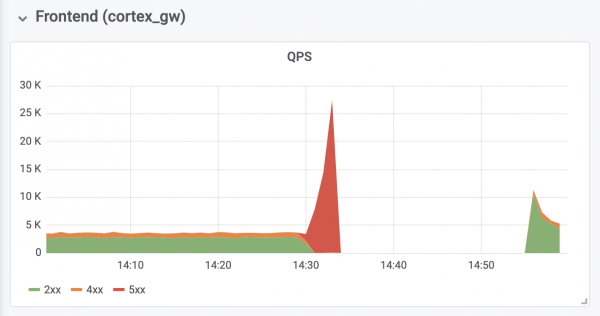
Las operaciones de escritura del clúster de producción
Conclusiones
Es importante aprender lecciones de este incidente y tomar las medidas necesarias para evitar que se repita.
Al mirar hacia atrás, debemos reconocer que no debimos establecer por defecto medio prioridad, hasta que todos los Ingester en producción recibieran un alto prioridad. Además, debimos preocuparnos de antemano por su alto prioridad. Ahora todo está corregido. Esperamos que nuestra experiencia ayude a otras organizaciones que están considerando el uso de prioridades de pods en Kubernetes.
Añadiremos un nivel adicional de control sobre el despliegue de cualquier objeto adicional, cuya configuración sea global para el clúster. En adelante, tales cambios serán evaluados pormayor audiencia.más personas. Además, la modificación que causó la falla se consideró demasiado insignificante para un documento de proyecto separado — solo se discutió en un issue de GitHub. De ahora en adelante, todos los cambios de configuración similares irán acompañados de la documentación del proyecto correspondiente.
Por último, automatizaremos la mejora del tamaño del proxy inverso de autenticación para prevenir OOM en caso de sobrecarga, lo que hemos presenciado, y analizaremos los parámetros predeterminados de Prometheus relacionados con la reversión y escalado, para prevenir problemas similares en el futuro.
La falla experimentada tuvo algunas consecuencias positivas: al obtener los recursos necesarios, Cortex se recuperó automáticamente sin intervención adicional. También obtuvimos valiosa experiencia al trabajar con — nuestro nuevo sistema de agregación de registros, — que ayudó a asegurar que todos los Ingester se comportaran correctamente durante y después de la falla.
P.D. del traductor
También puedes leer en nuestro blog:
- «»;
- «»;
- «»;
- «».
Fuente: habr.com
