

Un equipo de ingenieros del MIT ha desarrollado una jerarquía de memoria orientada a objetos para un manejo de datos más eficiente. En este artículo, examinamos cómo está estructurada.
/ / PD
Como se sabe, el aumento del rendimiento de los CPU modernos no viene acompañado de una reducción correspondiente en la latencia de acceso a la memoria. La diferencia en los indicadores de un año a otro puede alcanzar hasta 10 veces (). Como resultado, se genera un cuello de botella que impide aprovechar plenamente los recursos disponibles y ralentiza el procesamiento de datos.
El daño al rendimiento lo causa la llamada latencia de descompresión. En algunos casos, la preparación de la descompresión de datos puede tardar hasta 64 ciclos de CPU.
Para comparar: la suma y multiplicación de números de punto flotante no más de diez ciclos. El problema es que la memoria trabaja con bloques de datos de tamaño fijo, mientras que las aplicaciones operan con objetos que pueden contener diferentes tipos de datos y variar en tamaño. Para solucionar este problema, los ingenieros del MIT han desarrollado una jerarquía de memoria orientada a objetos que optimiza el procesamiento de datos.
Cómo funciona la tecnología
La solución se basa en tres tecnologías: Hotpads, Zippads y un algoritmo de compresión COCO.
Hotpads es una jerarquía de memoria de registro de súper operación controlada por software (). Estos registros se llaman pads y hay tres de ellos, de L1 a L3. En ellos se almacenan objetos de diferentes tamaños, metadatos y arreglos de punteros.
En esencia, la arquitectura es un sistema de cachés, pero diseñado para trabajar con objetos. El nivel de pad donde se encuentra un objeto depende de cuán frecuentemente se utiliza. Si uno de los niveles "se desborda", el sistema activa un mecanismo similar a los "recolectores de basura" en lenguajes como Java o Go. Este analiza qué objetos se usan con menos frecuencia y los mueve automáticamente entre los niveles.
Zippads funciona sobre la base de Hotpads: archiva y desarchiva los datos que entran o salen de los dos últimos niveles de la jerarquía: el pad L3 y la memoria principal. En los pads uno y dos, los datos se almacenan en su forma inalterada.
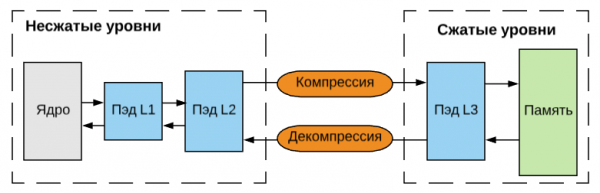
Zippads comprime objetos de hasta 128 bytes. Los objetos más grandes se dividen en partes que se almacenan en diferentes áreas de la memoria. Según los desarrolladores, este enfoque aumenta el coeficiente de memoria utilizada eficientemente.
Para la compresión de objetos se utiliza el algoritmo COCO (Compresión entre Objetos), del cual hablaremos a continuación, aunque el sistema también puede trabajar con o . El algoritmo COCO es una variante de compresión diferencial (). Compara objetos con 'base' y elimina los bits repetidos; vea el esquema a continuación:
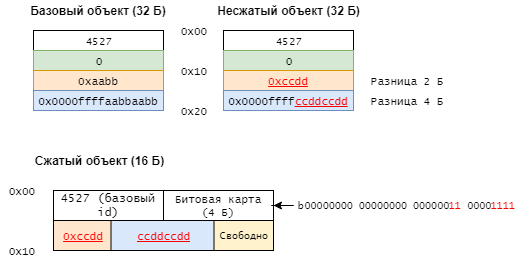
Según ingenieros del MIT, su jerarquía de memoria orientada a objetos es un 17% más eficiente que los enfoques clásicos. Está mucho más alineada con la arquitectura de aplicaciones modernas, por lo que el nuevo método tiene potencial.
Se espera que primero la tecnología sea adoptada por empresas que trabajen con grandes volúmenes de datos y algoritmos de aprendizaje automático. Otra dirección potencial son las plataformas en la nube. Los proveedores de IaaS podrán trabajar de manera más efectiva con virtualización, sistemas de almacenamiento de datos y recursos computacionales.
Nuestros recursos y fuentes adicionales:


Fuente: habr.com
