

Este artículo describe la implementación de pipes en el núcleo de Unix. Me sentí un poco decepcionado al ver que un artículo reciente titulado «» resultó ser no sobre la estructura interna. Me intrigó, así que busqué en fuentes antiguas para encontrar la respuesta.
¿De qué se trata?
Los pipes — "probablemente el invento más importante en Unix" — son una característica definitoria de la filosofía de Unix que une pequeños programas, así como la conocida línea de comando:
$ echo hello | wc -c
6
Esta funcionalidad depende del llamado al sistema proporcionado por el núcleo pipe, el cual está descrito en las páginas de documentación y :
Los pipes proporcionan un canal unidireccional para la comunicación entre procesos. Un pipe tiene una entrada (extremo de escritura) y una salida (extremo de lectura). Los datos escritos en la entrada del pipe pueden ser leídos desde la salida.
El pipe se crea mediante la llamada
pipe(2), que devuelve dos descriptores de archivo: uno se refiere a la entrada del pipe y el otro a la salida.
Los resultados del trazado del comando anterior demuestran la creación del pipe y el flujo de datos a través de él de un proceso a otro:
$ strace -qf -e execve,pipe,dup2,read,write
    sh -c 'echo hello | wc -c'

execve("/bin/sh", ["sh", "-c", "echo hello | wc -c"], …)
pipe([3, 4])                            = 0
[pid 2604795] dup2(4, 1)                = 1
[pid 2604795] write(1, "hellon", 6)    = 6
[pid 2604796] dup2(3, 0)                = 0
[pid 2604796] execve("/usr/bin/wc", ["wc", "-c"], …)
[pid 2604796] read(0, "hellon", 16384) = 6
[pid 2604796] write(1, "6n", 2)        = 2
El proceso padre llama a pipe(), para obtener los descriptores de archivo conectados. Un proceso hijo escribe en un descriptor, mientras que otro proceso lee los mismos datos desde otro descriptor. La shell usa dup2 para "renombrar" los descriptores 3 y 4 para que correspondan a stdin y stdout.
Sin pipes, la shell tendría que escribir el resultado de un proceso en un archivo y pasárselo a otro proceso para que leyera los datos del archivo. Como resultado, gastaríamos más recursos y espacio en disco. Sin embargo, los pipes no solo son buenos porque evitan el uso de archivos temporales:
Si un proceso intenta leer de un pipe vacío, entonces
read(2)se bloqueará hasta que los datos estén disponibles. Si un proceso intenta escribir en un pipe lleno, entonceswrite(2)se bloqueará hasta que se lean suficientes datos del canal para realizar la escritura.
Como exige POSIX, esta es una propiedad importante: la escritura en el canal hasta PIPE_BUF bytes (al menos 512) debe ser atómica, para que los procesos puedan interactuar entre sí a través del canal de la manera en que los archivos normales (que no proporcionan tales garantías) no pueden.
Al usar un archivo normal, un proceso puede escribir toda su salida en él y transmitirla a otro proceso. O los procesos pueden actuar en modo de paralelismo extremo, utilizando un mecanismo de señalización externo (como un semáforo) para comunicarse entre sí sobre la finalización de la escritura o lectura. Los canales nos liberan de todas estas complicaciones.
¿Qué estamos buscando?
Lo explicaré de manera sencilla, para que se le sea más fácil imaginar cómo puede funcionar un canal. Necesitará asignar un búfer en memoria y algún estado. Se requerirán funciones para agregar y eliminar datos del búfer. Se necesitará algún medio para invocar funciones durante las operaciones de lectura y escritura en los descriptores de archivo. Y serán necesarias bloqueos para implementar el comportamiento especial descrito anteriormente.
Ahora estamos listos para interrogar con luz brillante el código fuente del núcleo, para confirmar o refutar nuestro borroso modelo mental. Pero siempre esté preparado para sorpresas.
¿Dónde estamos buscando?
No sé dónde se encuentra mi copia del famoso libro “” con el código fuente de Unix 6, pero gracias a se puede buscar en línea en de versiones aún más antiguas de Unix.
Navegar por los archivos de TUHS es como visitar un museo. Podemos mirar nuestra historia común, y siento respeto por los muchos años de esfuerzo para recuperar todo este material bit a bit de viejas cintas y documentos. Y soy muy consciente de los fragmentos que aún faltan.
Satisfecho mi curiosidad sobre la antigua historia de los canales, para comparar podemos observar los núcleos modernos.
Por cierto, pipe es la llamada al sistema número 42 en la tabla sysent[]. ¿Coincidencia?
Núcleos tradicionales de Unix (1970–1974)
No encontré ninguna pista pipe(2) ni en (enero de 1970), ni en (noviembre de 1971), ni en el código fuente incompleto (junio de 1972).
TUHS afirma que (febrero de 1973) fue la primera versión con tuberías:
La tercera edición de Unix fue la última versión con un núcleo escrito en ensamblador, pero al mismo tiempo, la primera versión con tuberías. Durante 1973, se trabajó en mejorar la tercera edición, reescribiendo el núcleo en C, y así apareció la cuarta edición de Unix.
Uno de los lectores encontró un escaneo de un documento en el que Doug McIlroy propuso la idea de "conectar programas según el principio de una manguera de jardín".
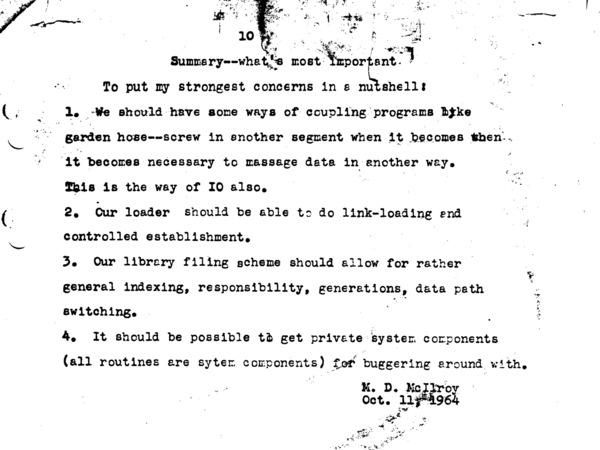
En el libro de Brian Kernighan "", también se menciona este documento en la historia de la aparición de las tuberías: "… estuvo colgado en la pared de mi oficina en Bell Labs durante 30 años". Aquí está , y otra historia del :
Cuando apareció Unix, mi interés por las corutinas me llevó a pedirle al autor del sistema operativo, Ken Thompson, que permitiera que los datos escritos en algún proceso no solo fueran enviados al dispositivo, sino también salieran hacia otro proceso. Ken decidió que esto era posible. Sin embargo, como minimalista, quería que cada función del sistema desempeñara un papel significativo. ¿Realmente la escritura directa entre procesos tiene una gran ventaja sobre la escritura en un archivo intermedio? Y solo cuando presenté una propuesta concreta con un nombre llamativo "tubería" y una descripción de la sintaxis de interacción entre procesos, Ken finalmente exclamó: "¡Lo haré!".
Y lo hizo. Una noche fatídica, Ken modificó el núcleo y la shell, corrigió varios programas estándar, estandarizando su procedimiento para aceptar datos de entrada (que pueden provenir de una tubería), así como cambió los nombres de los archivos. Al día siguiente, las tuberías comenzaron a aplicarse de manera muy amplia en las aplicaciones. Al final de la semana, las secretarias las utilizaban para enviar documentos desde editores de texto a la impresora. Poco después, Ken reemplazó la API original y la sintaxis para la shell del uso de tuberías por acuerdos más limpios que se han utilizado desde entonces.
Desafortunadamente, el código fuente del núcleo de la tercera edición de Unix se ha perdido. Y aunque tenemos el código fuente del núcleo escrito en C de la , que salió en noviembre de 1973, salió unos meses antes del lanzamiento oficial y no contiene la implementación de las tuberías. Es una lástima que el código fuente de la función legendaria de Unix esté perdido, posiblemente para siempre.
Tenemos el texto de la documentación sobre pipe(2) de ambas versiones, así que se puede comenzar a buscar en la documentación (por palabras específicas subrayadas "manualmente", línea de literales ^H, después de la cual viene un guion bajo!). Este proto-pipe(2) está escrito en ensamblador y devuelve solo un descriptor de archivo, pero ya proporciona la funcionalidad básica esperada:
Llamada del sistema pipe crea un mecanismo de entrada y salida que se llama tubería. El descriptor de archivo devuelto se puede usar para operaciones de lectura y escritura. Cuando se escribe algo en la tubería, se almacena en un búfer de hasta 504 bytes de datos, después de lo cual el proceso de escritura se suspende. Al leer de la tubería, se obtienen los datos almacenados.
Para el próximo año, el núcleo fue reescrito en C, y obtuvo su forma moderna con el prototipo "pipe(fildes)»:
Llamada del sistema pipe crea un mecanismo de entrada y salida que se llama tubería. Los descriptores de archivo devueltos se pueden utilizar en operaciones de lectura y escritura. Cuando se escribe algo en la tubería, se utiliza el descriptor devuelto en r1 (correspondiente a fildes[1]), que se almacena en un búfer de hasta 4096 bytes de datos, después de lo cual el proceso de escritura se suspende. Al leer de la tubería, el descriptor devuelto en r0 (correspondiente a fildes[0]) obtiene los datos.
Se supone que después de definir la tubería, dos (o más) procesos interactuantes (creados mediante llamadas posteriores a fork) transferirán datos de la tubería mediante llamadas a read y write.
En la shell hay una sintaxis para definir una matriz lineal de procesos, conectados a través de una tubería.
Las llamadas para leer de una tubería vacía (que no contiene datos almacenados), que solo tiene un extremo (con todos los descriptores de archivo de escritura cerrados), devuelven "fin de archivo". Las llamadas para escribir en una situación similar se ignoran.
La más antigua se refiere (junio de 1974), pero es casi idéntica a la que apareció en la siguiente versión. Solo se añadieron comentarios, por lo que se puede omitir la quinta edición.
La sexta edición de Unix (1975)
Comenzamos a leer el código fuente de Unix (mayo de 1975). En gran parte gracias a Lions es mucho más fácil encontrarlo que los fuentes de versiones anteriores:
Durante muchos años, el libro Lions fue el único documento sobre el núcleo de Unix disponible fuera de Bell Labs. Aunque la licencia de la sexta edición permitía a los docentes usar su código fuente, la licencia de la séptima edición excluyó esta posibilidad, por lo que el libro se distribuía en forma de copias mecanografiadas ilegales.
Hoy en día se puede comprar un ejemplar reimpreso del libro, en cuya portada aparecen estudiantes junto a una fotocopiadora. Y gracias a Warren Toomey (quien inició el proyecto TUHS), puedes descargar . Quiero darte una idea de cuánto esfuerzo se dedicó a crear este archivo:
Hace más de 15 años, tecleé una copia del código fuente, que aparece en Lions, porque no me gustaba la calidad de mi copia, hecha a partir de un número desconocido de copias. TUHS aún no existía, y no tenía acceso a fuentes antiguas. Pero en 1988, encontré una cinta antigua de 9 pistas, que contenía una copia de respaldo de una computadora PDP11. Era difícil saber si funcionaba, pero había un árbol intacto en /usr/src/, donde la mayoría de los archivos estaban marcados con el año 1979, lo que ya en ese momento parecía antiguo. Esta era la séptima edición o su derivado PWB, como yo pensaba.
Tomé ese hallazgo como base y edité manualmente las fuentes hasta llevarlas al estado de la sexta edición. Parte del código se mantuvo igual, parte tuvo que ser levemente editada, cambiando el token moderno += por el obsoleto =+. Extraje algo y reescribí otras partes, aunque no demasiadas.
Y hoy podemos leer en línea en TUHS el código fuente de la sexta edición desde .
Por cierto, a primera vista, la principal característica del código C antes de la época de Kernighan y Ritchie es su brevedad. No tan a menudo puedo insertar fragmentos de código sin una extensa edición, para que se ajusten a un área de visualización relativamente estrecha en mi sitio.
Al principio hay un comentario explicativo (y sí, allí hay aún ):
/*
 * Max allowable buffering per pipe.
 * This is also the max size of the
 * file created to implement the pipe.
 * If this size is bigger than 4096,
 * pipes will be implemented in LARG
 * files, which is probably not good.
 */
#define    PIPSIZ    4096
el tamaño del búfer no ha cambiado desde la cuarta edición. Pero aquí, sin ninguna documentación pública, vemos que en algún momento las tuberías usaban archivos como almacenamiento auxiliar!
En cuanto a los archivos LARG, corresponden al , que se utiliza en el «algoritmo de direccionamiento amplio» para procesar con el objetivo de soportar sistemas de archivos más grandes. Ya que Ken dijo que era mejor no utilizarlos, creo que le puedo dar el beneficio de la duda.
Aquí está la verdadera llamada al sistema pipe:
/*
 * The sys-pipe entry.
 * Allocate an inode on the root device.
 * Allocate 2 file structures.
 * Put it all together with flags.
 */
pipe()
{
    register *ip, *rf, *wf;
    int r;

    ip = ialloc(rootdev);
    if(ip == NULL)
        return;
    rf = falloc();
    if(rf == NULL) {
        iput(ip);
        return;
    }
    r = u.u_ar0[R0];
    wf = falloc();
    if(wf == NULL) {
        rf->f_count = 0;
        u.u_ofile[r] = NULL;
        iput(ip);
        return;
    }
    u.u_ar0[R1] = u.u_ar0[R0]; /* wf's fd */
    u.u_ar0[R0] = r;           /* rf's fd */
    wf->f_flag = FWRITE|FPIPE;
    wf->f_inode = ip;
    rf->f_flag = FREAD|FPIPE;
    rf->f_inode = ip;
    ip->i_count = 2;
    ip->i_flag = IACC|IUPD;
    ip->i_mode = IALLOC;
}
El comentario describe claramente lo que está ocurriendo aquí. Pero entender el código no es tan sencillo, en parte por la forma en que a través de «» y los registros R0 y R1 se pasan los parámetros de las llamadas al sistema y los valores devueltos.
Intentaremos usar para asignar en el disco , y con — asignar en memoria dos . Si todo va bien, estableceremos los flags para definir estos archivos como los dos extremos de un pipe, los indicaremos en el mismo inode (cuyo contador de referencias será igual a 2), y marcaremos el inode como modificado y en uso. Tenga en cuenta las invocaciones a en los caminos de error para reducir el contador de referencias en el nuevo inode.
pipe() debería a través de R0 y R1 devolver los números de los descriptores de archivo para lectura y escritura. falloc() devuelve un puntero a la estructura del archivo, pero también «devuelve» a través de u.u_ar0[R0] y el descriptor de archivo. Es decir, el código guarda en r el descriptor de archivo para lectura y asigna el descriptor para escritura directamente desde u.u_ar0[R0] después de la segunda llamada falloc().
El flag FPIPE, que establecimos al crear el pipe, controla el comportamiento de la función , que llama a subprogramas específicos de entrada/salida I/O:
/*
 * common code for read and write calls:
 * check permissions, set base, count, and offset,
 * and switch out to readi, writei, or pipe code.
 */
rdwr(mode)
{
    register *fp, m;

    m = mode;
    fp = getf(u.u_ar0[R0]);
        /* … */

    if(fp->f_flag&FPIPE) {
        if(m==FREAD)
            readp(fp); else
            writep(fp);
    }
        /* … */
}
Luego la función readp() en pipe.c lee datos del pipe. Pero es mejor rastrear la implementación comenzando con writep(). Reitero, el código se complicó debido a las peculiaridades de la convención de paso de argumentos, pero algunos detalles se pueden omitir.
writep(fp)
{
    registro *rp, *ip, c;

    rp = fp;
    ip = rp->f_inode;
    c = u.u_count;

bucle:
    /* Si todo está hecho, devolver. */

    plock(ip);
    if(c == 0) {
        prele(ip);
        u.u_count = 0;
        return;
    }

    /
     * Si no hay ambos lados de lectura y escritura del
     * pipe activos, devolver error y señal también.
     */

    if(ip->i_count i_size1 == PIPSIZ) {
        ip->i_mode =| IWRITE;
        prele(ip);
        sleep(ip+1, PPIPE);
        goto bucle;
    }

    /* Escribir lo que sea posible y volver a empezar. */

    u.u_offset[0] = 0;
    u.u_offset[1] = ip->i_size1;
    u.u_count = min(c, PIPSIZ-u.u_offset[1]);
    c =- u.u_count;
    writei(ip);
    prele(ip);
    if(ip->i_mode&IREAD) {
        ip->i_mode =& ~IREAD;
        wakeup(ip+2);
    }
    goto bucle;
}
Queremos escribir bytes en la entrada del pipe u.u_count. Primero debemos requerir bloquear el descriptor de índice (ver abajo plock/prele).
Luego verificamos el contador de enlaces del inode. Mientras ambos extremos de la tubería permanezcan abiertos, el contador debe ser igual a 2. Mantenemos un enlace (de rp->f_inode). Así que si el contador es menor que 2, eso debería significar que el proceso lector ha cerrado su extremo de la tubería. En otras palabras, estamos intentando escribir en una tubería cerrada, lo cual es un error. El código de error por primera vez EPIPE y la señal SIGPIPE aparecieron en la sexta edición de Unix.
Pero incluso si la tubería está abierta, puede estar llena. En este caso, liberamos el bloqueo y esperamos con la esperanza de que otro proceso lea de la tubería y libere suficiente espacio. Al despertarnos, volvemos al inicio, volvemos a aplicar el bloqueo y comenzamos un nuevo ciclo de escritura.
Si hay suficiente espacio libre en la tubería, escribimos en ella usando . El parámetro i_size1 del inode (puede ser igual a 0 en una tubería vacía) indica el final de los datos que ya contiene. Si hay suficiente espacio para escribir, podemos llenar la tubería desde i_size1 hasta PIPESIZ. Luego liberamos el bloqueo y tratamos de despertar cualquier proceso que esté esperando la oportunidad de leer de la tubería. Volvemos al inicio para ver si logramos escribir tantos bytes como necesitábamos. Si no lo logramos, comenzamos un nuevo ciclo de escritura.
Normalmente, el parámetro i_mode del inode se usa para almacenar permisos r, w y x. Pero en el caso de las tuberías, señalizamos que un proceso está esperando para escribir o leer usando los bits IREAD y IWRITE respectivamente. El proceso establece una bandera y llama a sleep(), y se espera que en el futuro algún otro proceso llame a wakeup().
La verdadera magia ocurre en sleep() y wakeup(). Se implementan en , fuente del famoso comentario “No se espera que lo entiendas” (You are not expected to understand this). Afortunadamente, no tenemos que entender el código, solo observamos algunos comentarios:
/*
 * Give up the processor till a wakeup occurs
 * on chan, at which time the process
 * enters the scheduling queue at priority pri.
 * The most important effect of pri is that when
 * pri<0 a signal cannot disturb the sleep;
 * if pri>=0 signals will be processed.
 * Callers of this routine must be prepared for
 * premature return, and check that the reason for
 * sleeping has gone away.
 */
sleep(chan, pri) /* … */

/*
 * Wake up all processes sleeping on chan.
 */
wakeup(chan) /* … */
El proceso que llama a sleep() para un canal específico puede ser luego despertado por otro proceso que llame a wakeup() para el mismo canal. writep() y readp() coordinan sus acciones mediante tales llamadas emparejadas. Tenga en cuenta que pipe.c siempre da prioridad a PPIPE al llamar a sleep(), por lo que todos sleep() pueden ser interrumpidos por una señal.
Ahora tenemos todo lo necesario para entender la función readp():
readp(fp)
int *fp;
{
    register *rp, *ip;

    rp = fp;
    ip = rp->f_inode;

loop:
    /* Bloqueo muy conservador. */

    plock(ip);

    /*
     * Si la cabeza (lectura) ha alcanzado
     * la cola (escritura), restablecemos ambos a 0.
     * /

    if(rp->f_offset[1] == ip->i_size1) {
        if(rp->f_offset[1] != 0) {
            rp->f_offset[1] = 0;
            ip->i_size1 = 0;
            if(ip->i_mode&IWRITE) {
                ip->i_mode =& ~IWRITE;
                wakeup(ip+1);
            }
        }

        /*
         * Si no hay ambos lector y
         * escritor activos, devolvemos sin
         * satisfacer la lectura.
         * /

        prele(ip);
        if(ip->i_count i_mode =| IREAD;
        sleep(ip+2, PPIPE);
        goto loop;
    }

    /* Leer y devolver */

    u.u_offset[0] = 0;
    u.u_offset[1] = rp->f_offset[1];
    readi(ip);
    rp->f_offset[1] = u.u_offset[1];
    prele(ip);
}
Puede que te resulte más fácil leer esta función de abajo hacia arriba. La rama «read and return» se usa generalmente cuando hay datos en el pipeline. En este caso, con leemos tantos datos como estén disponibles comenzando desde la actual f_offset de lectura, y luego actualizamos el valor del desplazamiento correspondiente.
En la siguiente lectura, el pipeline estará vacío si el desplazamiento de lectura ha alcanzado el valor i_size1 del inode. Restablecemos la posición a 0 y tratamos de despertar cualquier proceso que quiera escribir en el pipeline. Sabemos que cuando el pipeline esté lleno, writep() dormirá en ip+1. Y ahora, cuando el pipeline esté vacío, podemos despertarlo para que reanude su ciclo de escritura.
Si no hay nada que leer, puede establecer una bandera readp() y dormir en IREAD ip+2 . Sabemos que lo despertará, cuando escriba algún dato en el pipeline. writep()Los comentarios de
readi() y writei() u» podemos tratarlos como funciones normales de entrada/salida que toman archivo, posición, búfer en memoria y cuentan la cantidad de bytes a leer o escribir.En cuanto al bloqueo «conservador»,
/*
 * Read the file corresponding to
 * the inode pointed at by the argument.
 * The actual read arguments are found
 * in the variables:
 *    u_base        core address for destination
 *    u_offset    byte offset in file
 *    u_count        number of bytes to read
 *    u_segflg    read to kernel/user
 */
readi(aip)
struct inode *aip;
/* … */

/*
 * Write the file corresponding to
 * the inode pointed at by the argument.
 * The actual write arguments are found
 * in the variables:
 *    u_base        core address for source
 *    u_offset    byte offset in file
 *    u_count        number of bytes to write
 *    u_segflg    write to kernel/user
 */
writei(aip)
struct inode *aip;
/* … */
se bloquea el inode hasta que terminen su trabajo o obtengan un resultado (es decir, llaman a readp() y writep() wakeup plock()). prele() y funcionan simplemente: con otro conjunto de llamadas sleep nos permiten despertar cualquier proceso que necesite el bloqueo que acabamos de liberar: y plock() Al principio no podía entender por qué
/*
 * Lock a pipe.
 * If its already locked, set the WANT bit and sleep.
 */
plock(ip)
int *ip;
{
    register *rp;

    rp = ip;
    while(rp->i_flag&ILOCK) {
        rp->i_flag =| IWANT;
        sleep(rp, PPIPE);
    }
    rp->i_flag =| ILOCK;
}

/*
 * Unlock a pipe.
 * If WANT bit is on, wakeup.
 * This routine is also used to unlock inodes in general.
 */
prele(ip)
int *ip;
{
    register *rp;

    rp = ip;
    rp->i_flag =& ~ILOCK;
    if(rp->i_flag&IWANT) {
        rp->i_flag =& ~IWANT;
        wakeup(rp);
    }
}
no llama readp() prele(ip) antes de llamar a wakeup(ip+1). Lo primero que llama en su ciclo esplock(ip), writep() lo que conduce a un deadlock, si no ha liberado su bloqueo, por lo que el código de alguna manera debe funcionar correctamente. Si miras a, que puede llevar a un bloqueo mutuo si readp() aún no ha levantado su bloqueo, por lo que el código de alguna manera debe funcionar correctamente. Si miramos wakeup(), se hace evidente que solo marca el proceso en suspensión como listo para ejecutarse, para el futuro. sched() realmente lo inició. Así que readp() llama a wakeup(), desbloquea, establece IREAD y llama a sleep(ip+2)— todo esto antes de writep() reanudar el ciclo.
Con esto, se termina la descripción de los pipes en la sexta edición. Un código simple, pero con consecuencias de gran alcance.
(enero de 1979) fue un nuevo lanzamiento principal (tras cuatro años), que incluyó muchas nuevas aplicaciones y propiedades del núcleo. También se realizaron cambios significativos relacionados con el uso de conversiones de tipo, uniones y punteros tipados a estructuras. Sin embargo, prácticamente no cambió. Podemos omitir esta edición.
Xv6, un núcleo similar a Unix sencillo
La creación del núcleo fue influenciada por la sexta edición de Unix, pero está escrita en C moderno para ejecutarse en procesadores x86. El código es fácil de leer, es comprensible. Además, a diferencia del código fuente de Unix de TUHS, puedes compilarlo, modificarlo y ejecutarlo en algo más que el PDP 11/70. Por ello, este núcleo es ampliamente utilizado en universidades como material de enseñanza sobre sistemas operativos. Los códigos .
El código contiene una implementación clara y bien pensada, , respaldada por un buffer en memoria en lugar de un inode en disco. Aquí solo presento la definición de "pipe estructural" y la función pipealloc():
#define PIPESIZE 512

struct pipe {
  struct spinlock lock;
  char data[PIPESIZE];
  uint nread;     // number of bytes read
  uint nwrite;    // number of bytes written
  int readopen;   // read fd is still open
  int writeopen;  // write fd is still open
};

int
pipealloc(struct file **f0, struct file **f1)
{
  struct pipe *p;

  p = 0;
  *f0 = *f1 = 0;
  if((*f0 = filealloc()) == 0 || (*f1 = filealloc()) == 0)
    goto bad;
  if((p = (struct pipe*)kalloc()) == 0)
    goto bad;
  p->readopen = 1;
  p->writeopen = 1;
  p->nwrite = 0;
  p->nread = 0;
  initlock(&p->lock, "pipe");
  (*f0)->type = FD_PIPE;
  (*f0)->readable = 1;
  (*f0)->writable = 0;
  (*f0)->pipe = p;
  (*f1)->type = FD_PIPE;
  (*f1)->readable = 0;
  (*f1)->writable = 1;
  (*f1)->pipe = p;
  return 0;

 bad:
  if(p)
    kfree((char*)p);
  if(*f0)
    fileclose(*f0);
  if(*f1)
    fileclose(*f1);
  return -1;
}
pipealloc() determina el estado de toda la otra implementación, que incluye las funciones piperead(), pipewrite() y pipeclose(). La llamada al sistema real sys_pipe es un envoltorio implementado en Recomiendo leer todo su código. La complejidad está al nivel del código fuente de la sexta edición, pero es mucho más fácil y agradable de leer.
Linux 0.01
Se puede encontrar el código fuente de Linux 0.01. Será esclarecedor estudiar la implementación de los pipes en su fs/pipe.c. Aquí se utiliza un inode para representar el pipe, pero el propio pipe está escrito en C moderno. Si te has adentrado en el código de la sexta edición, aquí no tendrás dificultades. Así se ve la función write_pipe():
int write_pipe(struct m_inode * inode, char * buf, int count)
{
    char * b=buf;

    wake_up(&inode->i_wait);
    if (inode->i_count != 2) { /* no readers */
        current->signal |= (1<0) {
        while (PIPE_FULL(*inode)) {
            wake_up(&inode->i_wait);
            if (inode->i_count != 2) {
                current->signal |= (1<i_wait);
        }
        ((char *)inode->i_size)[PIPE_HEAD(*inode)] =
            get_fs_byte(b++);
        INC_PIPE( PIPE_HEAD(*inode) );
        wake_up(&inode->i_wait);
    }
    wake_up(&inode->i_wait);
    return b-buf;
}
Incluso sin mirar las definiciones de las estructuras, se puede entender cómo se utiliza el contador de referencias de inode para verificar si la operación de escritura lleva a cabo. SIGPIPE. Además del trabajo por bytes, esta función se puede correlacionar fácilmente con las ideas descritas anteriormente. Incluso la lógica sleep_on/wake_up no parece tan ajena.
Los núcleos modernos de Linux, FreeBSD, NetBSD, OpenBSD
He hecho una revisión rápida de algunos núcleos modernos. Ninguno de ellos tiene ya una implementación que use discos (no es de sorprender). En Linux hay su propia implementación. Y aunque los tres núcleos modernos de BSD contienen implementaciones basadas en el código escrito por John Dyson, con el paso de los años se han diferenciado demasiado entre sí.
Para leer fs/pipe.c (en Linux) o sys/kern/sys_pipe.c (en *BSD), se requiere un verdadero compromiso. Hoy en día, el rendimiento y el soporte de funciones como operaciones de entrada/salida vectoriales y asíncronas son cruciales. Los detalles sobre la asignación de memoria, bloqueos y configuración del núcleo varían mucho. Esto no es lo que los institutos necesitan para un curso introductorio sobre sistemas operativos.
De todos modos, me resultó interesante excavar algunos patrones antiguos (como la generación SIGPIPE y el retorno EPIPE al escribir en un pipe cerrado) en todos estos núcleos modernos tan diferentes. Probablemente nunca veré en persona una computadora PDP-11, pero hay mucho que aprender del código que fue escrito varios años antes de mi nacimiento.
El artículo escrito por Divi Kapoor en 2011 “” es una revisión de cómo funcionan (todavía) los pipes en Linux. Y un ilustra el modelo de interacción de pipes, cuyas capacidades superan a las de los archivos temporales; además muestra cuán lejos han llegado los pipes desde la “muy conservadora bloqueo” en el núcleo de Unix de sexta edición.
Fuente: habr.com
