

¡Hola, Habr! Soy Artem Karamychev, líder del equipo de administración de sistemas. . En el último año, hemos lanzado muchos nuevos productos. Queríamos que los servicios de API fueran fácilmente escalables, tolerantes a fallos y listos para un rápido aumento de la carga del usuario. Nuestra plataforma está implementada en OpenStack, y quiero contarles qué problemas de tolerancia a fallos de los componentes tuvimos que resolver para obtener un sistema tolerante a fallos. Creo que esto será interesante para aquellos que también están desarrollando productos en OpenStack.
La tolerancia a fallos general de la plataforma se compone de la resiliencia de sus componentes. Así que pasaremos gradualmente por todos los niveles donde identificamos riesgos y los cerramos.
La versión en video de esta historia, que se basa en una presentación en la conferencia Uptime day 4, organizada por , se puede ver .
Tolerancia a fallos de la arquitectura física
La parte pública de la nube MCS ahora se basa en dos centros de datos de nivel Tier III, entre ellos hay fibra oscura propia, reservada a nivel físico por diferentes rutas, con una capacidad de 200 Gbps. El nivel Tier III proporciona el nivel necesario de tolerancia a fallos de la infraestructura física.
La fibra oscura está reservada tanto a nivel físico como lógico. El proceso de reserva de canales fue iterativo, surgieron problemas y estamos mejorando constantemente la conexión entre los centros de datos.
Por ejemplo, no hace mucho, durante trabajos en una alcantarilla cerca de uno de los centros de datos, un excavadora perforó una tubería, dentro de esta tubería se encontraron tanto el cable óptico principal como el de reserva. Nuestro canal de comunicación tolerante a fallos con el centro de datos resultó ser vulnerable en un punto, en la alcantarilla. Por lo tanto, perdimos parte de la infraestructura. Sacamos conclusiones, tomamos una serie de acciones, incluida la instalación de una óptica adicional a través de la alcantarilla vecina.
En los centros de datos, hay puntos de presencia de proveedores de telecomunicaciones a los que transmitimos nuestros prefijos a través de BGP. Se selecciona la mejor métrica para cada dirección de red, lo que permite ofrecer a diferentes clientes la mejor calidad de conexión. Si la conexión a través de un proveedor se interrumpe, reconfiguramos nuestra ruta a través de los proveedores disponibles.
En caso de una falla del proveedor, cambiamos automáticamente al siguiente. Si uno de los centros de datos falla, tenemos una copia espejo de nuestros servicios en el segundo centro de datos que asume toda la carga.
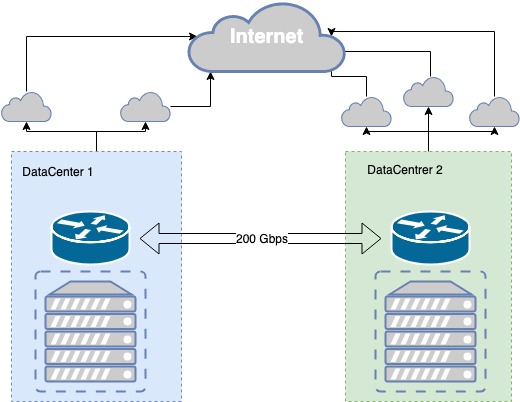
Resiliencia de la infraestructura física
Lo que utilizamos para la resiliencia a nivel de aplicaciones
Nuestro servicio se basa en varios componentes de código abierto.
ExaBGP — un servicio que implementa una serie de funciones utilizando el protocolo de enrutamiento dinámico basado en BGP. Lo utilizamos activamente para anunciar nuestras direcciones IP públicas, a través de las cuales los usuarios acceden a la API.
HAProxy — un balanceador de carga de alta demanda que permite configurar reglas de balanceo de tráfico muy flexibles en diferentes niveles del modelo OSI. Lo utilizamos para balancear ante todos los servicios: bases de datos, intermediarios de mensajes, servicios API, servicios web, nuestros proyectos internos: todo está detrás de HAProxy.
API application — una aplicación web escrita en python, con la que el usuario gestiona su infraestructura, su servicio.
Worker application (en adelante simplemente worker) — en los servicios de OpenStack, es un demonio de infraestructura que permite transmitir comandos API a la infraestructura. Por ejemplo, la creación de un disco se lleva a cabo precisamente en el worker, mientras que la solicitud de creación se realiza en la API application.
Arquitectura estándar de OpenStack Application
La mayoría de los servicios desarrollados para OpenStack intentan seguir una única paradoja. Un servicio generalmente se compone de 2 partes: API y workers (ejecutores de backend). Por lo general, API es una aplicación WSGI en Python, que se ejecuta ya sea como un proceso independiente (daemon) o utilizando un servidor web ya configurado como Nginx o Apache. El API procesa la solicitud del usuario y pasa instrucciones adicionales para que las ejecute la aplicación worker. La transmisión ocurre a través de un corredor de mensajes, que generalmente es RabbitMQ, siendo mal soportados los demás. Cuando los mensajes llegan al corredor, los workers los procesan y, de ser necesario, devuelven una respuesta.
Esta paradoja implica puntos de falla comunes aislados: RabbitMQ y la base de datos. Sin embargo, RabbitMQ está aislado dentro de un solo servicio y, en teoría, puede ser individual para cada servicio. Por lo tanto, en MCS, separamos al máximo estos servicios, creando una base de datos separada y un RabbitMQ separado para cada proyecto distinto. Este enfoque es beneficioso ya que, en caso de una falla en algunos de los puntos vulnerables, no se rompe todo el servicio, sino solo su parte.
La cantidad de aplicaciones worker no está limitada, por lo que el API puede escalar horizontalmente fácilmente detrás de balanceadores para aumentar el rendimiento y la tolerancia a fallos.
En algunos servicios es necesaria la coordinación dentro del servicio, cuando se realizan operaciones secuenciales complejas entre el API y los workers. En este caso, se utiliza un centro de coordinación único, un sistema de clústeres como Redis, Memcache, etcd, que permite a un worker indicarle a otro que esta tarea está asignada a él ("tú, por favor, no la tomes"). Usamos etcd. Por lo general, los workers se comunican activamente con la base de datos, escribiendo y leyendo información de allí. Como base de datos, utilizamos mariadb, que está en nuestro clúster multimaster.
Este clásico servicio único está organizado de una manera comúnmente aceptada para OpenStack. Se puede considerar como un sistema cerrado, para el cual las formas de escalado y tolerancia a fallos son bastante evidentes. Por ejemplo, para la tolerancia a fallos, basta con colocar un balanceador frente al API. El escalado de los workers se logra aumentando su número.
El punto débil de todo el esquema son RabbitMQ y MariaDB. Su arquitectura merece un artículo aparte. En este artículo, quiero centrarme en la tolerancia a fallos de la API.
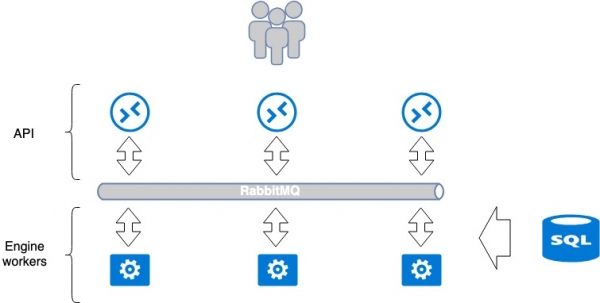
Arquitectura de Openstack Application. Balanceo y tolerancia a fallos de la plataforma en la nube
Hacemos que el balanceador HAProxy sea tolerante a fallos con la ayuda de ExaBGP
Para que nuestras API sean escalables, rápidas y tolerantes a fallos, les hemos colocado un balanceador. Elegimos HAProxy. En mi opinión, cuenta con todas las características necesarias para nuestra tarea: balanceo en varios niveles de OSI, interfaz de gestión, flexibilidad y escalabilidad, una gran cantidad de métodos de balanceo, y soporte para tablas de sesiones.
El primer problema que había que resolver era la tolerancia a fallos del propio balanceador. Simplemente instalar un balanceador también crea un punto de falla: si el balanceador falla, el servicio cae. Para evitar que esto suceda, utilizamos HAProxy junto con ExaBGP.
ExaBGP permite implementar un mecanismo de verificación del estado del servicio. Usamos este mecanismo para verificar la operatividad de HAProxy y, en caso de problemas, desactivar el servicio HAProxy desde BGP.
Esquema ExaBGP+HAProxy
- Instalamos el software necesario, ExaBGP y HAProxy, en tres servidores.
- Creamos una interfaz loopback en cada uno de los servidores.
- En los tres servidores configuramos la misma dirección IP pública en esta interfaz.
- La dirección IP pública se anuncia en Internet a través de ExaBGP.
La tolerancia a fallos se logra anunciando la misma dirección IP desde los tres servidores. Desde el punto de vista de la red, la misma dirección está disponible desde tres diferentes next hops. El enrutador ve tres rutas iguales, elige la más prioritaria según su propia métrica (que generalmente es la misma opción), y el tráfico solo va a uno de los servidores.
En caso de problemas con HAProxy o caída de un servidor, ExaBGP deja de anunciar la ruta, y el tráfico se redirige suavemente a otro servidor.
De esta manera hemos logrado la tolerancia a fallos del balanceador.
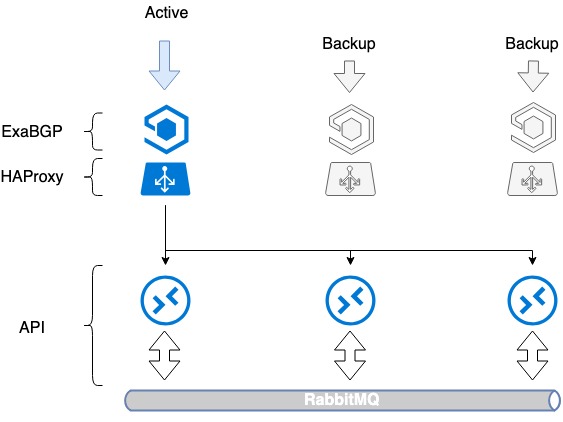
Tolerancia a fallos de los balanceadores HAProxy
El esquema resultó ser no perfecto: aprendimos a hacer redundante HAProxy, pero no aprendimos a distribuir la carga dentro de los servicios. Por lo tanto, ampliamos un poco este esquema: pasamos a balancear entre varias direcciones IP públicas.
Balanceo basado en DNS más BGP
Aún queda sin resolver la cuestión de la balanceo de carga ante nuestros HAProxy. Sin embargo, es posible solucionarlo de manera bastante sencilla, como lo hicimos nosotros.
Para balancear tres servidores se necesitarán 3 direcciones IP públicas y el viejo y confiable DNS. Cada una de estas direcciones se define en la interfaz de loopback de cada HAProxy y se anuncia en internet.
En OpenStack, se utiliza un catálogo de servicios para gestionar los recursos, donde se establece el endpoint API de cada servicio. En este catálogo, especificamos el nombre de dominio — public.infra.mail.ru, que se resuelve a través de DNS con tres direcciones IP diferentes. Como resultado, obtenemos una distribución de carga entre las tres direcciones mediante DNS.
Pero dado que al anunciar las direcciones IP públicas no gestionamos las prioridades de selección del servidor, esto aún no es un balanceo. Por lo general, solo se seleccionará un servidor según la antigüedad de la dirección IP, mientras que los otros dos quedarán inactivos, ya que no se especifican métricas en BGP.
Comenzamos a anunciar rutas a través de ExaBGP con diferentes métricas. Cada balanceador anuncia las tres direcciones IP públicas, pero una de ellas, la principal para ese balanceador, se anuncia con la métrica más baja. Así que mientras los tres balanceadores estén en funcionamiento, las solicitudes al primer IP van al primer balanceador, las solicitudes al segundo van al segundo, y al tercero, al tercero.
¿Qué sucede en el momento en que uno de los balanceadores falla? Al fallar cualquiera de los balanceadores, su dirección principal aún se anuncia desde los otros dos y el tráfico se redistribuye entre ellos. De este modo, entregamos al usuario a través de DNS varias direcciones IP. Mediante balanceo por DNS y diferentes métricas, logramos una distribución uniforme de la carga entre los tres balanceadores, sin perder la tolerancia a fallos.
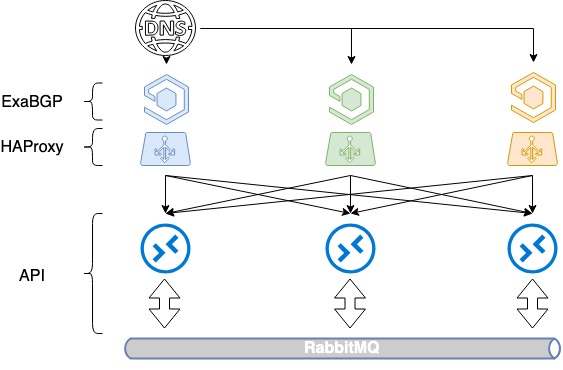
Balanceo HAProxy basado en DNS + BGP
Interacción entre ExaBGP y HAProxy
Así que hemos implementado la tolerancia a fallos en caso de que un servidor se caiga, basada en la interrupción del anuncio de rutas. Pero HAProxy también puede desconectarse por otras razones además de la caída del servidor: errores de administración, fallos dentro del servicio. Queremos eliminar el balanceador dañado de la carga en estos casos, lo cual requiere otro mecanismo.
Por lo tanto, al ampliar el esquema anterior, implementamos un heartbeat entre ExaBGP y HAProxy. Esta es una implementación de software para la interacción entre ExaBGP y HAProxy, donde ExaBGP utiliza scripts personalizados para verificar el estado de las aplicaciones.
Para ello, es necesario configurar un verificador de salud en el archivo de configuración de ExaBGP, que pueda comprobar el estado de HAProxy. En nuestro caso, configuramos un backend de salud en HAProxy, y desde ExaBGP comprobamos con una simple solicitud GET. Si el anuncio deja de realizarse, es probable que HAProxy no esté funcionando, y no se debe anunciar.
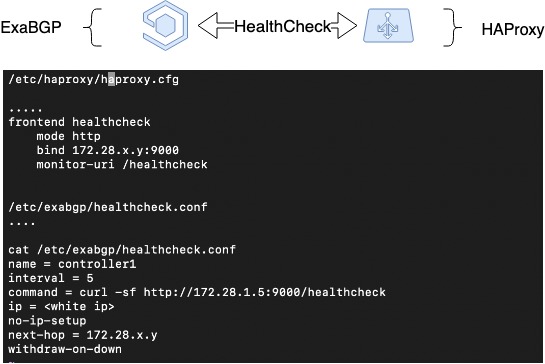
Verificación de Salud de HAProxy
Compañeros de HAProxy: sincronización de sesiones
Lo siguiente que había que hacer era sincronizar las sesiones. Al trabajar a través de equilibradores de carga distribuidos, es difícil mantener la información sobre las sesiones de los clientes. Pero HAProxy es uno de los pocos equilibradores que puede hacerlo gracias a la funcionalidad de Peers, que permite la transferencia de tablas de sesiones entre diferentes procesos de HAProxy.
Existen diferentes métodos de balanceo: simples, como , y avanzados, donde se recuerda la sesión del cliente, y siempre aterriza en el mismo servidor que antes. Queríamos implementar la segunda opción.
En HAProxy, para la conservación de las sesiones del cliente, se utiliza el mecanismo de stick-tables. Estas guardan la dirección IP original del cliente, la dirección del target elegido (backend) y cierta información operativa. Normalmente, las stick-tables se utilizan para conservar el par source-IP + destination-IP, lo cual es especialmente útil para aplicaciones que no pueden transmitir el contexto de la sesión del usuario al cambiar a otro equilibrador, por ejemplo, en el modo de balanceo RoundRobin.
Si se le enseña a la stick-table a moverse entre diferentes procesos de HAProxy (entre los cuales se realiza el balanceo), nuestros equilibradores podrán trabajar con un solo conjunto de stick-tables. Esto permitirá un cambio de red sin interrupciones para el cliente en caso de que uno de los equilibradores falle, y el manejo de las sesiones de los clientes continuará en los mismos backends que se eligieron previamente.
Para un funcionamiento correcto, debe resolverse el problema de la dirección IP source del equilibrador desde el que se estableció la sesión. En nuestro caso, se trata de una dirección dinámica en la interfaz de loopback.
El funcionamiento correcto de los pares solo se logra en ciertas condiciones. Es decir, los tiempos de espera de TCP deben ser lo suficientemente largos o el cambio debe ser lo suficientemente rápido para que la sesión TCP no se interrumpa. Sin embargo, esto permite un cambio sin problemas.
En nuestra IaaS, tenemos un servicio construido con esta misma tecnología. Es , que se llama Octavia. Se basa en dos procesos de HAProxy y desde el principio incluye soporte para pares. En este servicio han demostrado ser muy efectivos.
En la imagen se muestra esquemáticamente el movimiento de las tablas de pares entre tres instancias de HAProxy, se propone una configuración de cómo se puede ajustar esto:
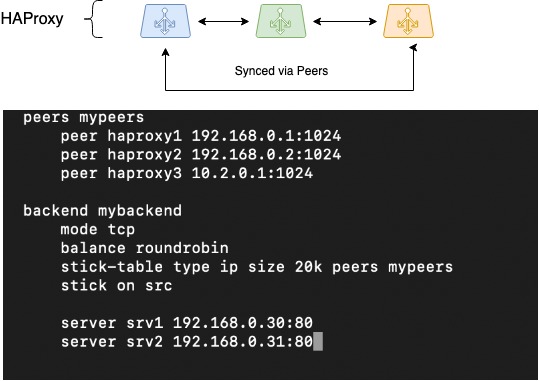
HAProxy Peers (sincronización de sesiones)
Si vas a implementar un esquema así, debes probar su funcionamiento cuidadosamente. No es seguro que funcione de la misma manera en el 100% de los casos. Pero, al menos, no perderás las tablas de stick cuando necesites recordar la IP de origen del cliente.
Límite en la cantidad de solicitudes simultáneas desde el mismo cliente
Cualquier servicio accesible públicamente, incluidos nuestros API, puede ser objeto de avalanchas de solicitudes. Las razones pueden ser muy variadas, desde errores de los usuarios hasta ataques deliberados. Nos someten periódicamente a DDoS por direcciones IP. Los clientes a menudo cometen errores en sus scripts, provocando mini-DDoS.
De una forma u otra, es necesario prever una protección adicional. Una solución obvia es limitar la cantidad de solicitudes a la API y no desperdiciar tiempo de CPU en el procesamiento de solicitudes maliciosas.
Para implementar tales limitaciones, usamos límites de tasa, organizados sobre la base de HAProxy, con las mismas tablas de stick. Los límites se configuran de manera bastante sencilla y permiten restringir al usuario en la cantidad de solicitudes a la API. El algoritmo recuerda la IP de origen desde la cual se realizan las solicitudes y limita la cantidad de solicitudes simultáneas de un mismo usuario. Por supuesto, hemos calculado el perfil promedio de carga en la API de cada servicio y hemos establecido un límite de aproximadamente 10 veces mayor que este valor. Seguimos observando de cerca la situación y manteniendo el pulso.
¿Cómo se ve esto en la práctica? Tenemos clientes que utilizan constantemente nuestras API para el autoescalado. Crean alrededor de doscientos a trescientos máquinas virtuales por la mañana y las eliminan por la tarde. Para OpenStack, crear una máquina virtual, además de los servicios PaaS, requiere al menos 1000 solicitudes API, ya que la interacción entre los servicios también se realiza a través de la API.
Estos cambios en las tareas generan una carga considerable. Evaluamos esta carga, recopilamos los picos diarios, los multiplicamos por diez y eso se convirtió en nuestro límite de tasa. Estamos siempre atentos. A menudo vemos bots y escáneres que intentan verificar si tenemos algún script CGA que puedan ejecutar, y los cortamos activamente.
Cómo actualizar la base de código sin que los usuarios se den cuenta
Implementamos la tolerancia a fallos también a nivel de los procesos de despliegue de código. En las implementaciones pueden ocurrir fallos, pero su impacto en la disponibilidad de los servicios se puede minimizar.
Actualizamos constantemente nuestros servicios y debemos garantizar el proceso de actualización de la base de código sin afectar a los usuarios. Esta tarea se resolvió utilizando las capacidades de gestión de HAProxy y la implementación de Graceful Shutdown en nuestros servicios.
Para resolver esta tarea, era necesario gestionar el equilibrador de carga y realizar un apagado ‘correcto’ de los servicios:
- En el caso de HAProxy, la gestión se lleva a cabo a través del archivo stats, que esencialmente es un socket y se define en la configuración de HAProxy. Se pueden enviarle comandos a través de stdio. Pero nuestra herramienta principal de control de configuraciones es ansible, por lo que tiene un módulo incorporado para gestionar HAProxy, el cual utilizamos activamente.
- La mayoría de nuestros servicios API y Engine soportan tecnologías de graceful shutdown: al apagarse esperan a que se complete la tarea actual, ya sea una solicitud http o alguna tarea de servicio. Lo mismo sucede con el worker. Sabe todas las tareas que está llevando a cabo y se cierra cuando todo se ha completado con éxito.
Gracias a estos dos aspectos, el algoritmo seguro de nuestro despliegue se ve de la siguiente manera.
- El desarrollador compila un nuevo paquete de código (en nuestro caso es RPM), lo prueba en un entorno de desarrollo, lo prueba en stage y lo deja en el repositorio de stage.
- El desarrollador establece la tarea para el despliegue con una descripción detallada de los «artefactos»: versión del nuevo paquete, descripción de nuevas funcionalidades y otros detalles sobre el despliegue si es necesario.
- El administrador del sistema comienza la actualización. Inicia el playbook de Ansible, que a su vez hace lo siguiente:
- Toma el paquete del repositorio de stage, y actualiza la versión del paquete en el repositorio de producción.
- Compila una lista de los backends del servicio que se está actualizando.
- Desactiva el primer servicio que se está actualizando en HAProxy y espera a que finalicen sus procesos. Gracias al apagado gracioso, nos aseguramos de que todas las solicitudes actuales de los clientes se completen con éxito.
- Después de que el API, los workers y HAProxy se detienen completamente, se actualiza el código.
- Ansible inicia los servicios.
- Para cada servicio, activa ciertos «disparadores», que realizan pruebas unitarias según una serie de pruebas clave predefinidas. Se realiza una verificación básica del nuevo código.
- Si no se encontraron errores en el paso anterior, se activa el backend.
- Pasamos al siguiente backend.
- Después de actualizar todos los backends, se ejecutan pruebas funcionales. Si no son suficientes, el desarrollador revisa cualquier nueva funcionalidad que haya implementado.
En este punto, el despliegue se ha completado.
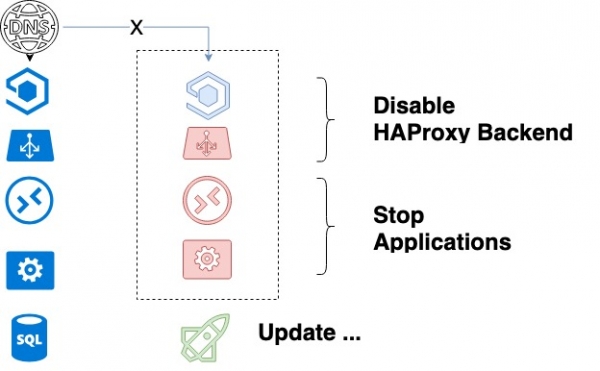
Ciclo de actualización del servicio
Este esquema no funcionaría si no tuviéramos una regla. Mantenemos en producción simultáneamente las versiones antigua y nueva. Desde la etapa de desarrollo del software, se establece que incluso si hay cambios en la base de datos del servicio, no romperán el código anterior. Como resultado, se produce una actualización gradual de la base de código.
Conclusión
Compartiendo mis propios pensamientos sobre la arquitectura WEB tolerante a fallos, quiero destacar una vez más sus puntos clave:
- tolerancia a fallos física;
- tolerancia a fallos de red (balanceadores, BGP);
- tolerancia a fallos del software utilizado y desarrollado.
¡Les deseo a todos un uptime estable!
Fuente: habr.com
