

Nota de traducción.: Este artículo es el resumen de un miniestudio realizado por ingenieros de IBM Cloud en busca de una solución para un problema real relacionado con la operación de la base de datos etcd. Para nosotros, se planteó una tarea similar, sin embargo, el proceso de pensamiento y las acciones de los autores pueden ser interesantes en un contexto más amplio.
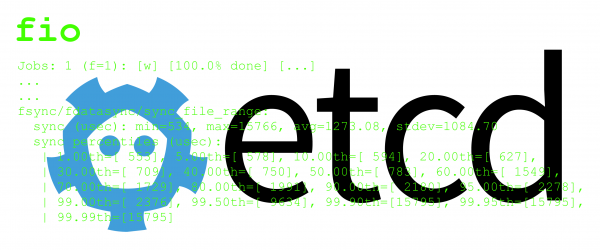
Resumen breve de todo el artículo: fio y etcd
El rendimiento del clúster etcd depende en gran medida de la velocidad del almacenamiento subyacente. Para controlar el rendimiento, etcd exporta diversas métricas de Prometheus. Una de ellas es wal_fsync_duration_seconds. En la documentación de etcd , se menciona que se puede considerar el almacenamiento como suficientemente rápido si el percentil 99 de esta métrica no supera los 10 ms…
Si está considerando la posibilidad de organizar un clúster etcd en máquinas con sistema operativo Linux y quiere verificar si los dispositivos de almacenamiento son suficientemente rápidos (por ejemplo, SSD), le recomendamos utilizar un popular probador de I/O llamado . Solo necesita ejecutar el siguiente comando (el directorio test-data debe estar ubicado en la partición montada del dispositivo en prueba):
fio --rw=write --ioengine=sync --fdatasync=1 --directory=test-data --size=22m --bs=2300 --name=mytestSolo queda observar la salida y verificar si el percentil 99 está por debajo de los 10 ms. Si es así, significa que su dispositivo está funcionando lo suficientemente rápido. Aquí hay un ejemplo de la salida:
fsync/fdatasync/sync_file_range:
  sync (usec): min=534, max=15766, avg=1273.08, stdev=1084.70
  percentiles de sincronización (usec):
   | 1.00th=[ 553], 5.00th=[ 578], 10.00th=[ 594], 20.00th=[ 627],
   | 30.00th=[ 709], 40.00th=[ 750], 50.00th=[ 783], 60.00th=[ 1549],
   | 70.00th=[ 1729], 80.00th=[ 1991], 90.00th=[ 2180], 95.00th=[ 2278],
   | 99.00th=[ 2376], 99.50th=[ 9634], 99.90th=[15795], 99.95th=[15795],
   | 99.99th=[15795]
Algunas observaciones:
- En el ejemplo anterior, ajustamos los parámetros
--sizey--bspara un caso específico. Para obtener un resultado significativo defio, especifique valores adecuados para su escenario de uso. Se tratará de cómo elegirlos a continuación. - Durante la prueba, solo
fiocarga el subsistema de disco. En la vida real, es muy probable que otros procesos (además de los relacionados conwal_fsync_duration_seconds) también estén escribiendo en el disco. Esta carga adicional puede llevar a un aumento enwal_fsync_duration_seconds. En otras palabras, si el percentil 99 obtenido al finalizar la prueba confio, está apenas por debajo de los 10 ms, hay una alta probabilidad de que el rendimiento del almacenamiento no sea suficiente. - Para la prueba, necesitará la versión
fiono inferior a 3.5, ya que las versiones más antiguas no agregan resultadosfdatasyncen forma de percentiles. - La salida anterior es solo un pequeño fragmento de la salida total.
fio.
Detalles sobre fio y etcd.
Algunas palabras sobre los WAL de etcd.
Por lo general, las bases de datos utilizan (write-ahead logging, WAL). Esto también se aplica a etcd. La discusión sobre el WAL está más allá del alcance de este artículo, pero para nuestros propósitos es necesario saber lo siguiente: cada miembro del clúster de etcd almacena el WAL en un almacenamiento persistente. etcd registra algunas operaciones con el almacén de clave-valor (por ejemplo, actualizaciones) en el WAL antes de ejecutarlas. Si un nodo falla y se reinicia entre snapshots, etcd podrá recuperar las transacciones realizadas desde el último snapshot, basándose en el contenido del WAL.
Así, cada vez que un cliente agrega una clave al almacén KV o actualiza el valor de una clave existente, etcd añade una descripción de la operación al WAL, que es un archivo normal en el almacenamiento persistente. Antes de continuar, etcd DEBE estar 100% segura de que la entrada en el WAL se ha guardado realmente. Para lograr esto en Linux, no es suficiente con utilizar una llamada al sistema , ya que la propia operación de escritura en el medio físico puede estar retrasada. Por ejemplo, Linux puede mantener temporalmente la escritura del WAL en caché en la memoria del núcleo (por ejemplo, en la caché de páginas). Para garantizar que los datos se escriben en el medio, es necesario implementar la llamada al sistema fdatasync — así es como actúa etcd (como se puede ver en la siguiente salida ; aquí 8 — descriptor de archivo WAL):
21:23:09.894875 lseek(8, 0, SEEK_CUR)   = 12808
21:23:09.894911 write(8, ".      20210220361223255266632$10 20103026"34"rn3fo"..., 2296) = 2296
21:23:09.895041 fdatasync(8)            = 0
Desafortunadamente, escribir en el almacenamiento persistente lleva tiempo. La ejecución prolongada de la llamada fdatasync puede afectar el rendimiento de etcd. En la documentación sobre el almacenamiento , se menciona que para un rendimiento adecuado, el percentil 99 de la duración de todas las llamadas fdatasync al escribir en el archivo WAL debe ser menor de 10 ms. Hay otras métricas relacionadas con el almacenamiento, pero este artículo se centrará precisamente en esta.
Evaluando el almacenamiento con fio.
Para evaluar si un determinado almacenamiento es adecuado para usar con etcd, se puede utilizar la herramienta. — un probador I/O popular. Tenga en cuenta que la entrada/salida de disco puede ocurrir de diferentes maneras: síncrona/asíncrona, múltiples clases de llamadas del sistema, etc. La otra cara de la moneda es que fio es extremadamente difícil de usar. La utilidad tiene muchos parámetros, y diferentes combinaciones de sus valores conducen a resultados muy diferentes. Para obtener una evaluación razonable en el caso de etcd, debe asegurarse de que la carga de escritura generada por fio se asemeje lo más posible a la carga de etcd al escribir en los archivos WAL:
- Esto significa que la carga generada
fiodebe ser, al menos, una serie de escrituras secuenciales en un archivo, donde cada operación de escritura consiste en una llamada del sistema , seguida defdatasync. - Para habilitar la escritura secuencial, debe especificar el flag
--rw=write. - Para
fioescribió usando llamadaswrite(y no otras llamadas del sistema — por ejemplo, ), use el flag--ioengine=sync. - Finalmente, el flag
--fdatasync=1garantiza que detrás de cadawritese debenfdatasync. - Los otros dos parámetros en nuestro ejemplo:
--sizey--bs— pueden variar según el caso de uso específico. En la siguiente sección se describirá su configuración.
Por qué elegimos fio y de dónde aprendimos a configurarlo
Esta nota surgió de un caso real con el que nos encontramos. Teníamos un clúster en Kubernetes v1.13 con monitoreo en Prometheus. Los discos de estado sólido sirvieron como almacenamiento para etcd v3.2.24. Las métricas de etcd mostraban retrasos demasiado altos fdatasync, incluso cuando el clúster estaba inactivo. Nos parecían métricas bastante dudosas, y no estábamos seguros de qué es lo que realmente representaban. Además, el clúster consistía en máquinas virtuales, por lo que no podíamos decir si el retraso estaba relacionado con la virtualización o si todo se debía a los SSD.
Además, consideramos varios cambios en la configuración de hardware y software, por lo que se requería una forma de evaluarlos. Por supuesto, podríamos haber ejecutado etcd en cada configuración y observar las métricas correspondientes de Prometheus, pero eso requeriría un esfuerzo significativo. Necesitábamos una forma sencilla que nos permita evaluar una configuración específica. Queríamos comprobar nuestra comprensión de las métricas de Prometheus provenientes de etcd.
Para esto, era necesario resolver dos problemas:
- En primer lugar, ¿cómo se ve la carga de I/O generada por etcd al escribir en archivos WAL? ¿Qué llamadas al sistema se utilizan? ¿Cuál es el tamaño de los bloques de escritura?
- En segundo lugar, supongamos que tenemos respuestas a las preguntas anteriores. ¿Cómo reproducir la carga correspondiente con
fio? Ведьfio— una utilidad extremadamente flexible con una abundancia de parámetros (esto se puede verificar fácilmente, por ejemplo, — nota del traductor).
Hemos resuelto ambos problemas utilizando el mismo enfoque, basado en comandos y :
- Con
lsofse pueden ver todos los descriptores de archivo utilizados por el proceso, así como los archivos a los que se refieren. - Con
stracese puede analizar un proceso en ejecución o iniciar un proceso y observar su comportamiento. El comando muestra todas las llamadas al sistema realizadas por este proceso y, si es necesario, por sus descendientes. Esto es importante para los procesos que hacen fork, y etcd es uno de esos procesos.
Lo primero que hicimos fue utilizar strace para estudiar el servidor etcd en un clúster de Kubernetes mientras estaba inactivo.
Se descubrió que los bloques de escritura en WAL están muy agrupados, con la mayoría de los tamaños en el rango de 2200 a 2400 bytes. Es por eso que en el comando al inicio de este artículo se utiliza la bandera --bs=2300 (bs — el tamaño en bytes de cada bloque de escritura en fio).
Tenga en cuenta que el tamaño de los bloques de escritura de etcd puede variar según la versión, el despliegue, los valores de los parámetros, etc. — esto afecta a la duración fdatasync. Si tiene un caso de uso similar, analice con strace sus procesos de etcd para obtener valores actuales.
Luego, para tener una visión clara y completa de cómo etcd interactúa con el sistema de archivos, lo ejecutamos desde strace con las banderas -ffttT. Esto permitió abarcar los procesos descendientes y registrar la salida de cada uno en un archivo separado. Además, se obtuvieron detalles sobre el momento de inicio y la duración de cada llamada al sistema.
También utilizamos el comando lsof, para confirmar nuestra comprensión de la salida strace en cuanto a qué descriptor de archivo se utilizó para qué propósito. La salida resultante fue strace, similar a la proporcionada anteriormente. Las manipulaciones estadísticas con los tiempos de sincronización confirmaron que la métrica wal_fsync_duration_seconds de etcd corresponde a las llamadas fdatasync con descriptores de archivos WAL.
Para generar con fio Se estudió la documentación de la utilidad y se seleccionaron los parámetros adecuados para nuestra tarea, analizando una carga de trabajo similar a la carga de etcd. Nos aseguramos de que se utilizaran las llamadas al sistema necesarias y confirmamos su duración al ejecutarlas. fio de strace (como se hizo en el caso de etcd).
Se prestó especial atención a determinar el valor del parámetro --size. Representa la carga total de I/O generada por la utilidad fio. En nuestro caso, es el número total de bytes escritos en el dispositivo. Es directamente proporcional al número de llamadas write (y fdatasync). Para un determinado bs número de llamadas fdatasync es igual a size / bs.
Dado que nos interesaba el percentil, nos esforzamos por tener un número de muestras lo suficientemente grande para que fuera estadísticamente significativo. Decidimos que 10^4 (correspondiente a un tamaño de 22 MB) sería suficiente. Valores más bajos del parámetro --size proporcionaban un ruido más pronunciado (por ejemplo, las llamadas fdatasync, que llevan mucho más tiempo de lo habitual y afectan al percentil 99).
¡La decisión es tuya!
El artículo muestra cómo fio se puede evaluar si un medio es lo suficientemente rápido para usar con etcd. ¡Ahora depende de ti! Puedes explorar máquinas virtuales con almacenamiento basado en SSD en el servicio .
P.D. del traductor
Con ejemplos listos para usar fio para resolver otras tareas, puedes revisar en o directamente en (hay muchos más que los mencionados en la documentación).
P.P.D. del traductor
También puedes leer en nuestro blog:
- «»;
- «»;
- «».
Fuente: habr.com
