

Muchos conocen la base de datos PostgreSQL, que ha demostrado ser eficaz en instalaciones pequeñas. Sin embargo, la tendencia hacia el uso de software de código abierto se ha vuelto cada vez más evidente, incluso en grandes empresas y requisitos empresariales. En este artículo, explicaremos cómo integrar Postgres en un entorno corporativo y compartiremos la experiencia de crear un sistema de copias de seguridad (SRK) para esta base de datos utilizando el sistema de copias de seguridad Commvault como ejemplo.
PostgreSQL ya ha demostrado su valía: la base de datos funciona de maravilla, es utilizada por empresas digitales de renombre como Alibaba y TripAdvisor, y la ausencia de costos de licencia la convierte en una alternativa atractiva a gigantes como MS SQL o Oracle DB. Sin embargo, en cuanto comenzamos a pensar en PostgreSQL dentro del panorama empresarial, nos encontramos rápidamente con exigencias estrictas: «¿Qué hay de la alta disponibilidad de la configuración? ¿la recuperación ante desastres? ¿dónde está la supervisión integral? ¿y la copia de seguridad automatizada? ¿el uso de bibliotecas de cintas tanto directamente como en almacenamiento secundario?»
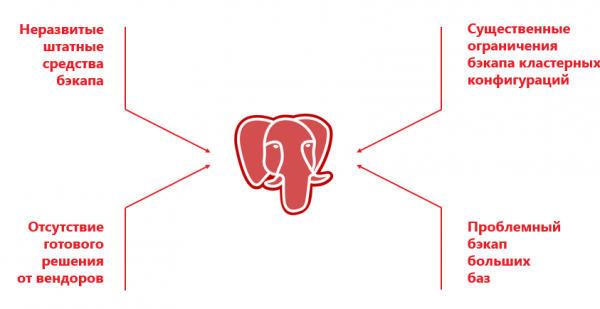
Por un lado, PostgreSQL no cuenta con herramientas de copia de seguridad integradas como las que tienen las «grandes» bases de datos, como RMAN en Oracle DB o SAP Database Backup. Por otro lado, los proveedores de sistemas de copias de seguridad empresariales (Veeam, Veritas, Commvault), aunque admiten PostgreSQL, en realidad solo trabajan con configuraciones específicas (generalmente independientes) y un conjunto de diversas limitaciones.
Sistemas de copias de seguridad diseñados específicamente para PostgreSQL, como Barman, Wal-g, pg_probackup, son extremadamente populares en instalaciones pequeñas de PostgreSQL o donde no son necesarias copias de seguridad pesadas de otros elementos del panorama de TI. Por ejemplo, además de PostgreSQL, la infraestructura puede incluir sistemas físicos y virtuales. servidores, OpenShift, Oracle, MariaDB, Cassandra, etc. Todo esto se recomienda respaldar con una herramienta común. Implementar una solución separada exclusivamente para PostgreSQL es una mala idea: los datos se copiarán a un disco y luego necesitarán ser movidos a una cinta. Esta duplicación de copias de seguridad aumenta el tiempo de respaldo y, lo que es más crítico, el de recuperación.
En la solución empresarial, la copia de seguridad de la instalación se realiza con un número determinado de nodos de un clúster dedicado. Por ejemplo, Commvault solo puede trabajar con un clúster de dos nodos, donde el Primary y el Secondary están estrictamente asignados a nodos específicos. Además, tiene sentido hacer copias de seguridad solo con el Primary, ya que hacer copias de seguridad desde el Secondary tiene sus limitaciones. Debido a las características del SGBD, no se crea un volcado en el Secondary, por lo que solo queda la posibilidad de una copia de seguridad de archivos.
Para reducir el riesgo de tiempo de inactividad, al crear un sistema de alta disponibilidad se forma una configuración de clúster 'viva', y el Primary puede migrar gradualmente entre diferentes servidores. Por ejemplo, el software Patroni inicia automáticamente el Primary en un nodo seleccionado aleatoriamente del clúster. El SRK no tiene forma de rastrear esto 'de fábrica', y si la configuración cambia, los procesos se rompen. Es decir, la implementación de la gestión externa interfiere con el funcionamiento eficaz del SRK, porque el servidor controlador simplemente no comprende de dónde y qué datos necesita copiar.
Otro problema es la implementación de la copia de seguridad en Postgres. Es posible a través de un volcado, y en bases pequeñas esto funciona. Pero en bases de datos grandes, el volcado toma mucho tiempo, requiere muchos recursos y puede causar fallos en la instancia de la base de datos.
La copia de seguridad de archivos soluciona la situación, pero en bases grandes se vuelve lenta, ya que funciona en modo de un solo hilo. Además, los proveedores tienen una serie de limitaciones adicionales. No se puede utilizar simultáneamente la copia de seguridad de archivos y la copia de seguridad de volcado, y a veces no se admite la deduplicación. Hay muchos problemas, y a menudo es más fácil elegir una base de datos cara, pero confiable, en lugar de Postgres.
¡No hay marcha atrás! ¡Detrás está Moscú para los desarrolladores!
Sin embargo, recientemente nuestro equipo se enfrentó a un desafío complicado: en el proyecto de creación del AIS OSAGO 2.0, donde estábamos desarrollando la infraestructura de TI, los desarrolladores eligieron PostgreSQL para el nuevo sistema.
Para los grandes desarrolladores de software, es mucho más fácil utilizar soluciones de código abierto 'de moda'. En la plantilla de Facebook hay suficientes especialistas que mantienen el funcionamiento de este SGBD. Y en el caso de RSA, todas las tareas del 'segundo día' recaían sobre nosotros. Se nos requería asegurar la alta disponibilidad, ensamblar el clúster y, por supuesto, establecer la copia de seguridad. La lógica de acción era la siguiente:
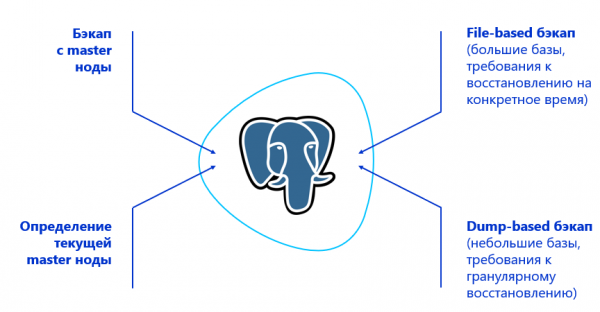
- Enseñar al SRK a hacer copias de seguridad desde el nodo primario del clúster. Para esto, el SRK debe poder encontrarlo, lo que significa que se necesita integración con alguna solución de gestión del clúster PostgreSQL. En el caso de RSA, se utilizó el software Patroni para ello.
- Determinar el tipo de copia de seguridad, basándose en los volúmenes de datos y los requisitos de recuperación. Por ejemplo, cuando es necesario restaurar páginas de forma granular, usar un volcado; y si las bases de datos son grandes y no se requiere recuperación granular, trabajar a nivel de archivos.
- Incorporar a la solución la capacidad de realizar copias de seguridad a nivel de bloques, para poder crear copias de seguridad en modo multihilo.
Desde el principio, nos propusimos crear un sistema efectivo y simple sin una compleja infraestructura de componentes adicionales. Cuantos menos parches haya, menos carga sobre el personal y menor riesgo de que el SRK falle. Enfoques que utilizaban Veeam y RMAN los descartamos de inmediato, porque un conjunto de dos soluciones ya sugiere una falta de fiabilidad del sistema.
Un poco de magia para empresas
Así que necesitábamos garantizar copias de seguridad fiables para 10 clústeres con 3 nodos cada uno, teniendo en cuenta que en el centro de datos de respaldo hay una infraestructura espejo. Los centros de datos en el contexto de PostgreSQL operan bajo el principio de activo-pasivo. El volumen total de bases de datos era de 50 TB. Cualquier SRK de nivel empresarial podría manejar esto fácilmente. Pero el matiz es que, inicialmente, Postgres no tiene una base para la plena y profunda compatibilidad con sistemas de copias de seguridad. Por lo tanto, tuvimos que buscar una solución que, desde el principio, tuviera la máxima funcionalidad en combinación con PostgreSQL y mejorar el sistema.
Realizamos 3 hackatones internos: revisamos más de una veintena de desarrollos, los probamos, hicimos cambios en base a nuestras hipótesis y volvimos a verificar. Tras analizar las opciones disponibles, elegimos Commvault. Este producto ya podía trabajar 'fuera de la caja' con una instalación de clúster PostgreSQL básica, y su arquitectura abierta despertó esperanzas (que se confirmaron) de una exitosa mejora e integración. Además, Commvault puede realizar copias de seguridad de los logs de PostgreSQL. Por ejemplo, Veritas NetBackup solo puede hacer copias de seguridad completas en PostgreSQL.
Más detalles sobre la arquitectura. Los servidores de gestión de Commvault se instalaron en cada uno de los dos centros de datos en una configuración de CommServ HA. El sistema es espejo, se gestiona a través de una única consola y cumple con todos los requisitos empresariales en términos de HA.
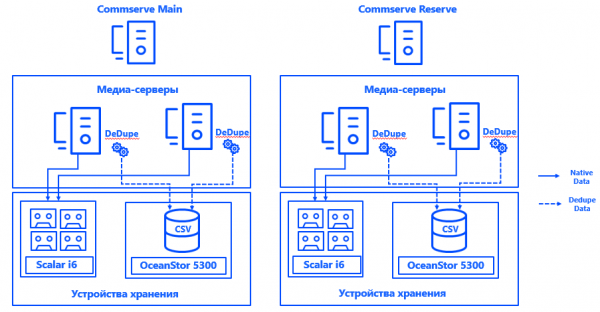
También en cada centro de datos hemos lanzado dos servidores de medios físicos, a los que se conectaron mediante SAN a través de Fibre Channel arreglos de discos dedicados específicamente para copias de seguridad y bibliotecas de cintas. Las bases de deduplicación distribuidas proporcionaron resiliencia a los servidores de medios, y la conexión de cada servidor a cada CSV permitió la operación continua en caso de que cualquier componente fallara. La arquitectura del sistema permite seguir realizando copias de seguridad, incluso si uno de los centros de datos falla.
Patroni determina el nodo primario para cada clúster. Puede ser cualquier nodo libre en el centro de datos, pero solo en el principal. En la reserva, todos los nodos son secundarios.
Para que Commvault entendiera qué nodo del clúster es el primario, integramos el sistema (gracias a la arquitectura abierta de la solución) con Postgres. Para esto, se creó un script que informa sobre la ubicación actual del nodo primario al gestor. servidor Commvault.
En general, el proceso se ve así:
Patroni selecciona el primario → Keepalived levanta la IP del clúster y ejecuta el script → el agente de Commvault en el nodo seleccionado del clúster recibe la notificación de que es el primario → Commvault reconfigura automáticamente la copia de seguridad dentro del cliente pseudo.
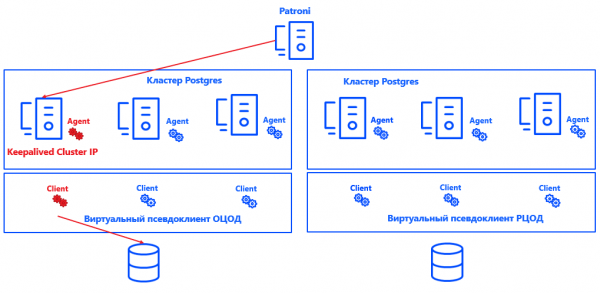
La ventaja de este enfoque es que la solución no afecta la consistencia, la corrección de los registros ni la recuperación de la instancia de Postgres. También se puede escalar fácilmente, ya que ahora no es necesario fijar para Commvault los nodos primarios y secundarios. Basta con que el sistema entienda dónde está el primario, y el número de nodos puede aumentarse prácticamente a cualquier valor.
La solución no pretende ser perfecta y tiene sus matices. Commvault solo puede hacer copias de seguridad de la instancia completa, no de bases de datos individuales. Por lo tanto, se creó una instancia separada para cada base de datos. Los clientes reales se agrupan en clientes pseudo virtuales. Cada cliente pseudo de Commvault es un clúster UNIX. Se añaden aquellos nodos del clúster donde está instalado el agente de Commvault para Postgres. Como resultado, todas las nodos virtuales del cliente pseudo se respaldan como una única instancia.
Dentro de cada pseudocliente se especifica el nodo activo del clúster. Este es el que nuestra solución de integración determina para Commvault. El principio de funcionamiento es bastante simple: si se eleva una IP de clúster en el nodo, el script establece en el binario del agente de Commvault el parámetro "nodo activo" — de hecho, el script coloca "1" en la parte necesaria de la memoria. El agente transmite estos datos a CommServe, y Commvault realiza la copia de seguridad desde el nodo correspondiente. Además, a nivel de script se verifica la corrección de la configuración, ayudando a evitar errores al iniciar la copia de seguridad.
Mientras tanto, grandes bases de datos se respaldan en bloques a través de múltiples hilos, cumpliendo con los requisitos de RPO y de la ventana de respaldo. La carga en el sistema es insignificante: las copias completas no se realizan con frecuencia, y en los otros días solo se recopilan logs, particularmente en períodos de baja carga.
Por cierto, aplicamos políticas separadas para el respaldo de los registros de archivo de PostgreSQL — se almacenan bajo reglas diferentes, se copian en un horario distinto y no se activa la deduplicación para ellos, ya que estos registros contienen datos únicos.
Para garantizar la consistencia de toda la infraestructura de TI, se instalaron clientes de archivos Commvault en cada uno de los nodos del clúster. Estos excluyen de las copias de seguridad los archivos de Postgres y están destinados únicamente al respaldo del sistema operativo y aplicaciones. También se ha previsto una política específica para esta parte de los datos, con su propio período de retención.
Actualmente, el SRK no afecta a los servicios productivos, pero si la situación cambia, se podrá activar el sistema de limitación de carga en Commvault.
¿Está bien? ¡Está bien!
Así que hemos obtenido no solo una copia de seguridad funcional, sino también completamente automatizada para la instalación en clúster de PostgreSQL, cumpliendo con todos los requisitos de las exigencias empresariales.
Los parámetros RPO y RTO de 1 hora y 2 horas están cómodamente superados, lo que significa que el sistema seguirá cumpliendo con ellos incluso con un aumento significativo en los volúmenes de datos almacenados. A pesar de muchas dudas, PostgreSQL y el entorno empresarial resultaron ser perfectamente compatibles. Y ahora, por nuestra experiencia, sabemos que el respaldo para estas bases de datos es posible en una variedad de configuraciones.
Por supuesto, en este camino hemos tenido que gastar siete pares de botas de hierro, superar una serie de dificultades, caer en varios errores y corregir una cierta cantidad de equivocaciones. Pero ahora el enfoque ya se ha probado y puede aplicarse para implementar Open Source en lugar de bases de datos propietarias en condiciones difíciles de la empresa.
¿Has intentado trabajar con PostgreSQL en un entorno corporativo?
Autores:
Oleg Lavrenov, ingeniero de diseño de sistemas de almacenamiento de datos en «Infostate Jet»
Dmitry Erikin, ingeniero de diseño de complejos computacionales en «Infostate Jet»
Fuente: habr.com
