

Muchas personas se enfrentan a Elasticsearch. Pero, ¿qué sucede cuando quieres usarlo para almacenar registros "en grandes volúmenes"? ¿Y cómo sobrevivir sin problemas a la falla de cualquiera de varios centros de datos? ¿Qué arquitectura deberías implementar y en qué trampas podrías caer?
En Odnoklassniki decidimos resolver la gestión de registros con ayuda de Elasticsearch y ahora compartimos nuestra experiencia con Habr: sobre la arquitectura y las trampas.
Soy Piotr Zaytsev, trabajo como administrador de sistemas en Odnoklassniki. Antes también fui administrador, trabajé con Manticore Search, Sphinx Search y Elasticsearch. Es posible que, si surge otro …search, probablemente también trabaje con él. Además, participo en varios proyectos de código abierto de forma voluntaria.
Cuando llegué a Odnoklassniki, imprudentemente dije en la entrevista que sabía trabajar con Elasticsearch. Después de adaptarme y realizar algunas tareas sencillas, me asignaron una gran tarea de reformar el sistema de gestión de registros que existía en ese momento.
Requisitos
Los requisitos del sistema se formularon de la siguiente manera:
- Se debía utilizar Graylog como frontend. Porque en la empresa ya había experiencia utilizando este producto, los programadores y testers lo conocían, les era familiar y conveniente.
- Volumen de datos: en promedio de 50 a 80 mil mensajes por segundo, pero si algo se rompe, el tráfico no tiene límites, esto puede llegar a ser de 2 a 3 millones de líneas por segundo.
- Al discutir con los clientes los requisitos de velocidad para el procesamiento de consultas, entendimos que el patrón típico de uso de este tipo de sistema es que las personas buscan los registros de su aplicación de los últimos dos días y no quieren esperar más de un segundo para el resultado de su consulta.
- Los administradores insistieron en que el sistema debe ser fácilmente escalable cuando sea necesario, sin requerirles una comprensión profunda de cómo está estructurado.
- La única tarea de mantenimiento que estos sistemas requieren de forma periódica es cambiar algún hardware.
- Además, en Odnoklassniki hay una maravillosa tradición técnica: cualquier servicio que lancemos debe ser capaz de sobrevivir a la falla de un centro de datos (sorpresiva, no planificada y en cualquier momento).
El último requisito para la implementación de este proyecto nos costó mucho esfuerzo, del cual hablaré en detalle más adelante.
Entorno
Contamos con cuatro centros de datos, siendo que las nodos de Elasticsearch solo pueden estar en tres (por varias razones no técnicas).
En estos cuatro centros de datos hay aproximadamente 18,000 fuentes de logs diferentes: hardware, contenedores, máquinas virtuales.
Una característica importante: el clúster se ejecuta en contenedores no en máquinas físicas, sino en . A los contenedores se les garantiza 2 núcleos, equivalentes a 2.0Ghz v4, con la posibilidad de utilizar los núcleos restantes en caso de inactividad.
En otras palabras:
Topología
La vista general de la solución me parecía de la siguiente manera:
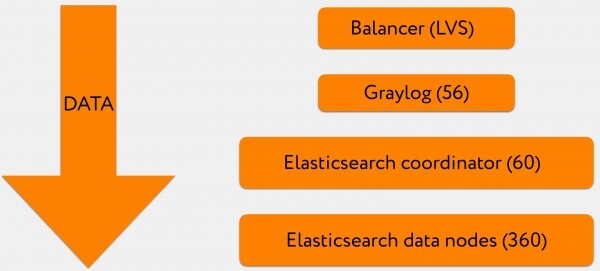
- 3-4 VIP se encuentran detrás del registro A del dominio Graylog, que es la dirección a la que se envían los logs.
- cada VIP es un equilibrador de carga LVS.
- Después de esto, los logs llegan a un conjunto de Graylog, parte de los datos se envía en formato GELF, parte en formato syslog.
- Luego, todo esto se escribe en grandes lotes en un conjunto de coordinadores de Elasticsearch.
- Y estos, a su vez, envían solicitudes de escritura y lectura a los nodos de datos relevantes.
Terminología
Es posible que no todos conozcan la terminología en detalle, así que me gustaría detenerme un poco en ella.
En Elasticsearch hay varios tipos de nodos: master, coordinator, data node. Hay otros dos tipos para diferentes transformaciones de logs y comunicación entre diferentes clústeres, pero solo usábamos los mencionados.
Master
Pinga todos los nodos presentes en el clúster, mantiene el mapa del clúster actualizado y lo distribuye entre los nodos, procesa la lógica de eventos, se encarga de diversas tareas de mantenimiento a nivel de clúster.
Coordinador
Realiza una única tarea: recibe solicitudes de los clientes para lectura o escritura y dirige este tráfico. En caso de que la solicitud sea de escritura, es probable que consulte al master en qué shard del índice relevante debe colocarlo y redirija la solicitud.
Nodo de datos
Almacena datos, ejecuta las solicitudes de búsqueda que llegan desde el exterior y operaciones sobre los shards ubicados en él.
Graylog
Es algo así como una combinación de Kibana con Logstash en el stack ELK. Graylog integra tanto la interfaz de usuario como el pipeline de procesamiento de logs. Detrás de Graylog funcionan Kafka y Zookeeper, que garantizan la conectividad de Graylog como un clúster. Graylog puede almacenar en caché los logs (Kafka) en caso de que Elasticsearch no esté disponible y repetir las solicitudes de lectura y escritura fallidas, agrupar y etiquetar los logs según las reglas definidas. Al igual que Logstash, Graylog tiene la funcionalidad de modificar las cadenas antes de escribirlas en Elasticsearch.
Además, Graylog cuenta con un servicio de descubrimiento integrado que permite, a partir de un nodo de Elasticsearch disponible, obtener todo el mapa del clúster y filtrarlo por una etiqueta específica, lo que permite dirigir las solicitudes a contenedores determinados.
Visualmente, esto se ve así:

Esta es una captura de pantalla de una instancia específica. Aquí organizamos un histograma basado en una consulta de búsqueda y mostramos filas relevantes.
Índices
Volviendo a la arquitectura del sistema, me gustaría detenerme más en cómo construimos el modelo de índices para que todo funcionara correctamente.
En el diagrama proporcionado anteriormente, este es el nivel más inferior: nodos de datos de Elasticsearch.
Un índice es una gran entidad virtual compuesta de shards de Elasticsearch. Cada uno de estos shards no es más que un índice de Lucene. Y cada índice de Lucene, a su vez, se compone de uno o más segmentos.
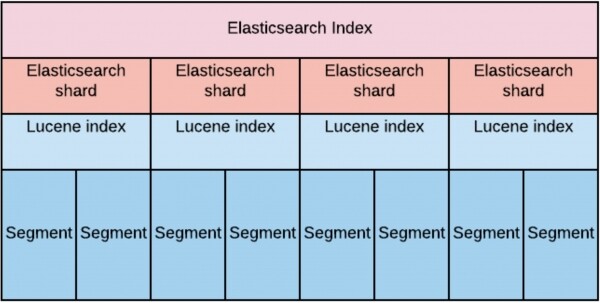
Al diseñar, consideramos que para cumplir con el requisito de velocidad de lectura sobre un gran volumen de datos, necesitábamos 'dispersar' estos datos uniformemente entre los nodos de datos.
Esto se tradujo en que el número de shards por índice (con réplicas) debe ser estrictamente igual al número de nodos de datos. En primer lugar, para garantizar un factor de replicación igual a dos (es decir, podemos perder la mitad del clúster). Y, en segundo lugar, para poder procesar solicitudes de lectura y escritura en al menos la mitad del clúster.
Primero definimos el tiempo de almacenamiento como 30 días.
La distribución de shards se puede representar gráficamente de la siguiente manera:
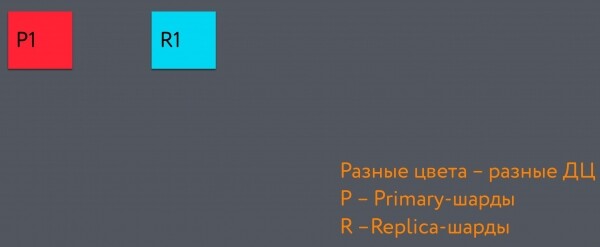
Todo el rectángulo gris oscuro en su totalidad es el índice. El cuadrado rojo a la izquierda en él es el shard primario, el primero en el índice. Y el cuadrado azul es el shard réplica. Están ubicados en diferentes centros de datos.
Cuando añadimos otro shard, se ubica en el tercer centro de datos. Y, al final, obtenemos una estructura como esta, que permite la pérdida de un centro de datos sin perder la consistencia de los datos:
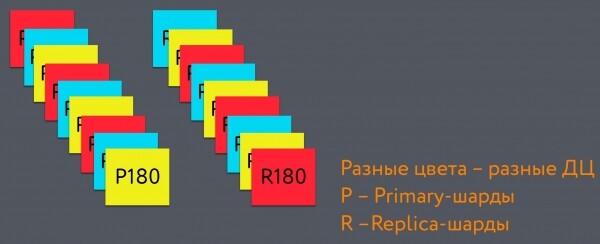
Hicimos la rotación de índices, es decir, la creación de un nuevo índice y la eliminación del más antiguo, igual a 48 horas (basado en el patrón de uso del índice: las búsquedas se realizan más frecuentemente sobre las últimas 48 horas).
Este intervalo de rotación de índices está relacionado con las siguientes razones:
Cuando un nodo de datos específico recibe una solicitud de búsqueda, es más ventajoso en términos de rendimiento interrogar un solo shard, si su tamaño es comparable al tamaño de la memoria del nodo. Esto permite mantener la parte 'caliente' del índice en la memoria y acceder a ella rápidamente. Cuando hay muchas partes 'calientes', la velocidad de búsqueda en el índice se degrada.
Cuando un nodo comienza a procesar una solicitud de búsqueda en un shard, asigna un número de hilos igual al número de núcleos de hyper-threading de la máquina física. Si la solicitud de búsqueda abarca un gran número de shards, el número de hilos aumenta proporcionalmente. Esto impacta negativamente en la velocidad de búsqueda y afecta adversamente la indexación de nuevos datos.
Para garantizar la latencia necesaria en la búsqueda, decidimos utilizar SSD. Para un procesamiento rápido de solicitudes, las máquinas que alojaban estos contenedores debían tener al menos 56 núcleos. El número 56 se eligió como un valor condicionadamente suficiente que determina la cantidad de hilos que generará Elasticsearch durante su funcionamiento. Muchos parámetros del pool de hilos en Elasticsearch dependen directamente del número de núcleos disponibles, lo que a su vez afecta directamente la cantidad necesaria de nodos en el clúster bajo el principio de 'menos núcleos — más nodos'.
Como resultado, obtuvimos que, en promedio, un shard pesa alrededor de 20 gigabytes, y hay 360 shards por índice. Por lo tanto, si los rotamos cada 48 horas, tenemos 15 en total. Cada índice almacena datos de 2 días.
Esquemas de escritura y lectura de datos
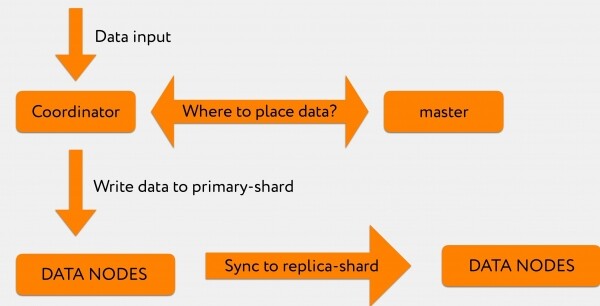
Vamos a analizar cómo se registran los datos en este sistema.
Supongamos que tenemos una solicitud de Graylog que llega al coordinador. Por ejemplo, queremos indexar entre 2,000 y 3,000 filas.
El coordinador, al recibir una solicitud de Graylog, interroga a un maestro: «En la solicitud de indexación se indicó específicamente el índice, pero no se especificó en qué fragmento escribir».
El maestro responde: «Escribe esta información en el fragmento número 71», después de lo cual se envía directamente al nodo de datos relevante, donde se encuentra el fragmento primario número 71.
Después de eso, el registro de transacciones se replica en el fragmento de réplica, que ya se encuentra en otro centro de datos.
Desde Graylog, llega a través del coordinador una solicitud de búsqueda. El coordinador la redirige por el índice, mientras que Elasticsearch reparte las solicitudes entre el fragmento primario y el fragmento de réplica según el principio round-robin.
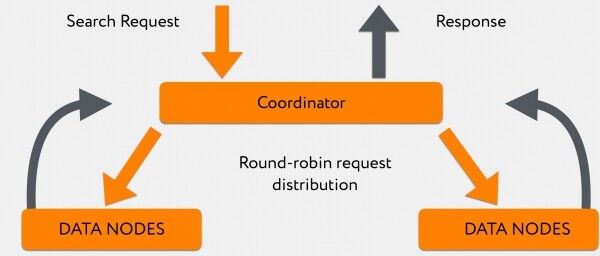
Los nodos, en un número de 180, responden de manera desigual y, mientras ellos responden, el coordinador acumula información que los nodos de datos más rápidos ya han «escupido» dentro de él. Después de eso, cuando toda la información ha llegado o se alcanza el tiempo de espera de la solicitud, se entrega todo directamente al cliente.
Todo este sistema, en promedio, procesa las solicitudes de búsqueda de las últimas 48 horas en 300-400 ms, excluyendo aquellas solicitudes que tienen un comodín líder.
«Flores» con Elasticsearch: configuración de Java
Para que todo esto funcionara como esperábamos originalmente, ajustamos durante mucho tiempo una variedad de cosas en el clúster.
La primera parte de los problemas detectados estaba relacionada con la configuración predeterminada de Java en Elasticsearch.
Problema uno
Observamos un gran número de mensajes sobre el hecho de que a nivel de Lucene, cuando se ejecutan trabajos de fondo, las combinaciones de segmentos de Lucene terminan con errores. Además, en los registros se podía ver que era un error OutOfMemoryError. A través de la telemetría, vimos que la memoria heap estaba libre y no estábamos seguros de por qué esta operación fallaba.
Resultó que las combinaciones de índices de Lucene ocurren fuera de la memoria heap. Y los contenedores están bastante estrictamente limitados en los recursos consumidos. En esos recursos solo podía entrar la memoria heap (el valor de heap.size era aproximadamente igual a RAM), y algunas operaciones off-heap fallaban con el error de asignación de memoria si por alguna razón no se ajustaban a los ~500 MB que quedaban hasta el límite.
La solución fue bastante trivial: aumentamos la cantidad de RAM disponible para el contenedor, después de lo cual nos olvidamos de que alguna vez tuvimos tales problemas.
El segundo problema
Al cabo de 4-5 días después del inicio del clúster, notamos que los nodos de datos comienzan a salir periódicamente del clúster y vuelven a ingresar después de 10-20 segundos.
Cuando empezamos a investigar, nos dimos cuenta de que esta memoria off-heap en Elasticsearch no se controla prácticamente de ninguna manera. Cuando le dimos más memoria al contenedor, pudimos llenar los grupos de buffers directos con información diversa, y se limpiaron solo después de que se ejecutara un GC explícito por parte de Elasticsearch.
En algunos casos, esta operación tomó bastante tiempo, y durante ese tiempo el clúster logró marcar este nodo como ya fuera de servicio. Este problema está bien documentado. .
La solución fue la siguiente: limitamos la capacidad de Java para utilizar la mayor parte de la memoria fuera del heap para estas operaciones. La limitamos a 16 gigabytes (-XX:MaxDirectMemorySize=16g), logrando que el GC explícito se llamara con mucha más frecuencia y se ejecutara mucho más rápido, evitando así desestabilizar el clúster.
El tercer problema
Si piensas que los problemas de 'nodos que abandonan el clúster en el momento más inesperado' han terminado aquí, estás equivocado.
Cuando configuramos el trabajo con los índices, optamos por mmapfs para en shards recientes con alta segmentación. Esto resultó ser un error bastante grave, porque al usar mmapfs, el archivo se mapea en la memoria RAM, y después trabajamos con el archivo mapeado. Debido a esto, cuando el GC intenta detener los hilos en la aplicación, tardamos mucho en llegar al safepoint, y en el camino hacia él, la aplicación deja de responder a las solicitudes del maestro sobre si sigue activa. Como resultado, el maestro considera que el nodo ya no está presente en el clúster. Después de unos 5-10 segundos, el recolector de basura hace su trabajo, el nodo revive, vuelve a entrar en el clúster y comienza la inicialización de los shards. Todo esto recordaba mucho a 'la producción que merecíamos' y no era adecuado para nada serio.
Para deshacernos de este comportamiento, primero cambiamos a niofs estándar, y luego, cuando migramos de las versiones cinco de Elastic a las seis, probamos hybridfs, donde este problema no se reproducía. Puedes leer más sobre los tipos de almacenamiento. .
El cuarto problema
Luego hubo otro problema muy interesante que tratamos durante un tiempo récord. Lo estuvimos persiguiendo durante 2-3 meses porque su patrón era completamente incomprensible.
A veces nuestros coordinadores entraban en Full GC, generalmente después del almuerzo, y no volvían. En la registro de las demoras de GC, se veía así: todo iba bien, bien, bien, y luego de repente — todo se volvía malo.
Primero pensamos que teníamos un usuario malicioso que estaba ejecutando algún tipo de consulta que sacaba al coordinador del modo de trabajo. Pasamos mucho tiempo registrando las consultas, tratando de averiguar qué estaba pasando.
Al final, descubrimos que en el momento en que un usuario ejecuta una gran consulta, y esta llega a un coordinador específico de Elasticsearch, algunas nodos responden más lento que otros.
Y el tiempo que el coordinador espera la respuesta de todos los nodos, acumula en sí mismo los resultados enviados por los nodos que ya han respondido. Para GC, esto significa que nuestro patrón de uso de memoria se cambia muy rápidamente. Y el GC que estábamos utilizando no manejaba esta tarea.
La única solución que encontramos para cambiar el comportamiento del clúster en tal situación fue migrar a JDK13 y utilizar el recolector de basura Shenandoah. Esto resolvió el problema, los coordinadores dejaron de caer.
Con esto, los problemas con Java terminaron y comenzaron los problemas de capacidad.
«Frutos» con Elasticsearch: capacidad
Los problemas de capacidad significan que nuestro clúster funciona de manera estable, pero en picos de documentos indexados y durante maniobras, el rendimiento es insuficiente.
El primer síntoma encontrado: en algunas «explosiones» en producción, cuando se genera repentinamente una gran cantidad de registros, en Graylog empieza a aparecer frecuentemente el error de indexación es_rejected_execution.
Esto ocurría porque thread_pool.write.queue en un nodo de datos, antes de que Elasticsearch pudiera procesar la solicitud de indexación y enviar la información al shard en el disco, por defecto solo puede almacenar en caché 200 solicitudes. Y en se menciona muy poco sobre este parámetro. Solo se indica el número máximo de hilos y el tamaño por defecto.
Por supuesto, empezamos a ajustar este valor y descubrimos lo siguiente: en nuestra configuración, se pueden almacenar en caché bastante bien hasta 300 solicitudes, y un valor mayor conlleva que nuevamente caigamos en Full GC.
Además, dado que se trata de lotes de mensajes que llegan dentro de una sola solicitud, también fue necesario ajustar Graylog para que escribiera no con frecuencia y en pequeños lotes, sino en grandes lotes o cada 3 segundos, si el lote aún no está lleno. En tal caso, la información que escribimos en Elasticsearch se vuelve accesible no en dos segundos, sino en cinco (lo cual nos parece aceptable), pero se reduce el número de reintentos que se deben hacer para empujar un gran lote de información.
Esto es especialmente importante en esos momentos en que algo se cae y lo informa con vehemencia, para no recibir un Elasticsearch completamente inundado de spam, y después de un tiempo, nodos de Graylog que no funcionan debido a búferes saturados.
Además, cuando ocurrían estas explosiones en producción, recibíamos quejas de programadores y testers: en el momento en que realmente necesitaban esos logs, se les proporcionaban muy lentamente.
Comenzamos a investigar. Por un lado, estaba claro que tanto las consultas de búsqueda como las solicitudes de indexación se procesan, en esencia, en las mismas máquinas físicas, y de alguna manera, habrá ciertas caídas.
Pero esto se podía sortear parcialmente gracias a que en las versiones seis de Elasticsearch apareció un algoritmo que permite distribuir las solicitudes entre los nodos de datos relevantes no por un principio aleatorio de round-robin (el contenedor que se encarga de la indexación y mantiene el primary-shard puede estar muy ocupado, y no habrá posibilidad de responder rápidamente), sino dirigir esta solicitud a un contenedor menos ocupado con un replica-shard, que responderá significativamente más rápido. En otras palabras, llegamos a use_adaptive_replica_selection: true.
La imagen de lectura comienza a lucir así:
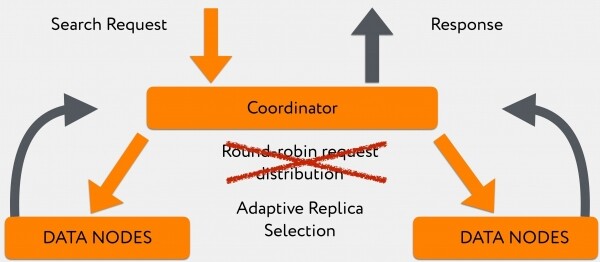
La transición a este algoritmo permitió mejorar notablemente el tiempo de consulta en esos momentos en que teníamos un gran flujo de logs para escribir.
Finalmente, el principal problema era la salida sin dolor del centro de datos.
Lo que queríamos del clúster justo después de la pérdida de conexión con un DC:
- Si nuestro master actual se encuentra en el centro de datos caído, será recolocado y su rol pasará a otro nodo en otro DC.
- El maestro rápidamente expulsará del clúster todos los nodos inaccesibles.
- Basándose en los nodos restantes, entenderá que en el centro de datos perdido teníamos tales shards primarios, rápidamente promocionará shards replicados complementarios en los centros de datos restantes y la indexación de los datos continuará.
- Como resultado de esto, la capacidad de escritura y lectura del clúster se degradará gradualmente; sin embargo, en general, todo seguirá funcionando, aunque lentamente, de manera estable.
Como descubrimos, queríamos algo así:
Y obtuvimos lo siguiente:
¿Cómo ocurrió esto?
En el momento de la caída del centro de datos, el cuello de botella fue el maestro.
¿Por qué?
Resulta que en el maestro hay un TaskBatcher, responsable de la distribución de ciertas tareas y eventos en el clúster. Cualquier salida de un nodo, cualquier promoción de un shard de réplica a primario, cualquier tarea para crear algún shard en algún lugar, todo esto primero pasa por el TaskBatcher, donde se procesa secuencialmente y en un solo hilo.
En el momento de la salida de un centro de datos, sucedía que todos los nodos de datos en los centros de datos sobrevivientes consideraban su deber informar al maestro "hemos perdido tales shards y tales nodos de datos".
Al mismo tiempo, los nodos de datos sobrevivientes enviaban toda esta información al maestro actual y trataban de esperar la confirmación de que él la había recibido. No la recibían, ya que el maestro recibía las tareas más rápido de lo que podía responder. Los nodos repetían las solicitudes debido al tiempo de espera, mientras el maestro ya no intentaba responderles y estaba completamente absorbido por la tarea de clasificar las solicitudes por prioridad.
En términos terminales, los nodos de datos estaban enviando tanto spam al maestro que él llegaba a un full GC. Después de eso, el rol del maestro se trasladaba a algún siguiente nodo, y con él sucedía exactamente lo mismo, y al final el clúster colapsaba por completo.
Hicimos mediciones, y hasta la versión 6.4.0, donde esto fue solucionado, bastaba con sacar simultáneamente solo 10 nodos de datos de 360 para colapsar completamente el clúster.
Así es como se veía aproximadamente:
Después de la versión 6.4.0, donde se arregló este bug problemático, los nodos de datos dejaron de matar al maestro. Pero eso no lo hizo "más inteligente". Es decir, cuando sacamos 2, 3 o 10 (cualquier cantidad distinta de uno) nodos de datos, el maestro recibe algún primer mensaje que dice que el nodo A salió y trata de informar sobre esto al nodo B, nodo C, nodo D.
En este momento, esto solo se puede abordar estableciendo un tiempo de espera de aproximadamente 20 a 30 segundos para intentar contarle a alguien algo, gestionando así la velocidad de salida del centro de datos del clúster.
En principio, esto se ajusta a los requisitos que se establecieron inicialmente para el producto final en el marco del proyecto, pero desde el punto de vista de la 'ciencia pura', es un error. Que, por cierto, fue corregido exitosamente por los desarrolladores en la versión 7.2.
De hecho, cuando un nodo de datos salía, resultaba que difundir la información sobre su salida era más importante que contarle a todo el clúster que en él se encontraban ciertos primary-shard (para promover un replica-shard en otro centro de datos a primary, donde se podía escribir información).
Por lo tanto, una vez que todo 'ha pasado', los nodos de datos que han salido no se marcan como stale de inmediato. En consecuencia, tenemos que esperar hasta que todos los pings a los nodos de datos salidos se agoten y solo después de esto nuestro clúster comienza a informar que en cierto lugar se debe continuar grabando información. Se puede leer más sobre esto. .
Como resultado, la operación de salida del centro de datos hoy nos lleva alrededor de 5 minutos en hora pico. Para una máquina tan grande y poco ágil, es un resultado bastante bueno.
Finalmente, llegamos a la siguiente solución:
- Tenemos 360 nodos de datos con discos de 700 gigabytes.
- 60 coordinadores para enrutar el tráfico a estos nodos de datos.
- 40 maestros, que nos han quedado como un legado de las versiones anteriores a 6.4.0: para sobrevivir la salida del centro de datos, estábamos moralmente preparados para perder algunas máquinas, para garantizar que incluso en el peor escenario tuviéramos un quórum de maestros.
- Cualquier intento de combinar roles en un mismo contenedor se topaba con el hecho de que tarde o temprano el nodo fallaba bajo carga.
- En todo el clúster se utiliza un heap.size de 31 gigabytes: todos los intentos de reducir el tamaño conducían a que en búsquedas pesadas con wildcard inicial ya sea se mataran algunos nodos o se activara el circuit breaker en Elasticsearch.
- Además, para garantizar el rendimiento de búsqueda, tratamos de mantener la cantidad de objetos en el clúster lo más baja posible, para manejar la menor cantidad de eventos en el punto más crítico, que se encontró en el maestro.
Por último, sobre la monitorización
Para que todo esto funcione como se pensó, supervisamos lo siguiente:
- Cada nodo de datos informa a nuestra nube que está presente y que tiene ciertos shards. Cuando apagamos algo en algún lugar, el clúster informa en 2-3 segundos que hemos apagado los nodos 2, 3 y 4 en el centro A; esto significa que en otros centros de datos no podemos apagar aquellos nodos que aún tienen shards en un solo ejemplar.
- Conociendo el comportamiento del maestro, observamos atentamente la cantidad de tareas pendientes. Porque incluso una tarea atascada, si no se timeouta a tiempo, puede teóricamente convertirse en la razón por la cual no se realizará, por ejemplo, la promoción de un shard replica a primary, lo que detendría la indexación.
- También miramos de cerca las demoras del recolector de basura, porque ya hemos tenido grandes dificultades con esto durante la optimización.
- Rechazos por hilos, para entender de antemano dónde está el 'cuello de botella'.
- Y las métricas estándar, como heap, RAM y I/O.
Al construir la supervisión, es indispensable considerar las características del Thread Pool en Elasticsearch. describe las posibilidades de configuración y los valores predeterminados para la búsqueda y la indexación, pero omite por completo thread_pool.management. Estos hilos manejan, entre otros, solicitudes del tipo _cat/shards y otras similares que son convenientes para escribir la supervisión. Cuanto más grande es el clúster, más de estas solicitudes se realizan por unidad de tiempo, y el mencionado thread_pool.management, además de no estar representado en la documentación oficial, está limitado por defecto a 5 hilos, lo que se agota muy rápido, después de lo cual la supervisión deja de funcionar correctamente.
Lo que quiero decir en conclusión es: ¡lo hemos logrado! Hemos conseguido dar a nuestros programadores y desarrolladores una herramienta que prácticamente en cualquier situación puede proporcionar información rápida y confiable sobre lo que está sucediendo en producción.
Sí, resultó bastante complicado, pero aun así, logramos encajar nuestras necesidades en los productos existentes que no tuvimos que parchear ni reescribir a medida.
Fuente: habr.com
