

¡Hola, habitantes de Habr! Este libro es adecuado para cualquier desarrollador que quiera entender el procesamiento de flujos. Comprender la programación distribuida ayudará a estudiar mejor Kafka y Kafka Streams. Sería bueno conocer el propio framework Kafka, pero no es obligatorio: te contaré todo lo que necesitas. Los desarrolladores experimentados en Kafka, así como los principiantes, dominarán la creación de aplicaciones interesantes para el procesamiento de flujos utilizando la biblioteca Kafka Streams, gracias a este libro. Los desarrolladores de Java de nivel medio y alto, ya familiarizados con conceptos como la serialización, aprenderán a aplicar sus habilidades para crear aplicaciones de Kafka Streams. El código fuente del libro está escrito en Java 8 y utiliza de manera significativa la sintaxis de expresiones lambda de Java 8, por lo que la capacidad de trabajar con funciones lambda (incluso en otro lenguaje de programación) será útil.
Fragmento. 5.3. Agregación y operaciones de ventana
En esta sección, pasaremos a estudiar las partes más prometedoras de Kafka Streams. Hasta ahora hemos examinado los siguientes aspectos de Kafka Streams:
- creación de topologías de procesamiento;
- uso de estado en aplicaciones de flujo;
- realización de uniones de flujos de datos;
- diferencias entre flujos de eventos (KStream) y flujos de actualizaciones (KTable).
En los siguientes ejemplos, reuniremos todos estos elementos. Además, te familiarizarás con las operaciones de ventana, otra gran capacidad de las aplicaciones de flujo. Nuestro primer ejemplo será la agregación simple.
5.3.1. Agregación del volumen de ventas de acciones por sectores industriales
La agregación y agrupación son herramientas vitales al trabajar con datos de flujo. Examinar registros individuales a medida que llegan a menudo resulta insuficiente. Para extraer información adicional de los datos, es necesario agrupamiento y combinación.
En este ejemplo, te pondrás en la piel de un trader intradía que necesita rastrear los volúmenes de ventas de acciones de empresas en varios sectores industriales. En particular, te interesan las cinco empresas con los mayores volúmenes de ventas de acciones en cada sector industrial.
Para dicha agregación, se requerirán varios pasos para traducir los datos a la forma necesaria (hablando en términos generales).
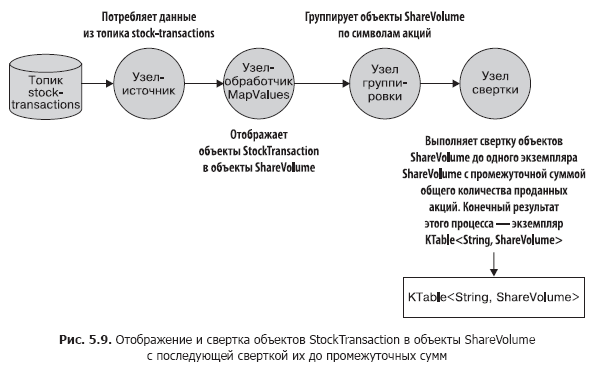
- Crear una fuente basada en un tema que publique información sin procesar sobre el comercio de acciones. Tendremos que mapear un objeto de tipo StockTransaction a un objeto de tipo ShareVolume. El hecho es que el objeto StockTransaction contiene metadatos de ventas, y solo necesitamos los datos sobre la cantidad de acciones vendidas.
- Agrupar los datos de ShareVolume por símbolos de acciones. Después de agrupar por símbolos, se pueden resumir estos datos a cantidades intermedias de volumen de ventas de acciones. Cabe señalar que el método KStream.groupBy devuelve una instancia de tipo KGroupedStream. Y para obtener una instancia de KTable, se puede invocar el método KGroupedStream.reduce.
¿Qué es la interfaz KGroupedStream?
Los métodos KStream.groupBy y KStream.groupByKey devuelven una instancia de KGroupedStream. KGroupedStream es una representación intermedia de un flujo de eventos después de agrupar por claves. No está destinado para ser manipulado directamente. En cambio, KGroupedStream se utiliza para operaciones de agregación, cuyo resultado siempre es una KTable. Y dado que el resultado de las operaciones de agregación es una KTable y se aplica un almacenamiento de estado, es posible que no todas las actualizaciones del resultado se envíen a lo largo de la tubería.
El método KTable.groupBy devuelve una KGroupedTable similar: una representación intermedia de un flujo de actualizaciones, reorganizadas por clave.
Tomemos un pequeño descanso y veamos la figura 5.9, que muestra lo que hemos logrado. Esta topología ya debería ser familiar para usted.
Ahora veamos el código para esta topología (se puede encontrar en el archivo src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (listado 5.2).
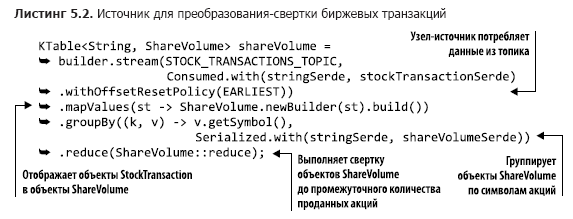
El código proporcionado es conciso y realiza muchas acciones en unas pocas líneas. En el primer parámetro del método builder.stream, puede notar algo nuevo para usted: el valor de la enumeración AutoOffsetReset.EARLIEST (también existe LATEST), que se establece mediante el método Consumed.withOffsetResetPolicy. Con esta enumeración, puede especificar la estrategia de reinicio de desplazamientos para cada KStream o KTable, que tiene prioridad sobre la configuración de reinicio de desplazamientos.
GroupByKey y GroupBy
En la interfaz KStream hay dos métodos para agrupar registros: GroupByKey y GroupBy. Ambos devuelven KGroupedTable, por lo que puede surgir la pregunta lógica: ¿cuál es la diferencia entre ellos y cuándo usar cada uno?
El método GroupByKey se aplica cuando las claves en KStream ya no están vacías. Lo más importante es que la bandera "requiere re-particionamiento" nunca se estableció.
El método GroupBy supone que se han cambiado las claves para la agrupación, por lo que la bandera de re-particionamiento se establece en verdadero. La ejecución después del método GroupBy de uniones, agregaciones, etc., resultará en un re-particionamiento automático.
Resumen: se debe utilizar GroupByKey siempre que sea posible, en lugar de GroupBy.
Lo que hacen los métodos mapValues y groupBy es claro, así que veamos el método sum() (que se puede encontrar en el archivo src/main/java/bbejeck/model/ShareVolume.java) (listado 5.3).
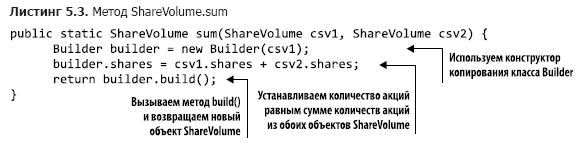
El método ShareVolume.sum devuelve la suma intermedia del volumen de acciones vendidas, y el resultado de toda la cadena de cálculos representa un objeto KTable. Ahora entiendes el papel que juega KTable. A medida que llegan objetos ShareVolume, la última actualización relevante se conserva en el respectivo objeto KTable. Es importante recordar que todas las actualizaciones se reflejan en el anterior shareVolumeKTable, pero no todas se envían a continuación.
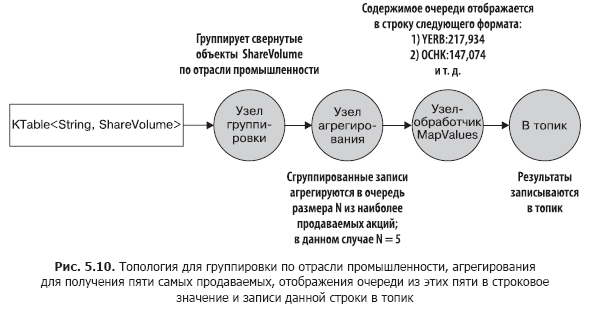
A continuación, utilizando este KTable, realizamos la agregación (por la cantidad de acciones vendidas) para obtener cinco empresas con los mayores volúmenes de ventas de acciones en cada una de las industrias. Nuestras acciones serán similares a las del primer agrupamiento.
- Realizar otra operación groupBy para agrupar objetos ShareVolume individuales por industria.
- Proceder a sumar objetos ShareVolume. Esta vez, el objeto de agregación es una cola de prioridad de tamaño fijo. En esta cola de tamaño fijo se conservan únicamente cinco empresas con las mayores cantidades de acciones vendidas.
- Convertir las colas del punto anterior en un valor string y devolver cinco de las más vendidas por cantidad de acciones por sectores industriales.
- Registrar los resultados en formato string en el tópico.
En la figura 5.10 se muestra un gráfico de la topología del flujo de datos. Como se puede ver, el segundo ciclo de procesamiento es bastante simple.
Ahora, habiendo entendido claramente la estructura de este segundo ciclo de procesamiento, se puede consultar su código fuente (lo encontrará en el archivo src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (listado 5.4).
En este inicializador hay una variable fixedQueue. Este es un objeto personalizado: un adaptador para java.util.TreeSet, que se utiliza para rastrear los N mayores resultados en orden decreciente de la cantidad de acciones vendidas.
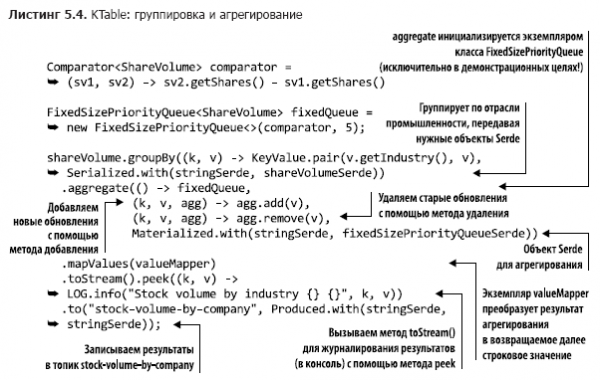
Ya te has encontrado con las llamadas groupBy y mapValues, así que no nos detendremos en ellas (llamamos al método KTable.toStream, ya que el método KTable.print se considera obsoleto). Sin embargo, aún no has visto la versión KTable del método aggregate(), así que dedicaremos un poco de tiempo a discutirlo.
Como recordarás, KTable se distingue en que los registros con las mismas claves se consideran actualizaciones. KTable reemplaza el registro antiguo por el nuevo. La agregación ocurre de manera similar: se agregan los últimos registros con la misma clave. Cuando llega un registro, se agrega a la instancia de la clase FixedSizePriorityQueue utilizando un sumador (el segundo parámetro en la llamada al método aggregate), pero si ya existe otro registro con la misma clave, el registro antiguo se elimina mediante un restador (el tercer parámetro en la llamada al método aggregate).
Todo esto significa que nuestro agregador, FixedSizePriorityQueue, no agrega todos los valores con una misma clave, sino que mantiene una suma móvil de las cantidades de las N acciones más vendidas. Cada registro que llega contiene el total de acciones vendidas hasta ese momento. KTable te proporcionará información sobre qué acciones de qué empresas se están vendiendo más en este momento, no se requiere agregación móvil de cada actualización.
Hemos aprendido a hacer dos cosas importantes:
- agrupar valores en KTable por una clave común;
- realizar operaciones útiles sobre esos valores agrupados, como reducción y agregación.
La habilidad para realizar estas operaciones es importante para comprender el significado de los datos que fluyen a través de la aplicación Kafka Streams y determinar qué información están transmitiendo.
También hemos reunido algunos de los conceptos clave discutidos previamente en este libro. En el capítulo 4, hablamos de lo crucial que es para una aplicación de streaming tener un estado local y tolerante a fallos. El primer ejemplo de este capítulo demostró por qué el estado local es tan importante: permite hacer un seguimiento de la información que ya has visto. El acceso local evita retrasos en la red, lo que hace que la aplicación sea más eficiente y resistente a errores.
Al realizar cualquier operación de reducción o agregación, es necesario especificar el nombre del almacén de estado. Las operaciones de reducción y agregación devuelven una instancia de KTable, y KTable utiliza el almacén de estado para reemplazar los antiguos resultados por nuevos. Como has visto, no todas las actualizaciones se envían más adelante en la canalización, y esto es importante, ya que las operaciones de agregación están destinadas a obtener información final. Si no se aplica un estado local, KTable enviará todos los resultados de agregación y reducción.
A continuación, veremos cómo realizar operaciones como la agregación dentro de un intervalo de tiempo específico, conocidas como operaciones de ventana (windowing operations).
5.3.2. Operaciones de Ventana
En la sección anterior, nos familiarizamos con la reducción y la agregación 'móviles'. La aplicación realizaba una reducción continua del volumen de ventas de acciones, seguida de la agregación de las cinco acciones más vendidas en el mercado.
A veces, estas reducciones y agregaciones continuas son necesarias. Y otras veces, se requieren operaciones solo sobre un intervalo de tiempo determinado. Por ejemplo, calcular cuántas transacciones de acciones de una empresa específica se realizaron en los últimos 10 minutos. O cuántos usuarios hicieron clic en un nuevo banner publicitario en los últimos 15 minutos. La aplicación puede realizar tales operaciones repetidamente, pero con resultados que solo se refieren a intervalos de tiempo específicos (ventanas de tiempo).
Conteo de transacciones bursátiles por comprador
En el siguiente ejemplo, nos ocuparemos de rastrear transacciones bursátiles de varios traders: ya sean grandes organizaciones o astutos financistas independientes.
Existen dos posibles razones para este tipo de seguimiento. Una de ellas es la necesidad de saber qué compran/venden los líderes del mercado. Si estos grandes jugadores e inversores experimentados ven oportunidades, tiene sentido seguir su estrategia. La segunda razón es la intención de detectar cualquier posible señal de transacciones ilegales utilizando información privilegiada. Para ello, necesitarás analizar la correlación entre los grandes picos de ventas y los comunicados de prensa importantes.
Este seguimiento consta de etapas como:
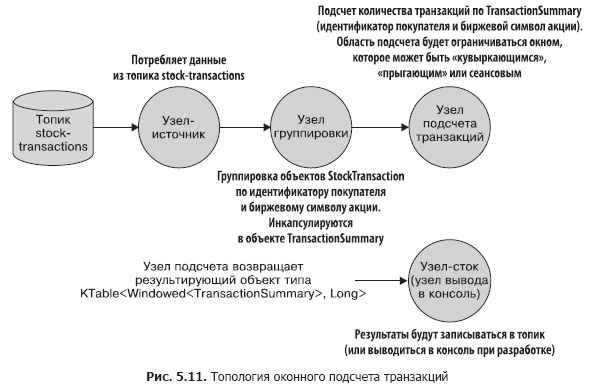
- crear un flujo para leer del tema stock-transactions;
- agrupar las entradas entrantes por el identificador del comprador y el símbolo de la acción. La llamada al método groupBy devuelve una instancia de la clase KGroupedStream;
- devolver mediante el método KGroupedStream.windowedBy un flujo de datos restringido por una ventana temporal, lo que permite realizar agregaciones en la ventana. Dependiendo del tipo de ventana, se devuelve ya sea TimeWindowedKStream o SessionWindowedKStream;
- contar las transacciones para la operación de agregación. El flujo de datos de la ventana determina si se incluye una entrada específica en este conteo;
- registrar los resultados en el tema o imprimirlos en la consola durante el desarrollo.
La topología de esta aplicación es simple, pero una representación visual no estaría de más. Veamos la figura 5.11.
A continuación, examinaremos la funcionalidad de las operaciones de ventana y el código correspondiente.
Tipos de ventanas
En Kafka Streams existen tres tipos de ventanas:
- de sesiones;
- de 'bote' (tumbling);
- deslizantes/'saltadoras' (sliding/hopping).
Cuál elegir depende de los requisitos del negocio. Las ventanas 'bote' y 'saltadoras' se limitan por tiempo, mientras que las restricciones de las sesiones están relacionadas con las acciones de los usuarios: la duración de la(s) sesión(es) se define exclusivamente por la actividad del usuario. Lo principal es recordar que todos los tipos de ventanas se basan en las marcas de fecha/hora de las entradas, no en el tiempo del sistema.
A continuación, implementaremos nuestra topología con cada uno de los tipos de ventanas. El código completo solo se proporcionará en el primer ejemplo, para los otros tipos de ventanas no habrá cambios, excepto el tipo de operación de ventana.
Ventanas de sesiones
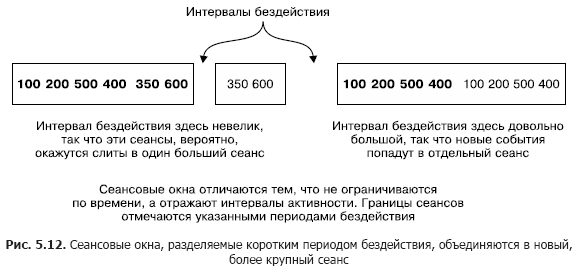
Las ventanas de sesión son muy diferentes de todos los demás tipos de ventanas. Están limitadas no tanto por el tiempo, sino por la actividad del usuario (o la actividad de la entidad que desearías rastrear). Las ventanas de sesión se delimitan por periodos de inactividad.
La figura 5.12 ilustra el concepto de ventanas de sesión. Una sesión más pequeña se mezclará con la sesión que está a su izquierda. Y la sesión a la derecha será separada, ya que sigue a un largo periodo de inactividad. Las ventanas de sesión se basan en las acciones de los usuarios, pero aplican marcas de fecha/hora de los registros para determinar a qué sesión pertenece el registro.
Uso de ventanas de sesión para rastrear transacciones bursátiles.
Utilizaremos ventanas de sesión para capturar información sobre transacciones bursátiles. La implementación de las ventanas de sesión se muestra en el listado 5.5 (que se puede encontrar en el archivo src/main/java/bbejeck/chapter_5/CountingWindowingAndKTableJoinExample.java).
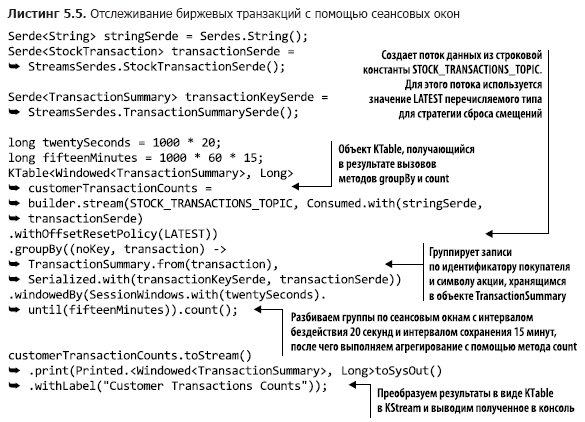
La mayoría de las operaciones de esta topología ya las has encontrado, así que no es necesario revisarlas nuevamente aquí. Pero hay algunos nuevos elementos que discutiremos ahora.
En cada operación groupBy generalmente se realiza alguna operación de agregación (agregación, reducción o conteo). Se puede realizar agregación acumulativa con un total acumulado, o agregación por ventana, donde se consideran los registros dentro de un intervalo de tiempo específico.
El código del listado 5.5 cuenta la cantidad de transacciones dentro de las ventanas de sesión. En la figura 5.13, estas acciones se analizan paso a paso.
Con la llamada windowedBy(SessionWindows.with(twentySeconds).until(fifteenMinutes)) estamos creando una ventana de sesión con un intervalo de inactividad de 20 segundos y un intervalo de retención de 15 minutos. El intervalo de inactividad de 20 segundos significa que la aplicación incluirá cualquier registro que llegue dentro de los 20 segundos desde el final o inicio de la sesión actual en la sesión actual (activa).
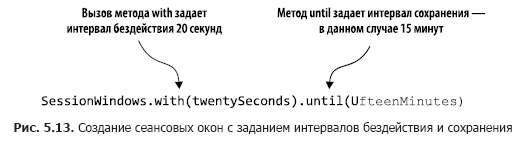
A continuación, indicamos qué operación de agregación se debe realizar en la ventana de sesión: en este caso, contar. Si el registro de entrada sale del intervalo de inactividad (por cualquiera de los lados de la marca de fecha/hora), la aplicación crea una nueva sesión. El intervalo de retención significa mantener la sesión durante un tiempo determinado y permite datos tardíos que salen del período de inactividad de la sesión, pero que aún pueden ser agregados. Además, el inicio y el final de una nueva sesión, resultante de la fusión, corresponden a la marca de fecha/hora más temprana y más tardía.
Veamos algunos registros del método count para entender cómo funcionan las sesiones (Tabla 5.1).
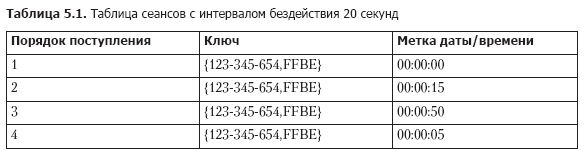
Al recibir registros, buscamos sesiones existentes con la misma clave, donde el tiempo de finalización es menor que la marca de fecha/hora actual — intervalo de inactividad — y el tiempo de inicio es mayor que la marca de fecha/hora actual más el intervalo de inactividad. Teniendo en cuenta esto, cuatro registros de la Tabla 5.1 se fusionan en una sola sesión de la siguiente manera.
1. Primero llega el registro 1, así que el tiempo de inicio es igual al tiempo de finalización y es 00:00:00.
2. Luego llega el registro 2, y buscamos sesiones que finalicen no antes de las 23:59:55 y que comiencen no más tarde de las 00:00:35. Encontramos el registro 1 y fusionamos las sesiones 1 y 2. Tomamos el tiempo de inicio de la sesión 1 (el más temprano) y el tiempo de finalización de la sesión 2 (el más tardío), por lo que nuestra nueva sesión comienza a las 00:00:00 y finaliza a las 00:00:15.
3. Llega el registro 3, buscamos sesiones entre las 00:00:30 y las 00:01:10 y no encontramos ninguna. Agregamos una segunda sesión para la clave 123-345-654,FFBE, que comienza y termina a las 00:00:50.
4. Llega el registro 4, y buscamos sesiones entre las 23:59:45 y las 00:00:25. Esta vez encontramos ambas sesiones: 1 y 2. Las tres sesiones se fusionan en una, con un tiempo de inicio de 00:00:00 y un tiempo de finalización de 00:00:15.
De lo expuesto en esta sección, es importante recordar los siguientes matices:
- las sesiones no son ventanas de tamaño fijo. La duración de la sesión se determina por la actividad dentro del intervalo de tiempo establecido;
- las marcas de fecha/hora en los datos determinan si un evento entra en una sesión existente o en el intervalo de inactividad.
A continuación, discutiremos la siguiente variante de ventanas: las ventanas "rodantes".
Ventanas "rodantes"
Las ventanas «rodantes» (tumbling) capturan eventos que ocurren en un intervalo de tiempo específico. Imagina que necesitas capturar todas las transacciones bursátiles de una empresa cada 20 segundos, así que recopilas todos los eventos durante ese intervalo. Al final del intervalo de 20 segundos, la ventana «rueda» y pasa a un nuevo intervalo de observación de 20 segundos. La Figura 5.14 ilustra esta situación.
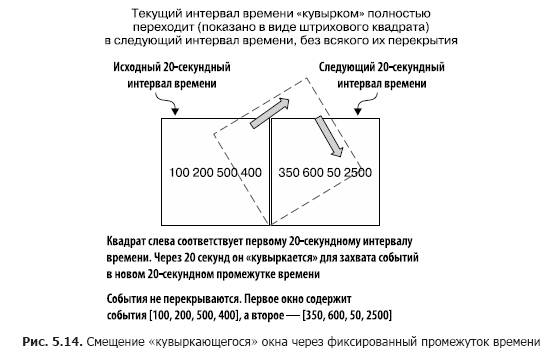
Como puedes ver, todos los eventos que llegaron en los últimos 20 segundos están incluidos en la ventana. Al final de este período, se crea una nueva ventana.
En la Listado 5.6, se muestra el código que demuestra el uso de ventanas «rodantes» para capturar cada 20 segundos las transacciones bursátiles (se puede encontrar en el archivo src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
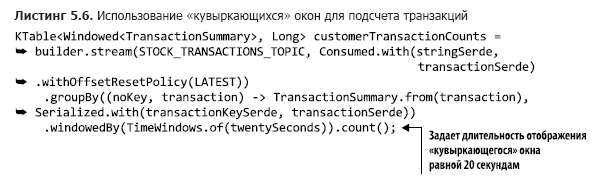
Gracias a este pequeño cambio en la llamada al método TimeWindows.of, se puede usar una ventana «rodante». En este ejemplo, no hay llamada al método until(), por lo que se utilizará el intervalo de retención predeterminado de 24 horas.
Finalmente, es hora de pasar a la última de las opciones de ventanas: las ventanas «deslizantes» (hopping).
Ventanas deslizantes («hopping»)
Las ventanas deslizantes/«hopping» (sliding/hopping) son similares a las «rodantes», pero con una pequeña diferencia. Las ventanas deslizantes no esperan a que termine el intervalo de tiempo antes de crear una nueva ventana para procesar eventos recientes. Inician nuevos cálculos después de un intervalo de espera que es menor que la duración de la ventana.
Para ilustrar las diferencias entre las ventanas «rodantes» y las «deslizantes», volvamos al ejemplo de contar transacciones bursátiles. Nuestro objetivo sigue siendo contar el número de transacciones, pero no queremos esperar todo el intervalo de tiempo antes de actualizar el contador. En cambio, vamos a actualizar el contador a intervalos más cortos de tiempo. Por ejemplo, seguiremos contando el número de transacciones cada 20 segundos, pero actualizaremos el contador cada 5 segundos, como se muestra en la Fig. 5.15. Esto nos da tres ventanas de resultados con datos superpuestos.
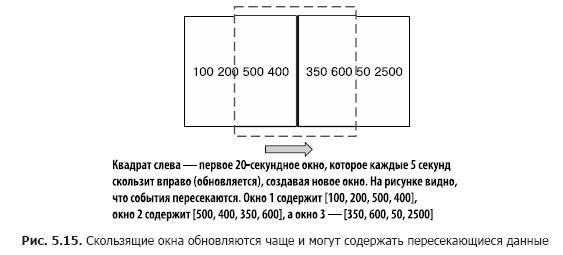
En la Listado 5.7, se proporciona el código para definir ventanas deslizantes (se puede encontrar en el archivo src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
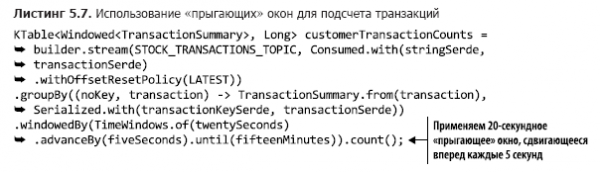
Una ventana «rebotante» puede transformarse en una ventana «saltadora» añadiendo la llamada al método advanceBy(). En el ejemplo proporcionado, el intervalo de retención es de 15 minutos.
En esta sección, hemos visto cómo limitar los resultados de la agregación mediante ventanas temporales. En particular, me gustaría que recordaras las siguientes tres cosas de esta sección:
- el tamaño de las ventanas de sesión no está limitado por el intervalo de tiempo, sino por la actividad de los usuarios;
- las ventanas «rebotantes» brindan una visión de los eventos dentro de un periodo de tiempo determinado;
- la duración de las ventanas «saltadoras» es fija, pero se actualizan con frecuencia y pueden contener registros superpuestos en todas las ventanas.
A continuación, veremos cómo convertir KTable de nuevo en KStream para realizar un join.
5.3.3. Join de objetos KStream y KTable
En el capítulo 4 discutimos cómo unir dos objetos KStream. Ahora aprenderemos a unir KTable y KStream. Esto puede ser necesario por la siguiente razón sencilla. KStream es un flujo de registros, y KTable es un flujo de actualizaciones de registros, pero a veces puede ser necesario agregar un contexto adicional al flujo de registros mediante actualizaciones de KTable.
Tomemos los datos sobre el número de transacciones bursátiles y los unamos con las noticias bursátiles de las correspondientes industrias. Esto es lo que debemos hacer para lograrlo, considerando el código ya existente.
- Convertir el objeto KTable con datos sobre el número de transacciones bursátiles en KStream, reemplazando la clave por una clave que indique la industria correspondiente a dicho símbolo de acciones.
- Crear un objeto KTable que lea datos del tema con las noticias bursátiles. Este nuevo KTable será categorizado por industrias.
- Unir actualizaciones de noticias con información sobre el número de transacciones bursátiles por industria.
Ahora veamos cómo implementar este plan de acción.
Conversión de KTable a KStream
Para convertir KTable a KStream, es necesario hacer lo siguiente.
- Llamar al método KTable.toStream().
- Usando la llamada al método KStream.map, reemplazar la clave con el nombre de la industria, después extraer del objeto Windowed el objeto TransactionSummary.
Vincularemos estas operaciones en una cadena de la siguiente manera (el código se puede encontrar en el archivo src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listado 5.8).
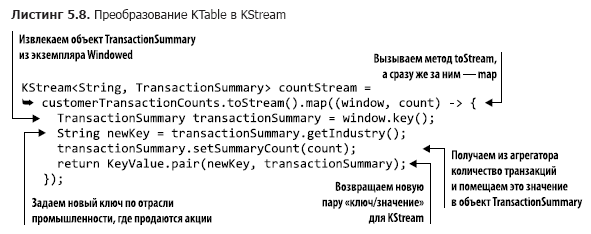
Dado que estamos realizando la operación KStream.map, el reagrupamiento para la instancia KStream devuelta se realiza automáticamente cuando se utiliza en una unión.
Hemos completado el proceso de transformación, ahora necesitamos crear un objeto KTable para leer las noticias de la bolsa.
Creación de KTable para noticias de la bolsa
Afortunadamente, para crear un objeto KTable es suficiente una línea de código (este código se puede encontrar en el archivo src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listado 5.9).
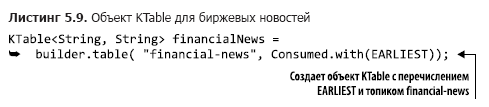
Cabe destacar que no es necesario especificar ningún objeto Serde, ya que se utilizan Serde de cadenas en la configuración. Además, gracias al uso de la enumeración EARLIEST, la tabla se llena con registros desde el principio.
Ahora podemos pasar al paso final: la unión.
Unión de actualizaciones de noticias con datos sobre el número de transacciones
La creación de la unión no presenta dificultades. Usaremos una unión izquierda en caso de que no haya noticias de bolsa para la industria correspondiente (el código necesario se puede encontrar en el archivo src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listado 5.10).
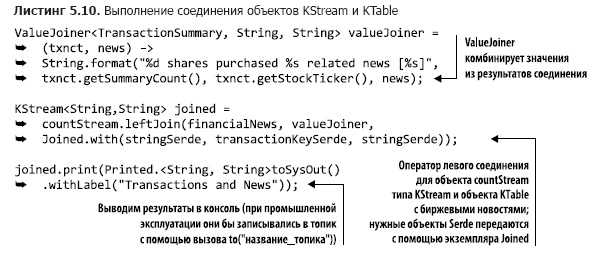
Este operador leftJoin es bastante simple. A diferencia de las uniones del capítulo 4, el método JoinWindow no se utiliza, ya que al realizar la unión KStream-KTable hay solo un registro por clave en KTable. Esta unión no está restringida por el tiempo: un registro está presente en KTable o no. La conclusión principal es que los objetos KTable pueden enriquecer KStream con datos de referencia que se actualizan con menos frecuencia.
Ahora consideraremos un método más eficiente para enriquecer los eventos de KStream.
5.3.4. Objetos GlobalKTable
Como habrás entendido, existe la necesidad de enriquecer los flujos de eventos o agregarles contexto. En el capítulo 4 viste uniones de dos objetos KStream, y en la sección anterior, la unión de KStream y KTable. En todos estos casos, es necesario reagrupamiento del flujo de datos al mapear claves a un nuevo tipo o valor. A veces, el reagrupamiento se realiza explícitamente, y otras veces Kafka Streams lo hace automáticamente. El reagrupamiento es necesario porque las claves han cambiado y los registros deben estar en nuevas secciones; de lo contrario, la unión será imposible (esto se discutió en el capítulo 4, en el apartado "Reagrupamiento de datos" de la subsección 4.2.4).
La re-segmentación tiene su precio
La re-segmentación requiere costos: costos adicionales de recursos para crear temas intermedios, mantener datos duplicados en otro tema; también significa un aumento en la latencia debido a la escritura y lectura de este tema. Además, si es necesario realizar una unión en más de un aspecto o dimensión, se deben organizar las uniones en cadena, reflejar los registros con nuevas claves y volver a realizar el proceso de re-segmentación.
Uniones con conjuntos de datos más pequeños
En algunos casos, el volumen de datos de referencia con los que se planea hacer la unión es relativamente pequeño, por lo que las copias completas pueden caber localmente en cada uno de los nodos. Para tales situaciones, Kafka Streams proporciona la clase GlobalKTable.
Las instancias de GlobalKTable son únicas, ya que la aplicación replica todos los datos en cada uno de los nodos. Y dado que todos los nodos tienen todos los datos, no es necesario segmentar el flujo de eventos por la clave de los datos de referencia para que esté disponible para todas las secciones. A través de los objetos GlobalKTable también se pueden realizar uniones sin clave. Regresamos a uno de los ejemplos anteriores para demostrar esta capacidad.
Unión de objetos KStream con objetos GlobalKTable
En la subsección 5.3.2 realizamos una agregación en ventana de transacciones bursátiles por clientes. Los resultados de esta agregación se veían aproximadamente así:
{customerId='074-09-3705', stockTicker='GUTM'}, 17
{customerId='037-34-5184', stockTicker='CORK'}, 16
Aunque estos resultados cumplían con el objetivo establecido, sería más conveniente si también se mostrara el nombre del cliente y el nombre completo de la empresa. Para agregar el nombre del comprador y el nombre de la empresa, se pueden realizar uniones normales, pero eso requeriría hacer dos mapeos de claves y re-segmentación. Con GlobalKTable se pueden evitar los costos de tales operaciones.
Para ello, utilizaremos el objeto countStream del listado 5.11 (el código correspondiente se puede encontrar en el archivo src/main/java/bbejeck/chapter_5/GlobalKTableExample.java), uniéndolo con dos objetos GlobalKTable.
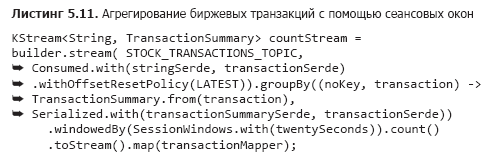
Ya hemos discutido esto antes, así que no me repetiré. Pero señalaré que el código en la función toStream().map está abstraído en un objeto-función para mejorar la legibilidad, en lugar de usar una expresión lambda incrustada.
El siguiente paso es declarar dos instancias de GlobalKTable (el código correspondiente se puede encontrar en el archivo src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (listado 5.12).
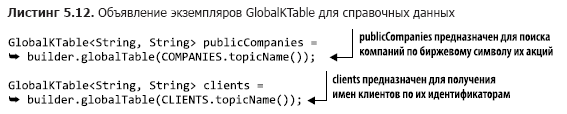
Tenga en cuenta que los nombres de los temas se describen utilizando tipos enumerados.
Ahora que hemos preparado todos los componentes, solo queda escribir el código para la conexión (que se puede encontrar en el archivo src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (listado 5.13).
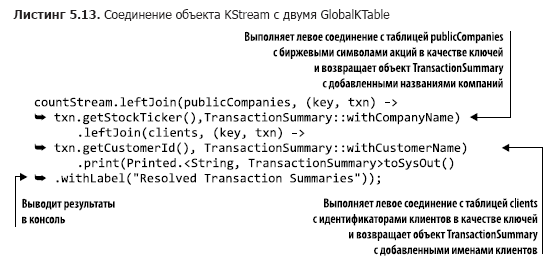
Aunque hay dos uniones en este código, están organizadas en forma de cadena, ya que por separado no se utiliza ninguno de sus resultados. Los resultados se muestran al final de toda la operación.
Al ejecutar la operación de unión mencionada, obtendrá resultados de la siguiente forma:
{customer='Barney, Smith' company="Exxon", transactions= 17}La esencia no ha cambiado, pero estos resultados son más claros.
Si contamos el capítulo 4, ya ha visto varios tipos de uniones en acción. Se enumeran en la tabla 5.2. Esta tabla refleja las capacidades de unión relevantes para la versión 1.0.0 de Kafka Streams; en futuras versiones, puede que algo cambie.
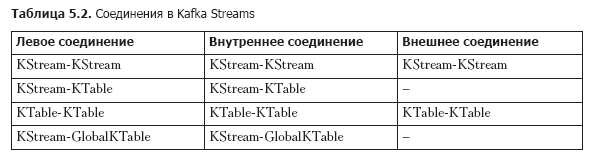
En conclusión, recordaré lo básico: puede unir flujos de eventos (KStream) y flujos de actualizaciones (KTable) utilizando un estado local. Además, si el tamaño de los datos de referencia no es demasiado grande, puede utilizar el objeto GlobalKTable. GlobalKTable replica todas las particiones en cada uno de los nodos de la aplicación Kafka Streams, lo que garantiza la disponibilidad de todos los datos sin importar qué partición corresponda a la clave.
A continuación, veremos una capacidad de Kafka Streams que permite observar cambios en el estado sin consumir datos del tema de Kafka.
5.3.5. Estado disponible para consultas
Ya hemos realizado varias operaciones que involucran estado y siempre hemos mostrado los resultados en la consola (con fines de desarrollo) o los hemos grabado en un tema (con fines de producción). Al grabar resultados en un tema, es necesario usar un consumidor de Kafka para verlos.
Leer datos de estos temas puede considerarse una forma de vistas materializadas. Para nuestros propósitos, podemos usar la definición de vista materializada de "Wikipedia": "...un objeto físico en la base de datos que contiene los resultados de la ejecución de una consulta. Por ejemplo, puede ser una copia local de datos remotos, o un subconjunto de filas y/o columnas de una tabla o de los resultados de un join, o una tabla agregada obtenida mediante agregación" (https://en.wikipedia.org/wiki/Materialized_view).
Kafka Streams también permite realizar consultas interactivas a los almacenes de estado, lo que da la posibilidad de leer directamente estas vistas materializadas. Es importante destacar que la consulta al almacén de estado es una operación de 'solo lectura'. Gracias a esto, no tienes que preocuparte por hacer que el estado sea inconsistente durante el procesamiento de datos por la aplicación.
La posibilidad de realizar consultas directas a los almacenes de estado es de gran importancia. Significa que se pueden crear aplicaciones, como paneles de control, sin necesidad de obtener primero los datos del consumidor de Kafka. También aumenta la eficiencia de la aplicación, ya que no es necesario volver a escribir los datos:
- gracias a la localización de los datos, se puede acceder a ellos rápidamente;
- se elimina la duplicación de datos, ya que no se almacenan en un almacén externo.
Lo principal que me gustaría que recordaras: puedes realizar consultas directamente sobre el estado desde la aplicación. No se puede subestimar las posibilidades que esto te brinda. En lugar de consumir datos de Kafka y almacenar registros en la base de datos para la aplicación, se pueden realizar consultas a los almacenes de estado con el mismo resultado. Las consultas directas a los almacenes de estado significan menos código (sin consumidor) y menos software (sin necesidad de una tabla de base de datos para almacenar los resultados).
Hemos cubierto una cantidad considerable de información en este capítulo, así que por ahora dejaremos de lado nuestra discusión sobre consultas interactivas a los almacenes de estado. Pero no se preocupen: en el capítulo 9 crearemos una aplicación sencilla: un panel informativo con consultas interactivas. Para demostrar las consultas interactivas y las posibilidades de su incorporación en aplicaciones de Kafka Streams, utilizaremos algunos de los ejemplos de este y del capítulo anterior.
Currículum
- Los objetos KStream representan flujos de eventos, similares a inserciones en una base de datos. Los objetos KTable representan flujos de actualizaciones, siendo más parecidos a las actualizaciones en una base de datos. El tamaño de un objeto KTable no crece, las entradas antiguas son reemplazadas por las nuevas.
- Los objetos KTable son necesarios para las operaciones de agregación.
- Con las operaciones de ventana se pueden segmentar los datos agregados en cubos temporales.
- Gracias a los objetos GlobalKTable se puede acceder a los datos de referencia en cualquier parte de la aplicación, independientemente de la partición por secciones.
- Es posible realizar uniones entre objetos KStream, KTable y GlobalKTable.
Hasta ahora nos hemos centrado en crear aplicaciones de Kafka Streams utilizando el DSL KStream de alto nivel. Aunque el enfoque de alto nivel permite escribir programas ordenados y concisos, su uso implica un cierto compromiso. Trabajar con el DSL KStream significa aumentar la concisión del código a costa de reducir el control. En el siguiente capítulo abordaremos la API de bajo nivel de los nodos procesadores y exploraremos otros compromisos. Los programas serán más largos que los que hemos visto hasta ahora, pero tendremos la capacidad de crear prácticamente cualquier nodo procesador que podamos necesitar.
→ Para más detalles, se puede consultar el libro en
→ Para los habitantes de Habr, un 25% de descuento con el cupón — Kafka Streams
→ Tras el pago de la versión impresa del libro, se enviará un libro electrónico por correo electrónico.
Fuente: habr.com
