

El seguimiento de conexiones ("conntrack") es una función fundamental de la pila de red del núcleo de Linux. Permite al núcleo rastrear todas las conexiones o flujos de red lógicos, identificando así todos los paquetes que componen cada flujo para que puedan ser procesados secuencialmente juntos.
Conntrack es una función importante del núcleo que se utiliza en algunos casos clave:
- NAT se basa en la información de conntrack, por lo que puede manejar todos los paquetes de un flujo de manera uniforme. Por ejemplo, cuando un pod accede a un servicio de Kubernetes, el equilibrador de carga kube-proxy utiliza NAT para dirigir el tráfico a un pod específico dentro del clúster. Conntrack registra que para una conexión determinada, todos los paquetes al IP del servicio deben enviarse al mismo pod, y que los paquetes devueltos por el pod de backend deben ser dirigidos de vuelta por NAT al pod que hizo la solicitud.
- Los firewalls con seguimiento de estado, como Calico, se basan en la información de conntrack para agregar el tráfico "de respuesta" a la lista blanca. Esto te permite escribir una política de red que diga: "permite a mi pod conectarse a cualquier IP remota" sin necesidad de escribir una política que permita explícitamente el tráfico de respuesta. (Sin esto, tendrías que agregar una regla mucho menos segura que diga "permitir paquetes a mi pod desde cualquier IP").
Además, conntrack generalmente mejora el rendimiento del sistema (reduciendo el consumo de tiempo de CPU y la latencia de los paquetes), ya que solo el primer paquete en el flujo
debe pasar por el procesamiento completo de la pila de red para determinar qué hacer con él. Consulta el post "" para ver un ejemplo de cómo funciona.
Sin embargo, conntrack tiene sus limitaciones...
Entonces, ¿dónde salió mal?
La tabla conntrack tiene un tamaño máximo configurable, y si se llena, las conexiones suelen comenzar a ser rechazadas o interrumpidas. Para manejar el tráfico de la mayoría de las aplicaciones, generalmente hay suficiente espacio libre en la tabla y nunca se convierte en un problema. Sin embargo, hay algunos escenarios en los que vale la pena considerar el uso de la tabla conntrack:
- El caso más evidente es cuando su servidor maneja una cantidad extremadamente alta de conexiones activas simultáneamente. Por ejemplo, si su tabla conntrack está configurada para 128k entradas, pero tiene más de 128k conexiones simultáneas, seguramente experimentará problemas.
- Un caso un poco menos obvio es cuando su servidor maneja un gran número de conexiones por segundo. Incluso si las conexiones son breves, Linux continúa rastreándolas durante un período de tiempo (por defecto 120s). Por ejemplo, si su tabla conntrack está configurada para 128 mil entradas y está intentando manejar 1100 conexiones por segundo, excederá el tamaño de la tabla conntrack, incluso si las conexiones son muy efímeras (128k / 120s = 1092 conexiones / s).
Hay varios tipos de aplicaciones de nicho que caen en estas categorías. Además, si tiene muchos atacantes, llenar la tabla conntrack de su servidor con muchas conexiones medio abiertas puede utilizarse en un ataque de tipo 'denegación de servicio' (DOS). En ambos casos, conntrack puede convertirse en un cuello de botella en su sistema. En algunos casos, ajustar los parámetros de la tabla conntrack puede ser suficiente para satisfacer sus necesidades, aumentando el tamaño o reduciendo los tiempos de espera de conntrack (pero si lo hace incorrectamente, encontrará grandes dificultades). Para otros casos, será necesario eludir conntrack para el tráfico agresivo.
Ejemplo real
Tomemos un ejemplo concreto: un importante proveedor de SaaS con el que trabajamos tenía una serie de servidores memcached en hosts (no en máquinas virtuales), cada uno de los cuales manejaba más de 50k conexiones breves por segundo.
Experimentaron con la configuración de conntrack, aumentando los tamaños de las tablas y reduciendo el tiempo de seguimiento, pero la configuración era inestable, lo que aumentó significativamente el consumo de RAM, lo cual fue un problema (¡cerca de GB!), y las conexiones eran tan cortas que conntrack no generaba su habitual mejora en el rendimiento (reducción del uso de CPU o de la latencia de los paquetes).
Como alternativa, se dirigieron a Calico. Las políticas de red de Calico permiten no utilizar conntrack para un tipo específico de tráfico (utilizando la opción doNotTrack para las políticas). Esto les proporcionó el nivel de rendimiento necesario más un nivel adicional de seguridad proporcionado por Calico.
¿Qué medidas se deben tomar para eludir conntrack?
- Las políticas de red do-not-track generalmente deben ser simétricas. En el caso de un proveedor SaaS: sus aplicaciones funcionaban dentro de una zona protegida y, por lo tanto, mediante una política de red podían poner en la lista blanca el tráfico de otras aplicaciones específicas que se les permitía acceder a memcached.
- La política do-not-track no considera la dirección de la conexión. Así, en caso de un ataque al servidor de memcached, teóricamente se podría intentar conectar a cualquiera de los clientes de memcached, siempre que utilice el puerto de origen correcto. Sin embargo, si has definido correctamente la política de red para tus clientes de memcached, esos intentos de conexión aún serán rechazados del lado del cliente.
- La política do-not-track se aplica a cada paquete, a diferencia de las políticas normales que solo se aplican al primer paquete de un flujo. Esto puede aumentar el consumo de recursos de CPU por paquete, ya que se debe aplicar una política a cada paquete. Pero para conexiones de corta duración, este gasto se compensa con la reducción del consumo de recursos en el manejo de conntrack. Por ejemplo, en el caso de un proveedor SaaS, el número de paquetes por conexión fue muy bajo, por lo que el consumo adicional de recursos de CPU al aplicar políticas a cada paquete estaba justificado.
Comencemos las pruebas
Realizamos una prueba en un pod con el servidor de memcached y múltiples pods de clientes de memcached, ejecutados en nodos remotos, de modo que pudiéramos ejecutar una gran cantidad de conexiones por segundo. El servidor con el pod del servidor de memcached tenía 8 núcleos y 512k entradas en la tabla de conntrack (tamaño predeterminado de la tabla para el host).
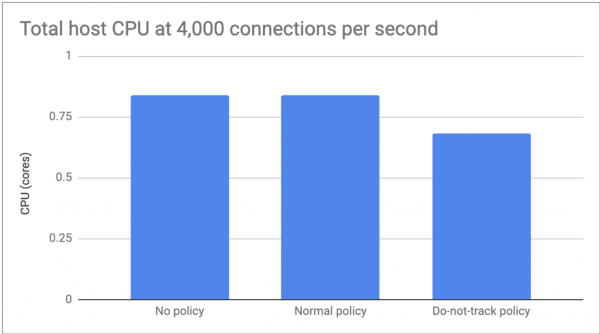
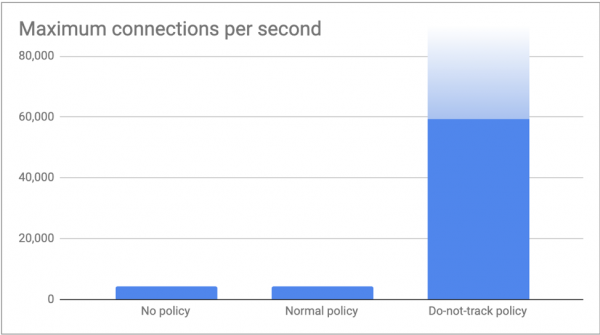
Medimos la diferencia en rendimiento entre: sin política de red; con una política normal de Calico; y con la política Calico do-not-track.
Para la primera prueba, hemos establecido el número de conexiones en 4,000 por segundo, por lo que pudimos centrarnos en la diferencia en el consumo de CPU. No hubo diferencias significativas entre la ausencia de política y la política normal, pero la política de no rastrear incrementó el consumo de CPU en aproximadamente un 20%.
En la segunda prueba, lanzamos tantas conexiones como nuestros clientes podían generar y medimos el número máximo de conexiones por segundo que podía manejar nuestro servidor memcached. Como era de esperar, en el caso de "sin políticas" y "política normal" ambos alcanzaron el límite de conntrack de más de 4,000 conexiones por segundo (512k / 120s = 4,369 conexiones/s). Con la política de no rastrear, nuestros clientes enviaron 60,000 conexiones por segundo sin ningún problema. Estamos seguros de que podríamos aumentar este número conectando más clientes, pero sentimos que estas cifras ya son suficientes para ilustrar el mensaje de este artículo.
Conclusión
Conntrack es una función importante del núcleo. Hace su trabajo de manera excepcional. A menudo es utilizado por componentes clave del sistema. Sin embargo, en ciertos escenarios, la sobrecarga debido a conntrack supera las ventajas normales que proporciona. En este escenario, las políticas de red de Calico pueden utilizarse para desactivar selectivamente el uso de conntrack, mejorando al mismo tiempo el nivel de seguridad de la red. Para todo el resto del tráfico, conntrack sigue siendo tu aliado.
También lee otros artículos en nuestro blog:
Fuente: habr.com
