

Hace un tiempo, nos enfrentamos a la cuestión de elegir una herramienta ETL para trabajar con BigData. La solución previamente utilizada, Informatica BDM, no cumplía con nuestras expectativas debido a su funcionalidad limitada. Su uso se redujo a un marco para ejecutar comandos spark-submit. En el mercado no había muchos análogos capaces de manejar el volumen de datos con el que lidiamos a diario. Finalmente, elegimos Ab Initio. Durante las demostraciones piloto, el producto mostró una velocidad de procesamiento de datos muy alta. Casi no hay información sobre Ab Initio en ruso, por lo que decidimos compartir nuestra experiencia en Habr.
Ab Initio cuenta con numerosas transformaciones clásicas y peculiares, cuyo código puede ser ampliado mediante su propio lenguaje PDL. Para pequeñas empresas, esta poderosa herramienta probablemente será excesiva, y la mayoría de sus capacidades pueden resultar costosas y poco utilizadas. Pero si tus escalas se asemejan a las de Sberbank, Ab Initio puede ser de interés para ti.
Ayuda al negocio a acumular conocimientos a nivel global y a desarrollar un ecosistema, al mismo tiempo que permite al desarrollador mejorar sus habilidades en ETL, adquirir conocimientos en shell, proporciona la oportunidad de aprender el lenguaje PDL, ofrece una representación visual de los procesos de carga y simplifica el desarrollo gracias a la abundancia de componentes funcionales.
En esta publicación, hablaré sobre las capacidades de Ab Initio y proporcionaré características comparativas de su funcionamiento con Hive y GreenPlum.
- Descripción del marco MDW y el trabajo para su ajuste bajo GreenPlum.
- Características comparativas del rendimiento de Ab Initio en su trabajo con Hive y GreenPlum.
- Funcionamiento de Ab Initio con GreenPlum en modo Near Real Time.
La funcionalidad de este producto es muy amplia y requiere tiempo para su estudio. Sin embargo, con las habilidades adecuadas y la correcta configuración del rendimiento, los resultados del procesamiento de datos son realmente impresionantes. El uso de Ab Initio puede ofrecer al desarrollador una experiencia interesante. Es una nueva visión del desarrollo ETL, un híbrido entre un entorno visual y el desarrollo de cargas en un lenguaje parecido a scripts.
Las empresas desarrollan sus ecosistemas y esta herramienta resulta más oportuna que nunca para ellos. Con Ab Initio, se puede acumular conocimiento sobre el negocio actual y utilizar ese conocimiento para expandir los negocios existentes y abrir nuevos. Las alternativas a Ab Initio incluyen entornos de desarrollo visual como Informatica BDM y entornos no visuales como Apache Spark.
Descripción de Ab Initio
Ab Initio, al igual que otras herramientas ETL, es un conjunto de productos.
Ab Initio GDE (Graphical Development Environment) es el entorno para el desarrollador donde configura las transformaciones de datos y las conecta mediante flujos de datos representados por flechas. Un conjunto de esas transformaciones se llama grafo:
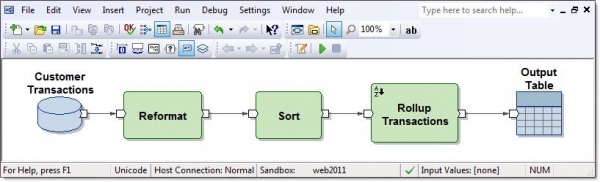
Las conexiones de entrada y salida de los componentes funcionales son puertos y contienen campos calculados dentro de las transformaciones. Varios grafos conectados por flujos en forma de flechas en el orden en que se ejecutan se llaman plan.
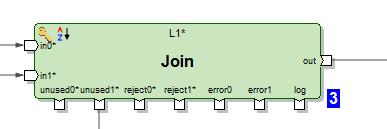
Existen varios cientos de componentes funcionales, lo que es muy significativo. Muchos de ellos son de especialización estrecha. Las capacidades de las transformaciones clásicas en Ab Initio son más amplias que en otras herramientas ETL. Por ejemplo, Join tiene varias salidas. Además del resultado de la fusión de conjuntos de datos, se pueden obtener entradas de los conjuntos de datos de entrada que no han podido fusionarse. También se pueden obtener rechazos, errores y un registro del funcionamiento de la transformación que se puede leer en este mismo grafo como un archivo de texto y procesar con otras transformaciones:
O, por ejemplo, se puede materializar el receptor de datos en forma de tabla y en este mismo grafo leer datos desde ella.
Existen transformaciones originales. Por ejemplo, la transformación Scan tiene funcionalidad similar a la de funciones analíticas. Hay transformaciones con nombres significativos: Create Data, Read Excel, Normalize, Sort within Groups, Run Program, Run SQL, Join with DB, entre otras. Los grafos pueden utilizar parámetros de tiempo de ejecución, lo que incluye la posibilidad de pasar parámetros del sistema operativo o a él. Los archivos con un conjunto listo de parámetros a pasar al grafo se llaman parameter sets (psets).
Como corresponde, Ab Initio GDE tiene su propio repositorio, denominado EME (Enterprise Meta Environment). Los desarrolladores tienen la posibilidad de trabajar con versiones locales del código y realizar check-in de sus desarrollos en el repositorio central.
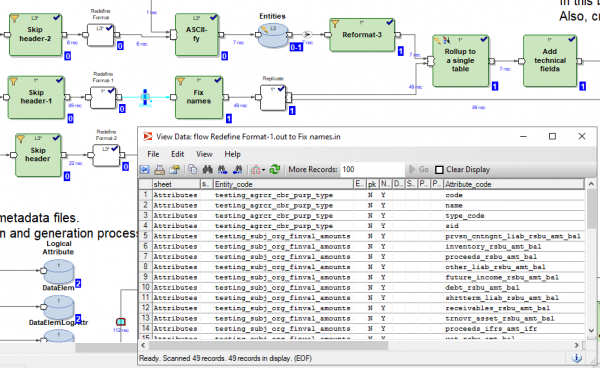
Es posible hacer clic en cualquier conexión de transformación del gráfico durante o después de la ejecución y ver los datos que pasaron entre estas transformaciones:
También hay la opción de hacer clic en cualquier flujo y ver los detalles de seguimiento: cuántas paralelas estaban trabajando en la transformación, cuántas filas y bytes se cargaron en cada una de las paralelas:
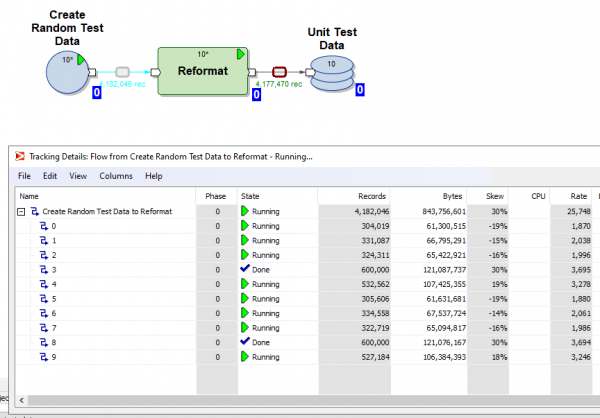
Es posible dividir la ejecución del gráfico en fases y marcar qué transformaciones deben ejecutarse primero (en la fase cero), las siguientes en la primera fase, las siguientes en la segunda fase, etc.
Para cada transformación se puede elegir un llamado layout (donde se ejecutará): sin paralelas o en flujos paralelos, cuya cantidad se puede especificar. Al mismo tiempo, los archivos temporales que crea Ab Initio al trabajar con las transformaciones se pueden almacenar tanto en el sistema de archivos servidores, como en HDFS.
En cada transformación basada en la plantilla por defecto se puede crear un script propio en el lenguaje PDL, que se asemeja un poco a shell.
A través del lenguaje PDL se pueden ampliar las funcionalidades de las transformaciones y, en particular, se pueden generar dinámicamente (durante la ejecución) fragmentos de código arbitrarios en función de los parámetros de tiempo de ejecución.
Además, Ab Initio tiene una buena integración con el sistema operativo a través de shell. En particular, en Sberbank se utiliza linux ksh. Se pueden intercambiar variables con shell y usarlas como parámetros de los gráficos. Se puede invocar la ejecución de gráficos de Ab Initio desde shell y administrar Ab Initio.
Además de Ab Initio GDE, se incluyen muchos otros productos en la entrega. Existe un sistema propio llamado Co>Operation System que pretende ser un sistema operativo. Hay Control>Center, donde se pueden programar y monitorear los flujos de carga. Existen productos para realizar desarrollo en un nivel más primitivo que lo que permite Ab Initio GDE.
Descripción del marco MDW y el trabajo para su ajuste bajo GreenPlum.
Junto con sus productos, el proveedor entrega el producto MDW (Metadata Driven Warehouse), que es un configurador de gráficos diseñado para ayudar en tareas típicas de llenado de almacenes de datos o data vaults.
Contiene analizadores de metadatos personalizados (específicos del proyecto) y generadores de código listos para usar 'out of the box'.
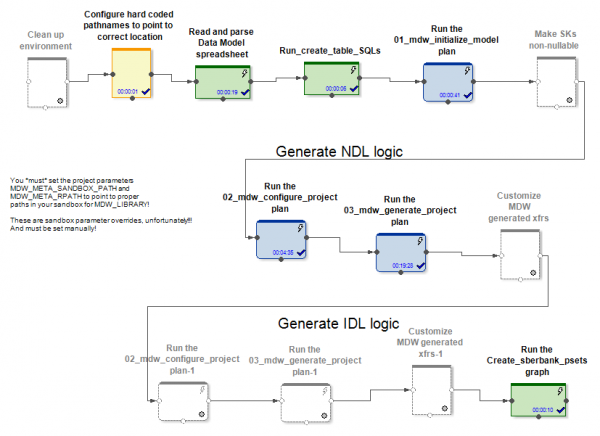
MDW recibe un modelo de datos, un archivo de configuración para la conexión a la base de datos (Oracle, Teradata o Hive) y algunas otras configuraciones. La parte específica del proyecto, por ejemplo, despliega el modelo en la base de datos. La parte estándar del producto genera gráficos y archivos de configuración para ellos al cargar datos en las tablas del modelo. Se crean gráficos (y psets) para varios modos de trabajo inicial e incremental para la actualización de entidades.
En los casos de Hive y RDBMS se generan gráficos diferentes para la actualización de datos inicial e incremental.
En el caso de Hive, los datos delta recibidos se combinan mediante Ab Initio Join con los datos que estaban en la tabla antes de la actualización. Los cargadores de datos en MDW (tanto en Hive como en RDBMS) no solo insertan nuevos datos de la delta, sino que también cierran los períodos de validez de los datos, basándose en las claves primarias de las cuales se recibió la delta. Además, es necesario reescribir de nuevo la parte de los datos que no ha cambiado. Pero esto es necesario, ya que Hive no tiene operaciones de eliminación o actualización.
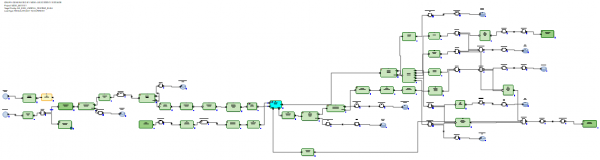
En el caso de RDBMS, los gráficos para la actualización incremental de datos son más óptimos, porque los RDBMS tienen capacidades reales de actualización.
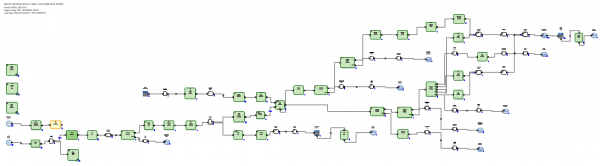
La delta recibida se carga en una tabla intermedia en la base de datos. Después, se conecta la delta con los datos que estaban en la tabla antes de la actualización. Esto se hace a través de SQL mediante una consulta SQL generada. A continuación, usando los comandos SQL de eliminar e insertar en la tabla objetivo, se inserta nueva información desde la delta y se cierran los períodos de validez de los datos, basándose en las claves primarias de las que se recibió la delta.
No es necesario reescribir los datos que no han cambiado.
Así, llegamos a la conclusión de que en el caso de Hive, MDW debe optar por reescribir toda la tabla, porque Hive no tiene una función de actualización. No se ha encontrado una mejor solución que la reescritura total de los datos al actualizar. En el caso de RDBMS, por el contrario, los creadores del producto decidieron confiar la conexión y actualización de las tablas al uso de SQL.
Para el proyecto en Sberbank, creamos una nueva implementación reutilizable del cargador de bases de datos para GreenPlum. Esto se basó en la versión generada por MDW para Teradata. Teradata, y no Oracle, resultó ser la opción más adecuada, ya que también es un sistema MPP. Los métodos de trabajo, así como la sintaxis de Teradata y GreenPlum resultaron ser similares.
Ejemplos de diferencias críticas para MDW entre diferentes RDBMS son los siguientes. En GreenPlum, a diferencia de Teradata, al crear tablas es necesario escribir la cláusula
distributed byEn Teradata se escribe
delete <table> todo, mientras que en GreenPlum se escribe
eliminar de <table>En Oracle, para optimización se escribe
delete from t where rowid in (), mientras que en Teradata y GreenPlum se escribe
delete from t where exists (select * from delta where delta.pk=t.pk)Además, cabe señalar que para el funcionamiento de Ab Initio con GreenPlum fue necesario instalar el cliente de GreenPlum en todos los nodos del clúster de Ab Initio. Esto se debe a que nos conectamos a GreenPlum simultáneamente desde todos los nodos de nuestro clúster. Para que la lectura desde GreenPlum fuera paralela y cada hilo paralelo de Ab Initio leyera su porción de datos desde GreenPlum, tuvimos que incluir en la sección «where» de las consultas SQL una construcción que Ab Initio entiende
where ABLOCAL()y definir el valor de esta construcción, especificando al transformador que lee de la base de datos el parámetro
ablocal_expr="string_concat(\"mod(t.\", string_filter_out(\"{$TABLE_KEY}\",\"{}\"), \",\", (decimal(3))(number_of_partitions()),\")=\", (decimal(3))(this_partition()))", que se compila en algo como
mod(sk,10)=3, por lo que se tiene que indicar a GreenPlum un filtro explícito para cada partición. Para otras bases de datos (Teradata, Oracle), Ab Initio puede realizar esta paralelización automáticamente.
Características comparativas del rendimiento de Ab Initio en su trabajo con Hive y GreenPlum.
En Sberbank se realizó un experimento para comparar el rendimiento de los gráficos generados por MDW en relación con Hive y GreenPlum. En el marco del experimento, en el caso de Hive había 5 nodos en el mismo clúster que Ab Initio, mientras que en el caso de GreenPlum había 4 nodos en un clúster separado. Es decir, Hive tenía cierta ventaja sobre GreenPlum en términos de hardware.
Se consideraron dos pares de gráficos que realizan la misma tarea de actualización de datos en Hive y en GreenPlum. Se ejecutaron gráficos generados por el configurador de MDW:
- carga inicial + carga incremental de datos generados aleatoriamente en la tabla de Hive
- carga inicial + carga incremental de datos generados aleatoriamente en una tabla equivalente de GreenPlum
En ambos casos (Hive y GreenPlum), se ejecutaron cargas en 10 flujos paralelos en el mismo clúster de Ab Initio. Los datos intermedios para los cálculos de Ab Initio se almacenaron en HDFS (en términos de Ab Initio se utilizó el diseño MFS usando HDFS). Una línea de datos generados aleatoriamente ocupaba en ambos casos 200 bytes.
El resultado fue el siguiente:
Hive:
Carga inicial en Hive
Filas insertadas
6 000 000
60 000 000
600 000 000
Duración de la carga inicial
en segundos
41
203
1 601
Carga incremental en Hive
Cantidad de filas que había en la
tabla de destino al inicio del experimento
6 000 000
60 000 000
600 000 000
Número de filas delta aplicadas a
la tabla de destino durante el experimento
6 000 000
6 000 000
6 000 000
Duración de la carga incremental
en segundos
88
299
2 541
GreenPlum:
Carga inicial en GreenPlum
Filas insertadas
6 000 000
60 000 000
600 000 000
Duración de la carga inicial
en segundos
72
360
3 631
Carga incremental en GreenPlum
Cantidad de filas que había en la
tabla de destino al inicio del experimento
6 000 000
60 000 000
600 000 000
Número de filas delta aplicadas a
la tabla de destino durante el experimento
6 000 000
6 000 000
6 000 000
Duración de la carga incremental
en segundos
159
199
321
Observamos que la velocidad de la carga inicial, tanto en Hive como en GreenPlum, depende linealmente del volumen de datos y, debido a un mejor hardware, es un poco más rápida en Hive que en GreenPlum.
La carga incremental en Hive también depende linealmente del volumen de los datos previamente cargados en la tabla de destino y se lleva a cabo de manera bastante lenta a medida que crece el volumen. Esto se debe a la necesidad de reescribir completamente la tabla de destino. Esto significa que aplicar pequeños cambios a tablas enormes no es una buena opción de uso para Hive.
En cambio, la carga incremental en GreenPlum tiene una baja dependencia del volumen de los datos previamente cargados en la tabla de destino y se lleva a cabo bastante rápido. Esto se logró gracias a los SQL Joins y a la arquitectura de GreenPlum, que permite la operación de eliminación.
Así que, GreenPlum inserta el delta mediante delete+insert, mientras que en Hive no hay operaciones de delete o update, por lo que todo el conjunto de datos durante la actualización incremental tuvo que reescribirse completamente. Lo más notable es la comparación de las celdas en negrita, ya que corresponde al uso más frecuente de cargas intensivas en recursos. Vemos que GreenPlum ganó a Hive en esta prueba por un factor de 8.
Funcionamiento de Ab Initio con GreenPlum en modo Near Real Time.
En este experimento, verificaremos la capacidad de Ab Initio para actualizar la tabla de GreenPlum con porciones de datos generadas aleatoriamente en un modo cercano al tiempo real. Consideraremos la tabla GreenPlum dev42_1_db_usl.TESTING_SUBJ_org_finval, con la que se trabajará.
Usaremos tres gráficos de Ab Initio para trabajar con ella:
1) Gráfico Create_test_data.mp - crea 10 flujos paralelos de archivos con datos en HDFS con 6,000,000 filas. Los datos son aleatorios, su estructura está organizada para insertarse en nuestra tabla.
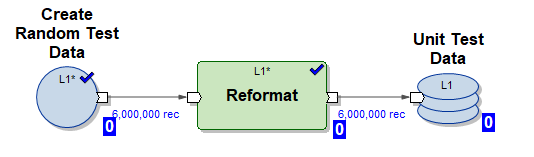
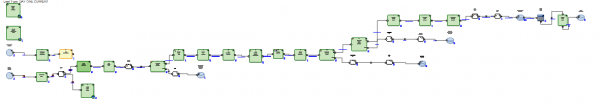
2) Gráfico mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset - gráfico MDW generado para la inserción inicial de datos en nuestra tabla en 10 flujos paralelos (se utilizan datos de prueba generados por el gráfico (1)).
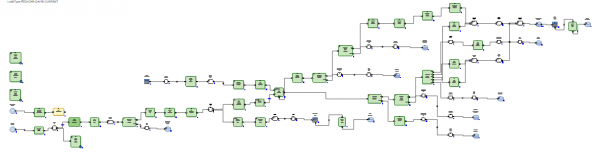
3) Gráfico mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset - gráfico MDW generado para la actualización incremental de nuestra tabla en 10 flujos paralelos utilizando un lote de datos recién recibidos (deltas), generados por el gráfico (1).
Ejecutaremos el siguiente escenario en modo NRT:
- generar 6,000,000 filas de prueba.
- realizar la carga inicial e insertar 6,000,000 filas de prueba en una tabla vacía.
- repetir 5 veces la carga incremental.
- generar 6,000,000 filas de prueba.
- realizar la inserción incremental de 6,000,000 filas de prueba en la tabla (los datos antiguos se les asigna un tiempo de expiración valid_to_ts y se insertan datos más recientes con la misma clave primaria).
Este escenario emula el modo de operación real de un sistema empresarial: en tiempo real, se presenta un volumen significativo de nuevos datos y se inyecta inmediatamente en GreenPlum.
Ahora veamos el registro de ejecución del escenario:
Iniciar Create_test_data.input.pset a las 2020-06-04 11:49:11.
Finalizar Create_test_data.input.pset a las 2020-06-04 11:49:37.
Iniciar mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset a las 2020-06-04 11:49:37.
Finalizar mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset a las 2020-06-04 11:50:42.
Iniciar Create_test_data.input.pset a las 2020-06-04 11:50:42.
Finalizar Create_test_data.input.pset a las 2020-06-04 11:51:06.
Iniciar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset a las 2020-06-04 11:51:06.
Finalizar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset a las 2020-06-04 11:53:41.
Iniciar Create_test_data.input.pset a las 2020-06-04 11:53:41.
Finalizar Create_test_data.input.pset a las 2020-06-04 11:54:04.
Iniciar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset a las 2020-06-04 11:54:04.
Finalizar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset a las 2020-06-04 11:56:51.
Iniciar Create_test_data.input.pset a las 2020-06-04 11:56:51.
Finalizar Create_test_data.input.pset a las 2020-06-04 11:57:14.
Iniciar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset a las 2020-06-04 11:57:14.
Finalizar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset a las 2020-06-04 11:59:55.
Iniciar Create_test_data.input.pset a las 2020-06-04 11:59:55.
Finalizar Create_test_data.input.pset a las 2020-06-04 12:00:23.
Iniciar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset a las 2020-06-04 12:00:23.
Finalizar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset a las 2020-06-04 12:03:23.
Iniciar Create_test_data.input.pset a las 2020-06-04 12:03:23.
Finalizar Create_test_data.input.pset a las 2020-06-04 12:03:49.
Iniciar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset el 2020-06-04 12:03:49
Terminar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset el 2020-06-04 12:06:46
Se observa la siguiente imagen:
Gráfico
Start time
Hora de finalización
Longitud
Create_test_data.input.pset
04.06.2020 11:49:11
04.06.2020 11:49:37
00:00:26
mdw_load.day_one.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:49:37
04.06.2020 11:50:42
00:01:05
Create_test_data.input.pset
04.06.2020 11:50:42
04.06.2020 11:51:06
00:00:24
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:51:06
04.06.2020 11:53:41
00:02:35
Create_test_data.input.pset
04.06.2020 11:53:41
04.06.2020 11:54:04
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:54:04
04.06.2020 11:56:51
00:02:47
Create_test_data.input.pset
04.06.2020 11:56:51
04.06.2020 11:57:14
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:57:14
04.06.2020 11:59:55
00:02:41
Create_test_data.input.pset
04.06.2020 11:59:55
04.06.2020 12:00:23
00:00:28
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:00:23
04.06.2020 12:03:23
00:03:00
Create_test_data.input.pset
04.06.2020 12:03:23
04.06.2020 12:03:49
00:00:26
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:03:49
04.06.2020 12:06:46
00:02:57
Vemos que 6,000,000 filas del incremento se procesan en 3 minutos, lo cual es bastante rápido.
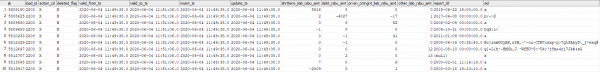
Los datos en la tabla de destino se distribuyeron de la siguiente manera:
select valid_from_ts, valid_to_ts, count(1), min(sk), max(sk) from dev42_1_db_usl.TESTING_SUBJ_org_finval group by valid_from_ts, valid_to_ts order by 1,2; 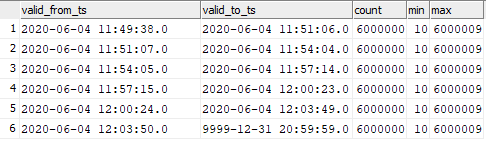
Se puede ver la correspondencia entre los datos insertados y los momentos de inicio de los gráficos.
Esto significa que se puede iniciar un proceso incremental de carga de datos en GreenPlum con frecuencia muy alta en Ab Initio y observar la rápida inserción de esos datos en GreenPlum. Por supuesto, no será posible ejecutarlo cada segundo, ya que Ab Initio, como cualquier herramienta ETL, requiere tiempo para 'arrancarse'.
Conclusión
Actualmente, Ab Initio se utiliza en Sberbank para construir la Capa Semántica de Datos Unificada (CSDU). Este proyecto implica la creación de una versión única del estado de diversas entidades comerciales del banco. La información proviene de diferentes fuentes, cuyas réplicas se preparan en Hadoop. Según las necesidades del negocio, se elabora un modelo de datos y se describen las transformaciones de datos. Ab Initio carga la información en la CSDU y los datos cargados no solo son de interés para el negocio en sí, sino que también sirven como fuente para construir vistas de datos. Además, la funcionalidad del producto permite usar diferentes sistemas como receptores (Hive, Greenplum, Teradata, Oracle), lo que permite preparar datos para el negocio en varios formatos que necesita.
Las capacidades de Ab Initio son amplias, por ejemplo, el marco MDW que se adjunta permite construir la trazabilidad técnica y empresarial de los datos 'fuera de la caja'. Para los desarrolladores, Ab Initio ofrece la posibilidad de 'no reinventar la rueda', sino de utilizar numerosos componentes funcionales existentes, que son esencialmente bibliotecas necesarias para trabajar con datos.
Autor: experto de la comunidad profesional de Sberbank SberProfi DWH/BIG Data. La comunidad profesional SberProfi DWH/BIG Data es responsable del desarrollo de competencias en áreas como el ecosistema Hadoop, Teradata, Oracle DB, GreenPlum, así como en herramientas BI como Qlik, SAP BO, Tableau, entre otras.
Fuente: habr.com
