

Me gustaría hablar sobre un interesante mecanismo de trabajo con la configuración de un sistema distribuido. La configuración se presenta directamente en un lenguaje compilable (Scala) utilizando tipos seguros. En esta publicación se descompone un ejemplo de dicha configuración y se abordan diversos aspectos de la implementación de la configuración compilable en el proceso general de desarrollo.
()
Introducción
Construir un sistema distribuido confiable implica que todos los nodos utilicen una configuración correcta y sincronizada con otros nodos. Normalmente se utilizan tecnologías DevOps (terraform, ansible o algo similar) para generar automáticamente archivos de configuración (a menudo específicos para cada nodo). También queremos estar seguros de que en todos los nodos interactuantes se utilizan protocolos idénticos (incluyendo la misma versión). De lo contrario, habrá incompatibilidad en nuestro sistema distribuido. En el mundo de la JVM, una de las consecuencias de este requisito es la necesidad de utilizar en todas partes la misma versión de la biblioteca que contiene los mensajes del protocolo.
¿Qué hay sobre las pruebas del sistema distribuido? Por supuesto, suponemos que se han previsto pruebas unitarias para todos los componentes antes de pasar a las pruebas de integración. (Para que podamos extrapolar los resultados de las pruebas al runtime, también debemos garantizar que el mismo conjunto de bibliotecas se utilice en la fase de pruebas y en el runtime).
Al trabajar con pruebas de integración, a menudo es más fácil utilizar un classpath unificado en todos los nodos. Solo nos quedará asegurar que se utilice el mismo classpath en el runtime. (Aunque es posible ejecutar diferentes nodos con diferentes classpaths, esto complica toda la configuración y dificulta el despliegue y las pruebas de integración). En esta publicación partimos de la premisa de que se utilizará el mismo classpath en todos los nodos.
La configuración se desarrolla junto con la aplicación. Para identificar las diferentes etapas de evolución de los programas, utilizamos versiones. Parece lógico también identificar diferentes versiones de las configuraciones. Y colocar la propia configuración en un sistema de control de versiones. Si hay una única configuración en producción, podemos usar simplemente el número de versión. Sin embargo, si se utilizan múltiples instancias en producción, necesitaremos varias
ramas de configuración y una etiqueta adicional además de la versión (por ejemplo, el nombre de la rama). De esta manera, podremos identificar de manera inequívoca la configuración exacta. Cada identificador de configuración corresponde de manera única a una combinación específica de nodos distribuidos, puertos, recursos externos y versiones de bibliotecas. En este post, asumiremos que solo hay una rama y que podemos identificar la configuración de manera habitual usando tres números separados por puntos (1.2.3).
En entornos modernos, los archivos de configuración se crean manualmente bastante poco. A menudo, se generan durante el despliegue y luego ya no se manipulan (para ). Surge la pregunta legítima de por qué seguimos utilizando un formato de texto para almacenar la configuración. Una alternativa viable es la posibilidad de usar código convencional para la configuración y obtener ventajas a través de chequeos en tiempo de compilación.
En este post, exploramos la idea de presentar la configuración dentro de un artefacto compilado.
Configuración compilable
En esta sección se presenta un ejemplo de configuración estática compilable. Se implementan dos servicios simples: un servicio de eco y un cliente del servicio de eco. Con base en estos dos servicios, se construyen dos variantes del sistema. En una variante, ambos servicios se encuentran en un mismo nodo, mientras que en la otra variante, están en nodos diferentes.
Generalmente, un sistema distribuido contiene varios nodos. Se pueden identificar los nodos usando valores de algún tipo NodeId:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
o
case class NodeId(hostName: String)o incluso
object Singleton
type NodeId = Singleton.type
Los nodos desempeñan diferentes roles, ejecutan servicios y entre ellos pueden establecerse conexiones TCP/HTTP.
Para describir una conexión TCP, necesitamos al menos un número de puerto. También nos gustaría reflejar el protocolo que se admite en este puerto para garantizar que tanto el cliente como el servidor utilicen el mismo protocolo. Describiremos la conexión utilizando la siguiente clase:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])donde Puerto — un número entero simple Int indicando el rango de valores permitidos:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Tipos refinados
Ver biblioteca y . En resumen, la biblioteca permite agregar restricciones a los tipos que se verifican en el momento de la compilación. En este caso, los valores permitidos para el número de puerto son enteros de 16 bits. Para la configuración compilada, el uso de la biblioteca refined no es obligatorio, pero mejora las capacidades del compilador para verificar la configuración.
Para los protocolos HTTP (REST), además del número de puerto, también puede que necesitemos una ruta al servicio:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Tipos fantasma
Para identificar el protocolo en el momento de la compilación, utilizamos un parámetro de tipo que no se usa dentro de la clase. Esta solución está relacionada con el hecho de que en runtime no utilizamos una instancia del protocolo, pero nos gustaría que el compilador verificara la compatibilidad de los protocolos. Al especificar el protocolo, no podremos pasar un servicio incompatible como dependencia.
Uno de los protocolos más comunes es REST API con serialización Json:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]donde RequestMessage — tipo de solicitud, ResponseMessage — tipo de respuesta.
Por supuesto, también se pueden utilizar otras descripciones de protocolos que proporcionen la precisión necesaria en la descripción.
Para los fines de esta publicación, utilizaremos una versión simplificada del protocolo:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]Aquí la solicitud es una cadena que se agrega a la URL, y la respuesta es la cadena devuelta en el cuerpo de la respuesta HTTP.
La configuración del servicio se describe por el nombre del servicio, los puertos y las dependencias. Estos elementos se pueden representar en Scala de varias maneras (por ejemplo, HList-s, tipos de datos algebraicos). Para los fines de esta publicación, utilizaremos el Cake Pattern y representaremos los módulos mediante traitEl patrón Cake no es un elemento obligatorio del enfoque descrito. Es simplemente una de las posibles implementaciones.
Las dependencias entre los servicios se pueden representar como métodos que devuelven puertos. EndPointde otros nodos:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Para crear un servicio de eco, solo se necesita el número de puerto y especificar que este puerto soporta el protocolo de eco. Podríamos no especificar un puerto concreto, ya que los traits permiten declarar métodos sin implementación (métodos abstractos). En este caso, al crear una configuración concreta, el compilador nos exigiría proporcionar una implementación para el método abstracto y proporcionar el número de puerto. Dado que hemos implementado el método, al crear una configuración concreta no necesitamos especificar otro puerto. Se utilizará el valor por defecto.
En la configuración del cliente, declaramos la dependencia del servicio de eco:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
La dependencia tiene el mismo tipo que el servicio exportado echoService. En particular, en el cliente de eco requerimos el mismo protocolo. Por lo tanto, al conectar dos servicios, podemos estar seguros de que todo funcionará correctamente.
Implementación de servicios
Para iniciar y detener un servicio se requiere una función. (La capacidad de detener el servicio es crítica para las pruebas.) Nuevamente, hay varias opciones para implementar tal función (por ejemplo, podríamos usar clases de tipos basadas en el tipo de configuración). Para los propósitos de este artículo, utilizaremos el patrón Cake. Representaremos el servicio mediante la clase cats.Resource, ya que en esta clase ya se prevén medios seguros para garantizar la liberación de recursos en caso de problemas. Para obtener el recurso, debemos proporcionar la configuración y el contexto de ejecución listo. La función de inicio del servicio puede tener el siguiente aspecto:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
donde
Configuración— tipo de configuración para este servicioAddressResolver— objeto de tiempo de ejecución que permite conocer las direcciones de otros nodos (ver más adelante)
y otros tipos de la biblioteca cats:
F[_]— tipo de efecto (en el caso más simpleF[A]puede ser simplemente una función() => A. En esta publicación, utilizaremoscats.IO.)Reader[A,B]— más o menos sinónimo de funciónA => Bcats.Resource— recurso que puede ser adquirido y liberadoTimer— temporizador (permite dormir durante un tiempo y medir intervalos de tiempo)ContextShift— análogo deExecutionContextApplicative— clase de tipo de efecto que permite combinar efectos individuales (casi una mónada). En aplicaciones más complejas, parece mejor usarMonad/ConcurrentEffect.
Utilizando esta firma de función, podemos implementar varios servicios. Por ejemplo, un servicio que no hace nada:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Ver. , donde se implementan otros servicios — ,
y .)
Un nodo representa un objeto que puede iniciar varios servicios (el inicio de la cadena de recursos se asegura a través del Cake Pattern):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Tenga en cuenta que especificamos el tipo exacto de configuración que se requiere para este nodo. Si olvidamos especificar alguno de los tipos de configuración requeridos por un servicio individual, habrá un error de compilación. También no podremos iniciar el nodo si no proporcionamos algún objeto que tenga el tipo adecuado con todos los datos necesarios.
Resolución de nombres de nodos
Para conectarse a un nodo remoto, necesitamos una dirección IP real. Es bastante posible que la dirección se conozca más tarde que las otras partes de la configuración. Por lo tanto, necesitamos una función que mapee el identificador del nodo a la dirección:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Se pueden proponer varias formas de implementar dicha función:
- Si las direcciones se conocen antes del despliegue, podemos generar código Scala con
las direcciones y luego ejecutar la compilación. Durante esto, se realizará la compilación y se ejecutarán las pruebas.
En este caso, la función será conocida estáticamente y podrá ser representada en el código como una proyecciónMap[NodeId, NodeAddress]. - En algunos casos, la dirección válida solo se conoce después de iniciar el nodo.
En este caso, podemos implementar un 'servicio de descubrimiento' que se inicie antes que los demás nodos, y todos los nodos se registrarán en este servicio y solicitarán las direcciones de otros nodos. - Si podemos modificar
/etc/hosts, entonces se pueden usar nombres de host predefinidos (comomy-project-main-nodeyecho-backend) y simplemente asociar estos nombres
con direcciones IP durante el despliegue.
En este artículo no abordaremos estos casos en detalle. Para nuestro
ejemplo simple, todos los nodos tendrán una dirección IP única — 127.0.0.1.
A continuación, consideraremos dos variantes de un sistema distribuido:
- Alojar todos los servicios en un solo nodo.
- Y alojar el servicio de eco y el cliente de eco en nodos diferentes.
Configuración para :
Configuración para un solo nodo
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identificador del nodo único
  \/\/ configuración del servidor
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Especificación de puerto de servicio segura. *\/
  override def portNumber: PortNumber = 8088

  \/\/ configuración del cliente

  \/** Usaremos el servicio proporcionado por el mismo host. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hola"

  def pollInterval: FiniteDuration = 1.second

  \/\/ configuración del controlador de ciclo de vida
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0.5 segundos adicionales para que haya 10 solicitudes, no 9.
}
El objeto implementa la configuración tanto del cliente como del servidor. También se utiliza la configuración del tiempo de vida para que, después del intervalo lifetime se finalice el programa. (Ctrl-C también funciona y libera correctamente todos los recursos.)
El mismo conjunto de traits de configuración e implementaciones se puede utilizar para crear un sistema compuesto por :
Configuración para dos nodos
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! especificación de dependencia
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0.5 segundos adicionales para que haya 10 solicitudes, no 9.

    def testMessage: String = "dolly"
  }
¡Importante! Tenga en cuenta cómo se realiza el enlace de servicios. Especificamos un servicio implementado por un nodo como la implementación del método dependiente de otro nodo. El tipo de dependencia es verificado por el compilador, ya que contiene el tipo de protocolo. Al ejecutarlo, la dependencia contendrá el identificador correcto del nodo objetivo. Gracias a este esquema, especificamos el número de puerto solo una vez y siempre hacemos referencia al puerto correcto.
Implementación de dos nodos del sistema
Para esta configuración, utilizamos las mismas implementaciones de servicios sin cambios. La única diferencia es que ahora tenemos dos objetos que implementan diferentes conjuntos de servicios:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
El primer nodo implementa el servidor y solo necesita la configuración del servidor. El segundo nodo implementa el cliente y utiliza otra parte de la configuración. Además, ambos nodos necesitan gestión del ciclo de vida. El nodo servidor funciona indefinidamente hasta que se detiene, SIGTERMy el nodo cliente finaliza después de algún tiempo. Ver. .
Proceso general de desarrollo
Veamos cómo este enfoque de configuración afecta el proceso general de desarrollo.
La configuración se compilará junto con el resto del código y se generará un artefacto (.jar). Parece sensato colocar la configuración en un artefacto separado. Esto se debe a que podemos tener múltiples configuraciones basadas en el mismo código. Nuevamente, se pueden generar artefactos correspondientes a diferentes ramas de configuración. Junto con la configuración, se mantienen las dependencias de versiones específicas de bibliotecas y estas versiones se guardan para siempre, en cualquier momento que decidamos desplegar esa versión de la configuración.
Cualquier cambio en la configuración se convierte en un cambio en el código. Por lo tanto, cada uno de estos
cambios estará cubierto por el proceso habitual de aseguramiento de calidad:
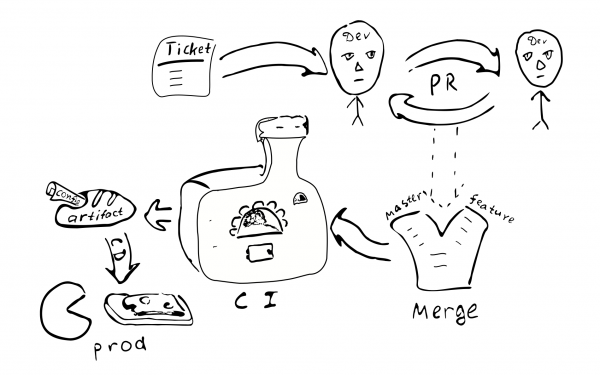
Ticket en el rastreador de errores -> PR -> revisión -> fusión con las ramas correspondientes ->
integración -> despliegue
Principales consecuencias de la implementación de una configuración compilable:
La configuración se acordará en todos los nodos del sistema distribuido. Dado que todos los nodos reciben la misma configuración de una única fuente.
Es problemático cambiar la configuración solo en uno de los nodos. Por lo tanto, la "desincronización de la configuración" (configuration drift) es poco probable.
Se vuelve más difícil realizar pequeños cambios en la configuración.
La mayor parte de los cambios en la configuración ocurrirán dentro del proceso general de desarrollo y estarán sujetos a revisión.
¿Es necesario un repositorio separado para almacenar la configuración de producción? Esta configuración puede contener contraseñas y otra información secreta a la que quisiéramos limitar el acceso. Desde esta perspectiva, parece lógico almacenar la configuración final en un repositorio separado. Se puede dividir la configuración en dos partes: una que contenga parámetros de configuración públicos y otra que contenga parámetros de acceso restringido. Esto permitirá que la mayoría de los desarrolladores tengan acceso a los parámetros comunes. Esta división no es difícil de lograr utilizando traits intermedios que contengan valores predeterminados.
Variaciones posibles
Intentemos comparar la configuración compilable con algunas alternativas comunes:
- Archivo de texto en la máquina de destino.
- Almacenamiento centralizado clave-valor (
etcd/zookeeper). - Componentes del proceso que pueden ser reconfigurados/reiniciados sin reiniciar el proceso.
- Almacenar la configuración fuera del artefacto y control de versiones.
Los archivos de texto ofrecen una gran flexibilidad en términos de pequeños cambios. Un administrador del sistema puede acceder a un nodo remoto, realizar cambios en los archivos correspondientes y reiniciar el servicio. Sin embargo, para sistemas grandes, esta flexibilidad puede no ser deseable. No quedan rastros de los cambios realizados en otros sistemas. Nadie revisa los cambios. Es difícil determinar quién hizo cambios y por qué. Los cambios no se prueban. Si el sistema es distribuido, el administrador puede olvidar hacer el cambio correspondiente en otros nodos.
(También cabe señalar que la aplicación de una configuración compilada no cierra la posibilidad de utilizar archivos de texto en el futuro. Solo será necesario añadir un analizador y un validador que proporcionen el mismo tipo. Configuración, y se pueden utilizar archivos de texto. De aquí se deduce directamente que la complejidad del sistema con una configuración compilada es algo menor que la complejidad del sistema que utiliza archivos de texto, ya que se requiere código adicional para los archivos de texto.)
Un almacén centralizado de clave-valor es un buen mecanismo para la distribución de metaparámteros de una aplicación distribuida. Debemos definir qué son los parámetros de configuración y qué son solo datos. Supongamos que tenemos una función C => A => B, donde los parámetros C cambian raramente, y los datos A cambian a menudo. En este caso, podemos decir que C son parámetros de configuración, y A son datos. Parece que los parámetros de configuración se diferencian de los datos en que en general cambian con menos frecuencia que los datos. Además, los datos generalmente provienen de una fuente (del usuario), mientras que los parámetros de configuración provienen de otra (del administrador del sistema).
Si se requiere actualizar parámetros que cambian raramente sin reiniciar el programa, esto puede llevar a complicar el programa, ya que necesitaremos de algún modo entregar los parámetros, almacenarlos, analizarlos y validarlos, y manejar valores incorrectos. Por lo tanto, desde el punto de vista de reducir la complejidad del programa, tiene sentido disminuir la cantidad de parámetros que pueden cambiar durante la ejecución del programa (o no soportar tales parámetros en absoluto).
Desde la perspectiva de esta publicación, vamos a distinguir entre parámetros estáticos y dinámicos. Si la lógica de funcionamiento del servicio requiere cambiar los parámetros durante la ejecución del programa, los denominaremos dinámicos. En caso contrario, los parámetros son estáticos y pueden configurarse utilizando una configuración compilada. Para la reconfiguración dinámica, es posible que necesitemos un mecanismo para reiniciar partes del programa con nuevos parámetros, similar a cómo se reinician los procesos del sistema operativo. (En nuestra opinión, es recomendable evitar la reconfiguración en tiempo real, ya que aumenta la complejidad del sistema. Si es posible, es mejor utilizar las capacidades estándar del sistema operativo para reiniciar procesos.)
Uno de los aspectos importantes del uso de una configuración estática, que lleva a las personas a considerar la reconfiguración dinámica, es el tiempo que requiere el sistema para reiniciarse después de actualizar la configuración (downtime). De hecho, si necesitamos realizar cambios en la configuración estática, tendremos que reiniciar el sistema para que los nuevos valores entren en vigor. El problema del downtime tiene diferentes grados de gravedad para diferentes sistemas. En algunos casos, se puede programar un reinicio en un momento de carga mínima. En caso de que sea necesario garantizar un servicio continuo, se puede implementar . De esta manera, cuando necesitemos reiniciar el sistema, ejecutamos una instancia paralela de este sistema, cambiamos el equilibrador hacia ella y esperamos a que las conexiones antiguas se completen. Después de que todas las conexiones antiguas se hayan completado, apagamos la instancia antigua del sistema.
Ahora consideremos la cuestión del almacenamiento de la configuración dentro del artefacto o fuera de él. Si almacenamos la configuración dentro del artefacto, al menos hemos podido verificar la corrección de la configuración durante la construcción del artefacto. Si la configuración se encuentra fuera del artefacto controlado, es difícil rastrear quién y por qué hizo cambios en este archivo. ¿Qué tan importante es esto? Desde nuestro punto de vista, para muchos sistemas de producción es importante tener una configuración estable y de alta calidad.
La versión del artefacto permite determinar cuándo fue creado, qué valores contiene, qué funciones están habilitadas/deshabilitadas y quién es responsable de cualquier cambio en la configuración. Por supuesto, almacenar la configuración dentro del artefacto requiere ciertos esfuerzos, por lo que se debe tomar una decisión consciente.
A favor y en contra
Me gustaría detenerme en los pros y contras de la tecnología propuesta.
Ventajas
A continuación se presenta una lista de las principales capacidades de la configuración compilada del sistema distribuido:
- Verificación estática de la configuración. Permite estar seguros de que
la configuración es correcta. - Un lenguaje de configuración rico. Normalmente, otros métodos de configuración están limitados a la sustitución de variables de cadena. Al utilizar Scala, se dispone de un amplio espectro de posibilidades del lenguaje para mejorar la configuración. Por ejemplo, podemos usar
traits para valores predeterminados, agrupar parámetros con objetos, y podemos referirnos a val definidos una sola vez (DRY) en el ámbito cubriente. Se pueden instanciar cualquier clase directamente dentro de la configuración (Seq,Map, clases personalizadas). - DSL. En Scala hay varias características del lenguaje que facilitan la creación de DSL. Se pueden aprovechar estas características y realizar un lenguaje de configuración que sea más conveniente para el grupo objetivo de usuarios, de modo que la configuración sea al menos legible para los especialistas en la materia. Los especialistas pueden, por ejemplo, participar en el proceso de revisión de la configuración.
- Integridad y sincronización entre nodos. Una de las ventajas de que la configuración de todo un sistema distribuido se almacene en un único punto es que todos los valores se declaran exactamente una vez y luego se reutilizan donde se requieren. El uso de tipos fantasma para declarar puertos garantiza que en todas las configuraciones válidas del sistema, los nodos utilicen protocolos compatibles. La existencia de dependencias obligatorias claras entre nodos asegura que todos los servicios estén interconectados.
- Alta calidad en la implementación de cambios. Modificar la configuración utilizando un proceso de desarrollo compartido hace que los altos estándares de calidad también estén disponibles para la configuración.
- Actualización simultánea de la configuración. La implementación automática del sistema tras realizar cambios en la configuración garantiza que todos los nodos se actualicen.
- Simplificación de la aplicación. La aplicación no necesita análisis, verificación de la configuración ni procesamiento de valores incorrectos. Esto reduce la complejidad de la aplicación. (Cierta complejidad en la configuración que se observa en nuestro ejemplo no es un atributo de la configuración compilada, sino una decisión consciente tomada para asegurar una mayor seguridad de tipos). Es bastante fácil volver a la configuración habitual; simplemente se implementan las partes faltantes. Por lo tanto, se puede, por ejemplo, empezar con una configuración compilada, posponiendo la implementación de partes adicionales hasta que realmente se necesiten.
- Configuración versionada. Dado que los cambios en la configuración siguen el mismo destino que cualquier otro cambio, al final obtenemos un artefacto con una versión única. Esto nos permite, por ejemplo, regresar a una versión anterior de la configuración si es necesario. Incluso podemos utilizar la configuración de hace un año y el sistema funcionará exactamente igual. Una configuración estable mejora la previsibilidad y confiabilidad de un sistema distribuido. Como la configuración se fija en la etapa de compilación, es bastante difícil de falsificar en producción.
- Modularidad. El marco propuesto es modular y los módulos pueden combinarse de diversas maneras para crear diferentes sistemas. En particular, se puede configurar un sistema para ejecutarse en un solo nodo en una variante, y en varios nodos en otra. Se pueden crear múltiples configuraciones para instancias productivas del sistema.
- Pruebas. Al reemplazar servicios individuales con objetos mock, se pueden obtener varias versiones del sistema que son convenientes para las pruebas.
- Pruebas de integración. La existencia de una configuración unificada de todo el sistema distribuido permite ejecutar todos los componentes en un entorno controlado en el marco de las pruebas de integración. Es fácil emular, por ejemplo, una situación en la que algunos nodos quedan fuera de servicio.
Desventajas y limitaciones
La configuración compilada se diferencia de otros enfoques de configuración y puede no ser adecuada para algunas aplicaciones. A continuación se presentan algunas desventajas:
- Configuración estática. A veces es necesario corregir rápidamente la configuración en producción, omitiendo todos los mecanismos de protección. En este enfoque, puede ser más complicado. Al menos, la compilación y el despliegue automático aún serán necesarios. Esta es tanto una característica útil del enfoque como una desventaja en algunos casos.
- Generación de configuración. En caso de que el archivo de configuración sea generado por una herramienta automática, pueden ser necesarios esfuerzos adicionales para integrar el script de generación.
- Caja de herramientas. Actualmente, las utilidades y metodologías diseñadas para trabajar con configuraciones se basan en archivos de texto. No todas estas utilidades/metodologías estarán disponibles en el caso de una configuración compilada.
- Se requiere un cambio de perspectiva. Los desarrolladores y DevOps están acostumbrados a archivos de texto. La propia idea de compilar la configuración puede ser algo inesperada y inusual, lo que provoca rechazo.
- Se necesita un proceso de desarrollo de alta calidad. Para utilizar cómodamente la configuración compilada, es necesaria una automatización completa del proceso de construcción y despliegue de la aplicación (CI/CD). De lo contrario, será bastante incómodo.
También examinaremos una serie de limitaciones del ejemplo considerado, no relacionadas con la idea de configuración compilada:
- Si proporcionamos información de configuración adicional que no es utilizada por el nodo, el compilador no nos ayudará a detectar la falta de implementación. Este problema se puede resolver si se renuncia al patrón de Cake y se utilizan tipos más estrictos, por ejemplo,
HListo tipos algebraicos de datos (case classes) para representar la configuración. - En el archivo de configuración hay líneas que no pertenecen a la configuración en sí: (
package,import, declaraciones de objetos;override defPara parámetros que tienen valores predeterminados). Parte de esto se puede evitar si se implementa su propio DSL. Además, otros tipos de configuración (por ejemplo, XML) también imponen ciertas restricciones sobre la estructura del archivo. - En este post no abordamos la reconfiguración dinámica de un clúster de nodos similares.
Conclusión
En este post hemos analizado la idea de representar la configuración en el código fuente utilizando las avanzadas capacidades del sistema de tipos de Scala. Este enfoque puede ser aplicado en diversas aplicaciones como un reemplazo a los métodos tradicionales de configuración basados en archivos XML o de texto. A pesar de que nuestro ejemplo está implementado en Scala, las mismas ideas se pueden trasladar a otros lenguajes compilables (como Kotlin, C#, Swift, …). Este enfoque se puede probar en uno de los próximos proyectos, y si no resulta adecuado, se puede cambiar a archivos de texto añadiendo los detalles que falten.
Naturalmente, la configuración compilable requiere un proceso de desarrollo de alta calidad. A cambio, se garantiza una alta calidad y fiabilidad de las configuraciones.
El enfoque discutido puede ser ampliado:
- Se pueden utilizar macros para realizar comprobaciones durante la compilación.
- Se puede implementar un DSL para representar la configuración en un formato accesible para los usuarios finales.
- Se puede implementar una gestión dinámica de recursos con ajuste automático de la configuración. Por ejemplo, al cambiar el número de nodos en el clúster, es necesario que (1) cada nodo reciba una configuración ligeramente diferente; (2) el gestor del clúster obtenga información sobre los nuevos nodos.
Agradecimientos
Me gustaría agradecer a Andrey Saksonov, Pavel Popov y Anton Nekhaev por las críticas constructivas al borrador del artículo.
Fuente: habr.com
