

Hoy, miércoles, se lanza otra versión de Kubernetes — 1.16. Siguiendo la tradición de nuestro blog, por décima vez, nos gustaría presentarte los cambios más significativos en la nueva versión.
La información utilizada para la preparación de este material se tomó de , y de los issues, pull requests, así como de las Propuestas de Mejora de Kubernetes (KEP). Entonces, ¡vamos!...
Nodos
Se presentan un número realmente grande de nuevas características notables (en estado alfa) en el lado de los nodos de los clústeres K8s (Kubelet).
Primero, están los llamados «» (Ephemeral Containers), diseñados para simplificar los procesos de depuración en los pods. El nuevo mecanismo permite iniciar contenedores especiales que se ejecutan en el espacio de nombres de los pods existentes y viven por un tiempo limitado. Su propósito es interactuar con otros pods y contenedores para resolver problemas y realizar depuración. Para esta capacidad, se ha implementado un nuevo comando kubectl debug, similar en esencia a kubectl exec: solo que en lugar de iniciar un proceso en un contenedor (como en el caso de exec), inicia un contenedor en el pod. Por ejemplo, este comando conectará un nuevo contenedor al pod:
kubectl debug -c debug-shell --image=debian target-pod -- bashPuedes encontrar más detalles sobre los contenedores efímeros (y ejemplos de su uso) en . La implementación actual (en K8s 1.16) es una versión alfa, y entre los criterios para su transición a beta se incluye 'probar el API de Contenedores Efímeros durante al menos 2 lanzamientos [Kubernetes]'.
NB: En esencia y incluso en nombre, la característica se asemeja a un complemento ya existente , del cual ya hemos . Se espera que con la aparición de contenedores efímeros, el desarrollo de un complemento externo separado se detenga.
Otra novedad es , que tiene como objetivo proporcionar un mecanismo de cálculo de costos generales para los pods, que pueden variar significativamente según el entorno de ejecución utilizado (runtime). Como ejemplo, los autores mencionan Kata Containers, que requieren iniciar un núcleo invitado, un agente kata, un sistema init, etc. Cuando el overhead se vuelve tan grande, no se puede ignorar, lo que significa que se necesita un modo de tenerlo en cuenta para la posterior asignación, planificación, etc. Para implementarlo, se ha agregado un campo en PodSpec llamado Overhead *ResourceList (se corresponde con los datos en RuntimeClass, si se utiliza).
Otra novedad notable es el gestor de topología de nodo (Node Topology Manager), destinado a unificar el enfoque para la optimización de la distribución de recursos de hardware para diversos componentes en Kubernetes. Esta iniciativa surge de la creciente necesidad de varios sistemas modernos (en el ámbito de las telecomunicaciones, el aprendizaje automático, los servicios financieros, etc.) de realizar cálculos paralelos de alto rendimiento y minimizar la latencia en la ejecución de operaciones, para lo cual utilizan las avanzadas capacidades de la CPU y la aceleración por hardware. Estas optimizaciones en Kubernetes hasta ahora se han logrado gracias a componentes dispares (gestor de CPU, gestor de dispositivos, CNI), y ahora se les añadirá una interfaz interna única que unificará el enfoque y simplificará la conexión de nuevos componentes similares, denominados — componentistas de topología — del lado de Kubelet. Los detalles están en .
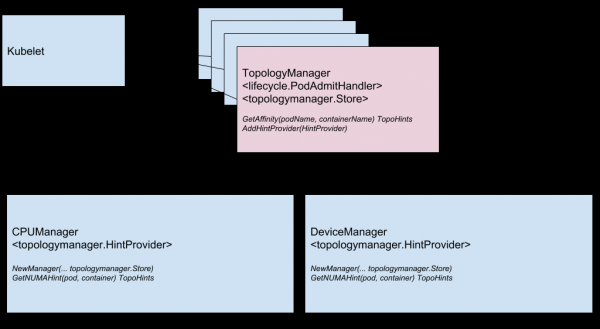
El esquema de componentes del Gestor de Topología
La siguiente función es la verificación de contenedores al momento de su inicio (). Como es sabido, para los contenedores que tardan en iniciar, es difícil obtener un estado actual: o se 'eliminan' antes de realmente comenzar a funcionar, o quedan atrapados durante mucho tiempo en un deadlock. La nueva verificación (activada a través de un feature gate llamado StartupProbeEnabled) anula — más bien, pospone — la acción de cualquier otra verificación hasta el momento en que el pod ha terminado su inicio. Por esta razón, la función fue inicialmente denominada . Para los pods que tardan en iniciar, se puede realizar sondeos de estado en intervalos de tiempo relativamente cortos.
Además, se presenta una mejora para RuntimeClass en estado beta, que añade soporte para 'clústeres heterogéneos'. Con ya no es necesario que cada nodo tenga soporte para cada RuntimeClass: para los pods se puede elegir RuntimeClass sin preocuparse por la topología del clúster. Antes, para lograr esto — para que los pods se ubicaran en nodos con soporte para todo lo que necesitaban — era necesario asignar las reglas adecuadas en NodeSelector y tolerancias. En se describen ejemplos de uso y, por supuesto, los detalles de implementación.
Red
Dos características de red significativas que aparecieron por primera vez (en la versión alfa) en Kubernetes 1.16 son:
- doble pila de red — IPv4/IPv6 — y su correspondiente "comprensión" a nivel de pod, nodos y servicios. Incluye la interacción entre IPv4 e IPv4 y entre IPv6 e IPv6 entre pods, de pods a servicios externos, implementaciones de referencia (dentro de los plugins Bridge CNI, PTP CNI y Host-Local IPAM), así como la compatibilidad hacia atrás con clústeres de Kubernetes que solo operan con IPv4 o IPv6. Los detalles de la implementación se encuentran en .
Ejemplo de salida de direcciones IP de dos tipos (IPv4 e IPv6) en la lista de pods:
kube-master# kubectl get pods -o wide NAME READY STATUS RESTARTS AGE IP NODE nginx-controller 1/1 Running 0 20m fd00:db8:1::2,192.168.1.3 kube-minion-1 kube-master# - Nueva API para Endpoint — . Resuelve problemas de rendimiento/escalabilidad del actual Endpoint API que afectan a varios componentes en el control-plane (apiserver, etcd, endpoints-controller, kube-proxy). La nueva API se añadirá al grupo de API Discovery y podrá manejar decenas de miles de endpoints backend en cada servicio dentro de un clúster que consta de miles de nodos. Para ello, cada Servicio se representa en N objetos
EndpointSlice, cada uno de los cuales tiene por defecto no más de 100 endpoints (valor configurable). En la API EndpointSlice también se preverán capacidades para su desarrollo futuro: el soporte de múltiples direcciones IP para cada pod, nuevos estados para los endpoints (no soloListoyNotReady), sub-conjuntos dinámicos para los endpoints.
Se ha avanzado a la versión beta el componente presentado en la release pasada , denominado service.kubernetes.io/load-balancer-cleanup y que se adjunta a cada servicio con el tipo LoadBalancer. En el momento de eliminar dicho servicio, previene la eliminación real del recurso hasta que se complete la "limpieza" de todos los recursos relacionados con el balanceador.
API Machinery
Se ha documentado un verdadero "hito de estabilización" en el ámbito del API server de Kubernetes y su interacción. En gran medida, esto ha sucedido gracias a la transición a estado estable de aquellos que no necesitan una presentación especial (CRD), los cuales tenían estado beta desde tiempos lejanos de Kubernetes 1.7 (esto es junio de 2017). La misma estabilización ha llegado también a las características relacionadas:
- para
/statusy/scaleCustomResources; - de versiones para CRD, basada en un webhook externo;
- (defaulting) recientemente introducidos y eliminación automática de campos (pruning) de la aplicación del esquema OpenAPI v3 para crear y publicar documentación OpenAPI utilizada para la validación de los recursos CRD en el lado del servidor. (pruning) CustomResources;
- la aplicación del esquema OpenAPI v3 para crear y publicar documentación OpenAPI, utilizada para validar recursos CRD en el lado del servidor.
Otro mecanismo que se ha vuelto habitual para los administradores de Kubernetes: también permaneció mucho tiempo en estado beta (desde K8s 1.9) y ahora se ha declarado estable.
Otras dos características alcanzaron la versión beta: y .
Y la única novedad significativa en la versión alpha fue desde SelfLink — un URI especial que representa el objeto especificado y que es parte de ObjectMeta y ListMeta (es decir, parte de cualquier objeto en Kubernetes). ¿Por qué se está eliminando? La motivación "simplemente" como la ausencia de razones reales (irrevocables) para que este campo continúe existiendo. Las razones más formales son optimizar el rendimiento (eliminando un campo innecesario) y simplificar el trabajo del generic-apiserver, que se ve obligado a manejar este campo de una manera especial (es el único campo que se establece justo antes de la serialización del objeto). La verdadera "obsolescencia" (dentro de la versión beta) SelfLink ocurrirá en la versión Kubernetes 1.20, y la definitiva será 1.21.
Almacenamiento de datos
El trabajo principal en el área de almacenamiento, como en versiones anteriores, se observa en el área de . Los principales cambios aquí fueron:
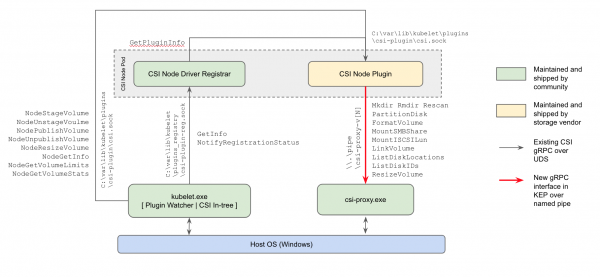
- por primera vez (en la versión alpha) soporte para plugins CSI en nodos de trabajo con Windows: un método actual para trabajar con almacenes que reemplazará a los plugins in-tree en el núcleo de Kubernetes y a los plugins FlexVolume de Microsoft basados en Powershell;

Esquema de implementación de plugins CSI en Kubernetes para Windows - la posibilidad , presentado aún en K8s 1.12, llegó a la versión beta;
- una "mejora" similar (de alpha a beta) se alcanzó con la capacidad de usar CSI para crear volúmenes efímeros locales ().
La función de clonación de volúmenes (uso de PVC existentes como DataSource para crear nuevos PVC) también ha obtenido ahora el estatus de versión beta.
Programador
Dos cambios significativos en la programación (ambos en versión alpha):
- — la posibilidad de usar pods en lugar de unidades lógicas de aplicación para "distribuir equitativamente" las cargas (como Deployment y ReplicaSet) y ajustar esta distribución (como un requisito estricto o como una condición flexible, es decir, prioridad). Esta función ampliará las posibilidades existentes de distribución de pods planificados, que actualmente están limitadas por las opciones
PodAffinityyPodAntiAffinity, proporcionando a los administradores un control más granular en este aspecto, lo que significa una mejor alta disponibilidad y un consumo de recursos optimizado. Más detalles en . - Uso Política BestFit en Función de Prioridad de Solicitud a Capacidad durante la planificación de pods, lo que permitirá aplicar (“empaquetado en contenedores”) tanto para recursos básicos (CPU, memoria) como para avanzados (como GPU). Más detalles en .

Planificación de pods: antes de utilizar la política de mejor ajuste (directamente a través del programador por defecto) y con su uso (a través de scheduler extender)
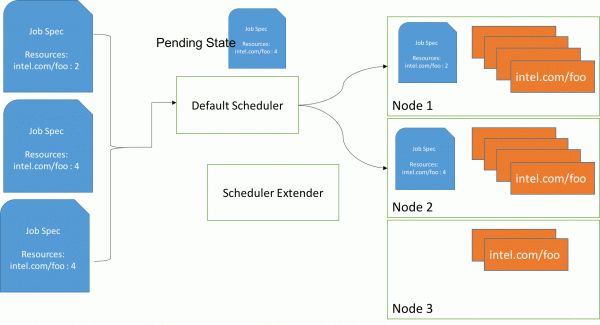
Además, la posibilidad de crear plugins propios para el programador fuera del árbol principal de desarrollo de Kubernetes (out-of-tree).
Otras modificaciones
También se puede destacar en la versión de Kubernetes 1.16 la iniciativa para las métricas existentes de manera adecuada, y más exactamente, de acuerdo con para la instrumentación de K8s. En general, se basan en la correspondiente . Las inconsistencias surgieron por diversas razones (por ejemplo, algunas métricas se crearon antes de que aparecieran las instrucciones actuales), y los desarrolladores decidieron que era hora de llevar todo a un estándar unificado, “en conformidad con el resto del ecosistema de Prometheus”. La implementación actual de esta iniciativa está en estado alfa, que se irá elevando en versiones posteriores de Kubernetes a beta (1.17) y estable (1.18).
Además, se pueden mencionar los siguientes cambios:
- Desarrollo del soporte para Windows con de la herramienta Kubeadm para este SO (versión alfa),
RunAsUserNamepara contenedores de Windows (versión alfa), en el soporte de Group Managed Service Account (gMSA) a beta, mount/attach para volúmenes de vSphere. - el mecanismo de compresión de datos en las respuestas de API. Anteriormente, se utilizaba un filtro HTTP para estos fines, lo que imponía una serie de restricciones que dificultaban su activación por defecto. Ahora funciona la “compresión transparente de solicitudes”: los clientes que envían
Accept-Encoding: gzipen el encabezado reciben una respuesta comprimida en GZIP, si su tamaño supera los 128 Kb. Los clientes en Go soportan automáticamente la compresión (envían el encabezado necesario), por lo que notarán de inmediato la reducción del tráfico. (Para otros lenguajes pueden ser necesarias pequeñas modificaciones.) - escalar HPA desde/hasta cero pods en función de métricas externas. Si el escalado se realiza en función de objetos/métricas externas, cuando las cargas de trabajo están inactivas, se puede escalar automáticamente a 0 réplicas para ahorrar recursos. Esta función debería ser especialmente útil en casos donde los workers solicitan recursos GPU, y el número de tipos diferentes de workers inactivos supera el número de GPU disponibles.
- Nuevo cliente — — para el acceso «general» a los objetos. Está diseñado para obtener fácilmente metadatos (es decir, subconjuntos
metadata) de los recursos del clúster y realizar operaciones como la recolección de basura y el establecimiento de cuotas. - Recopilar Kubernetes sin proveedores de nube obsoletos («integrados» en in-tree) (versión alfa).
- En la utilidad kubeadm se añadió la posibilidad experimental (versión alfa) de aplicar parches de kustomize durante las operaciones
init,joinyupgrade. Para más información sobre cómo utilizar la bandera--experimental-kustomize, ver en . - Nuevo endpoint para apiserver — , — que permite exportar información sobre su disponibilidad (readiness). Además, el API-server ha obtenido la bandera
--maximum-startup-sequence-duration, que permite regular sus reinicios. - Dos funciones para Azure han sido declaradas estables: soporte para (Availability Zones) y (RG). Además, se ha añadido en Azure:
- AAD y ADFS;
-
service.beta.kubernetes.io/azure-pip-namepara especificar la IP pública en el balanceador de carga; - configuraciones
LoadBalancerNameyLoadBalancerResourceGroup.
- AWS ha introducido para EBS en Windows y las llamadas API de EC2
DescribeInstances. - Kubeadm ahora migra automáticamente Los binarios
- en la imagen Docker correspondiente etcd son ejecutables para el mundo, lo que permite lanzar esta imagen sin necesidad de privilegios de root. Además, la imagen de migración de etcd ha dejado Cluster Autoscaler 1.16.0
- En Actualizaciones en el software utilizado/dependiente: Go 1.12.9, etcd 3.3.15, CoreDNS 1.6.2.
- Kubernetes 1.15: revisión de las principales novedades
P.D.
También puedes leer en nuestro blog:
- «»;
- «»;
- «»;
- «».
Fuente: habr.com
