

Nota de traducción.: Este artículo, escrito por Galo Navarro, quien ocupa el cargo de Principal Software Engineer en la empresa europea Adevinta, es una fascinante e instructiva 'investigación' en el ámbito de la explotación de infraestructuras. Su título original fue ligeramente modificado en la traducción por razones que el autor explica al principio.
Nota del autor: Parece que esta publicación mucho más atención de la que se esperaba. Todavía estoy recibiendo comentarios airados sobre cómo el título del artículo puede resultar engañoso y que algunos lectores están decepcionados. Entiendo las razones de lo ocurrido, así que, a pesar del riesgo de arruinar toda la intriga, quiero contarles de inmediato de qué trata este artículo. Al observar la migración de equipos a Kubernetes, he notado algo curioso: cada vez que surge un problema (por ejemplo, un aumento en la latencia tras la migración), se culpa a Kubernetes, pero luego resulta que el orquestador, en general, no es el culpable. Este artículo trata sobre uno de esos casos. Su título repite la exclamación de uno de nuestros desarrolladores (verán que Kubernetes no tiene nada que ver aquí). No encontrarán revelaciones inesperadas sobre Kubernetes, pero pueden esperar algunas valiosas lecciones sobre sistemas complejos.
Hace un par de semanas, mi equipo estuvo involucrado en la migración de un microservicio a la plataforma principal, que incluye CI/CD, un entorno de trabajo basado en Kubernetes, métricas y otras herramientas útiles. La mudanza fue experimental: planeábamos usarla como base y trasladar otros 150 servicios en los próximos meses. Todos ellos son responsables del funcionamiento de algunas de las mayores plataformas en línea de España (Infojobs, Fotocasa, etc.).
Después de implementar la aplicación en Kubernetes y redirigir parte del tráfico, nos esperaba una sorprendente y preocupante noticia. La latencia (latencia) de las solicitudes en Kubernetes era diez veces mayor que en EC2. En resumen, era necesario buscar una solución a este problema o renunciar a la migración del microservicio (y tal vez a todo el proyecto).
¿Por qué la latencia en Kubernetes es tan superior a la de EC2?
Para encontrar el cuello de botella, recopilamos métricas a lo largo de toda la ruta de la solicitud. Nuestra arquitectura es simple: una puerta de enlace API (Zuul) proxía las solicitudes a las instancias del microservicio en EC2 o Kubernetes. En Kubernetes utilizamos NGINX Ingress Controller, y los backend son simplemente objetos de tipo con una aplicación JVM en la plataforma Spring.
                                  EC2
                            +---------------+
                            |  +---------+  |
                            |  |         |  |
                       +-------> BACKEND |  |
                       |    |  |         |  |
                       |    |  +---------+  |
                       |    +---------------+
             +------+  |
Public       |      |  |
      -------> ZUUL +--+
traffic      |      |  |              Kubernetes
             +------+  |    +-----------------------------+
                       |    |  +-------+      +---------+ |
                       |    |  |       |  xx  |         | |
                       +-------> NGINX +------> BACKEND | |
                            |  |       |  xx  |         | |
                            |  +-------+      +---------+ |
                            +-----------------------------+
Parece que el problema estaba relacionado con retrasos en la fase inicial de funcionamiento del backend (he marcado la zona problemática en el gráfico como «xx»). En EC2, la respuesta de la aplicación tardaba alrededor de 20 ms. En Kubernetes, el retraso aumentaba a 100-200 ms.
Rápidamente descartamos a los sospechosos probables relacionados con el cambio de entorno de ejecución. La versión de JVM se mantuvo igual. Los problemas de contenedorización tampoco eran culpables: la aplicación ya funcionaba exitosamente en contenedores en EC2. ¿Carga? Pero observamos altos retrasos incluso con 1 solicitud por segundo. Las pausas para la recolección de basura también se podían descartar.
Uno de nuestros administradores de Kubernetes preguntó si la aplicación tenía dependencias externas, ya que en el pasado las solicitudes a DNS habían causado problemas similares.
Hipótesis 1: resolución de nombres DNS
Con cada solicitud, nuestra aplicación consulta al menos una vez, y hasta tres, a una instancia de AWS Elasticsearch en un dominio como elastic.spain.adevinta.com. Dentro de los contenedores, contamos con , por lo que podemos verificar si realmente la búsqueda del dominio está tomando mucho tiempo.
Consultas DNS desde el contenedor:
[root@be-851c76f696-alf8z \/]# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 22 msec
;; Query time: 22 msec
;; Query time: 29 msec
;; Query time: 21 msec
;; Query time: 28 msec
;; Query time: 43 msec
;; Query time: 39 msec
Consultas similares desde una de las instancias EC2, donde se ejecuta la aplicación:
bash-4.4# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 77 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
Dado que la búsqueda toma alrededor de 30 ms, quedó claro que la resolución DNS al acceder a Elasticsearch realmente contribuía al aumento de la latencia.
Sin embargo, esto era extraño por dos razones:
- Ya tenemos una gran cantidad de aplicaciones en Kubernetes que interactúan con los recursos de AWS, pero no sufren de grandes retrasos. Cualquiera que sea la razón, se relaciona específicamente con este caso.
- Sabemos que la JVM realiza almacenamiento en caché de DNS en memoria. En nuestras imágenes, el valor TTL está escrito en
$JAVA_HOME/jre/lib/security/java.securityy está establecido en 10 segundos:networkaddress.cache.ttl = 10. En otras palabras, la JVM debe almacenar en caché todas las consultas DNS durante 10 segundos.
Para confirmar la primera hipótesis, decidimos temporalmente renunciar a las consultas DNS y ver si el problema desaparecía. Primero optamos por reconfigurar la aplicación para que se conectara a Elasticsearch directamente por dirección IP, en lugar de a través de un nombre de dominio. Esto requeriría una modificación del código y un nuevo despliegue, así que simplemente asociamos el dominio con su dirección IP en /etc/hosts:
34.55.5.111 elastic.spain.adevinta.comAhora el contenedor recibía la IP casi instantáneamente. Esto llevó a una leve mejora, pero apenas nos acercamos al nivel de latencia esperado. Aunque la resolución de DNS tardaba mucho tiempo, la verdadera causa seguía evadiéndonos.
Diagnóstico mediante red
Decidimos analizar el tráfico desde el contenedor utilizando tcpdump, para rastrear qué estaba sucediendo en la red:
[root@be-851c76f696-alf8z \/]# tcpdump -leni any -w capture.pcap Luego enviamos algunas solicitudes y descargamos su captura (kubectl cp my-service:\/capture.pcap capture.pcap) para un análisis posterior en .
No había nada sospechoso en las solicitudes DNS (excepto por un pequeño detalle que mencionaré más adelante). Pero había ciertas peculiaridades en cómo nuestro servicio manejaba cada solicitud. A continuación se muestra una captura de pantalla de la captura, mostrando la recepción de la solicitud antes de que comience la respuesta:
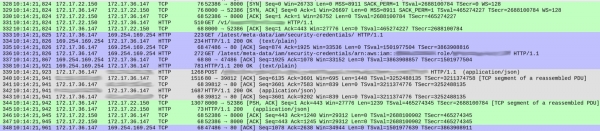
Los números de paquetes se encuentran en la primera columna. Para mayor claridad, he destacado diferentes flujos TCP en color.
El flujo verde, que comienza con el paquete 328, muestra cómo el cliente (172.17.22.150) estableció una conexión TCP con el contenedor (172.17.36.147). Después del apretón de manos inicial (328-330), el paquete 331 trajo HTTP GET \/v1\.. — una solicitud entrante a nuestro servicio. Todo el proceso tomó 1 ms.
El flujo gris (desde el paquete 339) muestra que nuestro servicio envió una solicitud HTTP a la instancia de Elasticsearch (no hay apretón de manos TCP, ya que se utiliza una conexión existente). Esto tomó 18 ms.
Hasta ahora todo bien, y los tiempos corresponden aproximadamente a las latencias esperadas (20-30 ms en las mediciones desde el cliente).
Sin embargo, la sección azul tarda 86 ms. ¿Qué está sucediendo en ella? Con el paquete 333, nuestro servicio envió una solicitud HTTP GET a /latest/meta-data/iam/security-credentials, y justo después, a través de la misma conexión TCP, otra solicitud GET a /latest/meta-data/iam/security-credentials/arn:...
Descubrimos que esto se repite con cada solicitud a lo largo de todo el rastreo. La resolución DNS es, de hecho, algo más lenta en nuestros contenedores (la explicación de este fenómeno es bastante interesante, pero la guardaré para un artículo aparte). Resultó que la causa de las grandes latencias son las llamadas al servicio AWS Instance Metadata con cada solicitud.
Hipótesis 2: llamadas innecesarias a AWS
Ambos endpoints pertenecen a . Nuestro microservicio utiliza este servicio al trabajar con Elasticsearch. Ambas llamadas son parte del proceso básico de autorización. El endpoint al que se llama en la primera solicitud devuelve el rol IAM asociado con la instancia.
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/
arn:aws:iam::<account_id>:role/some_role
La segunda solicitud se dirige al segundo endpoint para obtener credenciales temporales para esta instancia:
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/arn:aws:iam::<account_id>:role/some_role`
{
    "Code" : "Success",
    "LastUpdated" : "2012-04-26T16:39:16Z",
    "Type" : "AWS-HMAC",
    "AccessKeyId" : "ASIAIOSFODNN7EXAMPLE",
    "SecretAccessKey" : "wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY",
    "Token" : "token",
    "Expiration" : "2017-05-17T15:09:54Z"
}
El cliente puede utilizarlas por un corto período de tiempo y debe obtener nuevos certificados periódicamente (hasta su Expiration). El modelo es simple: AWS realiza una rotación frecuente de claves temporales por razones de seguridad, pero los clientes pueden almacenarlas en caché durante unos minutos, compensando la disminución del rendimiento relacionada con la obtención de nuevos certificados.
El AWS Java SDK debería hacerse cargo de organizar este proceso, pero por alguna razón no lo hace.
Al buscar en los issues en GitHub, nos encontramos con el problema . Esto nos ayudó a definir la dirección hacia donde debíamos 'cavar' más.
AWS SDK actualiza los certificados al ocurrir una de las siguientes condiciones:
- El vencimiento de los mismos (
Expiration) cae dentro deEXPIRATION_THRESHOLD, fijado en el código en 15 minutos. - Ha pasado más tiempo desde el último intento de actualizar los certificados que
REFRESH_THRESHOLD, 'hardcodeado' en 60 minutos.
Para ver el tiempo real de vencimiento de los certificados que recibimos, ejecutamos los comandos cURL mencionados anteriormente desde el contenedor y desde la instancia EC2. El tiempo de vida del certificado obtenido del contenedor resultó ser mucho más corto: exactamente 15 minutos.
Ahora todo está claro: para la primera solicitud, nuestro servicio obtenía certificados temporales. Dado que su validez no superaba los 15 minutos, en la solicitud subsecuente, AWS SDK decidía actualizarlos. Y esto sucedía con cada solicitud.
¿Por qué se redujo la duración de los certificados?
El servicio AWS Instance Metadata está diseñado para trabajar con instancias EC2, no con Kubernetes. Por otro lado, no queríamos cambiar la interfaz de las aplicaciones. Para esto, utilizamos — una herramienta que, mediante agentes en cada nodo de Kubernetes, permite a los usuarios (ingenieros que implementan aplicaciones en el clúster) asignar roles de IAM a contenedores en pods como si fueran instancias EC2. KIAM intercepta llamadas al servicio AWS Instance Metadata y las procesa desde su caché, después de haberlas obtenido de AWS. Desde la perspectiva de la aplicación, nada cambia.
KIAM proporciona certificados a corto plazo a los pods. Esto es razonable, considerando que la duración media de vida de un pod es menor que la de una instancia EC2. Por defecto, la duración de los certificados .
Como resultado, si superponemos ambos valores por defecto, surge un problema. Cada certificado proporcionado a la aplicación expira en 15 minutos. Mientras tanto, AWS Java SDK obliga a actualizar cualquier certificado cuyo tiempo de vida sea inferior a 15 minutos.
Como resultado, el certificado temporal se actualiza forzosamente con cada solicitud, lo que lleva a un par de llamadas a la API de AWS y provoca un aumento significativo en la latencia. En AWS Java SDK encontramos , donde se menciona un problema similar.
La solución resultó ser sencilla. Simplemente reconfiguramos KIAM para solicitar certificados con una mayor duración. Una vez hecho esto, las solicitudes comenzaron a pasar sin la intervención del servicio AWS Metadata, y la latencia incluso disminuyó a un nivel más bajo que en EC2.
Conclusiones
A partir de nuestra experiencia con migraciones, se puede decir que una de las fuentes más frecuentes de problemas no son errores en Kubernetes u otros elementos de la plataforma. Tampoco están relacionados con defectos fundamentales en los microservicios que estamos trasladando. Los problemas a menudo surgen simplemente porque estamos conectando diferentes elementos.
Mezclamos sistemas complejos que nunca antes habían interactuado entre sí, esperando que juntos formen un único sistema más grande. Desafortunadamente, cuanto más elementos hay, mayor es el margen de error y más alta es la entropía.
En nuestro caso, la alta latencia no fue resultado de errores o malas decisiones en Kubernetes, KIAM, AWS Java SDK o nuestro microservicio. Fue el resultado de la combinación de dos parámetros independientes predeterminados: uno en KIAM y otro en AWS Java SDK. Por separado, ambos parámetros tienen sentido: tanto la política activa de actualización de certificados en AWS Java SDK como el corto período de validez de los certificados en KIAM. Pero si se juntan, los resultados se vuelven impredecibles. Dos decisiones independientes y lógicas no necesariamente tienen que tener sentido al unirse.
P.D. del traductor
Puedes aprender más sobre la arquitectura de la utilidad KIAM para integrar AWS IAM con Kubernetes en su sitio web.
Y en nuestro blog también puedes leer:
- «»;
- «»;
- «»;
- «».
Fuente: habr.com
