

Me llamo Víctor Yagofarov y desarrollo la plataforma de Kubernetes en la empresa DomClick como líder técnico del equipo de Ops (operaciones). Quiero hablar sobre cómo están organizados nuestros procesos Dev Ops, sobre las particularidades de la gestión de uno de los clústeres de k8s más grandes de Rusia, así como sobre las prácticas de DevOps/SRE que aplica nuestro equipo.
Equipo de Ops
Actualmente, en el equipo de Ops trabajan 15 personas. Tres de ellas se encargan de la oficina, dos trabajan en otra zona horaria y están disponibles, incluso, durante la noche. Así, siempre hay alguien del equipo de Ops frente al monitor y listo para reaccionar ante cualquier incidente. No tenemos turnos nocturnos, lo que preserva nuestra salud mental y permite a todos dormir bien y disfrutar de su tiempo libre fuera del ordenador.
Las competencias son variadas: hay expertos en redes, DBA, especialistas en la pila ELK, administradores/desarrolladores de Kubernetes, expertos en monitoreo, virtualización, hardware, etc. Lo que une a todos es que cada uno puede, en cierta medida, reemplazar a cualquier otro: por ejemplo, añadir nuevos nodos al clúster de k8s, actualizar PostgreSQL, escribir un pipeline CI/CD + Ansible, automatizar algo en Python/Bash/Go, conectar hardware en el centro de datos. Tener habilidades fuertes en un área no impide cambiar de dirección y empezar a desarrollarse en otra. Por ejemplo, me uní a la empresa como especialista en PostgreSQL, y ahora mi principal responsabilidad son los clústeres de Kubernetes. En el equipo, cualquier crecimiento es bienvenido y hay un fuerte sentido de apoyo mutuo.
Por cierto, estamos buscando talento. Los requisitos para los candidatos son bastante estándar. Personalmente, me importa que la persona se integre bien en el equipo, sea no conflictiva, pero también sepa defender su punto de vista, desee desarrollarse y no tema hacer algo nuevo, proponiendo sus ideas. Además, son imprescindibles habilidades de programación en lenguajes de script, conocimientos básicos de Linux y un nivel de inglés suficiente. El inglés es necesario simplemente para que la persona, en caso de error, pueda buscar la solución al problema en 10 segundos en lugar de 10 minutos. Actualmente, es muy difícil encontrar especialistas con un profundo conocimiento de Linux: es curioso, pero dos de cada tres candidatos no pueden responder a la pregunta «¿Qué es el Load Average? ¿De qué se compone?», y consideran que la pregunta «¿Cómo generar un core dump de un programa en C?» es algo del mundo de los superhumanos… o de los dinosaurios. Hay que aceptar esto, ya que generalmente las personas tienen competencias muy desarrolladas en otros ámbitos, y nosotros podemos enseñarles sobre Linux. La respuesta a la pregunta «¿por qué todo esto es necesario para un ingeniero DevOps en el mundo actual de la nube?» tendrá que quedar fuera del alcance del artículo, pero en tres palabras: todo esto es necesario.
Equipo de Herramientas
El equipo de Herramientas juega un papel importante en la automatización. Su tarea principal es crear herramientas gráficas y de línea de comandos convenientes para los desarrolladores. Por ejemplo, nuestro desarrollo interno Confer permite, literalmente, desplegar una aplicación en Kubernetes con solo unos clics, configurar sus recursos, claves de vault, etc. Antes utilizábamos Jenkins + Helm 2, pero fue necesario desarrollar nuestra propia herramienta para eliminar el copiar y pegar y aportar uniformidad al ciclo de vida del software.
El equipo de Ops no escribe pipelines para los desarrolladores, pero puede asesorar sobre cualquier cuestión relacionada con su redacción (algunos todavía usan Helm 3).
DevOps
En cuanto a DevOps, lo vemos así:
Los equipos de Dev escriben código y lo despliegan a través de Confer en dev -> qa/stage -> prod. La responsabilidad de que el código no se detenga y no arroje errores recae en los equipos de Dev y Ops. Durante el día, la persona de guardia del equipo de Ops debe ser la primera en reaccionar ante un incidente con su aplicación, y durante la noche, el administrador de guardia (Ops) debe despertar al desarrollador de guardia si sabe con certeza que el problema no está en la infraestructura. Todas las métricas y alertas en la monitorización aparecen de manera automática o semi-automática.
La zona de responsabilidad de Ops comienza en el momento del despliegue de la aplicación en producción, pero la responsabilidad de Dev no termina ahí; hacemos lo mismo y estamos en el mismo barco.
Los desarrolladores consultan a los administradores si necesitan ayuda para escribir un microservicio administrativo (por ejemplo, backend en Go + HTML5), y los administradores consultan a los desarrolladores sobre cualquier cuestión de infraestructura o sobre temas relacionados con k8s.
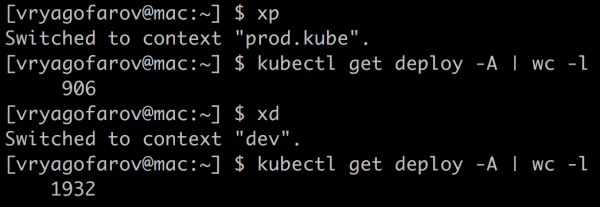
Por cierto, no tenemos monolitos, solo microservicios. Su número oscila entre 900 y 1000 en el clúster k8s de producción, si medimos por la cantidad de despliegues. La cantidad de pods varía entre 1700 y 2000. Actualmente hay alrededor de 2000 pods en el clúster de producción.
No puedo dar números exactos, ya que estamos monitoreando los microservicios innecesarios y los eliminamos de forma semi-automática. Monitorear las entidades innecesarias en k8s nos ayuda , lo que ahorra recursos y dinero.
Gestión de recursos
Monitoreo
La piedra angular de la explotación de un gran clúster es un monitoreo bien estructurado e informativo. Aún no hemos encontrado una solución universal que cubra el 100% de todas las necesidades de monitoreo, por lo que periódicamente creamos diferentes soluciones personalizadas en este entorno.
- Zabbix. El antiguo y buen monitoreo, que está destinado, en primer lugar, a rastrear el estado general de la infraestructura. Nos informa cuándo un nodo falla por CPU, memoria, discos, red, etc. No es nada sobrenatural, pero también tenemos un DaemonSet separado de agentes, con los que, por ejemplo, monitoreamos el estado de DNS en el clúster: buscamos pods de coredns que se están estancando, comprobamos la disponibilidad de hosts externos. Podría parecer innecesario preocuparse por eso, pero a grandes volúmenes de tráfico, este componente se convierte en un punto crítico de fallo. Anteriormente ya he , cómo luché contra el rendimiento de DNS en el clúster.
- Prometheus Operator. Un conjunto de diversos exportadores proporciona una visión amplia de todos los componentes del clúster. Luego, visualizamos todo esto en grandes tableros en Grafana, y para las notificaciones utilizamos alertmanager.
Otro instrumento útil para nosotros ha sido . Lo escribimos después de encontrarnos varias veces con la situación en la que un equipo bloquea el Ingress de otro equipo, lo que provoca errores 50x. Ahora, antes del despliegue en producción, los desarrolladores verifican que no afecten a nadie, y para mi equipo, es una buena herramienta para el diagnóstico inicial de problemas con Ingress. Curiosamente, originalmente se creó para administradores y tenía un aspecto bastante "tosco", pero después de que a las equipos de desarrollo les gustara la herramienta, se transformó significativamente y ya no parece una "interfaz web hecha por administradores para administradores". Pronto nos desharemos de esta herramienta y situaciones similares se validarán antes de que se despliegue el pipeline.
Recursos de los equipos en "Kube"
Antes de proceder con los ejemplos, vale la pena explicar cómo trabajamos la asignación de recursos para microservicios.
Para entender qué equipos y en qué cantidades utilizan sus recursos (CPU, memoria, SSD local), asignamos a cada equipo su propio namespace en "Kube" y limitamos sus máximas capacidades en CPU, memoria y disco, después de discutir las necesidades de los equipos. De este modo, un equipo, en general, no bloqueará todo el clúster para el despliegue, al reservarse miles de núcleos y terabytes de memoria. Los accesos al namespace se otorgan a través de AD (utilizamos RBAC). Los namespaces y sus límites se añaden a través de un pull request en el repositorio de GIT, y luego todo se despliega automáticamente a través de un pipeline de Ansible.
Ejemplo de asignación de recursos para un equipo:
namespaces:

  chat-team:
    pods: 23
    limits:
      cpu: 11
      memory: 20Gi
    requests:
      cpu: 11
      memory: 20Gi
Solicitudes y límites
En "Kube" Request — es la cantidad de recursos garantizados reservados para pod (uno o más contenedores Docker) en el clúster. Limit — es un máximo no garantizado. A menudo se puede ver en los gráficos cómo algún equipo se asignó demasiadas solicitudes para todas sus aplicaciones y no puede desplegar una aplicación en "Kube", ya que en su namespace ya se han "gastado" todas las solicitudes.
La salida correcta de tal situación: observar el consumo real de recursos y compararlo con la cantidad solicitada (Request).
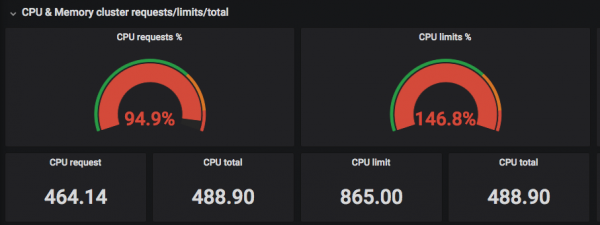
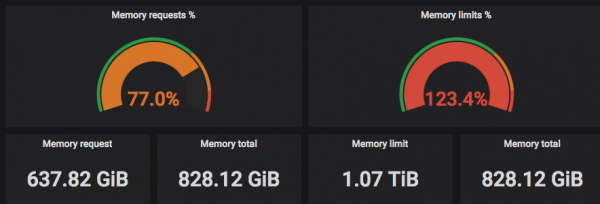
En las capturas de pantalla anteriores, se puede ver que las "solicitadas" (Requested) CPU se ajustan a la cantidad real de hilos, mientras que los límites pueden exceder la cantidad real de hilos de los procesadores centrales =)
Ahora desglosaremos un namespace (he elegido el namespace kube-system, que es el namespace del sistema para los componentes de "Kube") y veremos la relación entre el tiempo de CPU y la memoria realmente utilizada y la solicitada:
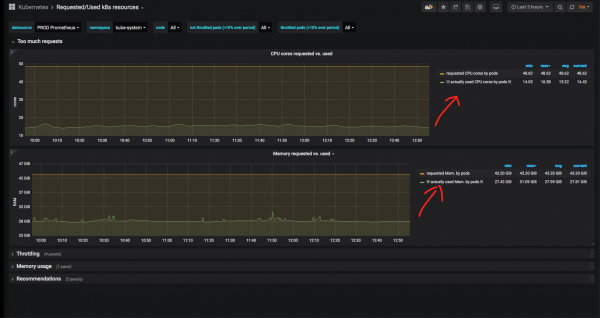
Es evidente que se ha reservado mucho más memoria y CPU para los servicios del sistema de lo que se utiliza realmente. En el caso del kube-system, esto es justificado: ha habido ocasiones en que el controlador de ingreso nginx o nodelocaldns en su pico alcanzaron el límite de CPU y consumieron mucha RAM, por lo que este margen es justificable. Además, no podemos depender de los gráficos de las últimas 3 horas; es preferible ver métricas históricas durante un periodo más amplio.
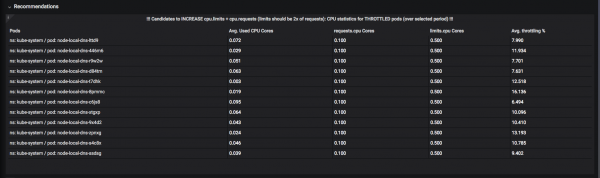
Se ha desarrollado un sistema de "recomendaciones". Por ejemplo, aquí se puede ver qué recursos sería mejor aumentar los "límites" (el límite superior permitido) para que no ocurra "throttling": el momento en que se ha consumido CPU o memoria por el tiempo asignado y se está a la espera de que lo "descongelen":
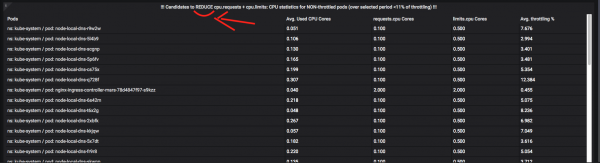
Y aquí están los pods que deberían moderar su apetito:
Sobre throttling + el monitoreo de recursos puede dar para no un artículo, por lo tanto, hagan preguntas en los comentarios. En pocas palabras, puedo decir que la tarea de automatizar métricas de este tipo es bastante complicada y requiere mucho tiempo y equilibrio con las funciones "window" y "CTE" de Prometheus / VictoriaMetrics (estos términos están entre comillas, ya que en PromQL casi no hay nada similar, y hay que elaborar consultas complejas que ocupan varias pantallas de texto y optimizarlas).
Al final, los desarrolladores tienen herramientas para monitorear sus namespaces en "Kube", y pueden elegir por sí mismos dónde y cuándo se pueden "recortar" recursos de ciertas aplicaciones, mientras que a algunos pods se les puede dejar todo el CPU toda la noche.
Metodologías
En la empresa, como está de moda ahora de moda, nos adherimos a las prácticas de DevOps y SRE-prácticas. Cuando hay 1000 microservicios en la empresa, alrededor de 350 desarrolladores y 15 administradores para toda la infraestructura, se tiene que "estar a la moda": detrás de todos esos "buzzwords" se esconde una necesidad urgente de automatización de todo, y los administradores no deben ser un cuello de botella en los procesos.
Como Ops, proporcionamos diversas métricas y tableros para desarrolladores relacionados con la velocidad de respuesta de los servicios y sus errores.
Utilizamos metodologías como: , y , combinándolos juntos. Nos esforzamos por minimizar la cantidad de paneles para que a simple vista sea claro qué servicio está degradándose en este momento (por ejemplo, códigos de respuesta por segundo, tiempo de respuesta en el percentil 99), y así sucesivamente. En cuanto necesitamos nuevas métricas para los paneles generales, inmediatamente las diseñamos y añadimos.
No he dibujado gráficos en un mes. Tal vez eso sea una buena señal: significa que la mayoría de los 'deseos' ya se han realizado. En ocasiones, durante una semana, al menos una vez al día dibujaba un nuevo gráfico.
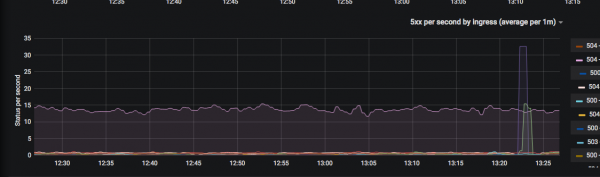
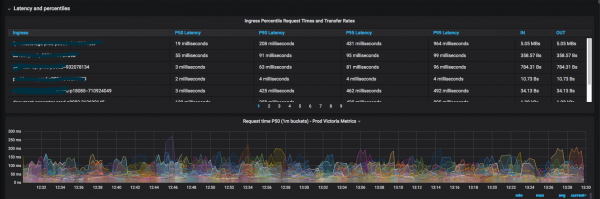
El resultado conseguido es valioso porque ahora los desarrolladores rara vez vienen a los administradores con preguntas de 'dónde ver alguna métrica'.
Implementación Service Mesh no está lejos y debería facilitar mucho la vida a todos, los colegas de Tools ya están cerca de implementar el 'Istio del hombre sano': el ciclo de vida de cada solicitud HTTP(s) será visible en la monitorización, y siempre se podrá entender 'en qué etapa todo se rompió' durante las interacciones entre servicios (y no solo). Suscríbete a las noticias del hub de la empresa DomClick. =)
Soporte de la infraestructura de Kubernetes
Históricamente, hemos utilizado una versión parcheada Kubespray — un rol de Ansible para desplegar, expandir y actualizar Kubernetes. En algún momento, se eliminó el soporte para instalaciones no kubeadm de la rama principal, y el proceso de transición a kubeadm no se propuso. Como resultado, la empresa Southbridge hizo su propio fork (con soporte para kubeadm y una rápida solución de problemas críticos).
El proceso de actualización de todos los clústeres de k8s es el siguiente:
- Tomamos Kubespray de Southbridge, comparamos con nuestra rama, fusionamos.
- Desplegamos la actualización en Stress- 'Cubo'.
- Desplegamos la actualización nodo por nodo (en Ansible es 'serial: 1') en Dev- 'Cubo'.
- Actualizamos Prod el sábado por la noche nodo por nodo.
En el futuro, hay planes de reemplazar Kubespray por algo más rápido y cambiar a kubeadm.
En total, tenemos tres 'Cubos': Stress, Dev y Prod. Planeamos lanzar otro (hot standby) el Prod-'Cubo' en el segundo centro de datos. Stress y Dev viven en 'virtual machines' (oVirt para Stress y VMWare cloud para Dev). Prod- 'Cubo' vive en 'hardware desnudo' (bare metal): son nodos idénticos con 32 hilos de CPU, 64-128 GB de memoria y 300 GB SSD RAID 10 — en total hay 50. Tres nodos 'delgados' están reservados para el 'maestro' Prod- 'Cubo': 16 GB de memoria, 12 hilos de CPU.
Para la producción, preferimos utilizar 'hardware desnudo' y evitamos capas innecesarias como OpenStack: no necesitamos 'vecinos ruidosos' y tiempo de CPU steal timeLa complejidad de la administración aumenta aproximadamente el doble en el caso de OpenStack in-house.
Para CI/CD de componentes «Kube» y otras infraestructuras, utilizamos un servidor GIT separado, Helm 3 (pasamos de manera algo dolorosa de Helm 2, pero estamos muy contentos con la opción atomic), Jenkins, Ansible y Docker. Nos gustan las feature branches y el despliegue en diferentes entornos desde un solo repositorio.
Conclusión
Así, a grandes rasgos, se ve el proceso de DevOps en la empresa DomClick desde la perspectiva de un ingeniero de operaciones. El artículo resultó ser menos técnico de lo que esperaba: por lo tanto, mantente al tanto de las novedades de DomClick en Habr: habrá artículos más «hardcore» sobre Kubernetes y más.
Fuente: habr.com
