

Ya hemos hablado sobre , que permite desarrollar aplicaciones distribuidas y empaquetarlas. Solo queda una cosa: aprender a desplegar estas aplicaciones y administrarlas. ¡No se preocupen, hemos pensado en todo! Hemos reunido todas las mejores prácticas para trabajar con Tarantool Cartridge y hemos escrito , que desplegará el paquete en los servidores, iniciará las instancias, las unirá en un clúster, configurará la autorización, will bootstrap vshard, habilitará el failover automático y parcheará la configuración del clúster.
¿Interesado? Entonces por favor, sigue leyendo, te contaremos y mostraremos todo.
Comencemos con un ejemplo
Solo veremos una parte de la funcionalidad de nuestro rol. Puedes encontrar la descripción completa de todas sus capacidades y parámetros de entrada en . Pero es mejor probar una vez que ver cien, así que vamos a desplegar una pequeña aplicación.
Tarantool Cartridge ofrece la creación de una pequeña aplicación Cartridge que almacena información sobre los clientes del banco y sus cuentas, y también proporciona una API para gestionar datos a través de HTTP. Para ello, el aplicativo describe dos roles posibles: api y almacenamiento, que pueden ser asignados a las instancias.
Cartridge no indica cómo ejecutar procesos, solo proporciona la posibilidad de configurar las instancias ya iniciadas. El resto, el usuario tiene que hacerlo por sí mismo: desplegar archivos de configuración, iniciar servicios y configurar la topología. Pero no haremos nada de esto, lo hará Ansible por nosotros.
De la palabra a la acción
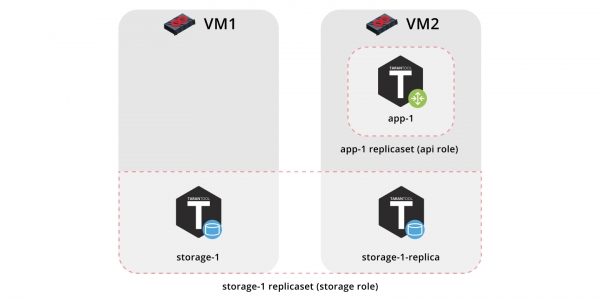
Así que desplegaremos nuestra aplicación en dos máquinas virtuales y configuraremos una topología simple:
- El replicaset
app-1implementará el rolapi, que incluye el rolvshard-router. Aquí solo habrá una instancia. - El replicaset
storage-1implementa el rolalmacenamiento(y al mismo tiempovshard-storage), aquí añadiremos dos instancias desde diferentes máquinas.
Para ejecutar el ejemplo necesitaremos y (versión 2.8 o superior).
El rol mismo se encuentra en . Este es un repositorio que permite compartir tus desarrollos y usar roles listos.
Clonemos el repositorio del ejemplo:
$ git clone https://github.com/dokshina/deploy-tarantool-cartridge-app.git
$ cd deploy-tarantool-cartridge-app && git checkout 1.0.0
Levantamos las máquinas virtuales:
$ vagrant upInstalamos el rol de ansible de Tarantool Cartridge:
$ ansible-galaxy install tarantool.cartridge,1.0.1Ejecutamos el rol instalado:
$ ansible-playbook -i hosts.yml playbook.ymlEsperamos a que termine la ejecución del playbook, y pasamos a y disfrutamos del resultado:
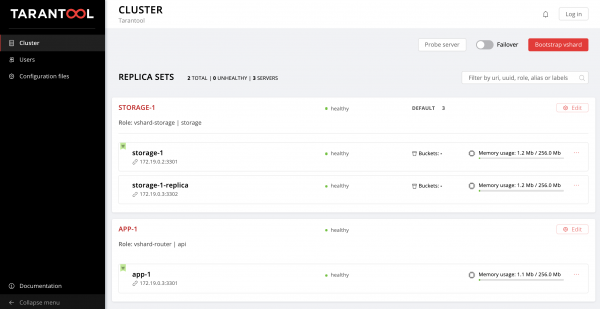
Se pueden enviar datos. Genial, ¿verdad?
Ahora vamos a ver cómo trabajar con esto, y también añadiremos otro conjunto de réplicas a la topología.
Empezamos a investigar
Entonces, ¿qué ha pasado?
Levantamos dos máquinas virtuales y ejecutamos un playbook de ansible que configuró nuestro clúster. Veamos el contenido del archivo y probar a ejecutarlo::
---
- name: Desplegar mi aplicación Tarantool Cartridge
  hosts: all
  become: true
  become_user: root
  tasks:
  - name: Importar el rol de Tarantool Cartridge
    import_role:
      name: tarantool.cartridge
Aquí no pasa nada interesante, solo ejecutamos el rol de ansible llamado tarantool.cartridge.
Lo más importante (es decir, la configuración del clúster) se encuentra en -el archivo hosts.yml:
---
all:
  vars:
    # variables comunes del clúster
    cartridge_app_name: getting-started-app
    cartridge_package_path: .\/getting-started-app-1.0.0-0.rpm  # ruta al paquete

    cartridge_cluster_cookie: app-default-cookie  # cookie del clúster

    # opciones comunes de ssh
    ansible_ssh_private_key_file: ~\/\.vagrant.d\/insecure_private_key
    ansible_ssh_common_args: '-o IdentitiesOnly=yes -o UserKnownHostsFile=\/dev\/null -o StrictHostKeyChecking=no'

  # INSTANCIAS
  hosts:
    storage-1:
      config:
        advertise_uri: '172.19.0.2:3301'
        http_port: 8181

    app-1:
      config:
        advertise_uri: '172.19.0.3:3301'
        http_port: 8182

    storage-1-replica:
      config:
        advertise_uri: '172.19.0.3:3302'
        http_port: 8183

  children:
    # AGRUPAR INSTANCIAS POR MÁQUINAS
    host1:
      vars:
        # opciones de conexión para la primera máquina
        ansible_host: 172.19.0.2
        ansible_user: vagrant

      hosts:  # instancias que se iniciarán en la primera máquina
        storage-1:

    host2:
      vars:
        # opciones de conexión para la segunda máquina
        ansible_host: 172.19.0.3
        ansible_user: vagrant

      hosts:  # instancias que se iniciarán en la segunda máquina
        app-1:
        storage-1-replica:

    # AGRUPAR INSTANCIAS POR CONJUNTOS DE RÉPLICAS
    replicaset_app_1:
      vars:  # configuración del conjunto de réplicas
        replicaset_alias: app-1
        failover_priority:
          - app-1  # líder
        roles:
          - 'api'

      hosts:  # instancias del conjunto de réplicas
        app-1:

    replicaset_storage_1:
      vars:  # configuración del conjunto de réplicas
        replicaset_alias: storage-1
        weight: 3
        failover_priority:
          - storage-1  # líder
          - storage-1-replica
        roles:
          - 'storage'

      hosts:   # instancias del conjunto de réplicas
        storage-1:
        storage-1-replica:
Todo lo que necesitamos es aprender a gestionar las instancias y los conjuntos de réplicas, modificando el contenido de este archivo. Más adelante, iremos añadiendo nuevas secciones. Para no confundirse sobre dónde añadirlas, pueden consultar la versión final de este archivo, hosts.updated.yml, que se encuentra en el repositorio de ejemplos.
Gestión de instancias
En términos de Ansible, cada instancia es un host (no confundir con un servidor físico), es decir, un nodo de infraestructura que Ansible gestionará. Para cada host, podemos especificar parámetros de conexión (como ansible_host y ansible_user), así como la configuración de la instancia. La descripción de las instancias se encuentra en la sección hosts.
Consideremos la configuración de la instancia storage-1:
todos:
  vars:
    ...

  # INSTANCIAS
  hosts:
    storage-1:
      config:
        advertise_uri: '172.19.0.2:3301'
        http_port: 8181

  ...
En la variable config hemos especificado los parámetros de la instancia — URI de anuncio y Puerto HTTP.
A continuación se presentan los parámetros de las instancias app-1 y storage-1-replica.
Necesitamos informar a Ansible los parámetros de conexión para cada instancia. Parece lógico agrupar las instancias por máquinas virtuales. Para ello, las instancias se agrupan en grupos host1 y host2, y en cada grupo en la sección vars se indican los valores ansible_host y ansible_user para una sola máquina virtual. Y en la sección hosts — hosts (también conocidos como instancias), que pertenecen a este grupo:
todos:
  vars:
    ...
  hosts:
    ...
  children:
    # AGRUPAR INSTANCIAS POR MÁQUINAS
    host1:
      vars:
        # opciones de conexión de la primera máquina
        ansible_host: 172.19.0.2
        ansible_user: vagrant
       hosts:  # instancias a iniciarse en la primera máquina
        storage-1:

     host2:
      vars:
        # opciones de conexión de la segunda máquina
        ansible_host: 172.19.0.3
        ansible_user: vagrant
       hosts:  # instancias a iniciarse en la segunda máquina
        app-1:
        storage-1-replica:
Comenzamos a modificar hosts.yml. Agregaremos otras dos instancias, storage-2-replica en la primera máquina virtual y storage-2 en la segunda:
todos:
  vars:
    ...

  # INSTANCIAS
  hosts:
    ...
    storage-2:  # <==
      config:
        advertise_uri: '172.19.0.3:3303'
        http_port: 8184

    storage-2-replica:  # <==
      config:
        advertise_uri: '172.19.0.2:3302'
        http_port: 8185

  children:
    # AGRUPAR INSTANCIAS POR MÁQUINAS
    host1:
      vars:
        ...
      hosts:  # instancias a iniciarse en la primera máquina
        storage-1:
        storage-2-replica:  # <==

    host2:
      vars:
        ...
      hosts:  # instancias a iniciarse en la segunda máquina
        app-1:
        storage-1-replica:
        storage-2:  # <==
  ...
Ejecutamos el playbook de ansible:
$ ansible-playbook -i hosts.yml
                   --limit storage-2,storage-2-replica
                   playbook.yml
Tenga en cuenta la opción --limit. Dado que cada instancia del clúster es un host en términos de Ansible, podemos especificar explícitamente qué instancias deben configurarse al ejecutar el playbook.
Nuevamente accedemos a la interfaz web y observamos nuestras nuevas instancias:
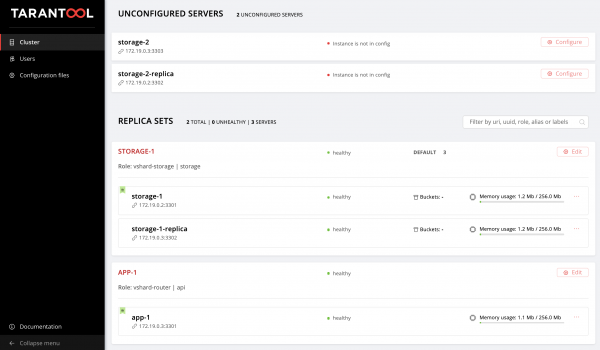
No nos detendremos aquí y dominaremos la gestión de la topología.
Gestión de la topología
Uniremos nuestras nuevas instancias en un conjunto de réplicas storage-2. Agregaremos un nuevo grupo replicaset_storage_2 y describiremos en sus variables los parámetros del conjunto de réplicas de manera similar a replicaset_storage_1. En la sección hosts especificaremos qué instancias formarán parte de este grupo (es decir, nuestro conjunto de réplicas):
---
all:
  vars:
    ...
  hosts:
    ...
  children:
    ...
    # AGRUPAR INSTANCIAS POR CONJUNTOS DE REPLICAS
    ...
    replicaset_storage_2:  # <==
      vars:  # configuración del conjunto de replicas
        replicaset_alias: storage-2
        weight: 2
        failover_priority:
          - storage-2
          - storage-2-replica
        roles:
          - 'storage'

      hosts:   # instancias del conjunto de replicas
        storage-2:
        storage-2-replica:
Reiniciamos el playbook:
$ ansible-playbook -i hosts.yml
                   --limit replicaset_storage_2
                   --tags cartridge-replicasets
                   playbook.yml
En el parámetro --limit esta vez hemos pasado el nombre del grupo que corresponde a nuestro conjunto de replicas.
Veamos la opción tags.
Nuestro rol ejecuta de manera secuencial varias tareas que están marcadas con las siguientes etiquetas:
cartridge-instances: gestión de instancias (configuración, conexión a membership);cartridge-replicasets: gestión de la topología (gestión de conjuntos de replicas y expulsión irreversible de instancias del clúster);cartridge-config: gestión de otros parámetros del clúster (vshard bootstrapping, modo de failover automático, parámetros de autorización y configuración de la aplicación).
Podemos especificar explícitamente qué parte del trabajo queremos realizar, entonces el rol omitirá el resto de las tareas. En nuestro caso, queremos trabajar solo con la topología, por lo que hemos indicado cartridge-replicasets.
Evaluemos el resultado de nuestros esfuerzos. Encontramos un nuevo conjunto de replicas en .
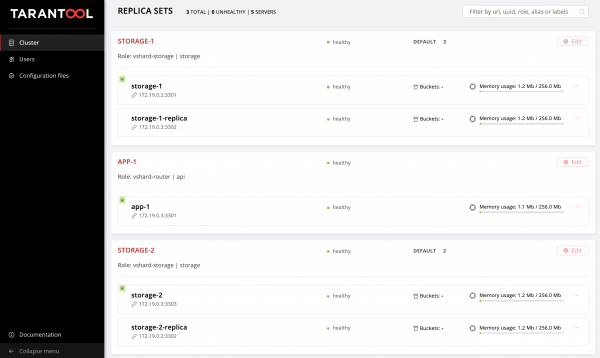
¡Hurra!
Experimente con cambios en la configuración de instancias y conjuntos de replicas y observe cómo cambia la topología del clúster. Puede probar diferentes escenarios operativos, como o aumento de memtx_memory. El rol intentará realizar esto sin reiniciar la instancia para reducir el posible tiempo de inactividad de su aplicación.
No olvide ejecutar vagrant halt, para detener las máquinas virtuales cuando termine de trabajar con ellas.
¿Y qué hay bajo el capó?
Aquí explicaré en detalle lo que sucedió bajo el capó del rol de ansible durante nuestros experimentos.
Veamos paso a paso el despliegue de la aplicación Cartridge.
Instalación del paquete y arranque de instancias
Primero, se debe entregar el paquete al servidor e instalarlo. Ahora el rol puede trabajar con paquetes RPM y DEB.
Luego, arrancamos las instancias. Aquí todo es muy simple: cada instancia es un servicio separado. Lo explico con un ejemplo: systemd$ systemctl start myapp@storage-1
Este comando arrancará la instancia.La instancia arrancada buscará su storage-1 aplicación myappconfiguración. en /etc/tarantool/conf.d/El archivo Unit journald.
para el servicio systemd se entregará junto con el paquete. /etc/systemd/system/myapp@.sevice для systemd-сервиса будет доставлен вместе с пакетом.
En Ansible hay módulos integrados para la instalación de paquetes y la gestión de servicios systemd, aquí no hemos inventado nada nuevo.
Configuración de la topología del clúster
Y aquí es donde comienza lo más interesante. Admitámoslo, sería extraño complicarse con un rol especial de Ansible para la instalación de paquetes y el inicio systemd-de servicios.
Se puede configurar el clúster manualmente:
- Primera opción: abrimos la interfaz web y presionamos los botones. Para iniciar varios instancias una vez, es bastante adecuado.
- Segunda opción: se puede utilizar la API de GraphQL. Aquí ya se puede automatizar algo, por ejemplo, escribir un script en Python.
- Tercera opción (para los valientes): entramos en el servidor, nos conectamos a una de las instancias usando
tarantoolctl connecty realizamos todas las manipulaciones necesarias con el módulo Luacartridge.
La tarea principal de nuestra invención es hacer precisamente esta parte del trabajo, la más complicada, por ustedes.
Ansible permite escribir su propio módulo y usarlo en un rol. Nuestro rol utiliza estos módulos para gestionar varios componentes del clúster.
¿Cómo funciona? Describen el estado deseado del clúster en una configuración declarativa, y el rol provee a cada módulo su sección de configuración. El módulo obtiene el estado actual del clúster y lo compara con lo que recibió como entrada. A continuación, a través del socket de una de las instancias, se ejecuta el código que lleva el clúster al estado deseado.
Resultados
Hoy les mostramos cómo desplegar su aplicación en Tarantool Cartridge y configurar una topología simple. Para ello usamos Ansible, una herramienta potente que se caracteriza por su facilidad de uso y permite configurar múltiples nodos de infraestructura simultáneamente (en nuestro caso, son instancias del clúster).
Arriba hemos explorado una de las muchas formas de describir la configuración del clúster utilizando Ansible. Una vez que comprendan que están listos para avanzar, estudien para escribir playbooks. Puede que les resulte más cómodo gestionar la topología usando group_vars y host_vars.
Pronto les contaremos cómo eliminar de manera irreversible (expel) instancias de la topología, bootstrap vshard, gestionar el modo de failover automático, configurar la autorización y parchear la configuración del clúster. Mientras tanto, pueden seguir investigando por su cuenta. y experimentar con el cambio de los parámetros del clúster.
Si algo no funciona, asegúrate de sobre el problema. ¡Lo resolveremos rápidamente!
Fuente: habr.com
