

Fuente:
La regresión lineal es uno de los algoritmos básicos para muchas áreas relacionadas con el análisis de datos. La razón es obvia. Es un algoritmo muy simple y comprensible, lo que contribuye a su amplia aplicación durante muchas décadas, si no cientos de años. La idea es que suponemos una dependencia lineal de una variable respecto a un conjunto de otras variables, y luego intentamos recuperar esa dependencia.
Pero en este artículo no se tratará sobre la aplicación de la regresión lineal para resolver problemas prácticos. Aquí se discutirán características interesantes de la implementación de algoritmos distribuidos para su recuperación, con las que nos encontramos al escribir el módulo de aprendizaje automático en . Un poco de matemáticas básicas, fundamentos de aprendizaje automático y computación distribuida ayudarán a entender cómo recuperar la regresión lineal, incluso si los datos están distribuidos entre miles de nodos.
¿De qué se trata?
Se nos presenta la tarea de recuperar una dependencia lineal. Como datos de entrada se proporciona un conjunto de vectores de variables presuntamente independientes, a cada uno de los cuales se le asigna un cierto valor de variable dependiente. Estos datos se pueden representar en forma de dos matrices:

Ahora, dado que se supone una dependencia, y además lineal, escribamos nuestra suposición en forma de producto de matrices (para simplificar la notación, de aquí en adelante se supone que el término independiente de la ecuación está oculto detrás de  , y la última columna de la matriz
 contiene unos):

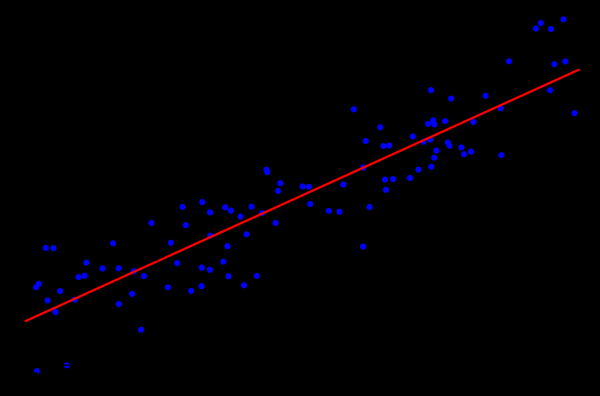
Se parece mucho a un sistema de ecuaciones lineales, ¿no es así? Se parece, pero es probable que no haya soluciones para dicho sistema de ecuaciones. La razón de esto es el ruido que está presente en prácticamente todos los datos reales. También puede ser que no exista una dependencia lineal como tal, con la que se pueda intentar combatir introduciendo variables adicionales que dependan no linealmente de las originales. Consideremos el siguiente ejemplo:
Fuente:
Este es un ejemplo simple de regresión lineal que demuestra la dependencia de una variable (en el eje  ) de otra variable (en el eje
 ). Para que el sistema de ecuaciones lineales correspondiente a este ejemplo tenga solución, todos los puntos deben estar exactamente en una misma línea. Pero no es así. Y no están en una misma línea precisamente por el ruido (o porque la suposición de la existencia de dependencia lineal fue errónea). Así, para restaurar la dependencia lineal a partir de datos reales, generalmente es necesario introducir otra suposición: los datos de entrada contienen ruido y este ruido tiene . Se pueden hacer suposiciones sobre otros tipos de distribución de ruido, pero en la gran mayoría de los casos se considera precisamente la distribución normal, de la cual se hablará a continuación.
Método de máxima verosimilitud
Entonces, hemos supuesto la existencia de un ruido aleatorio normalmente distribuido. ¿Cómo actuar en tal situación? Para este caso, en matemáticas existe y se utiliza ampliamente . En resumen, su esencia radica en la elección y su posterior maximización.
Regresamos a la restauración de la dependencia lineal a partir de datos con ruido normal. Observemos que la dependencia lineal supuesta es la esperanza matemática  de la distribución normal existente. Al mismo tiempo, la probabilidad de que
 tome un determinado valor, dado que hay observables
 , se ve de la siguiente manera:

Ahora sustituiremos en lugar de  y
 las variables que necesitamos:

Solo queda encontrar el vector  , en el que esta probabilidad es máxima. Para maximizar tal función, es conveniente primero logaritmarla (el logaritmo de la función alcanzará su máximo en el mismo punto que la propia función):

Lo que, a su vez, se reduce a la minimización de la siguiente función:

Por cierto, esto se llama el método . A menudo, se omiten todas las consideraciones anteriores y simplemente se utiliza este método.
Descomposición QR
Se puede encontrar el mínimo de la función mencionada anteriormente si se encuentra el punto en el que el gradiente de esta función es igual a cero. Y el gradiente se escribirá de la siguiente manera:

es un método matricial para resolver el problema de minimización que se utiliza en el método de los mínimos cuadrados. En este sentido, reescribimos la ecuación en forma matricial:

Entonces, descomponemos la matriz  en matrices
 y
 y realizamos una serie de transformaciones (el algoritmo QR de descomposición no se discutirá aquí, solo su uso relativo a la tarea planteada):

Matriz  es ortogonal. Esto nos permite deshacernos del producto
 :

Y si reemplazamos  en
 , entonces obtendremos
 . Teniendo en cuenta que
 es una matriz triangular superior, esto se ve de la siguiente manera:

Esto se puede resolver mediante el método de sustitución. El elemento  se encuentra como
 , el elemento anterior
 se encuentra como
 y así sucesivamente.
Cabe señalar que la complejidad del algoritmo resultante debido al uso de la descomposición QR es igual a  . Aunque la operación de multiplicación de matrices se puede paralelizar bien, no parece posible escribir una versión distribuida efectiva de este algoritmo.
Descenso por gradiente
Al hablar de la minimización de alguna función, siempre se debe recordar el método (estocástico) de descenso de gradientes. Este es un método simple y efectivo de minimización, basado en el cálculo iterativo del gradiente de la función en un punto y su posterior desplazamiento en dirección opuesta al gradiente. Cada uno de estos pasos acerca la solución al mínimo. El gradiente se ve igual:

Además, este método se puede paralelizar y distribuir bien gracias a las propiedades lineales del operador gradiente. Notemos que en la fórmula anterior, bajo el signo de suma, hay términos independientes. En otras palabras, podemos calcular el gradiente de manera independiente para todos los índices  desde el primero hasta
 , paralelamente, calcular el gradiente para los índices desde
 hasta
 . Luego, sumamos los gradientes obtenidos. El resultado de la suma será el mismo que si hubiéramos calculado el gradiente de una vez para los índices desde el primero hasta
 . Así, si los datos están distribuidos entre varias partes, el gradiente puede ser calculado independientemente en cada parte, y luego los resultados de estos cálculos se pueden sumar para obtener el resultado final:

Desde el punto de vista de la implementación, esto se ajusta a la paradigma . En cada paso del descenso de gradientes, se envía una tarea a cada nodo de datos para calcular el gradiente, luego se recolectan los gradientes calculados y el resultado de su suma se utiliza para mejorar el resultado.
A pesar de la simplicidad de implementación y la posibilidad de ejecución en la paradiгma MapReduce, el descenso de gradiente también tiene sus desventajas. En particular, el número de pasos necesarios para alcanzar la convergencia es significativamente mayor en comparación con otros métodos más especializados.
LSQR
es otro método para resolver el problema planteado, que es adecuado tanto para la recuperación de la regresión lineal como para la solución de sistemas de ecuaciones lineales. Su principal característica es que combina las ventajas de los métodos matriciales y el enfoque iterativo. Las implementaciones de este método se pueden encontrar en la biblioteca , así como en . No se proporcionará una descripción de este método (se puede encontrar en el artículo ). En su lugar, se demostrará un enfoque que permite adaptar LSQR para su ejecución en un entorno distribuido.
El método LSQR se basa en . Es un procedimiento iterativo, donde cada iteración consta de los siguientes pasos:
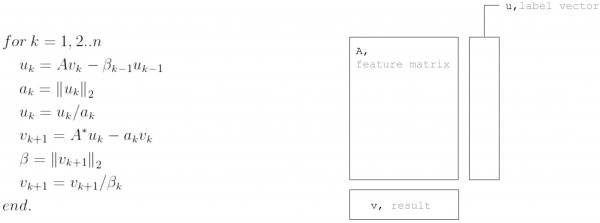
Pero suponiendo que la matriz  está particionada horizontalmente, cada iteración se puede representar en forma de dos pasos MapReduce. De esta manera, se logra minimizar la transferencia de datos durante cada iteración (solo vectores de longitud igual al número de incógnitas):
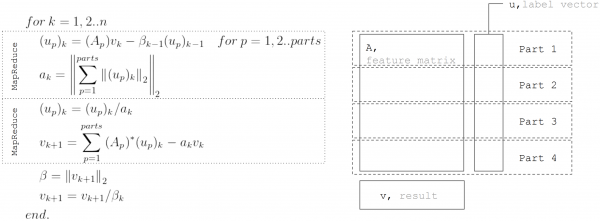
Este enfoque se utiliza en la implementación de la regresión lineal en .
Conclusión
Existen muchos algoritmos para la recuperación de la regresión lineal, pero no todos pueden aplicarse en cualquier situación. Por ejemplo, la descomposición QR es excelente para resolver con precisión en pequeños conjuntos de datos. El descenso de gradiente se implementa fácilmente y permite encontrar rápidamente una solución aproximada. LSQR, por su parte, combina las mejores propiedades de los dos algoritmos anteriores, ya que puede ser distribuido, converge más rápido en comparación con el descenso de gradiente y también permite la detención temprana del algoritmo, a diferencia de la descomposición QR para la búsqueda de soluciones aproximadas.
Fuente: habr.com
