

Transcripción de la presentación de 2015 de Ilya Kosmodemyansky "Ajustes de Linux para mejorar el rendimiento de PostgreSQL"
Descargo de responsabilidad: Cabe mencionar que esta presentación está fechada en noviembre de 2015 — ha pasado más de 4 años y ha transcurrido mucho tiempo. La versión de PostgreSQL mencionada en la presentación 9.4 ya no es compatible. En los últimos 4 años, se han lanzado 5 nuevas versiones de PostgreSQL y 15 versiones del núcleo de Linux. Si se reescribieran esos puntos, resultaría en una presentación diferente. Sin embargo, aquí se trata del ajuste fundamental de Linux para PostgreSQL, que sigue siendo relevante hoy en día.
Me llamo Ilya Kosmodemyansky. Trabajo en la empresa PostgreSQL-Consulting. Y ahora hablaré un poco sobre qué hacer con Linux en relación a las bases de datos en general y a PostgreSQL en particular, porque los principios son bastante similares.
¿De qué se trata esta charla? Si te comunicas con PostgreSQL, hasta cierto punto necesitas ser un administrador de UNIX. ¿Qué significa esto? Si comparamos Oracle y PostgreSQL, en Oracle necesitas ser un 80 % DBA del administrador de bases de datos y un 20 % administrador de Linux.
Con PostgreSQL es un poco más complicado. Con PostgreSQL necesitas tener una comprensión mucho mejor de cómo funciona Linux. Y al mismo tiempo, necesitas seguir el ritmo, porque últimamente todo se actualiza bastante. Y aparecen nuevos núcleos, nuevas funcionalidades, se mejora el rendimiento, etc.
¿Por qué hablamos de Linux? No es porque estemos en la conferencia de Linux en San Petersburgo, sino porque en las condiciones modernas, uno de los sistemas operativos más justificados para operar con bases de datos en general y con PostgreSQL en particular es Linux. Porque FreeBSD, lamentablemente, se desarrolla en una dirección muy extraña. Y habrá problemas tanto con el rendimiento como con muchas otras cosas. El rendimiento de PostgreSQL en Windows es un tema aparte, que se basa en el hecho de que Windows no tiene memoria compartida como UNIX, y PostgreSQL depende completamente de esto, ya que es un sistema multiprocesador.
Y excentricidades como Solaris, creo que interesan a menos personas, así que continuemos.
Una distribución de Linux moderna tiene más de 1,000 parámetros syctl, dependiendo de cómo se compile el núcleo. Además, si miramos diferentes configuraciones, hay muchas maneras de ajustar algo. Hay parámetros de sistemas de archivos, sobre cómo montarlos. Si hay preguntas sobre cómo iniciar, qué habilitar en el BIOS, cómo configurar el hardware, etc.
Este es un volumen muy grande del que se puede hablar durante varios días, y no en una breve presentación, pero ahora me detendré en cosas importantes, como evitar aquellos escollos que sin duda no les permitirán aprovechar bien la base de datos en Linux si no los corrigen. Y hay un punto importante, que muchos parámetros por defecto no están configurados de manera adecuada para la base de datos. Es decir, por defecto funcionará mal o no funcionará en absoluto.
¿Cuáles son los objetivos tradicionales de ajuste en Linux? Creo que ya que todos ustedes están familiarizados con la administración de Linux, no es necesario explicar qué son los objetivos.
Se puede ajustar:
- CPU.
- Memoria.
- Almacenamiento.
- Otros. De esto hablaremos al final como un aperitivo. Incluso, por ejemplo, parámetros como la política de ahorro de energía pueden influir de manera muy impredecible y no tan agradable en el rendimiento.
¿Cuál es la especificidad de PostgreSQL y de la base de datos en general? El problema es que no se puede ajustar algún tornillo por separado y esperar que el rendimiento mejore significativamente.
Sí, hay tornillos, pero la base de datos es algo complejo. Interactúa con todos los recursos disponibles del servidor y prefiere interactuar plenamente. Si observas las recomendaciones modernas de Oracle sobre cómo utilizar el sistema operativo host, será como el chiste del cosmonauta mongol: alimentar al perro y no tocar nada. Démosle a la base todos los recursos, la base de datos se encargará de todo.
En principio, con PostgreSQL hay una situación similar. La diferencia radica en que la base de datos aún no puede reclamar todos los recursos por sí misma, es decir, en algún lugar es necesario manejar esto a nivel de Linux de manera independiente.
La idea principal es no elegir un único objetivo y comenzar a ajustarlo, ya sea memoria, CPU o algo por el estilo, sino analizar la carga de trabajo e intentar mejorar al máximo el rendimiento, para que la carga que los buenos programadores nos han creado, incluidos nuestros usuarios, pase a través de nuestra base de datos de la manera más eficiente.
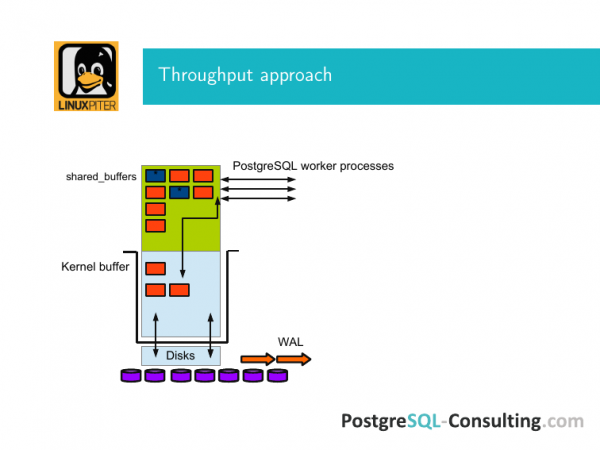
Esta es una imagen para explicar qué es esto. Hay un buffer en el sistema operativo Linux, hay memoria compartida y hay buffers compartidos de PostgreSQL. A diferencia de Oracle, PostgreSQL trabaja directamente solo a través del buffer del núcleo, es decir, para que una página del disco llegue a su memoria compartida, debe pasar por el buffer del núcleo y volver, exactamente la misma situación.
Bajo este sistema viven los discos. Lo he dibujado como discos. En realidad, puede haber un controlador RAID, etc.
Y esta entrada y salida de datos, de una manera u otra, ocurre a través de esto.
PostgreSQL es una base de datos clásica. Dentro hay páginas. Y toda la entrada y salida se realiza mediante estas páginas. Levantamos bloques en memoria usando páginas. Y si no ha pasado nada, simplemente las hemos leído, entonces, poco a poco, desaparecen de esa caché, de los buffers compartidos, y van de vuelta al disco.
Si hemos reemplazado algo en algún lugar, entonces toda la página se marca como sucia. Las marqué aquí en color azul. Y eso significa que esta página debe sincronizarse con el almacenamiento de bloques. Es decir, cuando la hacemos sucia, hacemos una escritura en el WAL. Y en un momento dado, ocurre un fenómeno llamado checkpoint. Y se registró información en este log de que ha llegado. Y eso significa que todas las páginas sucias que estaban en ese momento en estos buffers compartidos se sincronizaron con el disco de almacenamiento mediante fsync a través del buffer del núcleo.
¿Para qué se hace esto? Si perdemos la alimentación, no queremos que se pierdan todos los datos. La memoria persistente, de la que nos han hablado, aún está en la teoría de bases de datos: es un futuro brillante al que, por supuesto, aspiramos y nos gusta, pero hasta ahora viven 20 años en el pasado. Y, por supuesto, es necesario monitorear todo esto.
La tarea de maximizar el rendimiento es optimizar en todas estas etapas para que todo funcione rápidamente de un lado a otro. La memoria compartida es principalmente la caché de páginas. En PostgreSQL, enviamos una consulta select y obtuvo estos datos del disco. Fueron a los buffers compartidos. Por lo tanto, para que esto funcione mejor, debe haber mucha memoria.
Para que todo esto funcione bien y rápido, es necesario configurar correctamente el sistema operativo en todas las etapas. Además, es importante seleccionar un hardware equilibrado, porque si hay algún desequilibrio en algún lugar, puedes tener mucha memoria, pero su rendimiento será insuficiente.
Y revisemos cada uno de estos puntos.
Para que estas páginas viajen de un lado a otro más rápido, se deben lograr lo siguiente:
- Primero, hay que trabajar de manera más eficiente con la memoria.
- Segundo, debe ser más eficiente esta transición, cuando las páginas de la memoria llegan al disco.
- Y, en tercer lugar, deben haber buenos discos.
Si tienes 512 GB de memoria RAM en servidor y todo esto finalmente llega a un disco duro SATA sin ningún tipo de caché, entonces todo el servidor de bases de datos se convierte no solo en una calabaza, sino en una calabaza con interfaz SATA. Te encontrarás directamente con este problema. Y nada te salvará.
En cuanto al primer punto sobre la memoria, hay tres cosas que pueden complicar mucho la vida.
La primera de ellas es NUMA. NUMA es un concepto diseñado para mejorar el rendimiento. Dependiendo de la carga de trabajo, se pueden optimizar diferentes aspectos. Y en su forma actual, no es muy bueno para aplicaciones como bases de datos que utilizan intensamente la caché compartida de páginas.
En pocas palabras. ¿Cómo saber que algo está mal con NUMA? Tienes algún tipo de ruido desagradable, de repente alguna CPU se encuentra sobrecargada. Mientras tanto, analizas las consultas en PostgreSQL y ves que no hay nada de este tipo. Estas consultas no deberían consumir CPU de manera tan intensa. Puede llevar tiempo detectarlo. Es más fácil seguir desde el principio la recomendación correcta sobre cómo configurar NUMA para PostgreSQL.
¿Qué es lo que realmente está sucediendo? NUMA significa Non-Uniform Memory Access. ¿En qué consiste? Tienes un CPU, y junto a él hay su memoria local. Y esta memoria puede acceder a la memoria de otros CPUs a través de interconexiones.
Si ejecutas numactl --hardware, obtendrás una gran hoja de datos. Entre otras cosas, habrá un campo de distancias. Habrá números – 10-20, algo por el estilo. Estos números son la cantidad de saltos necesarios para acceder a esa memoria remota y usarla localmente. En principio, es una buena idea. Esto mejora significativamente el rendimiento bajo ciertas cargas.
Ahora imagina que tienes un CPU que primero intenta usar su memoria local, luego intenta acceder a otra memoria a través del interconect para algo. Y en este CPU se aloja todo tu caché de páginas de PostgreSQL: todos esos gigabytes. Siempre obtienes el peor de los casos, porque en el CPU directamente en ese módulo de memoria suele haber poco. Y toda la memoria que se gestiona pasa a través de estos interconectores. Se vuelve lenta y problemática. Y tienes un procesador que atiende esta unidad, constantemente abrumado. Y el tiempo de acceso a esa memoria es malo, lento. Esta es la situación que no deseas si utilizas esto para una base de datos.
Por eso, la opción más correcta para la base de datos es que el sistema operativo Linux no sepa en absoluto lo que está ocurriendo. Para que acceda a la memoria como siempre lo hace.
¿Por qué es así? Aparentemente, debería ser al revés. Esto ocurre por una razón muy simple: necesitamos mucha memoria para el caché de páginas, decenas, cientos de gigabytes.
Y si hemos asignado todo esto y hemos cacheado nuestros datos allí, entonces la ganancia de usar el caché será sustancialmente mayor que cualquier beneficio de un acceso a la memoria más ingenioso. Así, ganaríamos de manera incomparables en comparación con lo que lograríamos teniendo un acceso más eficiente a la memoria usando NUMA.
Por lo tanto, hay dos enfoques en este momento, mientras no llegue un futuro brillante y la base de datos no pueda decidir por sí misma en qué CPU está trabajando y de dónde necesita obtener algo.
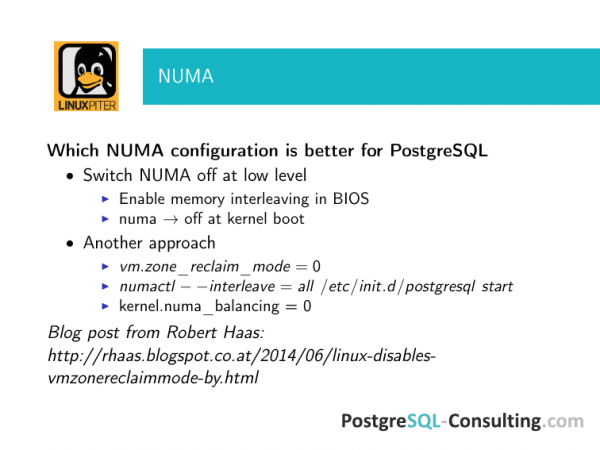
Así que el enfoque correcto es desactivar NUMA por completo., por ejemplo, al reiniciar. En la mayoría de los casos, las ganancias son tan significativas que no surge la pregunta de cuál es la mejor opción.
Hay otra opción. La utilizamos más a menudo que la primera, porque cuando un cliente llega a nosotros en soporte, reiniciar el servidor es un gran asunto para él. Su negocio está en funcionamiento. Y experimentan problemas debido a NUMA. Por eso intentamos desactivarlo de maneras menos invasivas que reiniciar, pero aquí hay que tener cuidado, verificar que realmente se haya desactivado. Porque, como muestra la experiencia, desactivar NUMA para el proceso padre de PostgreSQL es bueno, pero no es necesariamente que eso funcione. Hay que verificar y asegurarse de que realmente se haya desactivado.
Hay un buen post de Robert Haas. Es uno de los committers de PostgreSQL. Uno de los desarrolladores clave de todas las entrañas de bajo nivel. Y si sigues los enlaces de este post, encontrarás varias historias coloridas sobre cómo el NUMA complicó la vida de las personas. Mira, estudia la lista de verificación del administrador del sistema sobre lo que se debe configurar en el servidor para que nuestra base de datos funcione bien. Estas configuraciones deben ser registradas y verificadas, porque de lo contrario no irá muy bien.
Quiero señalar que esto se aplica a todas las configuraciones de las que voy a hablar. Pero comúnmente, las bases de datos se configuran en modo master-slave para la redundancia. No olvides realizar estos ajustes en el slave, porque en un momento dado tendrás una falla, y cambiarás al slave, que se convertirá en el master.
En una situación de emergencia, cuando todo está muy mal, tu teléfono sonará constantemente y tu jefe aparecerá con un garrote grande; no tendrás tiempo para pensar en verificar. Y los resultados pueden ser bastante desastrosos.
El siguiente punto es las huge pages. Es complicado probar las huge pages por separado, y tampoco tiene sentido hacerlo, aunque hay benchmarks que pueden hacerlo. Se encuentran fácilmente en Google.
¿Cuál es el sentido? Tienes un servidor no muy caro, con mucha memoria RAM, por ejemplo, más de 30 GB. No utilizas huge pages. Esto significa que definitivamente hay sobrecarga en el uso de la memoria. Y esa sobrecarga no es nada agradable.
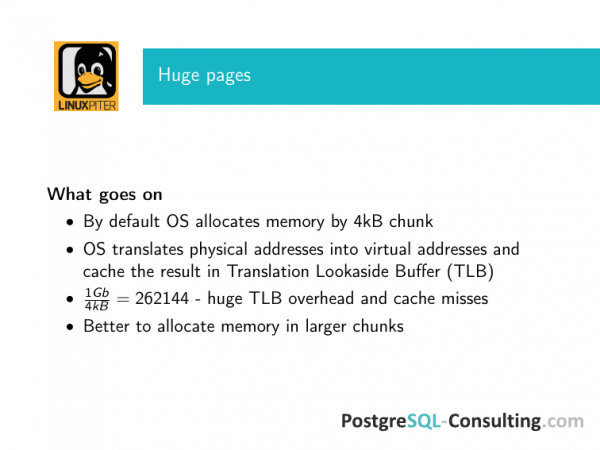
¿Por qué es así? ¿Y qué está sucediendo? El sistema operativo asigna memoria en pequeños trozos. Es conveniente, así se ha hecho históricamente. Y si nos adentramos en los detalles, el sistema operativo debe traducir direcciones virtuales a físicas. Y este proceso no es el más sencillo, por lo que el sistema operativo almacena el resultado de esta operación en el Translation Lookaside Buffer (TLB).
Y dado que el TLB es una caché, en esta situación surgen todos los problemas inherentes a las cachés. En primer lugar, si tienes mucha memoria RAM y toda ella está asignada en pequeños trozos, entonces este búfer se vuelve muy grande. Y si la caché es grande, buscar a través de ella es más lento. La sobrecarga es significativa y consume espacio, es decir, la memoria RAM está ocupada por algo que no es correcto. Eso es uno.
Cuanto más crece la caché en esta situación, mayor es la probabilidad de que tenga fallos de caché. La eficiencia de esta caché cae rápidamente a medida que aumenta su tamaño. Por ello, en los sistemas operativos se ideó un enfoque simple. En Linux se ha utilizado desde hace tiempo. En FreeBSD, esto apareció no hace mucho. Pero estamos hablando de Linux. Se trata de huge pages.
Es importante señalar que la idea de huge pages fue impulsada inicialmente por comunidades que incluían a Oracle e IBM, es decir, los fabricantes de bases de datos pensaron firmemente que esto sería útil, incluso para bases de datos.
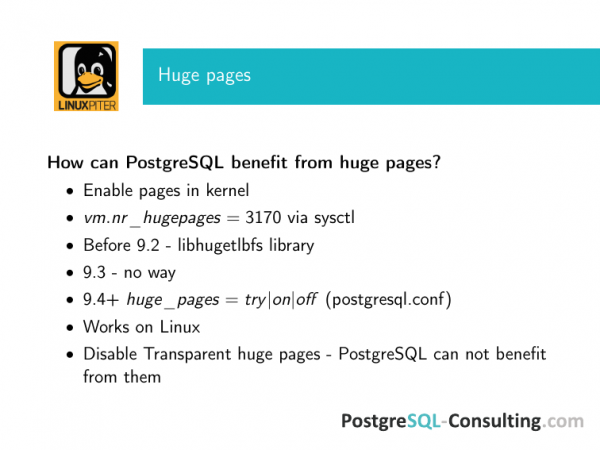
¿Y cómo se integra esto con PostgreSQL? Primero, el núcleo de Linux debe tener habilitadas las huge pages.
En segundo lugar, deben indicarse explícitamente mediante el parámetro sysctl – cuántas hay. Las cifras aquí provienen de algún viejo servidor. Puede calcular cuántos buffers compartidos tiene, para que las huge pages quepan dentro.
Y si tiene todo el servidor dedicado a PostgreSQL, un buen punto de partida es asignar el 25 % de la memoria RAM a los buffers compartidos, o el 75 %, si está seguro de que su base de datos puede caber en esos 75 %. Este es el primer punto de partida. Y calcule, si tiene 256 GB de memoria RAM, entonces, por lo tanto, tendrá 64 GB de buffers compartidos. Calcule con un margen de seguridad – en qué debe estar establecido este número.
Hasta la versión 9.2 (si no me equivoco, desde la versión 8.2) era posible integrar PostgreSQL con huge pages mediante una biblioteca externa. Y esto siempre debe hacerse. Primero, necesita que el núcleo pueda asignar huge pages correctamente. Y en segundo lugar, que la aplicación que trabaja con ellas pueda utilizarlas. No se aprovechará por sí sola. Dado que PostgreSQL asignó memoria al estilo de system 5, esto se podía hacer con libhugetlbfs — este es el nombre completo de la biblioteca.
En 9.3 se mejoró el rendimiento de PostgreSQL en el manejo de la memoria y se abandonó el método de asignación de memoria system 5. Todos estaban muy contentos, porque de lo contrario, al intentar iniciar dos instancias de PostgreSQL en una misma máquina, te dice que no hay suficiente memoria compartida. Y menciona que hay que ajustar el sysctl. Y ese sysctl es tal que hay que reiniciar y demás. En general, todos se alegraron. Pero la asignación de memoria mmap rompió el uso de huge pages. La mayoría de nuestros clientes utilizan grandes buffers compartidos. Y recomendamos encarecidamente no actualizar a 9.3, porque el overhead empezaba a contarse en buenos porcentajes.
Sin embargo, la comunidad prestó atención a este problema y en 9.4 se trabajó muy bien en este aspecto. Y en 9.4 apareció un parámetro en postgresql.conf, donde puedes habilitar try, on u off.
Try es el parámetro más seguro. Al iniciar PostgreSQL, cuando asigna memoria compartida, intenta tomar de huge pages esa memoria. Y si no tiene éxito, vuelve a la asignación normal. Y si estás en FreeBSD o Solaris, puedes usar try, siempre es seguro.
Si está on, simplemente no se iniciará si no pudo asignar de huge pages. Aquí ya depende de cada uno. Pero si tienes try, verifica que realmente se haya asignado lo necesario, porque hay mucho margen para el error. Actualmente, esta funcionalidad solo funciona en Linux.
Una pequeña nota antes de avanzar. Transparent huge pages no se aplica a PostgreSQL por ahora. No puede utilizarlas de manera adecuada. Y en el caso de Transparent huge pages, para una carga de trabajo que necesita un gran bloque de memoria compartida, las ventajas solo se presentan en volúmenes muy grandes. Si tienes terabytes de memoria, entonces esto puede tener importancia. Si hablamos de aplicaciones más comunes, donde tienes 32, 64, 128, 256 GB de memoria en la máquina, entonces simplemente huge pages está bien, y desactivamos Transparent.
Y la última cosa relacionada con la memoria, que no está directamente vinculada al flujo de datos, puede arruinar mucho. Todo el ancho de banda se ve afectado seriamente si el servidor está constantemente haciendo swap.
Y esto será muy desagradable en varios momentos. Y el principal inconveniente radica en que en los núcleos modernos el comportamiento es un poco diferente al de los núcleos Linux más antiguos. Y esto es algo con lo que es bastante incómodo lidiar, porque cuando hablamos de alguna operación con swap, esto termina no siendo la llegada oportuna del OOM-killer. Y el OOM-killer que llegó tarde y eliminó PostgreSQL es molesto. Todos, es decir, hasta el último usuario, se darán cuenta de esto.
¿Qué está pasando? Tienes una gran cantidad de memoria RAM, todo funciona bien. Pero por alguna razón, el servidor se queda atascado en swap y eso lo ralentiza. Podría parecer que hay mucha memoria, pero esto ocurre.
Antes recomendábamos establecer vm.swappiness en cero, es decir, desactivar swap. Antes parecía que 32 GB de memoria RAM y los buffers compartidos correspondientes eran una cantidad enorme. La función principal del swap es proporcionar un espacio donde enviar un núcleo si fallamos. Y eso ya no se estaba cumpliendo. ¿Y qué harás luego con este núcleo? Esa es ya una tarea en la que no está muy claro para qué sirve el swap, aún más de tal tamaño.
Pero en los núcleos modernos, es decir, en las versiones tres, el comportamiento ha cambiado. Y si ajustas swap a cero, es decir, lo apagas, tarde o temprano, incluso con una cierta cantidad de memoria RAM restante, el OOM-killer vendrá a matar a los consumidores más intensivos. Porque él considerará que con tal carga de trabajo nos queda un poco y vamos a fallar, es decir, no apuñalar el proceso del sistema, sino eliminar algo menos importante. Lo menos importante resultará ser el consumidor intensivo de memoria compartida, a saber, postmaster. Y después de esto, será un alivio si no tienes que restaurar la base de datos.
Por lo tanto, ahora por defecto, si no me equivoco, la mayoría de las distribuciones utilizan alrededor de 6, es decir, en qué momento comenzamos a utilizar swap dependiendo de cuánta memoria queda. Ahora recomendamos establecer vm.swappiness = 1, porque esto prácticamente lo apaga, pero evita los efectos de una llegada inesperada del OOM-killer que lo elimina todo.
¿Qué sigue? Cuando hablamos del rendimiento de las bases de datos y poco a poco nos acercamos a los discos, todos empiezan a agarrarse la cabeza. Porque la verdad de que el disco es lento y la memoria es rápida es algo que todos conocen desde pequeños. Y todos saben que en las bases de datos habrá problemas con el rendimiento del disco.
El principal problema con el rendimiento de PostgreSQL, relacionado con los picos de checkpoints, no surge porque el disco sea lento. Más bien se debe a que el ancho de banda de la memoria y el disco no están equilibrados. Además, pueden estar desbalanceados en diferentes lugares. PostgreSQL no está configurado, el SO no está configurado, el hardware no está configurado y el hardware es incorrecto. Y este problema no ocurre solo si todo se hace como debe ser, es decir, o no hay carga, o las configuraciones y el hardware están bien seleccionados.
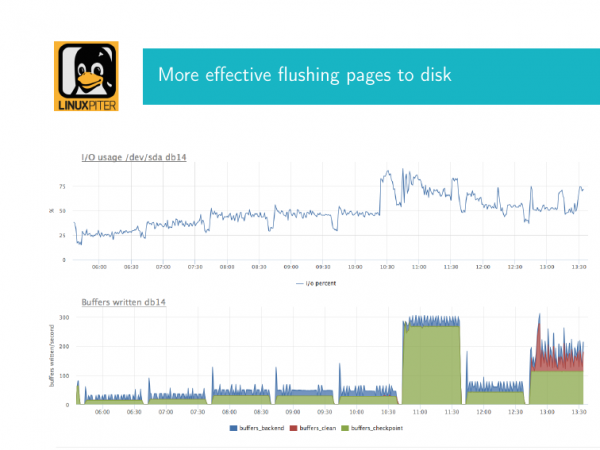
¿Qué es esto y cómo se ve? Normalmente, las personas que trabajan con PostgreSQL han pasado por esto varias veces. Lo explicaré. Como dije, PostgreSQL hace checkpoints periódicamente para volcar las páginas sucias de la memoria compartida al disco. Si tenemos un gran volumen de memoria compartida, el checkpoint comienza a afectar intensamente al disco porque vuelca estas páginas usando fsync. Llega al kernel buffer y se escribe en los discos mediante fsync. Y si el volumen de esto es grande, podemos observar un efecto desagradable, a saber, una utilización del disco muy alta.
Aquí tengo dos imágenes. Ahora explicaré qué son. Son dos gráficos correlacionados en el tiempo. El primer gráfico es la utilización del disco. Aquí alcanza casi el 90% en ese momento. Si su base de datos cae con discos físicos, con un controlador RAID y la utilización está al 90%, entonces son malas noticias. Esto significa que un poco más y llegará al 100% y la entrada/salida se detendrá.
Si tiene un arreglo de discos, la historia es un poco diferente. Ahí depende de cómo esté configurado, qué tipo de arreglo, etc.
Y paralelamente aquí se ha configurado un gráfico de una vista interna de Postgres que indica cómo se realiza el checkpoint. Y en color verde se muestra cuántos buffers, estas páginas sucias, llegaron en ese momento a este checkpoint para sincronización. Y esto es lo principal que se debe saber aquí. Vemos que hay muchas páginas que llegaron y en algún momento nos topamos con la placa, es decir, estuvimos escribiendo constantemente, aquí claramente el sistema de discos está muy ocupado. Y nuestro checkpoint está afectando mucho al disco. En un escenario ideal, la situación debería verse, más bien, así, es decir, aquí hubo menos escritura. Y con la configuración podemos arreglar esto para que siga así. Es decir, la utilización es baja, pero en algún lugar estamos escribiendo.
¿Qué se debe hacer para resolver este problema? Si su IO se ha detenido en la base de datos, significa que todos los usuarios que vinieron a ejecutar sus consultas estarán esperando.
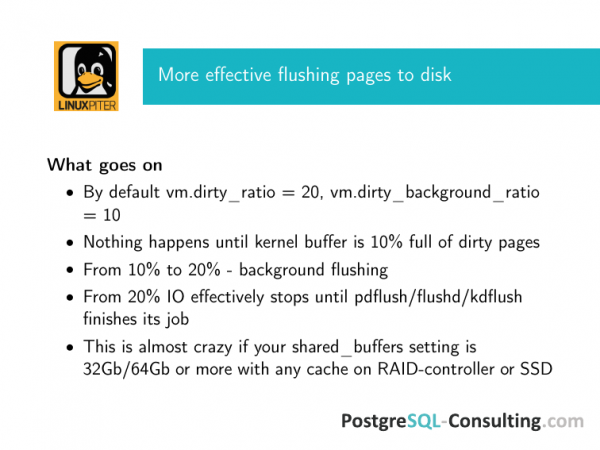
Si se observa desde el punto de vista de Linux, si ha tomado un buen hardware, lo ha configurado correctamente y ha ajustado adecuadamente PostgreSQL para que realice estos checkpoints con menos frecuencia, esparciéndolos en el tiempo uno entre otro, entonces está utilizando los parámetros predeterminados de Debian. Para la mayoría de las distribuciones de Linux, esta es la situación: vm.dirty_ratio=20, vm.dirty_background_ratio=10.
¿Qué significa esto? A partir del núcleo 2.6, apareció un demonio de flushing. Pgflush, dependiendo de cuál se utilice, se encarga de la descarga en segundo plano de las páginas sucias del buffer del núcleo y descarga, cuando sea necesario, las páginas sucias, cuando el flushing en segundo plano ya no es suficiente.
¿Cuándo se activa el fondo? Cuando el 10 % de toda la memoria RAM en el servidor está ocupada por páginas sucias en el buffer del núcleo, se llama a una función especial de escritura en segundo plano. ¿Por qué es de fondo? Toma como parámetro cuántas páginas escribir. Y, por ejemplo, escribe N páginas. Y por un tiempo, esta cosa se duerme. Luego vuelve y escribe otra cantidad de páginas.
Esta es una historia extremadamente simple. Aquí la tarea es como con una piscina, cuando se vierte en un tubo y se llena en otro. Nuestro checkpoint ha llegado y si ha enviado pocas páginas sucias para descarga, gradualmente se dispersará todo esto cuidadosamente desde el buffer del núcleo pgflush.
Si siguen acumulándose esas páginas sucias, se acumulan hasta el 20%, después de esto, la prioridad del sistema operativo es escribir todo esto en el disco, porque la alimentación se cortará, y estaremos en problemas. Perderemos esos datos, por ejemplo.
¿Cuál es el truco? El truco consiste en que estos parámetros en el mundo moderno, el 20% y el 10% de toda la memoria RAM disponible en la máquina, son completamente monstruosos desde el punto de vista del rendimiento de cualquier sistema de disco que tengas.
Imagina que tienes 128 GB de memoria RAM. 12,8 GB llegan a tu sistema de disco. Y por mucho que tengas caché allí, o por mucho que tengas un arreglo, no soportarán tanto.
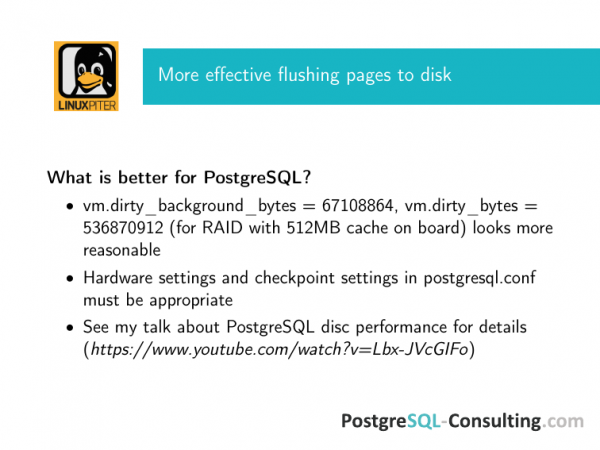
Por lo tanto, recomendamos configurar esos números desde la capacidad de tu controlador RAID. Aquí hay una recomendación para un controlador que tiene 512 MB de caché.
Todo se considera de manera muy simple. Se puede establecer vm.dirty_background en bytes. Y esas configuraciones anulan las dos anteriores. O el ratio por defecto, o las activadas con bytes, funcionarán las que tienen bytes. Pero dado que soy consultor DBA y trabajo con diferentes clientes, trato de ponerme a cubierto, así que si en bytes, entonces en bytes. Nadie ha dado ninguna garantía de que un buen administrador no le agregue memoria al servidor, no lo reinicie, y el número permanezca igual. Simplemente calculen esos números, para garantizar que todo quepa ahí.
¿Qué sucede si no cabe? Se dice que se detiene efectivamente cualquier flushing, pero en realidad es una figura retórica. El sistema operativo tiene un gran problema: tiene muchas páginas sucias, por lo tanto se detiene efectivamente la IO que generan tus clientes, es decir, cuando una aplicación envía una consulta SQL a la base, está en espera. Cualquier entrada/salida en ella está en la prioridad más baja, porque la base está ocupada con el checkpoint. Y cuándo lo terminará es completamente incierto. Y cuando has alcanzado el flushing no de fondo, no background, significa que toda tu IO está ocupada con eso. Y mientras no termine, no podrás hacer nada.
Aquí hay otros dos puntos importantes que están más allá de este informe. Estas configuraciones deben coincidir con las configuraciones en postgresql.conf, es decir, las configuraciones de checkpoints. Y tu sistema de disco debe estar adecuadamente configurado. Si tienes caché en RAID, debe haber una batería en él. Las personas compran RAID con buen caché sin batería. Si tienes SSD en RAID, deben ser de servidor, deben tener condensadores. Aquí hay una lista de verificación detallada. En este enlace está mi informe sobre cómo configurar el rendimiento del disco en PostgreSQL. Ahí están todas estas listas de verificación.
¿Qué más puede complicar la vida? Son dos parámetros. Son relativamente nuevos. Pueden estar habilitados por defecto en diferentes aplicaciones. Y pueden complicar la vida tanto como si están habilitados incorrectamente.
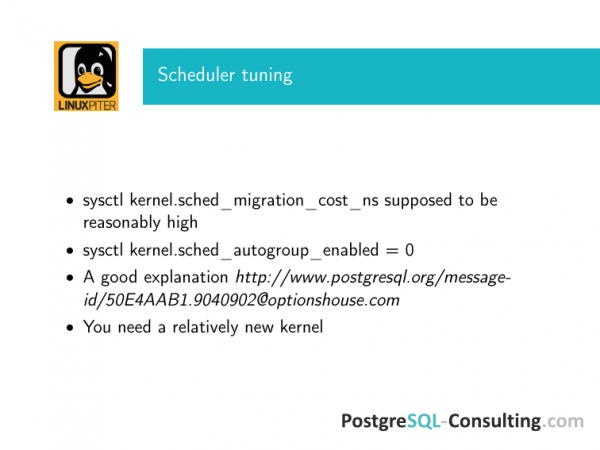
Hay dos cosas relativamente nuevas. Ya aparecen en los núcleos tres. Son sched_migration_cost en nanosegundos y sched_autogroup_enabled, que por defecto es uno.
¿Y cómo arruinan la vida? ¿Qué es sched_migration_cost? El planificador de Linux puede migrar un proceso de una CPU a otra. Y para PostgreSQL, que ejecuta consultas, la migración a otra CPU no tiene sentido. Desde la perspectiva del sistema operativo, cuando cambias entre ventanas de openoffice y terminal, puede que sea bueno, pero para la base de datos, esto es muy malo. Por lo tanto, una política sensata es establecer el migration_cost en un valor grande, al menos en varios miles de nanosegundos.
¿Qué significará esto para el planificador? Considerará que durante ese tiempo este proceso todavía está caliente. Es decir, si tienes alguna transacción larga que está haciendo algo, el planificador lo entenderá. Considerará que mientras no pase este tiempo de espera, no es necesario migrar este proceso a ningún lado. Si este proceso está haciendo algo, no se migrará a ningún otro lugar, terminará tranquilamente en la CPU que se le asignó. Y el resultado es excelente.
El segundo punto es autogroup. Hay una buena idea para cargas de trabajo específicas, que no tienen relación con bases de datos modernas, que es agrupar procesos según el terminal virtual desde el cual fueron iniciados. Esto es conveniente para algunas tareas. En la práctica, PostgreSQL es un sistema multiproceso con prefork que se inicia desde un solo terminal. Tendrá un bloqueador de escritura, un checkpoint, y todas sus solicitudes de clientes se agruparán en un solo programador, en una sola CPU. Y estarán allí esperando pacíficamente a que se libere, interrumpiéndose entre sí y ocupándolo por más tiempo. Esta es una situación que no se necesita en caso de tal carga y, por lo tanto, debe desactivarse.
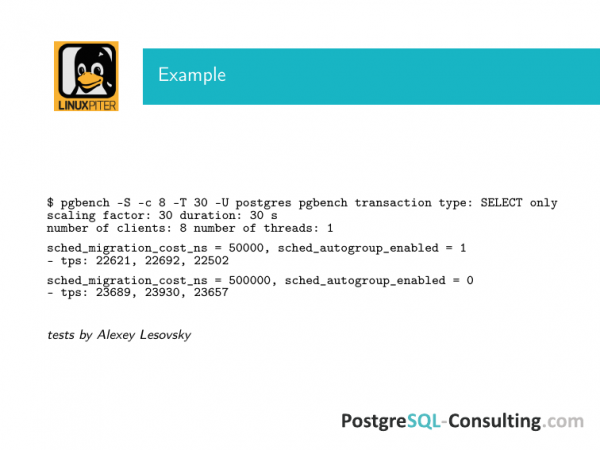
Mi colega Alexéi Lesovski realizó pruebas con un pgbench simple, donde aumentó en un orden el migration_cost y desactivó el autogroup. La diferencia en un hardware deficiente fue de casi un 10%.. Hay una discusión en la lista de correo de PostgreSQL donde la gente presenta resultados sobre cómo tales cambios afectaron la velocidad de las consultas. influyeron en un 50%.. Hay muchas historias como estas.
Y por último, sobre la política de ahorro de energía. Es bueno que ahora se pueda usar Linux en una laptop. Y supuestamente consumirá bien la batería. Pero resulta que esto también puede ocurrir en un servidor.
Además, si alquila servidores a algún proveedor de hosting, entonces los "amables" hosting no se preocupan por que tenga un mejor rendimiento. Su tarea es asegurarse de que su hardware se utilice de manera más eficiente. Por lo tanto, pueden habilitar de forma predeterminada el modo de ahorro de energía de laptop en el sistema operativo.
Si utiliza en un servidor con una base de datos bajo carga intensa esta opción, su elección es acpi_cpufreq + performance. Incluso con ondemand ya habrá problemas.
Intel_pstate es un controlador un poco diferente. Y ahora se prefiere este, ya que es más reciente y funciona mejor.
Y, por lo tanto, el gobernador solo debe ser performance. Ondemand, powersave y todo lo demás no son para usted.
Los resultados del explain analyze en PostgreSQL pueden diferir en varios órdenes de magnitud si habilita powersave, porque prácticamente el CPU bajo su base de datos se programará de manera completamente impredecible.
Estas configuraciones pueden estar habilitadas por defecto. Échale un vistazo detenidamente - verifica si están habilitadas por defecto. Esto puede ser realmente un gran problema.
Y al final quería agradecer a los chicos de nuestro equipo de DBA PosgreSQL-Consulting, en particular a Max Boguk y Alexey Lesovsky, quienes se enfrentan a desafíos diariamente en este tema. Y para nuestros clientes, nos esforzamos por hacer que todo funcione lo mejor posible. Aquí es como con las instrucciones de seguridad aérea. Todo está escrito con sangre. Cada uno de estos problemas fue descubierto durante algún inconveniente. Con gusto los comparto con ustedes.
Preguntas:
¡Gracias! Si, por ejemplo, una empresa quiere ahorrar y alojar la base de datos y la lógica de la aplicación en un mismo servidor, o si la empresa sigue la tendencia moderna de arquitecturas de microservicios, donde PostgreSQL se ejecuta en un contenedor. ¿Cuál es el truco? Sysctl afecta globalmente a todo el núcleo. No he oído que sysctl se virtualice de alguna manera para funcionar por separado en un contenedor. Solo hay cgroup y allí solo hay control parcial. ¿Cómo se puede vivir con esto? O si desea rendimiento, entonces ejecute PostgreSQL en un servidor físico separado y ajústelo.
Respondimos a su pregunta de aproximadamente tres maneras. Si no se trata de un servidor físico que se pueda ajustar, relájese, todo funcionará bien sin esa configuración. Si tiene una carga tal que necesita hacer estas configuraciones, llegará a un servidor físico antes que a estas configuraciones.
¿Cuál es el problema? Si es una máquina virtual, es probable que tenga muchos problemas, por ejemplo, con el hecho de que la latencia del disco es bastante inconsistente en la mayoría de las máquinas virtuales. Incluso si el ancho de banda de los discos es bueno, una transacción fallida en operaciones de entrada/salida, que no afecta mucho al rendimiento promedio, que ocurre durante un checkpoint o al escribir en WAL, hará que la base de datos sufra gravemente. Y notará esto antes de encontrarse con esos problemas.
Si tiene NGINX en el mismo servidor, también tendrá el mismo problema. Competirá por la memoria compartida. Y no llegará a los problemas que se describen aquí.
Pero, por otro lado, algunos de estos parámetros seguirán siendo relevantes para usted. Por ejemplo, con sysctl establecer dirty_ratio para que no sea tan extremo; de todos modos, esto ayudará. De una forma u otra, tendrá interacción con el disco. Y lo hará de una manera incorrecta. Esos son en general los parámetros predeterminados que mostré. Y en cualquier caso, es mejor cambiarlos.
Y puede haber problemas con NUMA. VmWare, por ejemplo, funciona bien con NUMA con configuraciones totalmente opuestas. Y aquí hay que elegir: ¿servidor físico o no físico?
Tengo una pregunta relacionada con Amazon AWS. Ellos tienen imágenes preconfiguradas. Una de ellas se llama Amazon RDS. ¿Hay alguna configuración personalizada para su sistema operativo?
Hay configuraciones, pero son diferentes. Aquí configuramos el sistema operativo desde el punto de vista de cómo la base de datos utilizará esto. Y allí hay parámetros que determinan a dónde vamos, como un tipo de shaping. Es decir, necesitamos tantos recursos, y ahora los consumiremos. Después de esto, Amazon RDS incorpora esos recursos, y ahí la performance disminuye. Hay historias separadas de cómo la gente comienza a jugar con esto. A veces con bastante éxito. Pero esto no tiene que ver con la configuración del sistema operativo. Es como un hackeo en la nube. Esa es otra historia.
¿Por qué las Transparent huge pages no tienen efecto en comparación con Huge TLB?
No lo tienen. Se puede explicar de muchas maneras. Pero en realidad simplemente no lo dan. ¿Cuál es la historia con PostgreSQL? Al iniciar, asigna un gran bloque de memoria compartida. Si son Transparent o no, no importa en absoluto. El hecho de que se asignen al inicio lo explica todo. Y si hay mucha memoria y es necesario reconstruir el segmento de shared_memory, entonces las Transparent huge pages serán relevantes. En PostgreSQL, simplemente se asigna un gran bloque al inicio y ya, no sucede nada especial después de eso. Se puede usar, claro, pero hay una posibilidad de corrupción en shared_memory, cuando se reasigne algo. PostgreSQL no sabe nada de esto.
Fuente: habr.com
