

Llegó 2019 y todavía no teníamos una solución estándar para la agregación de logs en Kubernetes. En este artículo, queremos compartir nuestras búsquedas, los problemas encontrados y sus soluciones, utilizando ejemplos de la práctica real.
Sin embargo, antes de comenzar, debo aclarar que los diferentes clientes entienden muy diferente la recopilación de logs:
- algunos quieren ver logs de seguridad y auditoría;
- otros buscan la centralización de logs de toda la infraestructura;
- y hay quienes solo necesitan recopilar los logs de las aplicaciones, excluyendo, por ejemplo, los balanceadores.
Sobre cómo implementamos diferentes "deseos" y con qué dificultades nos encontramos, sigue leyendo.
Teoría: sobre las herramientas para logs
Antecedentes sobre los componentes del sistema de logging
El logging ha recorrido un largo camino, resultando en metodologías de recopilación y análisis de logs que aplicamos hoy. Ya en la década de 1950, Fortran introdujo una versión de los flujos estándar de entrada y salida, que ayudaban al programador a depurar su programa. Estos fueron los primeros logs computacionales, que facilitaban la vida de los programadores de esa época. Hoy en día, vemos en ellos el primer componente del sistema de logging — fuente o "productor" (producer) de logs..
La ciencia de la computación no se detuvo: aparecieron las redes informáticas, los primeros clústeres... Comenzaron a funcionar sistemas complejos compuestos por varias computadoras. Ahora los administradores de sistemas se vieron obligados a recopilar logs de varias máquinas, y en casos especiales podían añadir mensajes del núcleo del sistema operativo en caso de que fuera necesario investigar un fallo del sistema. Para describir sistemas de recopilación centralizada de logs, a principios de 2000 se publicó , que estandarizó remote_syslog. Así surgió otro importante componente: el colector (recolector) de logs y su almacenamiento.
Con el aumento del volumen de logs y la implementación generalizada de tecnologías web, surgió la necesidad de mostrar los logs de manera conveniente a los usuarios. Los simples instrumentos de consola (awk/sed/grep) fueron reemplazados por más avanzados visores de logs — el tercer componente.
Con el aumento del volumen de logs, se hizo evidente otra cosa: los logs son necesarios, pero no todos. Además, diferentes logs requieren diferentes niveles de retención: algunos se pueden perder en un día, mientras que otros deben guardarse durante 5 años. Así, se añadió un componente de filtrado y enrutamiento de flujos de datos al sistema de registro, al que denominaremos filtro.
Los almacenes también dieron un salto significativo: pasaron de archivos comunes a bases de datos relacionales, y luego a almacenes orientados a documentos (como Elasticsearch). Así, el almacén se separó del colector.
Al final, el propio concepto de log se amplió a una especie de flujo abstracto de eventos que queremos guardar para la historia. Más precisamente, en caso de que se necesite realizar una investigación o elaborar un informe analítico…
En resumen, en un periodo relativamente corto de tiempo, la recolección de logs se ha convertido en un subsistema importante, que con justicia puede considerarse una de las subdivisiones de Big Data.
Si alguna vez un simple print podía ser suficiente para un 'sistema de registro', ahora la situación ha cambiado drásticamente.
Kubernetes y logs
Cuando Kubernetes llegó a la infraestructura, la ya existente problemática de recolección de logs no lo evitó. En cierto sentido, se volvió aún más aguda: la gestión de la plataforma de infraestructura no solo se simplificó, sino que también se complicó al mismo tiempo. Muchos servicios antiguos comenzaron a migrar a un enfoque de microservicios. En el contexto de los logs, esto se tradujo en un número creciente de fuentes de logs, su ciclo de vida particular y la necesidad de rastrear a través de los logs las interrelaciones de todos los componentes del sistema…
A modo de avance, puedo afirmar que actualmente, desafortunadamente, no existe una versión estandarizada de registro para Kubernetes que se distinga favorablemente de todas las demás. Los esquemas más populares en la comunidad se reducen a los siguientes:
- alguien despliega la pila EFK (Elasticsearch, Fluentd, Kibana);
- alguien más – prueba el recién lanzado o usa ;
- nosotros (¿o tal vez a nosotros también?…) en gran parte estamos satisfechos con el desarrollo propio — …
Generalmente, utilizamos estas combinaciones en clústeres K8s (para soluciones autoalojadas):
- ;
- .
Sin embargo, no me detendré en las instrucciones para su instalación y configuración. En su lugar, me enfocaré en sus desventajas y en conclusiones más globales sobre la situación con los registros en general.
Práctica con registros en K8s
«Registros diarios», ¿cuántos de ustedes hay?
La recolección centralizada de registros de una infraestructura bastante grande requiere muchos recursos, que se utilizarán para la recolección, almacenamiento y procesamiento de los registros. Durante la explotación de varios proyectos, nos encontramos con diversos requerimientos y los problemas que surgieron a partir de ellos durante la operación.
Probemos ClickHouse
Consideremos un almacenamiento centralizado en un proyecto con una aplicación que genera registros de manera bastante activa: más de 5000 líneas por segundo. Comencemos a trabajar con sus registros, acumulándolos en ClickHouse.
Tan pronto como se necesite el máximo en tiempo real, un servidor de 4 núcleos con ClickHouse ya estará sobrecargado en el subsistema de disco:
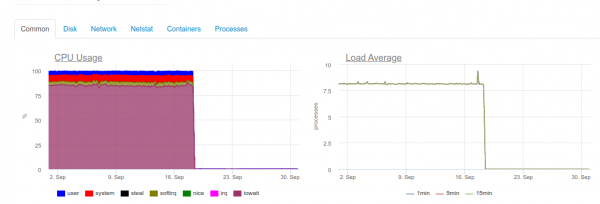
Este tipo de carga está relacionado con el hecho de que intentamos escribir en ClickHouse lo más rápido posible. Y esto causa una mayor carga en el disco, lo que puede generar errores como los siguientes:
DB::Exception: Too many parts (300). Merges are processing significantly slower than inserts
La cuestión es que en ClickHouse (donde se almacenan los datos de los registros) presentan sus propias complicaciones durante las operaciones de escritura. Los datos insertados en ellas generan una partición temporal, que luego se fusiona con la tabla principal. Como resultado, la inserción resulta ser muy exigente para el disco, y también está sujeta a una limitación, notificación de la cual hemos recibido anteriormente: no se pueden fusionar más de 300 sub-particiones por segundo (de hecho, esto equivale a 300 inserts por segundo).
Para evitar este tipo de comportamiento, en bloques lo más grandes posibles y no más de 1 vez cada 2 segundos. Sin embargo, escribir en grandes lotes implica que debemos escribir en ClickHouse con menos frecuencia. Esto, a su vez, puede llevar a un desbordamiento del búfer y a la pérdida de registros. La solución es aumentar el búfer de Fluentd, pero entonces también aumentará el consumo de memoria.
Nota: Otro aspecto problemático de nuestra solución con ClickHouse estaba relacionado con el hecho de que la partición en nuestro caso (loghouse) se implementaba a través de tablas externas asociadas Esto lleva a que al seleccionar grandes intervalos de tiempo se requiere demasiada memoria RAM, ya que la metatable recorre todas las particiones, incluso aquellas que evidentemente no contienen los datos necesarios. Sin embargo, actualmente se puede considerar que este enfoque está obsoleto para las versiones actuales de ClickHouse. ).
Como resultado, queda claro que para la recolección de logs en tiempo real en ClickHouse, los recursos no son adecuados para todos los proyectos (más bien, su distribución no será razonable). Además, será necesario utilizar un acumulador, del que volveremos a hablar. El caso descrito anteriormente es real. Y en ese momento no pudimos ofrecer una solución confiable y estable que satisficiera al cliente y permitiera recopilar logs con la mínima latencia...
¿Y Elasticsearch?
Se sabe que Elasticsearch maneja grandes cargas. Lo probaremos en el mismo proyecto. Ahora la carga se ve de la siguiente manera:
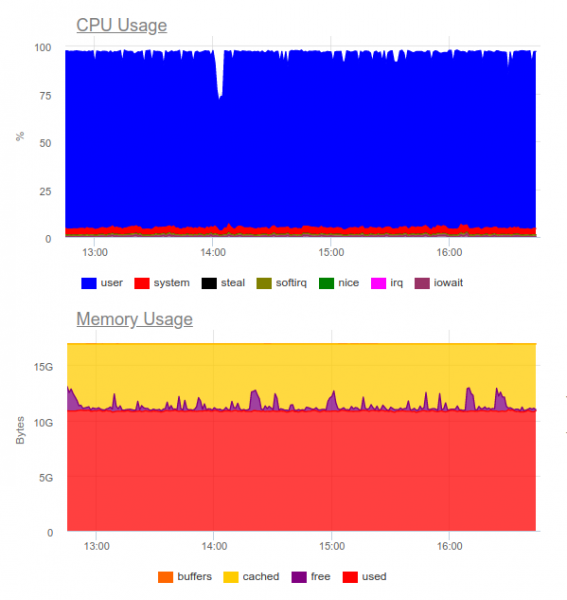
Elasticsearch pudo procesar el flujo de datos, sin embargo, la escritura de tales volúmenes en él utiliza mucho el CPU. Esto se resuelve organizando un clúster. Técnicamente no es un problema, sin embargo, resulta que solo para el funcionamiento del sistema de recolección de logs ya estamos utilizando alrededor de 8 núcleos y tenemos un componente de alta carga adicional en el sistema...
Resultado: esta opción puede ser justificable, pero solo en el caso de que el proyecto sea grande y su dirección esté dispuesta a gastar recursos significativos en un sistema de logging centralizado.
Entonces surge la pregunta inevitable:
¿Qué logs son realmente necesarios?
 Intentemos cambiar el enfoque: los logs deben ser informativos y no cubrir cada evento en el sistema.
Supongamos que tenemos una tienda en línea exitosa. ¿Qué logs son importantes? Recopilar la máxima información, por ejemplo, del gateway de pago, es una excelente idea. Pero en el servicio de corte de imágenes en el catálogo de productos, no todos los logs son críticos para nosotros: solo necesitamos errores y monitoreo extendido (por ejemplo, sobre el porcentaje de errores 500 que genera este componente).
Así hemos llegado a la conclusión de que la logging centralizado no está justificado en muchas ocasiones. Muy a menudo, el cliente quiere recopilar todos los logs en un solo lugar, aunque en realidad solo se requieren aproximadamente el 5% de los mensajes desde el log, los cuales son críticos para el negocio:
- A veces, es suficiente con configurar, digamos, solo el tamaño del registro del contenedor y el recolector de errores (por ejemplo, Sentry).
- Para investigar incidentes, a menudo puede ser suficiente con una alerta de error y un registro local grande.
- Tuvimos proyectos que se manejaron exclusivamente con pruebas funcionales y sistemas de recolección de errores. El desarrollador no necesitaba registros como tales; todo lo veía a través de los rastros de errores.
Ilustración de la vida real
Un buen ejemplo puede ser otra historia. Recibimos una solicitud del equipo de seguridad de uno de nuestros clientes, que ya utilizaba una solución comercial que había sido desarrollada mucho antes de la implementación de Kubernetes.
Fue necesario "amigarse" con el sistema de recolección de registros centralizado y el sensor corporativo de detección de problemas: QRadar. Este sistema puede recibir registros a través del protocolo syslog y recogerlos por FTP. Sin embargo, integrar esto con el complemento remote_syslog para fluentd no fue inmediato. (como resultó ser, ). Los problemas con la configuración de QRadar estaban en el lado del equipo de seguridad del cliente.
Como resultado, parte de los registros críticos para el negocio se exportaron a QRadar por FTP, mientras que otra parte se redirigió directamente desde los nodos a través de remote syslog. Para esto, incluso escribimos — tal vez ayude a alguien a resolver una tarea similar... Gracias al esquema resultante, el cliente obtuvo y analizó los registros críticos (con su herramienta favorita), y nosotros pudimos reducir los costos del sistema de registro, conservando solo el último mes.
Otro ejemplo es bastante indicativo de cómo no se deben hacer las cosas. Uno de nuestros clientes, en el procesamiento de cada eventos provenientes del usuario, generó una salida de múltiples líneas no estructurada de información en el registro. Como es fácil imaginar, tales registros eran extremadamente difíciles de leer y almacenar.
Criterios para los registros
Estos ejemplos llevan a la conclusión de que, además de elegir un sistema de recolección de registros, también es necesario diseñar los propios registros! ¿Cuáles son los requisitos aquí?
- Los registros deben estar en un formato legible por máquinas (por ejemplo, JSON).
- Los registros deben ser compactos y permitir ajustes en el nivel de registro, para depurar posibles problemas. Al mismo tiempo, en entornos de producción, se deben ejecutar sistemas con niveles de registro como Advertencia o Error.
- Los registros deben estar normalizados, es decir, en el objeto del registro todas las cadenas deben tener el mismo tipo de campo.
Los registros no estructurados pueden provocar problemas al cargar los registros en el almacenamiento y detener por completo su procesamiento. Como ilustración, un ejemplo con el error 400, que muchos han encontrado en los registros de fluentd:
2019-10-29 13:10:43 +0000 [warn]: dump an error event: error_class=Fluent::Plugin::ElasticsearchErrorHandler::ElasticsearchError error="400 - Rejected by Elasticsearch"
El error significa que está enviando al índice un campo con un tipo inestable en un mapping ya existente. Un ejemplo básico sería un campo en el registro de nginx con una variable $upstream_status. Puede contener tanto un número como una cadena. Por ejemplo:
{ "ip": "1.2.3.4", "http_user": "-", "request_id": "17ee8a579e833b5ab9843a0aca10b941", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "/staffs/265.png", "protocol": "HTTP/1.1", "status": "200", "body_size": "906", "referrer": "https://example.com/staff", "user_agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.70 Safari/537.36", "request_time": "0.001", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "127.0.0.1:9000", "upstream_status": "200", "upstream_response_length": "906", "location": "staff"}
 { "ip": "1.2.3.4", "http_user": "-", "request_id": "47fe42807f2a7d8d5467511d7d553a1b", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "/staff", "protocol": "HTTP/1.1", "status": "200", "body_size": "2984", "referrer": "-", "user_agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.70 Safari/537.36", "request_time": "0.010", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "10.100.0.10:9000, 10.100.0.11:9000", "upstream_status": "404, 200", "upstream_response_length": "0, 2984", "location": "staff"}
En los registros se puede ver que el servidor 10.100.0.10 respondió con un error 404 y la solicitud se envió a otro almacenamiento de contenido. Como resultado, en los registros, el valor se volvió así:
"upstream_response_time": "0.001, 0.007"
Esta situación es tan común que incluso ha recibido una mención específica en la documentación. .
Hay casos en los que se necesitan todos los registros sin excepción. Y este es un problema con los esquemas típicos de recopilación de registros para K8s, como se mencionó/consideró anteriormente.
Por ejemplo, fluentd no puede recopilar registros de contenedores de corta duración. En uno de nuestros proyectos, un contenedor con migración de bases de datos vivió menos de 4 segundos y luego fue eliminado, de acuerdo con la anotación correspondiente:
"helm.sh/hook-delete-policy": hook-succeeded
Debido a esto, el registro de ejecución de la migración no llegó al almacenamiento. La política
before-hook-creation puede ayudar en este caso..
Otro ejemplo es la rotación de registros de Docker. Supongamos que hay una aplicación que escribe activamente en los registros. En condiciones normales, logramos procesar todos los registros, pero tan pronto como surge un problema, como el que se describió anteriormente con el formato incorrecto, el procesamiento se detiene y Docker rota el archivo. El resultado es que se pueden perder registros críticos para el negocio.
Es por eso que es importante separar los flujos de registros, integrando el envío de los más valiosos directamente en la aplicación para asegurar su conservación. Además, no estaría de más crear un tipo de «acumulador» de registros, que pueda sobrevivir a una breve indisponibilidad del almacenamiento mientras conserva los mensajes críticos.
Por último, no hay que olvidar que es importante monitorear adecuadamente cualquier subsistema. De lo contrario, es fácil encontrarse en una situación en la que fluentd se encuentra en un estado CrashLoopBackOff y no envía nada, lo que puede resultar en la pérdida de información importante.
Conclusiones
En este artículo no abordamos soluciones SaaS como Datadog. Muchos de los problemas descritos aquí ya han sido resueltos de alguna manera por empresas comerciales especializadas en la recopilación de registros, pero no todos pueden utilizar SaaS por diversas razones. (los principales son el costo y el cumplimiento de la Ley Federal 152).
La recopilación centralizada de registros parece ser una tarea simple al principio, pero en realidad no lo es. Es importante recordar que:
- Solo vale la pena registrar con detalle los componentes críticos; para los demás sistemas se puede configurar el monitoreo y la recopilación de errores.
- Los registros en producción deben ser mínimos para no sobrecargar de manera innecesaria.
- Los registros deben ser legibles por máquina, normalizados y tener un formato estricto.
- Los registros realmente críticos deben enviarse por un flujo separado, que debe estar aislado de los principales.
- Es conveniente pensar en un acumulador de registros que pueda proteger contra picos de alta carga y hacer que la carga en el almacenamiento sea más equilibrada.
Estas simples reglas, si se aplicaran en todas partes, permitirían que las esquemas descritos anteriormente funcionaran, incluso a pesar de que les falten componentes importantes (acumulador). Si no se siguen estos principios, la tarea fácilmente llevará a usted y a la infraestructura a otro componente del sistema con alta carga (y al mismo tiempo poco efectivo).
P.D.
También puedes leer en nuestro blog:
- «»;
- «»;
- «».
Fuente: habr.com
