

El monitoreo se ha convertido en un componente crucial de las crecientes soluciones en la nube con el aumento de la complejidad de los sistemas distribuidos. Es necesario para entender su comportamiento. Se necesitan herramientas escalables que puedan recolectar datos de todos los servicios y proporcionar a los especialistas una interfaz única con análisis de rendimiento, visualización de errores, disponibilidad y registros.
Estas herramientas también deben ser efectivas y eficientes. En este artículo, analizaremos dos tecnologías populares: EFK (Elasticsearch) y PLG (Loki) y examinaremos sus arquitecturas y diferencias.
Pila EFK
Es posible que ya haya oído hablar del popular ELK o EFK. La pila consta de varias partes separadas: Elasticsearch (almacenamiento de objetos), Logstash o FluentD (recolección y agregación de registros) y Kibana para la visualización.
Un esquema típico de funcionamiento se ve así:
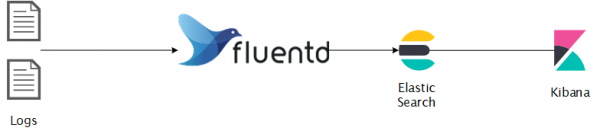
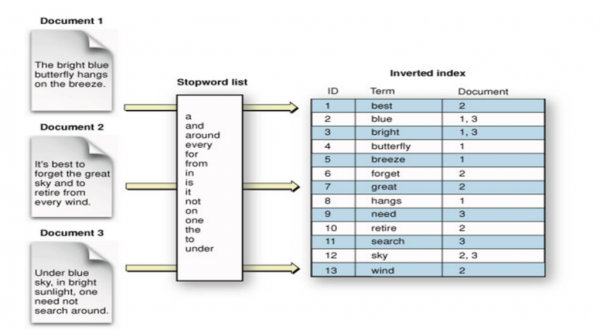
Elasticsearch — almacenamiento de objetos distribuido con búsqueda y análisis en tiempo real. Una excelente solución para datos semiestructurados, como los registros. La información se almacena en documentos JSON, se indexa en tiempo real y se distribuye entre los nodos del clúster. Se utiliza un índice invertido que contiene todas las palabras únicas y los documentos relacionados para la búsqueda de texto completo, que se basa en el motor de búsqueda Apache Lucene.
FluentD — es un recopilador de datos que realiza la unificación de datos durante su recolección y consumo. Intenta organizar los datos en JSON tanto como sea posible. Su arquitectura es extensible, hay más de , soportadas por la comunidad, para todos los casos de uso.
Kibana — es una herramienta de visualización de datos para Elasticsearch con varias capacidades adicionales, como análisis de series temporales, gráficos, aprendizaje automático y más.
Arquitectura de Elasticsearch
Los datos del clúster de Elasticsearch se almacenan repartidos entre todos sus nodos. El clúster consiste en varios nodos para mejorar la disponibilidad y la resistencia. Cualquier nodo puede desempeñar todos los roles del clúster, pero en implementaciones escalables de gran tamaño, generalmente se asignan tareas separadas a los nodos.
Tipos de nodos del clúster:
- master node — gestiona el clúster, se necesitan al menos tres, uno siempre está activo;
- data node — almacena datos indexados y realiza diversas tareas con ellos;
- nodo de ingestión — organiza tuberías para la transformación de datos antes de la indexación;
- nodo de coordinación — enrutamiento de solicitudes, reducción de la fase de procesamiento de búsqueda, coordinación de la indexación masiva;
- nodo de alerta — ejecución de tareas de notificación;
- nodo de aprendizaje automático — procesamiento de tareas de aprendizaje automático.
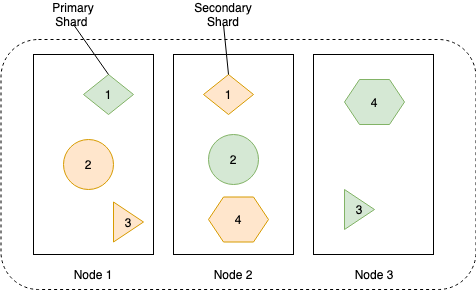
En el diagrama a continuación se muestra cómo se almacenan y replican los datos a través de los nodos para lograr una mayor disponibilidad de datos.
Los datos de cada réplica se almacenan en un índice invertido, el esquema a continuación muestra cómo ocurre esto:
Instalación
Se pueden ver los detalles , voy a utilizar el gráfico de helm:
$ helm install efk-stack stable/elastic-stack --set logstash.enabled=false --set fluentd.enabled=true --set fluentd-elasticsStack PLG
No te sorprendas si no puedes encontrar este acrónimo, ya que es más conocido como Grafana Loki. De todos modos, esta stack está ganando popularidad, ya que aplica soluciones técnicas acertadas. Puede que ya hayas oído hablar de Grafana, una herramienta popular para la visualización. Sus creadores, inspirándose en Prometheus, desarrollaron Loki, un sistema de agregación de registros de alto rendimiento y escalabilidad horizontal. Loki indexa solo los metadatos y no los propios registros; esta solución técnica le permitió ser fácil de operar y rentable.
Promtail — agente para enviar registros desde el sistema operativo al clúster Loki. Grafana — herramienta de visualización basada en datos de Loki.
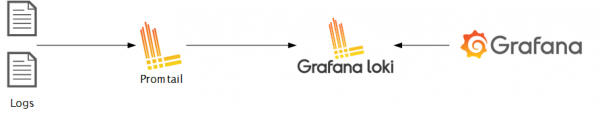
Loki se basa en los mismos principios que Prometheus, por lo que es adecuado para almacenar y analizar registros de Kubernetes.
Arquitectura de Loki
Loki puede ejecutarse tanto en modo de un solo proceso como en múltiples procesos, lo que permite la escala horizontal.
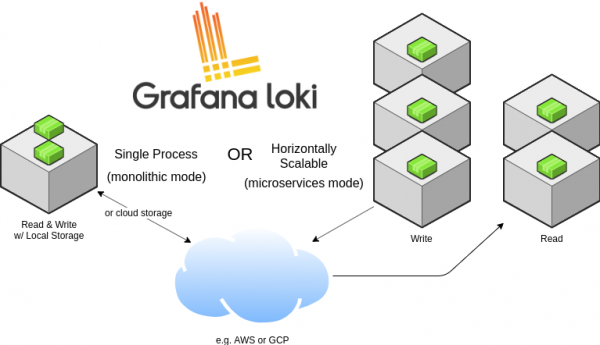
También puede funcionar como una aplicación monolítica o como un microservicio. La ejecución en modo de un solo proceso puede ser útil para el desarrollo local o para un monitoreo menor. Para implementación industrial y cargas escalables, se recomienda usar la variante de microservicios. Las rutas de escritura y lectura de datos están separadas, por lo que se puede ajustar y escalar con bastante precisión según sea necesario.
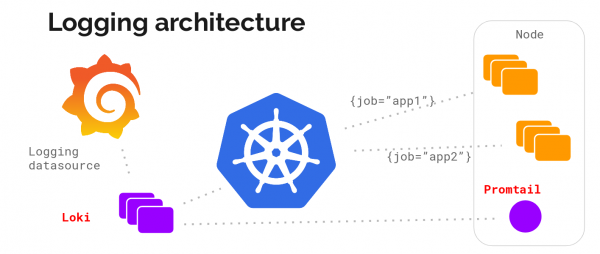
Veamos la arquitectura del sistema de recopilación de registros sin entrar en detalles:
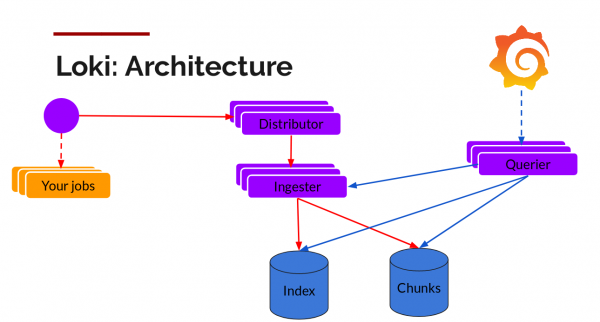
Y aquí hay una descripción (arquitectura de microservicios):
Componentes:
Promtail — agente que se instala en los nodos (como un conjunto de servicios), extrae registros de tareas y consulta la API de Kubernetes para obtener metadatos que etiquetarán los registros. Luego envía el registro al servicio principal de Loki. Para la coincidencia de metadatos, se aplican las mismas reglas de etiquetado que en Prometheus.
Distribuidor — servicio distribuidor que funciona como un búfer. Para procesar millones de registros, empaqueta los datos entrantes, comprimiéndolos en bloques a medida que llegan. Varios receptores de datos funcionan simultáneamente, pero los registros pertenecientes a un solo flujo de datos entrantes deben estar solo en uno de ellos para todos sus bloques. Esto se organiza como un anillo de receptores y un hash secuencial. Para la tolerancia a fallos y redundancia, se hace n veces (3, si no se configura).
Ingester — servicio receptor. Los bloques de datos llegan comprimidos con registros añadidos. Una vez que el bloque alcanza un tamaño suficiente, se produce el volcado del bloque en la base de datos. Los metadatos van al índice y los datos del bloque con el registro van a Chunks (normalmente un almacenamiento de objetos). Después del volcado, el receptor crea un nuevo bloque donde se añadirán nuevos registros.
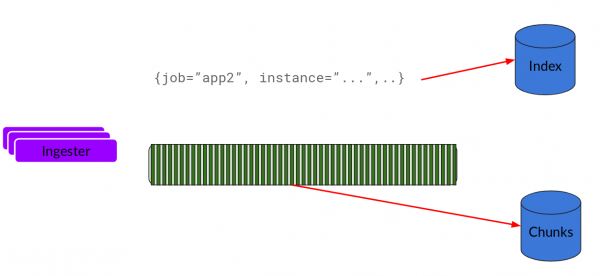
Index — base de datos, DynamoDB, Cassandra, Google BigTable, etc.
Chunks — bloques de registros en formato comprimido, generalmente almacenados en un almacenamiento de objetos, por ejemplo, S3.
Consultor — camino de lectura que hace todo el trabajo sucio. Mira el rango de tiempo y etiquetas, luego consulta el índice para buscar coincidencias. A continuación, lee los bloques de datos y los filtra para obtener el resultado.
Ahora veamos todo en funcionamiento.
Instalación
Para la instalación en Kubernetes, lo más fácil es usar helm. Suponemos que ya lo ha instalado y configurado ( nota del traductor)
Agregamos el repositorio y instalamos el stack.
$ helm repo add loki https://grafana.github.io/loki/charts
$ helm repo update
$ helm upgrade --install loki loki/loki-stack --set grafana.enabled=true,prometheus.enabled=true,prometheus.alertmanager.persistentVolume.enabled=false,prometheus.server.persistentVolume.enabled=false
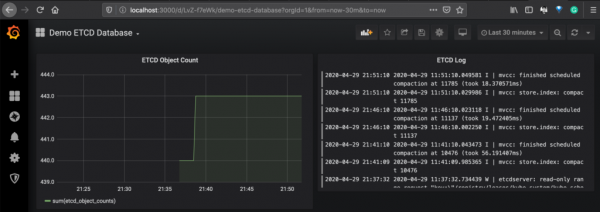
A continuación se muestra un ejemplo de un panel que muestra datos de Prometheus para métricas de Etcd y Loki para registros de pods de Etcd.
Ahora discutamos la arquitectura de ambos sistemas y comparemos sus capacidades entre sí.
Comparación
Lenguaje de consultas
En Elasticsearch se utiliza Query DSL y el lenguaje de consultas de Lucene, que permiten la búsqueda de texto completo. Es un motor de búsqueda robusto y bien establecido con un amplio soporte para operadores. Con él se puede buscar en el contexto y ordenar según la relevancia.
En la otra esquina del ring está LogQL, utilizado en Loki, el heredero de PromQL (lenguaje de consultas de Prometheus). Utiliza etiquetas de registros para filtrar y extraer datos de registros. Hay posibilidad de utilizar algunos operadores y aritmética, como se describe , pero en capacidades se queda atrás del lenguaje de Elastic.
Dado que las consultas en Loki están relacionadas con etiquetas, es fácil correlacionarlas con métricas, lo que a su vez facilita la organización de la monitorización operativa.
Escalabilidad
Ambos stacks son escalables horizontalmente, pero con Loki es más sencillo, ya que tiene caminos de lectura y escritura de datos separados, además de una arquitectura de microservicios. Loki puede adaptarse a tus necesidades y puede manejar volúmenes de datos de registros muy grandes.
Multitenencia
La multitenencia del clúster es un tema común para reducir OPEX, ambos stacks ofrecen multitenencia. Para Elasticsearch hay varias de segmentar clientes: un índice separado para cada cliente, enrutamiento basado en el cliente, campos únicos para el cliente, filtros de búsqueda. En Loki hay en forma de encabezado HTTP X-Scope-OrgID.
Costo
Loki es muy eficiente en términos de costes porque no indexa datos, solo metadatos. De esta manera se logra y en memoria (caché), ya que el almacenamiento de objetos es más barato que el de bloques, que se utiliza en los clústeres de Elasticsearch.
Conclusión
El stack EFK puede utilizarse para diversos propósitos, brindando la máxima flexibilidad y una interfaz multifuncional de Kibana para análisis, visualización y consultas. Puede ser mejorado adicionalmente con capacidades de aprendizaje automático.
El stack Loki es útil en el ecosistema de Kubernetes debido al mecanismo de descubrimiento de metadatos. Se pueden correlacionar fácilmente los datos de monitoreo basados en series temporales en Grafana y registros.
Cuando se trata de costos y almacenamiento a largo plazo de registros, Loki es una excelente opción para iniciarse en soluciones en la nube.
En el mercado hay más alternativas, algunas pueden ser mejores para ti. Por ejemplo, GKE tiene integración con Stackdriver, que proporciona una excelente solución para monitoreo. No las incluimos en nuestro análisis en este artículo.
Enlaces:
El artículo fue traducido y preparado para Habr por empleados del — intensivos, videoclases y formación corporativa de profesionales en activo (Kubernetes, DevOps, Docker, Ansible, Ceph, SRE, Agile)
Fuente: habr.com
