

TL;DR
- Para lograr una alta observabilidad de contenedores y microservicios, así como de registros y métricas primarias, no es suficiente.
- Para una recuperación más rápida y un aumento de la resiliencia, las aplicaciones deben aplicar el Principio de Alta Observabilidad (HOP).
- A nivel de aplicación, para el HOP se requiere: registro adecuado, monitoreo exhaustivo, verificaciones de disponibilidad y trazas de rendimiento/transiciones.
- Como elemento del HOP, utiliza verificaciones. readinessProbe y livenessProbe Kubernetes.
¿Qué es una Plantilla de Verificación de Disponibilidad?
Al diseñar una aplicación crítica y altamente disponible, es muy importante considerar aspectos como la resiliencia. Una aplicación se considera resiliente si se recupera rápidamente de una falla. Una aplicación típica en la nube utiliza una arquitectura de microservicios, donde cada componente se coloca en un contenedor individual. Y para asegurarte de que la aplicación en k8s sea altamente disponible, al diseñar el clúster, debes seguir ciertas plantillas. Entre ellas se encuentra la Plantilla de Verificación de Disponibilidad. Esta define cómo la aplicación informa a k8s sobre su disponibilidad. No solo es información sobre si el pod está funcionando, sino también sobre cómo recibe y responde a las solicitudes. Cuanto más sepa Kubernetes sobre la disponibilidad del pod, más decisiones inteligentes tomará sobre el enrutamiento de tráfico y el equilibrio de carga. Así, el Principio de Alta Observabilidad permite que la aplicación responda oportunamente a las solicitudes.
Principio de Alta Observabilidad (HOP)
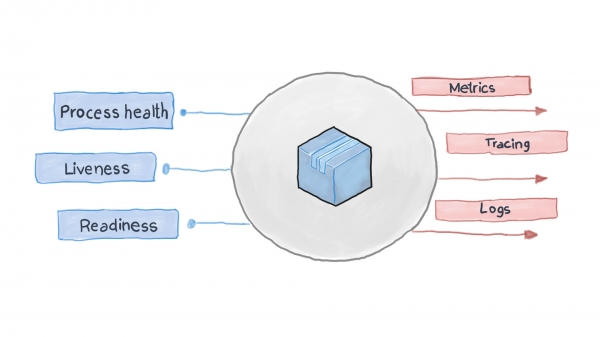
El Principio de Alta Observabilidad es uno de los . En una arquitectura de microservicios, los servicios no tienen preocupación por cómo se procesa su solicitud (y esto es correcto), pero es importante cómo obtener respuestas de los servicios receptores. Por ejemplo, para la autenticación del usuario, un contenedor envía a otro una solicitud HTTP, esperando una respuesta en un formato específico, y eso es todo. La solicitud puede ser procesada por PythonJS y la respuesta puede ser proporcionada por Python Flask. Los contenedores son entre sí como cajas negras con contenido oculto. Sin embargo, el principio NOR exige que cada servicio exponga varios puntos finales de API, mostrando cuán operativo es, así como su estado de disponibilidad y tolerancia a fallos. Kubernetes consulta esos indicadores para determinar los próximos pasos en la enrutación y equilibrado de carga.
Una aplicación en la nube bien diseñada registra sus eventos principales utilizando flujos estándar de entrada y salida STDERR y STDOUT. A continuación, un servicio auxiliar, como filebeat, logstash o fluentd, envía los registros a un sistema de monitoreo centralizado (por ejemplo, Prometheus) y a un sistema de recopilación de registros (conjunto de software ELK). En el esquema a continuación se muestra cómo funciona una aplicación en la nube de acuerdo con el Patrón de Verificación de Salud y el Principio de Alta Observabilidad.
¿Cómo aplicar el Patrón de Verificación de Salud en Kubernetes?
De forma predeterminada, k8s monitorea el estado de los pods a través de uno de los controladores (, , , y otros, etc.). Al detectar que un pod ha fallado por alguna razón, el controlador intenta reiniciarlo o reprogramarlo en otro nodo. Sin embargo, un pod puede informar que está en ejecución y funcionando, y sin embargo no estar activo. Por ejemplo: su aplicación utiliza Apache como servidor web, y ha instalado el componente en varios pods del clúster. Dado que la biblioteca no se configuró correctamente, todas las solicitudes a la aplicación devuelven un código 500 (error interno del servidor). Al verificar la entrega, la comprobación del estado de los pods da un resultado exitoso, pero los clientes piensan lo contrario. Esta situación no deseada podemos describirla de la siguiente manera:
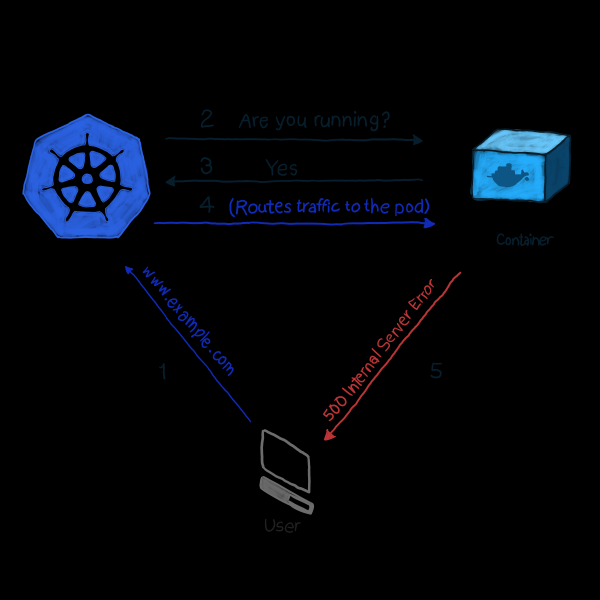
En nuestro ejemplo, k8s realiza la verificación de salud. En este tipo de verificación, kubelet constantemente monitorea el estado del proceso dentro del contenedor. Si detecta que el proceso se ha detenido, lo reinicia. Si un error se soluciona simplemente reiniciando la aplicación, y el programa está diseñado para apagarse ante cualquier error, entonces para seguir las NORMAS y la Plantilla de verificación de operatividad, basta con verificar la operatividad del proceso. Lamentablemente, no todos los errores se resuelven con un reinicio. Para esos casos, k8s ofrece 2 métodos más profundos para detectar fallos en el funcionamiento del pod: y .
LivenessProbe
Durante livenessProbe kubelet realiza 3 tipos de verificaciones: no solo determina si el pod está funcionando, sino también si está listo para recibir y responder adecuadamente a las solicitudes:
- Establezca una solicitud HTTP al pod. La respuesta debe contener un código de estado HTTP en el rango de 200 a 399. Así, los códigos 5xx y 4xx indican que el pod tiene problemas, incluso si el proceso sigue funcionando.
- Para verificar pods con servicios que no son HTTP (por ejemplo, el servidor de correo Postfix), es necesario establecer una conexión TCP.
- Ejecución de un comando arbitrario para el pod (internamente). La verificación se considera exitosa si el código de salida del comando es 0.
Ejemplo de cómo funciona esto. La definición del siguiente pod contiene una aplicación NodeJS que arroja un error 500 ante solicitudes HTTP. Para asegurarnos de que el contenedor se reinicia al recibir tal error, utilizamos el parámetro livenessProbe:
apiVersion: v1
kind: Pod
metadata:
 name: node500
spec:
 containers:
   - image: magalix/node500
     name: node500
     ports:
       - containerPort: 3000
         protocol: TCP
     livenessProbe:
       httpGet:
         path: /
         port: 3000
       initialDelaySeconds: 5
Esto no difiere de cualquier otra definición de pod, pero agregamos el objeto .spec.containers.livenessProbe. El parámetro httpGet que toma la ruta a la que se envía la solicitud HTTP GET (en nuestro ejemplo es /, pero en escenarios de producción podría ser algo como /api/v1/status). Además, livenessProbe acepta el parámetro initialDelaySeconds, que indica a las operaciones de verificación que deben esperar un tiempo determinado en segundos. La demora es necesaria porque el contenedor necesita tiempo para iniciarse, y al reiniciarse, estará indisponible por un tiempo.
Para aplicar esta configuración al clúster, utilice:
kubectl apply -f pod.yamlDespués de unos segundos, puede verificar el contenido del pod con el siguiente comando:
kubectl describe pods node500Al final de la salida, busque .
Como pueden ver, livenessProbe inició una solicitud HTTP GET, el contenedor devolvió un error 500 (para lo que estaba programado), kubelet lo reinició.
Si les interesa cómo fue programada la aplicación NideJS, aquí están el archivo app.js y el Dockerfile que se utilizaron:
app.js
var http = require('http');

var server = http.createServer(function(req, res) {
    res.writeHead(500, { "Content-type": "text/plain" });
    res.end("Hemos encontrado un errorn");
});

server.listen(3000, function() {
    console.log('El servidor está corriendo en 3000')
})
Dockerfile
FROM node
COPY app.js /
EXPOSE 3000
ENTRYPOINT [ "node","/app.js" ]
Es importante tener en cuenta lo siguiente: livenessProbe reiniciará el contenedor solo en caso de fallo. Si el reinicio no soluciona el error que afecta el funcionamiento del contenedor, kubelet no podrá tomar medidas para resolver la falla.
readinessProbe
readinessProbe funciona de manera similar a livenessProbes (solicitudes GET, comunicación TCP y ejecución de comandos), excepto en las acciones de resolución de problemas. Un contenedor que ha fallado no se reinicia, sino que se aísla del tráfico entrante. Imaginen que uno de los contenedores está realizando muchos cálculos o experimenta una gran carga, lo que provoca un aumento en el tiempo de respuesta a las solicitudes. En el caso de livenessProbe, se activa la verificación de disponibilidad de respuesta (a través del parámetro de verificación timeoutSeconds), después de lo cual kubelet reinicia el contenedor. Al reiniciarlo, el contenedor comienza a ejecutar tareas intensivas en recursos, y se vuelve a reiniciar. Esto puede ser crítico para aplicaciones donde la velocidad de respuesta es importante. Por ejemplo, un vehículo en movimiento espera una respuesta del servidor; si la respuesta se retrasa, el vehículo puede tener un accidente.
Vamos a escribir una definición de redinessProbe que establezca un tiempo de respuesta para una solicitud GET de no más de dos segundos, mientras que la aplicación responderá a la solicitud GET en cinco segundos. El archivo pod.yaml debería verse de la siguiente manera:
apiVersion: v1
kind: Pod
metadata:
 name: nodedelayed
spec:
 containers:
   - image: afakharany/node_delayed
     name: nodedelayed
     ports:
       - containerPort: 3000
         protocol: TCP
     readinessProbe:
       httpGet:
         path: /
         port: 3000
       timeoutSeconds: 2
Desplegaremos el pod con kubectl:
kubectl apply -f pod.yamlEsperemos un par de segundos y luego veamos cómo actuó el readinessProbe:
kubectl describe pods nodedelayedAl final de la salida, podemos ver que algunos eventos son similares a .
Como pueden ver, kubectl no reinició el pod cuando el tiempo de verificación superó los 2 segundos. En su lugar, canceló la solicitud. Las conexiones entrantes se redirigen a otros pods en funcionamiento.
Nota: ahora que se ha eliminado la carga innecesaria del pod, kubectl vuelve a dirigir las solicitudes a él: las respuestas a las solicitudes GET ya no se retrasan.
A modo de comparación: aquí está el archivo app.js modificado:
var http = require('http');

var server = http.createServer(function(req, res) {
   const sleep = (milliseconds) => {
       return new Promise(resolve => setTimeout(resolve, milliseconds))
   }
   sleep(5000).then(() => {
       res.writeHead(200, { "Content-type": "text/plain" });
       res.end("Hellon");
   })
});

server.listen(3000, function() {
   console.log('El servidor está funcionando en el puerto 3000')
})
TL;DR
Antes de la llegada de las aplicaciones en la nube, los registros eran el principal medio para monitorear y verificar el estado de las aplicaciones. Sin embargo, no había herramientas para tomar medidas correctivas ante fallos. Los registros siguen siendo útiles hoy en día, deben recopilarse y enviarse a un sistema de recopilación de registros para analizar incidentes y tomar decisiones. [esto se podía hacer sin aplicaciones en la nube usando monit, por ejemplo, pero con k8s se ha vuelto mucho más fácil 🙂 – nota del editor. ]
Hoy en día, las correcciones deben hacerse casi en tiempo real, por lo que las aplicaciones ya no deberían ser cajas negras. No, deben mostrar puntos finales que permitan a los sistemas de monitoreo solicitar y recopilar datos valiosos sobre el estado de los procesos, para poder reaccionar instantáneamente si es necesario. Esto se llama Patrón de diseño de verificación de estado, que sigue el Principio de alta observabilidad (NOR).
Kubernetes ofrece por defecto 2 tipos de verificación de estado: readinessProbe y livenessProbe. Ambos utilizan los mismos tipos de comprobaciones (solicitudes HTTP GET, conexiones TCP y ejecución de comandos). Se diferencian en las acciones que toman en respuesta a fallos en los pods. livenessProbe reinicia el contenedor con la esperanza de que el error no se repita, mientras que readinessProbe aísla el pod del tráfico entrante hasta que se resuelve la causa de la falla.
El diseño correcto de la aplicación debe incluir ambos tipos de verificación y asegurarse de que recopilen suficientes datos, especialmente cuando se crea una situación excepcional. También debe mostrar los puntos finales de API necesarios que transmitan al sistema de monitoreo (el mismo Prometheus) métricas importantes sobre el estado de disponibilidad.
Fuente: habr.com
