

Un aspecto importante en el funcionamiento de los sistemas distribuidos es el manejo de fallos. Kubernetes ayuda en esto utilizando controladores que supervisan el estado de su sistema y reinician los servicios que han dejado de funcionar. Sin embargo, Kubernetes puede detener forzosamente sus aplicaciones para garantizar la viabilidad general del sistema. En esta serie, veremos cómo puede ayudar a Kubernetes a realizar su trabajo de manera más efectiva y reducir el tiempo de inactividad de las aplicaciones.
Antes de comenzar a usar contenedores, la mayoría de las aplicaciones se ejecutaban en máquinas virtuales o físicas. Si una aplicación fallaba o se bloqueaba, se necesitaba mucho tiempo para detener la tarea en ejecución y reiniciar el programa. En el peor de los casos, alguien tenía que resolver este problema manualmente por la noche, en un momento poco oportuno. Si una tarea importante era realizada por solo 1-2 máquinas de trabajo, tal fallo era completamente inaceptable.
Por lo tanto, en lugar de reinicios manuales, se comenzó a utilizar la supervisión a nivel de procesos para reiniciar automáticamente la aplicación en caso de un cierre inesperado. Si el programa falla, el proceso de supervisión captura el código de salida y reinicia el servidor. Con la llegada de sistemas como Kubernetes, este tipo de respuesta a los fallos del sistema se integró directamente en la infraestructura.
Kubernetes utiliza un bucle de eventos de 'observación - registro de diferencias - acción' para asegurarse de que los recursos mantengan su operatividad desde los contenedores hasta los nodos mismos.
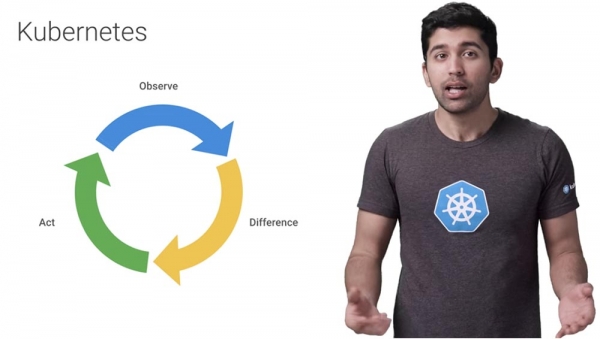
Esto significa que ya no es necesario iniciar manualmente la supervisión de procesos. Si un recurso no pasa la verificación de estado de Health Check, Kubernetes simplemente proporcionará automáticamente un reemplazo. A su vez, Kubernetes hace mucho más que solo monitorear los fallos de sus aplicaciones. Puede crear más copias de la aplicación para funcionar en varias máquinas, actualizar la aplicación o ejecutar simultáneamente varias versiones de su aplicación.
Por lo tanto, existen muchas razones por las que Kubernetes puede interrumpir el funcionamiento de un contenedor completamente sano. Por ejemplo, si actualiza su despliegue, Kubernetes detendrá lentamente los pods antiguos mientras inicia nuevos. Si apaga un nodo, Kubernetes detendrá todos los pods en ese nodo. Finalmente, si un nodo se queda sin recursos, Kubernetes apagará todos los pods para liberar esos recursos.
Por lo tanto, es muy importante que su aplicación se detenga con el mínimo impacto en el usuario final y con un tiempo de recuperación mínimo. Esto significa que, antes de apagarse, debe guardar todos los datos que necesite almacenar, cerrar todas las conexiones de red, completar el trabajo restante y realizar otras tareas urgentes.
En la práctica, esto significa que su aplicación debe ser capaz de manejar el mensaje SIGTERM, que es la señal de terminación del proceso, la cual es la señal predeterminada para la utilidad kill en los sistemas operativos basados en Unix. Al recibir este mensaje, la aplicación debe apagarse.
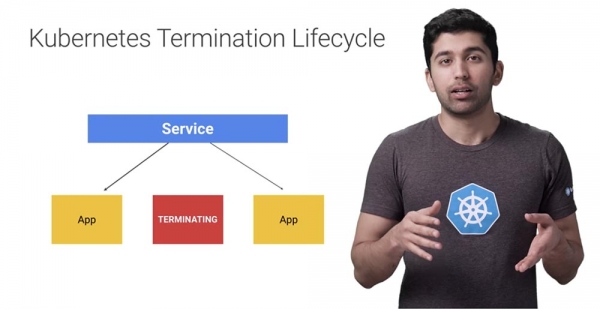
Una vez que Kubernetes decide terminar el pod, se produce una serie de eventos. Vamos a revisar cada etapa que Kubernetes realiza al cerrar un contenedor o pod.
Supongamos que queremos terminar uno de los pods. En este momento, dejará de recibir tráfico nuevo; los contenedores que están funcionando en el pod no se verán afectados, pero todo el tráfico nuevo será bloqueado.
Veamos el gancho preStop: es un comando especial o una solicitud HTTP que se envía a los contenedores en el pod. Si su aplicación no se apaga correctamente al recibir SIGTERM, puede usar preStop para cerrar correctamente.
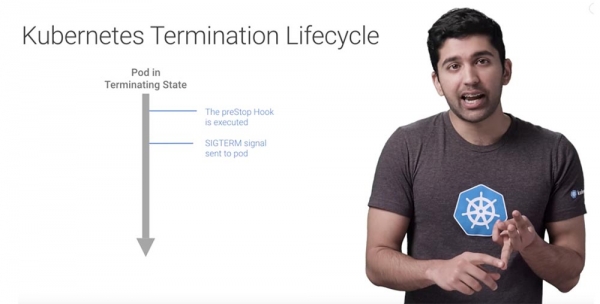
La mayoría de los programas se apagan correctamente al recibir la señal SIGTERM, pero si utiliza código de terceros o un sistema que no puede controlar completamente, el gancho preStop es una excelente manera de invocar un apagado elegante sin modificar la aplicación.
Después de la ejecución de este hook, Kubernetes enviará una señal SIGTERM a los contenedores en el pod, lo que les informará que pronto serán desconectados. Al recibir esta señal, su código comenzará el proceso de desconexión. Este proceso puede incluir la detención de cualquier conexión de larga duración, como una conexión a la base de datos o un flujo WebSocket, la salvaguarda del estado actual, y cosas similares.
Incluso si utiliza el hook preStop, es muy importante verificar qué ocurre con su aplicación cuando le envía la señal SIGTERM, cómo se comporta, para que eventos o cambios en el funcionamiento del sistema provocados por la desconexión del pod no le tomen por sorpresa.
En este momento, antes de tomar más acciones, Kubernetes esperará durante el tiempo especificado, llamado terminationGracePeriodSecond, o periodo para una desconexión adecuada al recibir la señal SIGTERM.
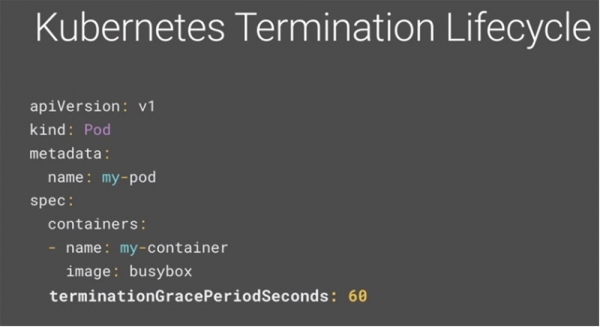
Por defecto, este periodo es de 30 segundos. Es importante señalar que dura en paralelo con el hook preStop y la señal SIGTERM. Kubernetes no esperará a que finalice el hook preStop y la SIGTERM; si su aplicación finaliza antes de que termine el periodo de TerminationGracePeriod, Kubernetes pasará inmediatamente al siguiente paso. Por lo tanto, asegúrese de que el valor de este periodo en segundos no sea menor que el tiempo necesario para una desconexión adecuada del pod, y si supera los 30s, aumente el periodo al valor requerido en YAML. En el ejemplo dado, es de 60s.
Y finalmente, el último paso: si los contenedores aún siguen funcionando al finalizar el terminationGracePeriod, enviarán una señal SIGKILL y serán eliminados forzosamente. En este momento, Kubernetes también limpiará todos los demás objetos del pod.
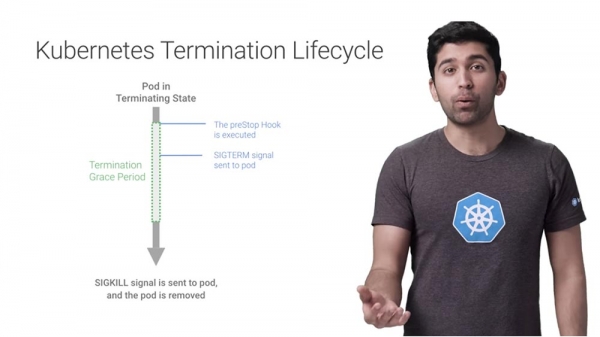
Kubernetes detiene los pods por muchas razones, así que asegúrese de que, en cualquier caso, su aplicación se cierre correctamente para garantizar la estabilidad del servicio.
Un poco de publicidad 🙂
Gracias por permanecer con nosotros. ¿Te gustan nuestros artículos? ¿Quieres ver más contenido interesante? Apóyanos haciendo un pedido o recomendando a tus conocidos, , un análogo único de servidores entry-level que hemos diseñado para Ti: (disponibles opciones con RAID1 y RAID10, hasta 24 núcleos y hasta 40GB DDR4).
¿Dell R730xd a mitad de precio en el centro de datos Equinix Tier IV en Ámsterdam? Solo aquí ¡en los Países Bajos! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — ¡desde $99! Lee sobre cómo
Fuente: habr.com
