

Si eres como la mayoría de las personas, probablemente estés utilizando recursos que funcionan fuera de tu clúster. Tal vez estés usando la API de Taleo para enviar mensajes de texto o analizando imágenes con la API de Google Cloud Vision.
Si utilizas el mismo endpoint — el punto de recepción de solicitudes en el servidor en todos tus entornos y no planeas mover tus servidores a Kubernetes, es completamente normal tener el endpoint del servicio directamente en tu código. Sin embargo, hay muchos otros escenarios posibles. En esta serie de 'Mejores Prácticas de Kubernetes' aprenderás cómo utilizar los mecanismos integrados de Kubernetes para descubrir servicios tanto dentro como fuera del clúster.
Como ejemplo de un servicio externo ampliamente utilizado, podemos mencionar una base de datos que opera fuera del clúster de Kubernetes. A diferencia de bases de datos en la nube como Google Cloud Data Store o Google Cloud Spanner, que utilizan un único endpoint para todos los tipos de acceso, la mayoría de las bases de datos tienen endpoints separados para diferentes circunstancias.
Las mejores prácticas para el uso de bases de datos tradicionales, como MySQL y MongoDB, generalmente implican que te conectes a diferentes componentes para diferentes entornos. Puede que tengas una máquina grande para datos de producción y una más pequeña para el entorno de prueba. Cada una de ellas tendrá su propia dirección IP o nombre de dominio, pero seguro que no querrás cambiar tu código al pasar de un entorno a otro. Por lo tanto, en lugar de codificar estas direcciones de forma rígida, puedes utilizar el servicio de descubrimiento de servicios externos basado en DNS integrado en Kubernetes de la misma manera que lo haces para los servicios nativos de Kubernetes.
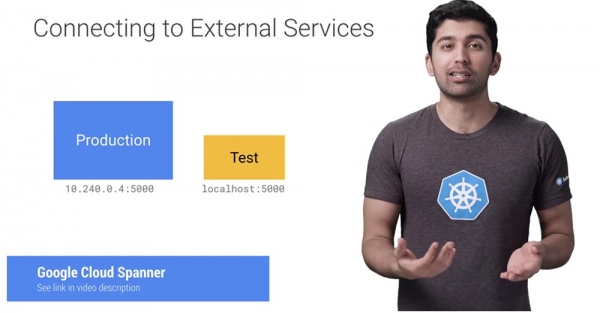
Supongamos que tienes una base de datos MongoDB en Google Compute Engine. Permanecerás atrapado en este mundo híbrido hasta que consigas moverla a un clúster.
Afortunadamente, puedes usar servicios estáticos de Kubernetes para facilitarte un poco la vida. En este ejemplo, he creado un servidor MongoDB utilizando Google Cloud Launcher. Como se ha creado en la misma red (o VPC del clúster de Kubernetes), se accede a él mediante una dirección IP interna de alto rendimiento.
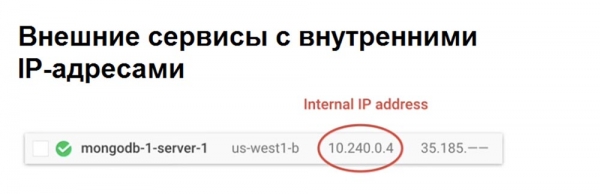
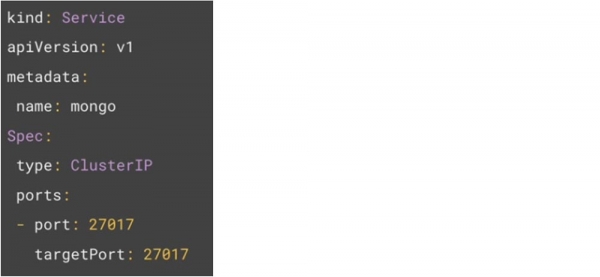
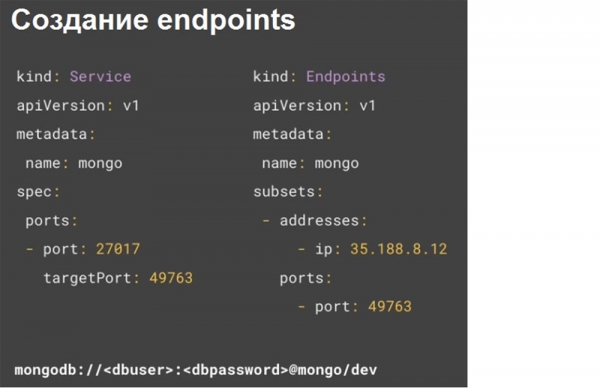
En Google Cloud, esta es la configuración predeterminada, por lo que no necesitas hacer ninguna configuración. Ahora que hay una dirección IP, el primer paso consiste en crear un servicio. Cabe notar que para este servicio no hay selectores de pods. Es decir, hemos creado un servicio que no sabrá a dónde enviar el tráfico. Esto permitirá crear manualmente un objeto de endpoint que recibirá el tráfico de este servicio.
El siguiente ejemplo de código muestra que los endpoints definen la dirección IP para la base de datos, utilizando el mismo nombre mongo que el servicio.
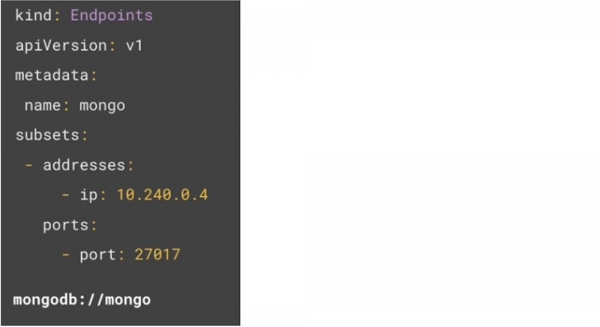
Kubernetes utilizará todas las direcciones IP para encontrar los endpoints, como si fueran pods normales de Kubernetes, así que ahora puedes acceder a la base de datos usando una simple cadena de conexión al nombre mongodb://mongo. No es necesario utilizar direcciones IP en tu código.
Si en el futuro las direcciones IP cambian, simplemente puedes actualizar los endpoints con la nueva dirección IP, y tus aplicaciones no necesitarán cambiar de ninguna manera adicional.
Si utilizas una base de datos alojada en un host de terceros, lo más probable es que los propietarios del host te hayan proporcionado un identificador de recurso unificado URI para conectarte. Así que si te dieron una dirección IP, puedes simplemente utilizar el método anterior. Este ejemplo muestra que tengo dos bases de datos MongoDB alojadas en el host mLab.
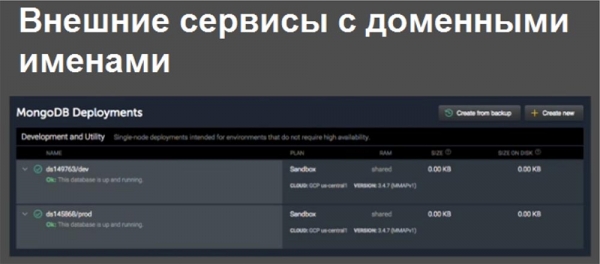
Una de ellas es la base de datos de desarrollo y la otra es la base de producción. Las cadenas de conexión para estas bases de datos son las siguientes: mLab te proporciona un URI dinámico y un puerto dinámico. Como puedes ver, son diferentes.
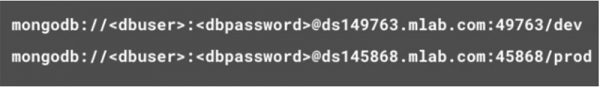
Para abstraernos de esto, usamos Kubernetes y nos conectamos a la base de datos de desarrollo. Puedes crear un nombre de servicio externo en Kubernetes, que te proporcionará un servicio estático que redirigirá el tráfico hacia el servicio externo.
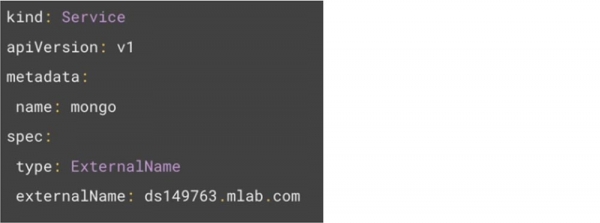
Este servicio realizará una simple redirección CNAME a nivel de núcleo, lo que tendrá un impacto mínimo en el rendimiento. Gracias a esto, puedes usar una cadena de conexión más simple.

Pero dado que el nombre externo utiliza redirección CNAME, no puede realizar la reasignación de puertos. Por lo tanto, esta solución es aplicable solo para puertos estáticos y no puede usarse con puertos dinámicos. Sin embargo, el mLab Free Tier proporciona por defecto un número de puerto dinámico, y no puedes cambiar esto. Esto significa que para dev y prod necesitas diferentes cadenas de conexión. Lo malo es que necesitarás codificar el número de puerto de forma rígida. Entonces, ¿cómo hacer que la reasignación de puertos funcione?
El primer paso es obtener la dirección IP del URI. Si ejecutas el comando nslookup, hostname o haces ping al URI, podrás obtener la dirección IP de la base de datos. Si el servicio te devuelve varias direcciones IP, todas estas direcciones se pueden usar en los puntos finales del objeto.
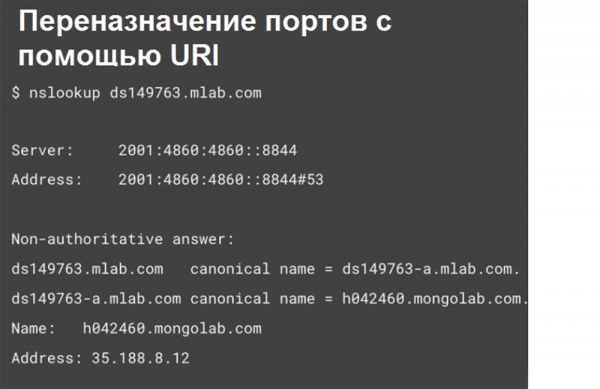
Es importante recordar que las direcciones IP de los URI pueden cambiar sin previo aviso, por lo que es bastante arriesgado usarlas en prod. Con una dirección IP de este tipo, puedes conectarte a una base de datos remota sin especificar un puerto. Así, el servicio de Kubernetes realiza la reasignación de puertos de forma bastante transparente.
El mapeo, o la asignación de recursos externos a internos, te permite usar estos servicios dentro del clúster en el futuro de manera flexible, minimizando los esfuerzos de refactorización. También facilita la gestión y proporciona una comprensión de qué servicios externos usa tu empresa.
La continuación será muy pronto...
Un poco de publicidad 🙂
Gracias por permanecer con nosotros. ¿Te gustan nuestros artículos? ¿Quieres ver más contenido interesante? Apóyanos haciendo un pedido o recomendando a tus conocidos, , un análogo único de servidores entry-level que hemos diseñado para Ti: (disponibles opciones con RAID1 y RAID10, hasta 24 núcleos y hasta 40GB DDR4).
¿Dell R730xd a mitad de precio en el centro de datos Equinix Tier IV en Ámsterdam? Solo aquí ¡en los Países Bajos! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — ¡desde $99! Lee sobre cómo
Fuente: habr.com
