

Para cada recurso de Kubernetes, hay dos tipos de requisitos que se pueden configurar: Requests y Limits. El primero describe los requisitos mínimos para la disponibilidad de recursos libres en un nodo, necesarios para ejecutar un contenedor o pod, mientras que el segundo limita estrictamente los recursos disponibles para el contenedor.
Cuando Kubernetes planifica un pod, es muy importante que los contenedores tengan suficientes recursos para funcionar correctamente. Si planeas desplegar una aplicación grande en un nodo con recursos limitados, es muy probable que no funcione debido a que el nodo se queda sin memoria o no tiene suficiente potencia de CPU. En este artículo, analizaremos cómo resolver los problemas de falta de capacidad computacional a través de solicitudes de recursos y límites.
Las solicitudes Requests y los límites Limits son mecanismos que Kubernetes utiliza para gestionar recursos como, por ejemplo, CPU y memoria. Requests es lo que garantiza que un contenedor reciba el recurso solicitado. Si un contenedor solicita un recurso, Kubernetes lo programará solo en el nodo que pueda proporcionarlo. Los límites Limits controlan que los recursos solicitados por el contenedor nunca superen un valor determinado.
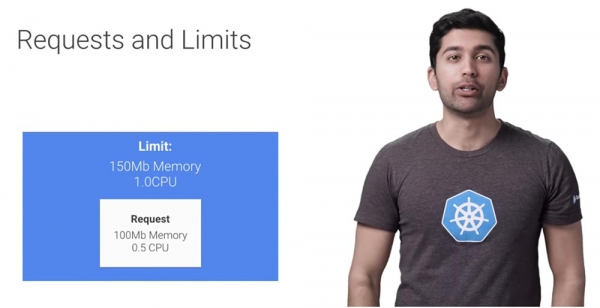
Un contenedor solo puede aumentar su capacidad de cálculo hasta un cierto límite, después del cual estará restringido. Veamos cómo funciona esto. Así que hay dos tipos de recursos: CPU y memoria. El programador de Kubernetes utiliza datos sobre estos recursos para determinar dónde ejecutar tus pods. Una especificación típica de recursos para un pod se ve así.
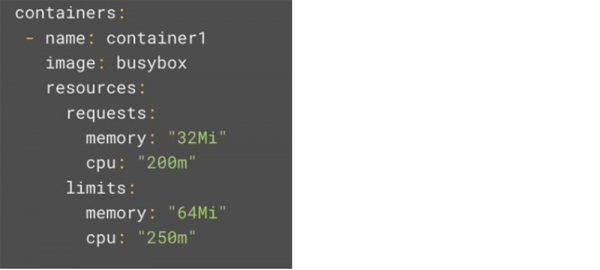
Cada contenedor en un pod puede establecer sus propias solicitudes y límites, todo de manera aditiva. Los recursos de CPU se definen en milicoros. Si su contenedor necesita dos núcleos completos para ejecutarse, establece un valor de 2000m. Si el contenedor solo requiere 1/4 de núcleo, el valor será 250m. Tenga en cuenta que si asigna un valor de recursos de CPU mayor que el número de núcleos del nodo más grande, la ejecución de su pod no será programada en absoluto. Una situación similar ocurrirá si tiene un pod que necesita cuatro núcleos y el clúster de Kubernetes consta de solo dos máquinas virtuales principales.
A menos que su aplicación esté diseñada específicamente para aprovechar los beneficios de múltiples núcleos (programas como cálculos científicos complejos y operaciones con bases de datos vienen a la mente), la mejor práctica es establecer las solicitudes de CPU en 1 o menos y luego ejecutar un mayor número de réplicas para escalabilidad. Esta decisión proporcionará mayor flexibilidad y confiabilidad al sistema.
Cuando se trata de las limitaciones de CPU, las cosas se ponen más interesantes, ya que se considera un recurso comprimible. Si su aplicación comienza a acercarse al límite de capacidad de CPU, Kubernetes comenzará a estrangular su contenedor usando CPU Throttling, que reduce la frecuencia de la CPU. Esto significa que la CPU será artificialmente limitada, proporcionando a la aplicación un rendimiento potencialmente peor, sin embargo, el proceso no será detenido ni expulsado.
Los recursos de memoria se definen en bytes. Generalmente, el valor en la configuración se mide en mebibytes (Mib), pero puede establecer cualquier valor, desde bytes hasta petabytes. Aquí se presenta la misma situación que con la CPU: si envía una solicitud por más cantidad de memoria de la que hay en sus nodos, la ejecución de este pod no será programada. Pero a diferencia de los recursos de CPU, la memoria no se puede comprimir porque no hay forma de limitar su uso. Por lo tanto, la ejecución del contenedor se detendrá tan pronto como exceda la memoria asignada.
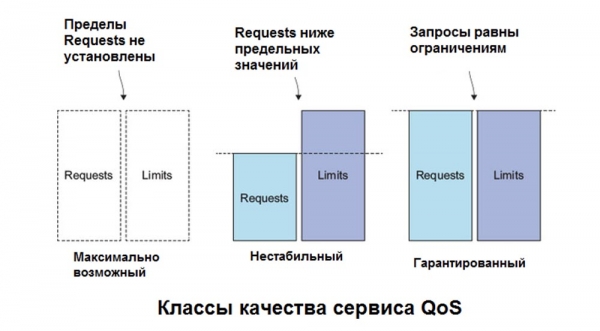
Es importante recordar que no puedes configurar solicitudes que superen el tamaño de los recursos que pueden proporcionar tus nodos. Las características de los recursos compartidos para las máquinas virtuales de GKE se pueden encontrar en los enlaces colocados debajo de este video.
En un mundo ideal, la configuración del contenedor por defecto sería más que suficiente para que los flujos de trabajo funcionaran sin problemas. Pero el mundo real no es así, las personas pueden fácilmente olvidar ajustar el uso de recursos o los hackers pueden establecer solicitudes y límites que superen las capacidades reales de la infraestructura. Para evitar el desarrollo de tales escenarios, se pueden configurar cuotas de recursos ResourceQuota y rangos de límites LimitRange.
Después de crear un espacio de nombres, se pueden bloquear con cuotas. Por ejemplo, si tienes espacios de nombres prod y dev, se utiliza una plantilla donde las cuotas de producción están completamente ausentes, mientras que las cuotas de desarrollo son muy estrictas. Esto permite que prod, en caso de un repentino aumento de tráfico, tome todos los recursos disponibles, bloqueando completamente a dev.
La cuota de recursos puede verse de esta manera. En este ejemplo, hay 4 secciones: son 4 líneas de código en la parte inferior.
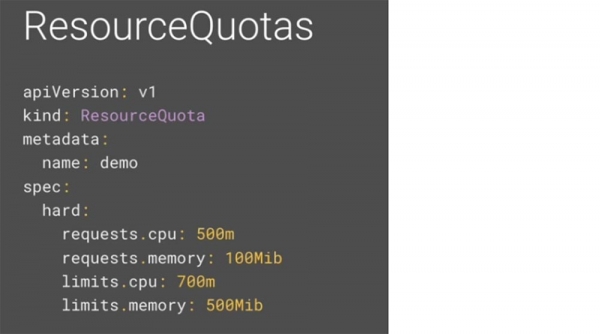
Veamos cada una de ellas. Requests.cpu es la cantidad máxima combinada de solicitudes de potencia de CPU que pueden provenir de todos los contenedores del espacio de nombres. En este ejemplo, puedes tener 50 contenedores con solicitudes de 10m, cinco contenedores con solicitudes de 100m o simplemente un contenedor con una solicitud de 500m. Mientras el total de requests.cpu de este espacio de nombres sea inferior a 500m, todo estará bien.
La memoria solicitada requests.memory es la cantidad máxima combinada de solicitudes de memoria que pueden tener todos los contenedores en el espacio de nombres. Al igual que en el caso anterior, puedes tener 50 contenedores de 2 MiB, cinco contenedores de 20 MiB o un único contenedor de 100 MiB, siempre que el total de memoria solicitada en el espacio de nombres sea inferior a 100 mebibytes.
Limits.cpu es el valor combinado máximo de potencia de CPU que pueden utilizar todos los contenedores en el espacio de nombres. Se puede considerar como el límite de las solicitudes de potencia de CPU.
Finalmente, limits.memory es la cantidad máxima de memoria total que pueden usar todos los contenedores en el espacio de nombres. Esta es una limitación de las solicitudes de memoria sumadas.
Por defecto, los contenedores en un clúster de Kubernetes funcionan con recursos de computación ilimitados. A través de las cuotas de recursos, los administradores del clúster pueden restringir el consumo y creación de recursos basándose en el espacio de nombres. En un espacio de nombres, un pod o contenedor puede consumir tanto poder de CPU y memoria como esté definido por la cuota de recursos del espacio de nombres. Sin embargo, existe la preocupación de que un pod o contenedor pueda monopolizar todos los recursos disponibles. Para prevenir esta situación, se utiliza el rango límite Limit Range, una política de restricción de distribución de recursos (para pods o contenedores) en el espacio de nombres.
El rango límite proporciona restricciones que pueden:
- asegurar el uso mínimo y máximo de recursos de computación para cada pod o contenedor en el espacio de nombres;
- forzar un mínimo y máximo de solicitud de almacenamiento Storage Request para cada PersistentVolumeClaim en el espacio de nombres;
- forzar la relación entre la solicitud Request y la limitación Limit para el recurso en el espacio de nombres;
- establecer Requests/Limits por defecto para los recursos de computación en el espacio de nombres y aplicarlos automáticamente a los contenedores en tiempo de ejecución.
Por lo tanto, puedes crear un rango límite en tu espacio de nombres. A diferencia de las cuotas, que se aplican a todo el espacio de nombres, el Limit Range se utiliza para contenedores individuales. Esto puede evitar que los usuarios creen contenedores minúsculos o, por el contrario, gigantescos dentro del espacio de nombres. El rango límite Limit Range podría verse así.
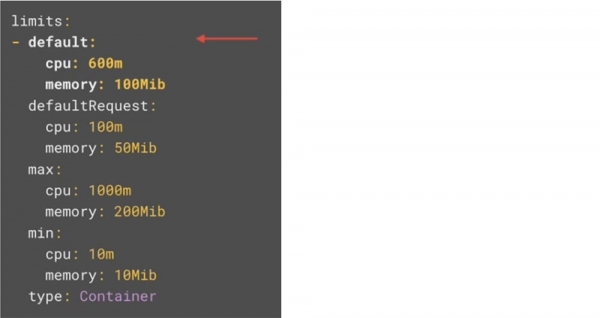
Como en el caso anterior, aquí se pueden distinguir 4 secciones. Vamos a analizar cada una.
En la sección default se establecen las restricciones por defecto para el contenedor en el pod. Si defines estos valores en el rango límite, entonces cualquier contenedor para el cual estos valores no se hayan establecido explícitamente se regirá por los valores por defecto.
En la sección de solicitud por defecto defaultRequest, se configuran las solicitudes por defecto para el contenedor en el pod. Nuevamente, si establece estos valores dentro del rango límite, cualquier contenedor para el cual estos parámetros no estén explícitamente definidos utilizará estos valores por defecto.
En la sección max se indican los límites máximos que se pueden establecer para el contenedor en el pod. Los valores en la sección default y las restricciones para el contenedor no pueden ser establecidos por encima de este límite. Es importante señalar que si se establece un valor max y la sección default no está presente, el valor máximo se convierte en el valor por defecto.
En la sección min se indican las solicitudes mínimas que se pueden establecer para el contenedor en el pod. Además, los valores en la sección default y las solicitudes para el contenedor no pueden ser establecidos por debajo de este límite.
Nuevamente, es importante señalar que si este valor está establecido y el valor default no lo está, el valor mínimo se convierte en la solicitud por defecto.
En última instancia, estas solicitudes de recursos son utilizadas por el programador de Kubernetes para ejecutar sus cargas de trabajo. Para que pueda configurar correctamente sus contenedores, es fundamental comprender cómo funciona esto. Supongamos que desea ejecutar varios módulos en su clúster. Suponiendo que las especificaciones del pod son válidas, se utilizará un balanceo cíclico en la programación de Kubernetes para seleccionar un nodo para ejecutar la carga de trabajo.
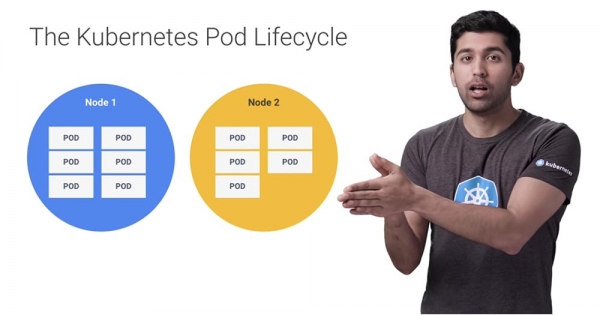
Kubernetes verificará si hay suficientes recursos en el nodo Node 1 para satisfacer las solicitudes de los contenedores del pod, y si no es así, pasará al siguiente nodo. Si ninguno de los nodos en el sistema puede satisfacer las solicitudes, los pods pasarán al estado de espera Pending state. Con funciones como el escalado automático de nodos en Google Kubernetes Engine, GKE puede determinar automáticamente el estado de espera y crear algunos nodos adicionales.
Si posteriormente hay un exceso de capacidad en los nodos, la función de escalado automático reducirá su número para ahorrarle dinero. Por eso Kubernetes programa los pods en función de las solicitudes. Sin embargo, el límite puede ser mayor que las solicitudes, y en algunos casos, un nodo puede agotar realmente sus recursos. Llamamos a ese estado overcommitment state.
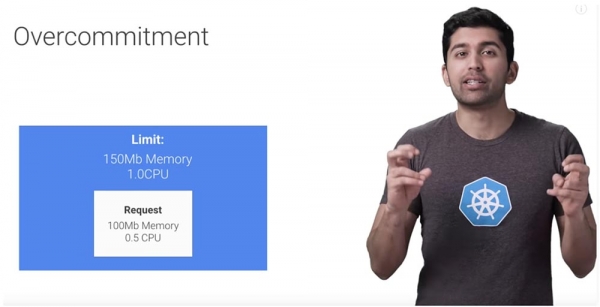
Como ya mencioné, cuando se trata de procesadores, Kubernetes comenzará a limitar los pods. Cada pod obtendrá tanto como solicitó, pero si no alcanza el límite, comenzará a aplicarse el throttling.
En cuanto a los recursos de memoria, Kubernetes se ve obligado a tomar decisiones sobre qué pods eliminar y cuáles conservar, hasta que libere recursos del sistema; de lo contrario, todo el sistema colapsará.
Imaginemos un escenario en el que tiene una máquina que ha agotado el límite de memoria: ¿cómo reaccionará Kubernetes?
Kubernetes buscará pods que estén utilizando más recursos de los que solicitaron. Así que si sus contenedores no tienen solicitudes de Requests, eso significa que por defecto están usando más de lo que pidieron, simplemente porque no solicitaron nada en absoluto. Tales contenedores se convierten en los principales candidatos para ser desconectados. Los siguientes en la lista son los contenedores que satisfacen todas sus solicitudes, pero aún se encuentran por debajo del límite máximo.
Por lo tanto, si Kubernetes encuentra varios pods que han superado los parámetros de sus solicitudes, los clasificará por prioridad y luego eliminará los módulos de menor prioridad. Si todos los módulos tienen la misma prioridad, Kubernetes detendrá los pods que hayan excedido sus solicitudes más que los demás pods.
En casos muy raros, Kubernetes puede interrumpir los pods que aún están dentro de sus solicitudes. Esto puede suceder cuando componentes críticos del sistema, como el agente Kubelet o Docker, comienzan a consumir más recursos de los que les fueron reservados.
Así que, en las etapas iniciales de funcionamiento de pequeñas empresas, un clúster de Kubernetes puede funcionar perfectamente sin establecer solicitudes de recursos y restricciones, pero a medida que sus equipos y proyectos comienzan a crecer, puede arriesgarse a enfrentar problemas en esta área. Agregar solicitudes y restricciones a sus módulos y espacios de nombres requiere muy poco esfuerzo adicional y puede evitar muchos inconvenientes.
Un poco de publicidad 🙂
Gracias por permanecer con nosotros. ¿Te gustan nuestros artículos? ¿Quieres ver más contenido interesante? Apóyanos haciendo un pedido o recomendando a tus conocidos, , un análogo único de servidores entry-level que hemos diseñado para Ti: (disponibles opciones con RAID1 y RAID10, hasta 24 núcleos y hasta 40GB DDR4).
¿Dell R730xd a mitad de precio en el centro de datos Equinix Tier IV en Ámsterdam? Solo aquí ¡en los Países Bajos! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — ¡desde $99! Lee sobre cómo
Fuente: habr.com
