

¡Ding ding ding! Son las 3 de la mañana, estás en un hermoso sueño y de repente, suena el teléfono. Esta semana te toca la guardia y, al parecer, algo ha sucedido. El sistema automatizado te llama para investigar qué pasa. Este es un momento importante en la gestión de los sistemas informáticos modernos, pero veamos cómo hacer que las notificaciones sean más cómodas para las personas.
Conoce la filosofía de monitoreo que nació a lo largo de varias décadas de mis guardias en diferentes equipos de monitoreo. Esta filosofía fue influenciada en gran medida por la verdadera biblia de Rob Eveshuck. (Mi filosofía de notificación), incluida en el libro sobre , y el libro de John Olspaw (Consideraciones sobre la configuración de alertas).
, y — gracias por ayudar a editar la publicación.
¿Qué es CASE?
Decidí crear un acrónimo atractivo, como el o . Lo llamo método CASE. Describe cuatro aspectos a los que se debe prestar atención al trabajar con monitoreo automatizado:
- (vinculado al contexto)
- (valor práctico)
- (enfoque en síntomas)
- (evaluación)
Si utilizas CASE, te tomas las notificaciones con un saludable desprecio y no despiertas a las personas por la noche. Es necesario evaluar regularmente la utilidad y efectividad del monitoreo. Cuando una persona recibe una notificación, tendrá mejores modelos mentales y más confianza.
Para que sea más fácil de recordar, imagina que necesitas un CASE [es decir, un caso, una razón — nota del traductor] para justificar cada notificación. 😎
¿Y todo esto para qué?
. Por muchas razones. Y CASE no eliminará todos ellos. Pero con él, las noches te despertarán con notificaciones de mejor calidad. Este método abarca diferentes procesos organizacionales que también ayudarán en esta tarea.
La belleza de los métodos RED y USE es que, con ellos, no solo sabemos cómo trabajar, sino que también hablamos entre nosotros en el mismo idioma. Espero que con el método CASE sea más fácil discutir notificaciones que protegen nuestros sistemas pero no dan paz a los colegas.
La clave es crear en la organización una cultura donde las notificaciones se tomen con un sano desapego. Las notificaciones pueden generarse de manera pertinente, pero no está garantizado que con el tiempo pierdan su valor. ¿Por qué configuramos esta notificación? ¿Hace cuánto tiempo se revisaron sus criterios? Con CASE se pueden encontrar respuestas a estas preguntas.
Contexto Pesado — vinculación con el contexto
Las 3 de la mañana no son el mejor momento para leer mensajes que contienen demasiadas palabras sofisticadas. Para reaccionar de manera efectiva, se necesita información. Idealmente, debería ser información sobre un problema concreto, donde el contexto sea obvio, y las notificaciones deben configurarse para que esto sea posible. Esto es "observación" y "orientación" del . Es un gasto razonable dedicar tiempo a esta configuración, porque distraer a una persona constantemente resulta aún más costoso. Respetemos unos a otros.
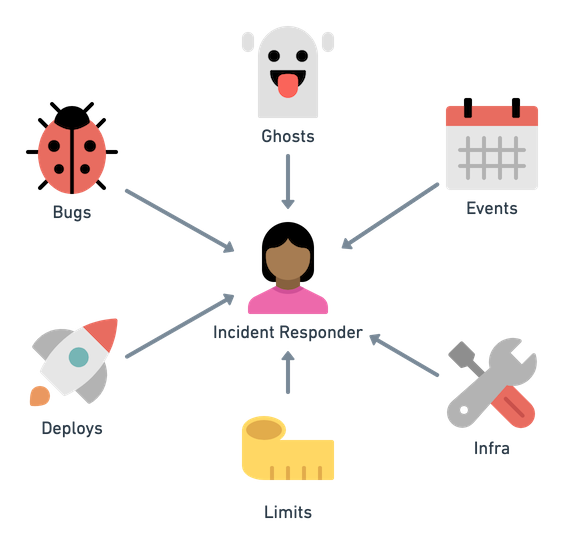
Los problemas tienen muchas fuentes. Especialmente fantasmas.
¿Cómo ayudar al operador de guardia? Primero, el operador ve la notificación, por lo que todas sus hipótesis se basan en ella. Luego revisa instrucciones y paneles de control, pero ¿siempre hay datos sobre la notificación concreta y no solo información general? Olspo sugiere "pensar en cómo se puede interpretar la notificación o cómo reaccionar ante ella" (diapositiva 29). Una buena notificación está centrada en el operador, no simplemente configurada según un valor umbral.
Por lo tanto, aquí hay ideas sobre cómo mejorar el contexto de las notificaciones:
- Muestre al usuario algo útil y creado específicamente para él, no solo instrucciones comunes o un panel de control. Anteriormente, nosotros, junto con los chicos, utilizamos paneles de control para investigaciones, configurados para notificaciones específicas. Esto ayudará si el problema es conocido, pero confundirá en otros casos. Aquí se debe encontrar un equilibrio.
- Cuente la historia de la notificación: ¿es nueva? ¿Se activa con frecuencia? ¿Es estacional?
- Muestre los cambios recientes en el estado del sistema. ¿Ha habido algo reciente? (Por ejemplo, despliegues o activación/desactivación de funciones.)
- Muestre las relaciones y brinde información para un modelo mental: las dependencias del sistema deben ser claramente visibles, preferiblemente indicando su operatividad.
- Conéctelo rápidamente con el equipo: ¿ve los incidentes actuales o puede averiguar quién más en la empresa recibió la notificación? El programa ¿Está activado?
Idealmente, un programa de gestión de incidentes debe ofrecer consejos sobre cómo mejorar el contexto de la notificación durante la investigación de incidentes. ¡Siempre hay espacio para mejorar!
Accionable — valor práctico
¿El de guardia debe hacer algo en respuesta a la notificación? Si no hay que hacer nada o no está claro qué hacer, ¿por qué lo despertaron? Necesitamos evitar notificaciones que molesten a los de guardia y no requieran acciones.
¿Qué se supone que hay que hacer? ¿Qué se necesita?
Antes, cuando los sistemas eran simples y los equipos pequeños, configurábamos el monitoreo solo para mantenernos informados. Una notificación de que la carga ha aumentado nos dará contexto si luego el servicio experimenta fallos. A gran escala, tales notificaciones solo confundirán, porque nuestros sistemas siempre operan en un estado de degradación de diversos grados. Esto lleva rápidamente a y, por supuesto, a la pérdida de sensibilidad. Por eso, el de guardia ignora o incluso filtra tales notificaciones y no siempre responde como debería. ¡No caigan en esta trampa! No configuren todas las notificaciones indiscriminadamente para luego enviarlas a un correo en una carpeta olvidada.
Así es como se ve una notificación con valor práctico:
- La notificación requiere acción, no solo informa sobre novedades.
- Esta acción es difícil o arriesgada de automatizar. Si la acción puede automatizarse, ¡hagan la automatización y dejen de molestar a la gente!
- La notificación contiene recomendaciones urgentes en forma de (SLA) o (RTO). Entonces, el de guardia puede activar el programa de gestión de incidentes en la organización.
Quiero aclarar: no estoy diciendo que las notificaciones solo deban enviarse por los SLO (objetivos de nivel de servicio) más importantes para APIs. El monitoreo de SLO se fragmenta y se divide continuamente y requiere un enfoque uniforme para todos los servicios. Es evidente que rastrearás los SLO más importantes para los clientes que te pagan. Pero también es necesario rastrear los SLO de infraestructura, como bases de datos. Pronto tendrás que ocuparte de los clientes internos y mantenerlos. Y así sin fin.
Con base en síntomas — énfasis en los síntomas
Te guste o no, trabajas en un sistema distribuido (Kavadj). Como resultado, utilizas diferentes tácticas para aislar los servicios y protegerlos de fallos (Treynor et al.) 3. Y aunque la recolección de basura prolongada o una consulta a la base de datos que se detiene indican problemas, no es necesario apresurarse a resolverlos si no hay problemas para los usuarios en el corto plazo.
Estas son señales importantes y pueden tener valor práctico, pero si no interfieren con los usuarios, no son tan urgentes como para distraer al operador. Las notificaciones basadas en causas son instantáneas de nuestros modelos mentales sobre fallos del sistema. Es mejor rastrear síntomas importantes que intentar enumerar todas las posibles causas de la falla.
Para que las notificaciones tengan valor práctico, concéntrate en , que son importantes para los usuarios. Evashchuk lo llama "monitoreo para usuarios". Recuerda que esta filosofía debe aplicarse en toda la organización. Si un servicio enfrenta problemas urgentes en alguna parte de la infraestructura, el equipo correspondiente se encargará de ello. Proteger los sistemas de tales fallos es un asunto completamente distinto (Treynor et al., sección sobre estrategias para minimizar dependencias críticas)..
Los síntomas no son tan cambiantes
Richard Cook recuerda que en sistemas complejos hay un montón de defectos, fallos y problemas.Tratar de enumerar todas las posibles causas es un trabajo de Sísifo. Intentas describir problemas, y estos cambian constantemente. Cindy Shridharan cree que "los sistemas no tienen que estar en un estado perfecto todo el tiempo" y es mejor utilizar un enfoque más humano ( ("Distributed Systems Observability"), 7).
Evita las notificaciones sobre el hecho del incidente
Normalmente, las notificaciones se configuran para causas al corregir incidentes. Y estas notificaciones limitadas sobre el hecho de que algo ha sucedido crean una falsa sensación de confianza, ya que el sistema siempre encuentra nuevas formas de romperse.
No te engañes con notificaciones sobre causas. Mejor piensa:
- ¿Por qué la notificación basada en síntomas no detectó el problema?
- ¿Sería útil mejorar el contexto para el usuario?
- ¿Cómo mejorar las herramientas de monitoreo para diagnosticar más rápidamente en lugar de acumular notificaciones sobre lo ocurrido?
Las herramientas de monitoreo para diagnóstico solo ayudarán si las consideras como un medio para pasar de los síntomas a la solución. Sin este feedback, simplemente estarás inundado de notificaciones tardías y gráficos sobre fallos pasados — y nada acerca de los futuros. Para la organización, es una excelente oportunidad para pasar de la defensa a la ofensiva. Y los desarrolladores y gerentes de producto tendrán las mismas expectativas y objetivos claros. El caso — CASE (:wink:) — es claro para cada notificación.
Las notificaciones basadas en causas son tolerables en cantidades moderadas.
A veces, nuestro sistema prácticamente no nos deja otra opción en cuanto a notificaciones basadas en causas. Y otras veces, los de guardia comprenden perfectamente que el síntoma necesariamente conducirá a una falla, lo que le da un valor práctico. Tal vez simplemente no estás seguro de lo que está sucediendo y ajustas las notificaciones por precaución. Esperemos que esta acción sea temporal, mientras cambiamos el sistema para abordar la cuestión del rendimiento degradado.
Recuerda otros componentes de CASE al manejar estas situaciones. Que sea temporal, no significa que debas dejar de pensar.
Evaluado — evaluación
Cualquier cambio en el sistema (nuevo código, nueva infraestructura, cualquier cosa nueva) amplía la variedad de fallos (Cook, 3). ¿Esta notificación todavía está funcionando como se esperaba? Modelos mentales claros y actuales de sistemas y experiencias de respuesta a ciertas notificaciones en apoyo — son características clave . Los defectos en los sistemas evolucionan continuamente, y debemos mantenernos al día con ellos.
Es necesario evaluar constantemente la calidad de cada notificación para que funcionen como se esperaba. ¡Estimados líderes! A sus equipos les resultará mucho más fácil si les ayudan a establecer este proceso. Aquí hay algunas ideas para la evaluación:
- desde cualquier lugar del mundo. Es la solución ideal para crear una oficina en la nube, donde todos los programas y datos de los empleados están en un entorno seguro , u otros métodos de prueba de notificaciones. ¡El equipo puede hacerlo por sí mismo, sin involucrar un pesado sistema de gestión de incidentes!
- Habilita la recopilación de datos sobre todas las notificaciones relacionadas con incidentes en el programa de gestión de incidentes. Marca las útiles, dañinas, inapropiadas, confusas, etc. Utilízalas como retroalimentación.
- Las notificaciones correctas se activan raramente y han sido revisadas minuciosamente. Asegúrate de que todos los enlaces funcionen y apunten al contexto adecuado, etc.
- Si una notificación nunca se activa o se activa con demasiada frecuencia, hay un problema. Arréglala o elimínala. ¡Cuidado con la pasividad o la actividad excesiva!
- Configura para las notificaciones marcas de tiempo con fecha de caducidad. Si la fecha de caducidad pasa, evalúa la notificación utilizando el método CASE y actualiza la marca de tiempo. Revisa regularmente la caducidad, como los productos alimenticios.
- Simplifica el proceso de mejora de notificaciones. Usa monitoreo en forma de código y almacena las notificaciones en un repositorio Git. Los pull requests ayudan a involucrar al equipo, y tendrás un historial de notificaciones pasadas. Así dejarás de temer cambiar notificaciones o pedir permiso a quienes las gestionan.
- Establece retroalimentación para las notificaciones, incluso si es solo , para que los responsables marquen las notificaciones como inútiles u molestas. Incorpora en la propia notificación un enlace o llamada a la acción y revisa la retroalimentación regularmente.
- Establece en el equipo la regla de que los responsables deben trabajar para simplificar el turno cuando hay poco trabajo. Que después de ti, todo sea un poco mejor que antes.
Conclusión
Creo que el método CASE ayuda a desarrolladores y organizaciones a discutir la configuración y el envío de notificaciones automáticas. Un desarrollador puede comenzar a evaluar las notificaciones utilizando el método CASE y luego unirse a él toda la organización con otros desarrolladores, la gestión y los programas de gestión de incidentes para mantener las notificaciones en buen estado. No se necesitan herramientas especiales ni procesos complejos para esto.
Toda la industria debe considerar el factor humano durante los turnos sin perjudicar el servicio al cliente de primera clase. Todas estas herramientas y prácticas se pueden y deben mejorar. Espero que el método CASE ayude en esto.
¡Disfruta de las notificaciones mejoradas!
Fuente: habr.com
