

Hola.
Decidí compartir mi hallazgo: el fruto de mis reflexiones, pruebas y errores.
En gran medida: esto no es ningún hallazgo, por supuesto, todo esto debería ser conocido desde hace tiempo por aquellos que se dedican a la estadística aplicada y a la optimización de cualquier sistema, no necesariamente sistemas de gestión de bases de datos.
Y: sí, lo saben, escriben artículos interesantes sobre sus investigaciones. (UPD.: en los comentarios mencionan un proyecto muy interesante: )
Por otro lado: a primera vista, no veo una amplia mención y difusión de tal enfoque en internet, entre los especialistas en TI y los DBA.
Entonces, al grano.
Supongamos que tenemos la tarea de configurar algún sistema de servicio para realizar un trabajo específico.
Sobre este trabajo, se sabe: cómo es, en qué se mide la calidad de este trabajo y cuál es el criterio para medir esa calidad.
También supongamos que, más o menos, está claro cómo se realiza el trabajo en (o con) este sistema de servicio.
"Más o menos" significa que hay la posibilidad de preparar (o conseguir de alguna manera) alguna herramienta, utilidad, servicio con el que se puede sintetizar y aplicar al sistema una carga de prueba lo suficientemente adecuada a lo que habrá en producción, en condiciones razonablemente similares a las de producción.
Y, supongamos que se conoce el conjunto de parámetros de ajuste de este sistema de servicio que se pueden utilizar para configurarlo en términos de productividad de su funcionamiento.
Y, cuál es el problema: no hay un entendimiento suficientemente completo de este sistema de servicio, que permita ajustar este sistema de manera experta, para la carga futura, en esta plataforma y obtener la productividad del sistema que se necesita.
Bueno. Así es, casi siempre.
¿Qué se puede hacer aquí?
Lo primero que se me ocurre: consultar la documentación de este sistema. Entender cuáles son los rangos permitidos de los valores de los parámetros de ajuste. Y, por ejemplo, mediante el método de descenso de coordenadas, ajustar los valores de los parámetros del sistema en las pruebas.
Es decir, establecer al sistema alguna configuración, en forma de un conjunto específico de valores de sus parámetros de ajuste.
Aplicar una carga de prueba a él, utilizando esa misma herramienta-utilidad, generador de carga.
Y observar la magnitud — la respuesta, o la métrica de calidad del funcionamiento del sistema.
El segundo pensamiento puede ser la conclusión de que — esto toma mucho tiempo.
Es decir, si hay muchos parámetros de configuración, si los rangos que abarcan sus valores son amplios, si cada prueba de carga toma mucho tiempo para ejecutarse, entonces: sí, todo esto puede llevar un tiempo inaceptablemente largo.
Y aquí se puede entender y recordar.
Se puede averiguar que, en el conjunto de valores de los parámetros de configuración del sistema de servicio, existe un vector, como una secuencia de ciertos valores.
A cada uno de estos vectores, bajo igualdad de condiciones (en lo que este vector no se ve afectado) le corresponde un valor definitivo de la métrica — el indicador de calidad del funcionamiento del sistema bajo carga de prueba.
Es decir,
Denotemos el vector de configuración del sistema como  , donde
 ; Donde
 — el número de parámetros de configuración del sistema, cuántos son, estos parámetros.
Y el valor de la métrica correspondiente a este  lo denotaremos como
 , entonces, obtenemos la función:

Y entonces: todo se reduce inmediatamente a, en mi caso: casi olvidados desde la época estudiantil, algoritmos de búsqueda de extremos de funciones.
Bien, pero aquí surge una pregunta organizacional y práctica: ¿qué algoritmo específico utilizar?
- Es decir, para no tener que codificar mucho a mano.
- Y que funcione, es decir, que encuentre el extremo (si existe), al menos — más rápido que el descenso por coordenadas.
El primer momento sugiere que debemos mirar hacia ciertos entornos en los que estos algoritmos ya están implementados y existen, de alguna forma, listos para ser utilizados en el código.
Bueno, conozco python y cran-r
El segundo momento indica que es necesario leer sobre los propios algoritmos, cuáles existen, qué requisitos y características de funcionamiento tienen.
Y qué ofrecen, pueden producir efectos secundarios útiles, ya sea directamente del propio algoritmo.
O se pueden obtener como resultado del trabajo del algoritmo.
Aquí mucho depende de las condiciones de entrada.
Por ejemplo, si, por alguna razón, se necesita obtener el resultado más rápido, hay que mirar hacia los algoritmos de descenso por gradientes y seleccionar alguna de ellas.
O, si el tiempo no es tan importante, se pueden usar métodos de optimización estocástica, como el algoritmo genético.
Propongo considerar el trabajo de este enfoque, para seleccionar la configuración del sistema, usando un algoritmo genético, en el siguiente, digamos: trabajo laboratorial.
Datos iniciales:
- Supongamos que hay un sistema de servicio:
oracle xe 18c - Supongamos que este sistema gestiona la actividad transaccional y el objetivo es lograr la mayor capacidad de procesamiento posible para la base de datos en transacciones/segundo.
- Las transacciones pueden variar mucho en su naturaleza al trabajar con datos y en el contexto de uso.
Acordemos que son transacciones que no procesan una gran cantidad de datos tabulares.
En el sentido de que no generan más datos de undo que de redo y no procesan grandes porcentajes de filas en tablas grandes.
Son transacciones que cambian una fila en una tabla más o menos grande, con un número reducido de índices sobre esa tabla.
Bajo este escenario, la productividad de la base de datos al procesar transacciones se definirá, con la salvedad, por la calidad del manejo de los datos de redo.
La salvedad es si hablamos específicamente sobre la configuración de la base de datos.
Porque, en general, pueden existir bloqueos transaccionales entre sesiones SQL, debido al diseño de la operación del usuario con los datos tabulares y/o el modelo tabular.
Estos, por supuesto, afectarán negativamente a la métrica de tps y será un factor exógeno, relativo a la base de datos: así fue diseñado el modelo tabular y el manejo de datos que ocasiona bloqueos.
Por lo tanto, para la claridad del experimento, excluyamos este factor, a continuación aclararé cómo exactamente.
- Supongamos, para ser precisos, que el 100% de los comandos SQL enviados a la base de datos son comandos DML.
Las características del trabajo del usuario con la base de datos son las mismas en las pruebas.
Es decir: número de sesiones SQL, datos tabulares, la manera en que las sesiones SQL trabajan con ellos. - La base de datos opera en
FORCE LOGGING,ARCHIVELOGmodos. El modo de Flashback de la base de datos está desactivado a nivel de la base de datos. - Los redo-logs están ubicados en un sistema de archivos separado, en un "disco" separado;
Toda la otra parte del componente físico de la base de datos está en otro sistema de archivos separado, en otro "disco":
Más detalles sobre la estructura del componente físico de la base de datos de laboratorio.
SQL> select status||' '||name from v$controlfile;
 /db/u14/oradata/XE/control01.ctl
SQL> select GROUP#||' '||MEMBER from v$logfile;
1 /db/u02/oradata/XE/redo01_01.log
2 /db/u02/oradata/XE/redo02_01.log
SQL> select FILE_ID||' '||TABLESPACE_NAME||' '||round(BYTES/1024/1024,2)||' '||FILE_NAME as col from dba_data_files;
4 UNDOTBS1 2208 /db/u14/oradata/XE/undotbs1_01.dbf
2 SLOB 128 /db/u14/oradata/XE/slob01.dbf
7 USERS 5 /db/u14/oradata/XE/users01.dbf
1 SYSTEM 860 /db/u14/oradata/XE/system01.dbf
3 SYSAUX 550 /db/u14/oradata/XE/sysaux01.dbf
5 MONITOR 128 /db/u14/oradata/XE/monitor.dbf
SQL> !cat /proc/mounts | egrep "\/db\/u[0-2]"
/dev/vda1 /db/u14 ext4 rw,noatime,nodiratime,data=ordered 0 0
/dev/mapper/vgsys-ora_redo /db/u02 xfs rw,noatime,nodiratime,attr2,nobarrier,inode64,logbsize=256k,noquota 0 0
Inicialmente, bajo estas condiciones de carga, quería usar la base de datos para transacciones.
Tiene una característica notable, cito al autor:
En el corazón de SLOB está el 'método SLOB.' El método SLOB tiene como objetivo probar plataformas
sin contención de aplicaciones. No se puede impulsar el rendimiento máximo del hardware
usando código de aplicación que, por ejemplo, esté limitado por bloqueos de aplicación o incluso
compartiendo bloques de datos de Oracle Database. ¡Así es! Hay una sobrecarga al compartir datos
en bloques de datos. Pero SLOB, en su implementación predeterminada, es inmune a tal contención.
Esta declaración: corresponde, y así es.
Es conveniente regular el grado de paralelismo de las sesiones SLOB, este es clave -t para iniciar la utilidad. runit.sh dentro del conjunto de SLOB.
Se regula el porcentaje de comandos DML, en el número de consultas que envía a la base de datos cada sesión de consulta, parámetro UPDATE_PCT.
Separado y muy conveniente: SLOB mismo, antes y después de la sesión de carga, prepara Statspack o instantáneas AWR (lo que se haya configurado para preparar).
Sin embargo, se descubrió que SLOB no soporta el funcionamiento de sesiones de consulta con una duración de menos de 30 segundos.
Por lo tanto, primero codifiqué mi propia versión del generador de carga, y luego se mantuvo en uso.
Aclararé sobre el generador de carga: qué y cómo hace, para mayor claridad.
En esencia, el generador de carga se ve así:
Código del trabajador
function dotx()
{
local v_period="$2"
[ -z "v_period" ] && v_period="0"
source "/home/oracle/testingredotrace/config.conf"

$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror exit failure
set verify off
set echo off
set feedback off

define wnum="$1"
define period="$v_period"
set appinfo worker_&&wnum

declare
 v_upto number;
 v_key  number;
 v_tots number;
 v_cts  number;
begin
 select max(col1) into v_upto from system.testtab_&&wnum;
 SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 v_tots := &&period + v_cts;
 while v_cts <= v_tots
 loop
  v_key:=abs(mod(dbms_random.random,v_upto));
  if v_key=0 then
   v_key:=1;
  end if;
  update system.testtab_&&wnum t
  set t.object_name=translate(dbms_random.string('a', 120), 'abcXYZ', '158249')
  where t.col1=v_key
  ;
  commit;
  SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 end loop;
end;
/

exit
__EOF__
}
export -f dotx
Los trabajadores se inician de esta manera:
Inicio de los trabajadores.
echo "iniciando prueba, duración: ${TEST_DURATION}" >> "$v_logfile"
for((i=1;i> "$v_logfile"
 dotx "$i" "${TEST_DURATION}" &
done
echo "esperando..." >> "$v_logfile"
wait
Y las tablas para los trabajadores se preparan así:
Creación de tablas
function createtable() {
source "\/home\/oracle\/testingredotracе\/config.conf"
$ORACLE_HOME\/bin\/sqlplus -S system\/${v_system_pwd} << __EOF__
whenever sqlerror continue
set verify off
set echo off
set feedback off

define wnum="$1"
define ts_name="slob"

begin
 execute immediate 'drop table system.testtab_&&wnum';
exception when others then null;
end;
\/\n
create table system.testtab_&&wnum tablespace &&ts_name as
select rownum as col1, t.*
from sys.dba_objects t
where rownum> "$v_logfile"
Es decir, para cada trabajador (prácticamente: una sesión SQL separada en la base de datos) se crea una tabla separada, con la que trabaja el trabajador.
Esto se logra al evitar bloqueos transaccionales entre las sesiones SQL de los trabajadores.
Cada trabajador: hace lo mismo, con su tabla, todas las tablas son iguales.
Los trabajadores todos — realizan el trabajo durante la misma cantidad de tiempo.
Además — un tiempo suficientemente largo para que, por ejemplo, definitivamente ocurra, y no una sola vez, el cambio de registro.
Y, en consecuencia, se generan gastos y efectos relacionados.
En mi caso — la duración del trabajo de los trabajadores la configuré en 8 minutos.
Un fragmento del informe statspack, con la descripción del funcionamiento de la base de datos bajo carga.
Base de datos    Id de DB    Instancia     Num de Inst  Hora de inicio   Versión     RAC
~~~~~~~~ ----------- ------------ -------- --------------- ----------- ---
          2929910313 XE                  1 07-Sep-20 23:12 18.0.0.0.0  NO

Nombre del host             Plataforma                CPUs Núcleos Sockets   Memoria (G)
~~~~ ---------------- ---------------------- ----- ----- ------- ------------
     billing.izhevsk1 Linux x86 64-bit           2     2       1         15.6

Captura       Id de captura     Hora de captura      Sesiones Curs/Sess Comentario
~~~~~~~~    ---------- ------------------ -------- --------- ------------------
Captura inicial:       1630 07-Sep-20 23:12:27       55        .7
  Captura final:       1631 07-Sep-20 23:20:29       62        .6
   Transcurrido:       8.03 (mins) Act. Prom. Sess:       8.4
   Tiempo en DB:      67.31 (mins)      CPU DB:      15.01 (mins)

Tamaños de caché            Inicio        Fin
~~~~~~~~~~~       ---------- ----------
    Caché de buffer:     1,392M              Tamaño de bloque estándar:         8K
     Pool compartido:       288M                  Caché de registro:   103,424K

Perfil de carga              Por segundo    Por transacción    Por ejecución    Por llamada
~~~~~~~~~~~~      ------------------  ----------------- ----------- -----------
      Tiempo en DB(s):                8.4                0.0        0.00        0.20
       CPU DB(s):                1.9                0.0        0.00        0.04
       Tamaño de redo:        7,685,765.6              978.4
   Lecturas lógicas:           60,447.0                7.7
   Cambios en bloques:           47,167.3                6.0
  Lecturas físicas:                8.3                0.0
 Escrituras físicas:              253.4                0.0
      Llamadas de usuario:               42.6                0.0
          Análisis:               23.2                0.0
     Análisis difíciles:                1.2                0.0
W/A MB procesados:                1.0                0.0
          Inicios de sesión:                0.5                0.0
        Ejecuciones:           15,756.5                2.0
       Deshacer:                0.0                0.0
    Transacciones:            7,855.1
Volviendo a la formulación del trabajo de laboratorio.
Vamos a variar, todas las demás condiciones iguales, los valores de los siguientes parámetros de la base de datos de laboratorio:
- Tamaño de grupos de registros de la base de datos. Rango de valores: [32, 1024] Mbytes;
- Cantidad de grupos de registros de la base de datos. Rango de valores: [2,32];
log_archive_max_processesrango de valores: [1,8];commit_loggingse permiten dos valores:batch|immediate;commit_waitse permiten dos valores:wait|nowait;log_bufferrango de valores: [2,128] Mbytes.log_checkpoint_timeoutrango de valores: [60,1200] segundosdb_writer_processesrango de valores: [1,4]undo_retentionrango de valores: [30;300] segundostransactions_per_rollback_segmentrango de valores: [1,8]disk_asynch_iose permiten dos valores:true|false;filesystemio_optionsse permiten los siguientes valores:none|setall|directIO|asynch;db_block_checkingse permiten los siguientes valores:OFF|LOW|MEDIUM|FULL;db_block_checksumse permiten los siguientes valores:OFF|TYPICAL|FULL;
Una persona con experiencia en la gestión de bases de datos Oracle puede sin duda decir ahora qué y qué valores se deben establecer de los parámetros indicados y sus valores permitidos para obtener una mayor productividad de la base de datos, según el trabajo con los datos determinado por el código de aplicación, aquí arriba.
Pero.
El objetivo del trabajo de laboratorio es demostrar que el algoritmo de optimización puede aclararnos esto de manera eficiente y relativamente rápida.
Por lo tanto, solo queda consultar la documentación sobre el sistema configurable, justo lo suficiente para averiguar: qué parámetros y en qué rangos se deben modificar.
Así como también: codificar el código que implementará el trabajo con el sistema configurable del algoritmo de optimización elegido.
Así que, ahora sobre el código.
Antes mencioné sobre cran-r, es decir: todas las manipulaciones con el sistema configurable se orquestan en forma de un script R.
La tarea, el análisis, la selección según el valor de la métrica, los vectores de estado del sistema: este es el paquete GA ()
El paquete, en este caso, no es muy adecuado, en el sentido de que espera que se le asignen vectores (cromosomas, si se utiliza la terminología del paquete) en forma de números enteros con parte decimal.
Y mi vector, a partir de los valores de los parámetros configurables: son 14 magnitudes — números enteros y valores de texto.
El problema, por supuesto, se puede sortear fácilmente asignando a los valores de texto algunos números específicos.
Así que, al final, la parte principal del script R se ve así:
Llamada GA::ga
cat("", file=v_logfile, sep="n", append=F)

pSize = 10
elitism_value=1
pmutation_coef=0.8
pcrossover_coef=0.1
iterations=50

gam=GA::ga(type="real-valued", fitness=evaluate,
lower=c(32,2, 1,1,1,2,60,1,30,1,0,0, 0,0), upper=c(1024,32, 8,10,10,128,800,4,300,8,10,40, 40,30),
popSize=pSize,
pcrossover = pcrossover_coef,
pmutation = pmutation_coef,
maxiter=iterations,
run=4,
keepBest=T)
cat("GA-session is done", file=v_logfile, sep="n", append=T)
gam@solution
Aquí, con ayuda de lower y upper atributos de la subrutina ga se establece, en esencia, el área del espacio de búsqueda dentro de la cual se buscará tal vector (o vectores) para los que se obtenga el valor máximo de la función de aptitud.
La subrutina ga realiza la búsqueda maximizando la función de aptitud.
Por lo tanto, resulta que, en este caso, la función de aptitud, entendiendo el vector como un conjunto de valores para ciertos parámetros del SGBD, debe obtener la métrica del SGBD.
Es decir: cuántas transacciones por segundo procesa el SGBD, dado un ajuste específico del SGBD y una carga específica en el SGBD.
Es decir, desglosándolo, se necesita que dentro de la función de aptitud se realice una serie de pasos:
- Procesamiento del vector de entrada de números — transformación en valores para los parámetros del SGBD.
- Intento de crear el número especificado de grupos de redo, de tamaño especificado. Y en la medida en que el intento: puede ser fallido.
Los grupos de registros existentes en la base de datos, en cierta cantidad y de cierto tamaño, deben ser eliminados para la limpieza del experimento. - Si el paso anterior tiene éxito: establecer la base de valores de los parámetros de configuración (de nuevo: puede haber fallos).
- Si el paso anterior tiene éxito: detener la base de datos, reiniciar la base de datos para que los nuevos valores de los parámetros entren en vigor. (de nuevo: puede haber fallos).
- Si el paso anterior tiene éxito: realizar una prueba de carga. Obtener métricas de la base de datos.
- Restaurar la base de datos a su estado original, es decir, eliminar los grupos de registros adicionales, y devolver la configuración original de la base de datos a su funcionamiento.
Código de la función de ajuste
evaluate=function(p_par) {
v_module="evaluate"
v_metric=0
opn=NULL
opn$rg_size=round(p_par[1],digit=0)
opn$rg_count=round(p_par[2],digit=0)
opn$log_archive_max_processes=round(p_par[3],digit=0)
opn$commit_logging="BATCH"
if ( round(p_par[4],digit=0) > 5 ) {
 opn$commit_logging="IMMEDIATE"
}
opn$commit_logging=paste("'", opn$commit_logging, "'",sep="")

opn$commit_wait="WAIT"
if ( round(p_par[5],digit=0) > 5 ) {
 opn$commit_wait="NOWAIT"
}
opn$commit_wait=paste("'", opn$commit_wait, "'",sep="")

opn$log_buffer=paste(round(p_par[6],digit=0),"m",sep="")
opn$log_checkpoint_timeout=round(p_par[7],digit=0)
opn$db_writer_processes=round(p_par[8],digit=0)
opn$undo_retention=round(p_par[9],digit=0)
opn$transactions_per_rollback_segment=round(p_par[10],digit=0)
opn$disk_asynch_io="true"
if ( round(p_par[11],digit=0) > 5 ) {
 opn$disk_asynch_io="false"
}

opn$filesystemio_options="none"
if ( round(p_par[12],digit=0) > 10 && round(p_par[12],digit=0)  20 && round(p_par[12],digit=0)  30 ) {
 opn$filesystemio_options="asynch"
}

opn$db_block_checking="OFF"
if ( round(p_par[13],digit=0) > 10 && round(p_par[13],digit=0)  20 && round(p_par[13],digit=0)  30 ) {
 opn$db_block_checking="FULL"
}

opn$db_block_checksum="OFF"
if ( round(p_par[14],digit=0) > 10 && round(p_par[14],digit=0)  20 ) {
 opn$db_block_checksum="FULL"
}

v_vector=paste(round(p_par[1],digit=0),round(p_par[2],digit=0),round(p_par[3],digit=0),round(p_par[4],digit=0),round(p_par[5],digit=0),round(p_par[6],digit=0),round(p_par[7],digit=0),round(p_par[8],digit=0),round(p_par[9],digit=0),round(p_par[10],digit=0),round(p_par[11],digit=0),round(p_par[12],digit=0),round(p_par[13],digit=0),round(p_par[14],digit=0),sep=";")
cat( paste(v_module," intenta evaluar el vector: ", v_vector,sep="") , file=v_logfile, sep="n", append=T)

rc=make_additional_rgroups(opn)
if ( rc!=0 ) {
 cat( paste(v_module,"falló al crear grupos adicionales",sep="") , file=v_logfile, sep="n", append=T)
 return (0)
}

v_rc=0
rc=set_db_parameter("log_archive_max_processes", opn$log_archive_max_processes)
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_logging", opn$commit_logging )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_wait", opn$commit_wait )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_buffer", opn$log_buffer )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_checkpoint_timeout", opn$log_checkpoint_timeout )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_writer_processes", opn$db_writer_processes )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("undo_retention", opn$undo_retention )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("transactions_per_rollback_segment", opn$transactions_per_rollback_segment )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("disk_asynch_io", opn$disk_asynch_io )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("filesystemio_options", opn$filesystemio_options )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checking", opn$db_block_checking )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checksum", opn$db_block_checksum )
if ( rc != 0 ) {  v_rc=1 }

if ( rc!=0 ) {
 cat( paste(v_module," no se puede iniciar la base de datos con ese vector de configuraciones",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("immediate")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=stop_db("immediate")
rc=start_db("")
if ( rc!=0 ) {
 cat( paste(v_module," no se puede iniciar la base de datos con ese vector de configuraciones",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("abort")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=run_test()
v_metric=getmetric()

rc=stop_db("immediate")
rc=create_spfile()
rc=start_db("")
rc=remove_additional_rgroups(opn)

cat( paste("resultado: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)
return (v_metric)
}
Por lo tanto, todo el trabajo se realiza en la función de aptitud.
Subprograma ga, que realiza el procesamiento de vectores, o, más correctamente, de cromosomas.
En el que lo que más nos importa es: la selección de cromosomas con tales genes, para los cuales la función de aptitud produce valores altos.
Este es, en esencia, el proceso de búsqueda del conjunto óptimo de cromosomas en un espacio de búsqueda N-dimensional.
Muy claro, detallado , con ejemplos de código R, funcionando con el algoritmo genético.
Separadamente, señalaré dos aspectos técnicos.
Llamadas auxiliares, de la función evaluate, por ejemplo, la parada-inicio, la asignación del valor de un parámetro de la base de datos, se realizan sobre la base de cran-r la función system2
Con la que se llama a algún script bash o comando.
Por ejemplo:
set_db_parameter
set_db_parameter=function(p1, p2) {
v_module="set_db_parameter"
v_cmd="/home/oracle/testingredotracе/set_db_parameter.sh"
v_args=paste(p1," ",p2,sep="")

x=system2(v_cmd, args=v_args, stdout=T, stderr=T, wait=T)
if ( length(attributes(x)) > 0 ) {
 cat(paste(v_module," failed with: ",attributes(x)$status," ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (attributes(x)$status)
}
else {
 cat(paste(v_module," ok: ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (0)
}
}
El segundo aspecto es la línea de evaluate la función, con la preservación del valor específico de la métrica y su correspondiente vector de ajuste, en el archivo de registro:
cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)Esto es importante, ya que de este conjunto de datos se podrá obtener información adicional sobre cuál de los componentes del vector de ajuste afecta más o menos al valor de la métrica.
Es decir, se podrá realizar un análisis de importancia de atributos.
Entonces, ¿qué puede resultar?
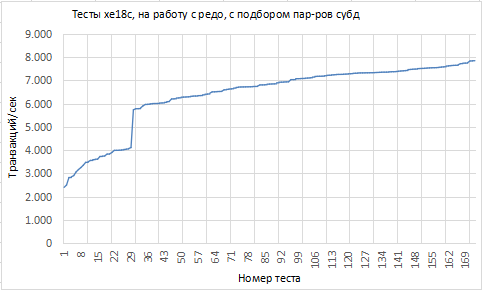
En forma de gráfico, si ordenamos las pruebas de acuerdo con el aumento de la métrica, se ve así:
Algunos datos que corresponden a los valores extremos de la métrica:
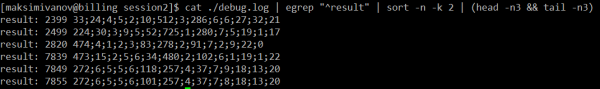
Aquí, en la captura de pantalla con los resultados, aclaro: los valores del vector de ajuste se dan en términos del código de la función de aptitud, no en términos de una lista de números/rangos de valores de parámetros, que se formuló anteriormente en el texto.
Bueno. Si esto es mucho o poco, ~8 mil tps: es un tema aparte.
En el marco del trabajo de laboratorio, este número no es importante, lo importante es la dinámica, cómo cambia este valor.
La dinámica aquí es buena.
Es evidente que, al menos un factor que afecta significativamente el valor de la métrica, el algoritmo ga, al explorar vectores-cromosomas, lo ha cubierto.
Según la dinámica bastante activa de los valores de la curva, hay al menos un factor más que, aunque sea significativamente menor, tiene influencia.
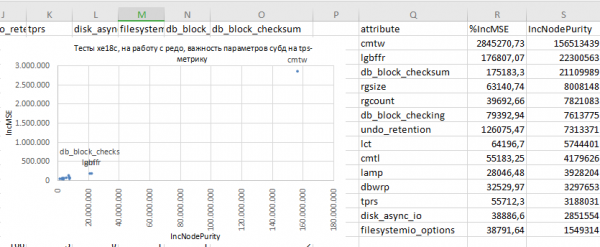
Aquí se necesita attribute-importance un análisis para entender qué atributos (en este caso, componentes del vector de configuración) y cuánto afectan el valor de la métrica.
Y a partir de esta información, entender qué factores fueron afectados por los cambios en los atributos significativos.
Ejecutar attribute-importance puede hacerse de varias maneras.
Para estos fines, me gusta el algoritmo randomForest del paquete R del mismo nombre (como entiendo su funcionamiento y su enfoque para evaluar la importancia de los atributos, construye un modelo de dependencia de la variable de respuesta a partir de los atributos.)
randomForestEn nuestro caso, la variable de respuesta es la métrica obtenida de las bases de datos en las pruebas de carga:
tps Y los atributos son los componentes del vector de configuración.;
Así que
evalúa la importancia de cada atributo del modelo con dos números: randomForest %IncMSE — cómo la presencia/ausencia de este atributo en el modelo altera la calidad MSE de este modelo (Error Cuadrático Medio); Y IncNodePurity es un número que refleja cuán bien, según los valores de este atributo, se puede dividir el conjunto de datos con observaciones, de manera que en una parte queden los datos con un solo valor de la métrica explicada, y en la otra con otro valor de la métrica.
Es decir: cuán clasificador es este atributo (la explicación más clara en ruso que he visto sobre random forest).
Código R típico para procesar un conjunto de datos con los resultados de pruebas de carga: ).
x=NULL v_data_file=paste('\/tmp\/data1.dat',sep="") x=read.table(v_data_file, header = TRUE, sep = ";", dec=",", quote = ""'", stringsAsFactors=FALSE) colnames(x)=c('metric','rgsize','rgcount','lamp','cmtl','cmtw','lgbffr','lct','dbwrp','undo_retention','tprs','disk_async_io','filesystemio_options','db_block_checking','db_block_checksum')idxTrain=sample(nrow(x),as.integer(nrow(x)*0.7)) idxNotTrain=which(! 1:nrow(x) %in% idxTrain ) TrainDS=x[idxTrain,] ValidateDS=x[idxNotTrain,]library(randomForest) #mtry=as.integer( sqrt(dim(x)[2]-1) ) rf=randomForest(metric ~ ., data=TrainDS, ntree=40, mtry=3, replace=T, nodesize=2, importance=T, do.trace=10, localImp=F) ValidateDS$predicted=predict(rf, newdata=ValidateDS[,colnames(ValidateDS)!="metric"], type="response") sum((ValidateDS$metric-ValidateDS$predicted)^2) rf$importance
Se pueden ajustar manualmente los hiperparámetros del algoritmo y, guiándose por la calidad del modelo, elegir un modelo más preciso para las predicciones en el conjunto de datos de validación.Se puede escribir alguna función para este trabajo (por cierto, nuevamente, basada en algún algoritmo de optimización).
Se puede usar el paquete R
caret tenedor, no es importante.
En resumen, en este caso, se obtiene el siguiente resultado para evaluar la importancia de los atributos:
Bueno. Por lo tanto, se puede empezar con las reflexiones globales:
- Resulta que el parámetro más significativo, en estas condiciones de prueba, fue
commit_wait
Técnicamente, establece el modo de ejecución de la operación io de escritura de los datos redo, desde el buffer de log de la base de datos, en el grupo de logs actual: síncrono o asíncrono.
Valornowaiten el que se obtiene un aumento casi vertical y multiplicativo del valor de la métrica tps: esto involucra la activación del modo asíncrono de io en los grupos redo.
Una pregunta aparte es si es necesario o no hacerlo en la base de datos de producción. Aquí me limito a constatar: es un factor significativo. - Es lógico que el tamaño del buffer de log de la base de datos resulte ser un factor significativo.
Cuanto menor es el tamaño del buffer de log, menor es su capacidad de almacenamiento, lo que provoca desbordamientos más frecuentes y/o la incapacidad de asignar espacio libre para una nueva porción de datos redo.
Y, por lo tanto, las demoras relacionadas con la asignación de espacio en el buffer de log y/o el volcado de datos redo desde él en los grupos redo.
Estas demoras, por supuesto, deben influir e influyen en el rendimiento de la base de datos en cuanto a transacciones. - Parámetro
db_block_checksum: bueno, también es bastante claro: el procesamiento de transacciones genera bloques dirty en el buffer cache de la base de datos.
Los cuales, con la verificación de checksums de los bloques de datos activada, la base de datos tiene que procesar: calcular estos checksums del cuerpo del bloque de datos, compararlos con lo que está escrito en el header del bloque de datos: coincide/no coincide.
Este tipo de trabajo, nuevamente, no puede sino retrasar el procesamiento de datos, y, por consiguiente, el parámetro y el mecanismo que establece este parámetro resultan ser significativos.
Por esa razón, el proveedor sugiere en la documentación de este parámetro distintos valores para él y señala que, sí, habrá impacto, pero hay diferentes valores, incluso 'desactivado', y diferentes impactos, que puedes elegir.
Y la conclusión global.
El enfoque, en general, resulta ser bastante efectivo.
Permite, en las etapas tempranas de pruebas de carga de un sistema de servicio, elegir su configuración óptima para la carga sin profundizar demasiado en las peculiaridades de la configuración del sistema para la carga.
Pero no lo excluye por completo, al menos a nivel de comprensión: es necesario conocer los "controles de ajuste" y los rangos de rotación permitidos de estos controles en el sistema.
Además, este enfoque puede encontrar rápidamente la configuración óptima del sistema.
Y se puede obtener información, tras las pruebas, sobre la naturaleza de la relación entre la métrica de calidad del funcionamiento del sistema y los valores de los parámetros de ajuste del sistema.
Esto, por supuesto, debería contribuir a la comprensión profunda de este sistema, su funcionamiento, al menos bajo esta carga.
Prácticamente, esto implica dividir los costos de familiarización con el sistema configurable y los costos de preparación para este tipo de pruebas de funcionamiento del sistema.
Quiero destacar que, en este enfoque, es críticamente importante el grado de adecuación de las pruebas del sistema a las condiciones de funcionamiento que tendrá en la explotación productiva.
Gracias por su atención, tiempo.
Fuente: habr.com
