

La implementación de una nueva versión del proyecto en producción requiere un cuidadoso equilibrio entre la velocidad de despliegue y la fiabilidad de la solución. En Slack, valoran las iteraciones rápidas, los ciclos cortos de retroalimentación y la respuesta ágil a las consultas de los usuarios. Además, la empresa cuenta con cientos de programadores que buscan lograr la máxima productividad posible.
Los autores del material, cuya traducción publicamos hoy, afirman que una empresa que busca adherirse a esos valores y al mismo tiempo crecer, debe estar en constante mejora de su sistema de despliegue de proyectos. La empresa necesita invertir esfuerzos en la transparencia y fiabilidad de los procesos de trabajo, para que estos se correspondan con la escala del proyecto. Aquí se discutirá sobre los procesos de trabajo establecidos en Slack y algunas soluciones que llevaron a la empresa a utilizar el sistema actual de despliegue de proyectos.
Cómo funcionan actualmente los procesos de despliegue de proyectos
Cada PR (pull request) en Slack debe someterse obligatoriamente a una revisión de código y debe pasar todas las pruebas exitosamente. Solo después de cumplir con estas condiciones, el programador puede fusionar su código con la rama master del proyecto. Sin embargo, el despliegue de dicho código se realiza únicamente durante el horario laboral en la zona horaria norteamericana. Como resultado, al contar con nuestros empleados en el lugar de trabajo, estamos completamente preparados para resolver cualquier problema inesperado.
Cada día realizamos alrededor de 12 despliegues planificados. Durante cada despliegue, el programador designado como responsable del despliegue es el encargado de llevar la nueva compilación a producción. Este es un proceso de múltiples etapas que asegura una transición fluida de la compilación al modo operativo. Gracias a este enfoque, podemos detectar errores antes de que afecten a todos nuestros usuarios. Si hay demasiados errores, el despliegue de la compilación puede revertirse. Si se identifica algún problema individual después del lanzamiento, se puede liberar fácilmente una corrección para ello.
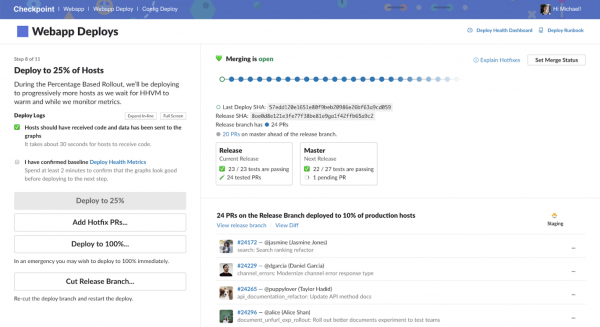
La interfaz del sistema Checkpoint, que se utiliza en Slack para el despliegue de proyectos
El proceso de despliegue de una nueva versión en producción se puede imaginar como compuesto por cuatro pasos.
▍1. Creación de la rama de lanzamiento
Cada lanzamiento comienza con una nueva rama de lanzamiento, desde un punto en nuestra historia de Git. Esto permite asignar etiquetas al lanzamiento y proporciona un lugar donde se pueden realizar correcciones operativas para errores encontrados durante la preparación del lanzamiento para su producción.
▍2. Despliegue en el entorno intermedio
El siguiente paso en el trabajo consiste en desplegar la compilación en los servidores intermedios (staging) y ejecutar pruebas automáticas para comprobar la funcionalidad general del proyecto (prueba de humo). El entorno intermedio es un entorno de producción al que no llega tráfico externo. En este entorno realizamos pruebas manuales adicionales. Esto nos brinda confianza adicional en que el proyecto modificado funciona correctamente. Solo las pruebas automatizadas no son suficientes para obtener dicha confianza.
▍3. Despliegue en entornos dogfood y canary
El despliegue en producción comienza con el entorno dogfood, que consiste en un conjunto de hosts que sirven nuestros espacios de trabajo internos en Slack. Dado que somos usuarios muy activos de Slack, este enfoque ha ayudado a descubrir numerosos errores en las primeras etapas del despliegue. Una vez que nos aseguramos de que la funcionalidad básica del sistema no se ve afectada, se lleva a cabo el despliegue de la compilación en el entorno canary. Este último es un sistema que recibe aproximadamente el 2% del tráfico de producción.
▍4. Introducción gradual en producción
Si los indicadores de monitoreo de la nueva versión se mantienen estables, y si después del despliegue del proyecto en el entorno canary no hemos recibido quejas, continuamos con la transición gradual de los servidores de producción a la nueva versión. El proceso de despliegue se divide en las siguientes etapas: 10%, 25%, 50%, 75% y 100%. Como resultado, podemos transferir lentamente el tráfico de producción a la nueva versión del sistema. Al mismo tiempo, tenemos tiempo para investigar la situación en caso de que se detecten anomalías.
▍¿Qué hacer si algo sale mal durante el despliegue?
Modificar el código siempre implica un riesgo. Pero lo manejamos gracias a que contamos con "líderes de despliegue" bien preparados, que dirigen el proceso de lanzamiento de una nueva versión a producción, supervisan las métricas de monitoreo y coordinan el trabajo de los programadores que lanzan el código.
En caso de que algo realmente salga mal, tratamos de detectar el problema lo antes posible. Investigamos el problema, encontramos el PR que causa errores, lo revertimos, analizamos cuidadosamente y creamos una nueva compilación. Sin embargo, a veces el problema pasa desapercibido hasta la implementación del proyecto en producción. En esa situación, lo más importante es restaurar el servicio. Por lo tanto, antes de comenzar a investigar el problema, revertimos de inmediato a la última compilación funcional.
Bloques de construcción del sistema de despliegue
Veamos las tecnologías que sustentan nuestro sistema de despliegue de proyectos.
▍Despliegues rápidos
El proceso de trabajo descrito anteriormente puede parecer, en retrospectiva, algo completamente obvio. Pero nuestro sistema de despliegue no llegó a ser así de inmediato.
Cuando la empresa era mucho más pequeña, toda nuestra aplicación podía funcionar en 10 instancias de Amazon EC2. Desplegar un proyecto en esa situación significaba usar rsync para una rápida sincronización entre todos los servidores. Antes, solo había un paso que separaba el nuevo código de producción, representado por un entorno intermedio. Las compilaciones se creaban y verificaban en ese entorno, y luego iban directamente a producción. Era muy sencillo entender ese sistema, permitía a cualquier programador desplegar en cualquier momento el código que había escrito.
Pero a medida que aumentaba el número de nuestros clientes, también crecía la infraestructura necesaria para soportar el proyecto. Pronto, debido al crecimiento continuo del sistema, nuestro modelo de despliegue, basado en la entrega de nuevo código a los servidores, dejó de funcionar adecuadamente. Específicamente, añadir cada nuevo servidor significaba un aumento en el tiempo requerido para realizar el despliegue. Incluso las estrategias basadas en la aplicación paralela de rsync tienen ciertas limitaciones.
Al final, resolvimos este problema al pasar a un sistema de despliegue completamente paralelo, estructurado de manera diferente a nuestro antiguo sistema. Específicamente, ahora no enviábamos el código a los servidores utilizando un script de sincronización. Cada servidor ahora descargaba la nueva versión de manera independiente, enterándose de la necesidad de hacerlo al observar el cambio en la clave de Consul. Los servidores cargaban el código en paralelo. Esto nos permitió mantener una alta velocidad de despliegue incluso en un entorno de crecimiento constante del sistema.
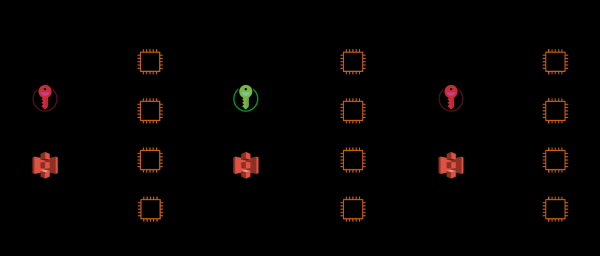
1. Los servidores de producción observan la clave de Consul. 2. La clave cambia, lo que informa a los servidores que deben comenzar a cargar el nuevo código. 3. Los servidores descargan archivos tarball con el código de la aplicación.
▍Despliegues atómicos
Otra solución que nos ayudó a implementar un sistema de despliegue multinivel fue el despliegue atómico.
Antes de utilizar los despliegues atómicos, cada despliegue podía generar numerosos mensajes de error. Esto se debía a que el proceso de copiar nuevos archivos a los servidores de producción no era atómico. Esto resultaba en un breve periodo durante el cual el código que invocaba nuevas funciones estaba disponible antes de que las propias funciones estuvieran disponibles. Cuando se llamaba a tal código, se retornaban errores internos. Esto se manifestaba en solicitudes de API fallidas y en páginas web "rotas".
El equipo que trató este problema lo resolvió introduciendo el concepto de directorios "calientes" (hot) y "fríos" (cold). El código en el directorio "caliente" se encarga del tráfico de producción. En los directorios "fríos", el código se prepara para su uso mientras el sistema está en funcionamiento. Durante el despliegue, el nuevo código se copia a un directorio "frío" que no se está utilizando. Luego, cuando no hay procesos activos en el servidor, se realiza un cambio instantáneo de directorios.
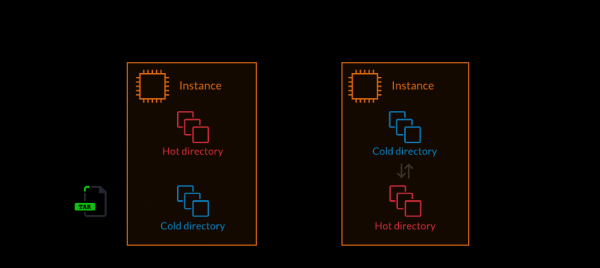
1. Descompresión del código de la aplicación en el directorio "frío". 2. Cambio del sistema al directorio "frío", que se convierte en "caliente" (operación atómica).
Resultados: un cambio de enfoque hacia la confiabilidad.
En 2018, el proyecto alcanzó una escala en la que el despliegue rápido comenzó a perjudicar la estabilidad del producto. Teníamos un sistema de despliegue bastante avanzado, en el que invertimos mucho esfuerzo y tiempo. Solo necesitábamos reorganizar y mejorar los procesos de despliegue. Nos convertimos en una empresa bastante grande, cuyos desarrollos se utilizan en todo el mundo para asegurar la comunicación ininterrumpida y para resolver tareas importantes. Por lo tanto, la fiabilidad se convirtió en nuestra principal prioridad.
Necesitábamos hacer que el proceso de despliegue de nuevas versiones de Slack fuera más seguro. Esta necesidad nos llevó a mejorar nuestro sistema de despliegue. De hecho, lo que hemos discutido anteriormente es este sistema mejorado. En el corazón del sistema, seguimos utilizando tecnologías de despliegue rápido y atómico. Lo que ha cambiado es la forma en que se realiza el despliegue. Nuestro nuevo sistema está diseñado para llevar a cabo el despliegue de nuevo código de manera gradual, en diferentes niveles y entornos. Ahora utilizamos herramientas y recursos de monitoreo más avanzados que antes. Esto nos permite detectar y corregir errores mucho antes de que tengan la oportunidad de llegar al usuario final.
Pero no pensamos detenernos aquí. Continuamente mejoramos este sistema utilizando herramientas y recursos de automatización más sofisticados.
¡Estimados lectores! ¿Cómo está organizado el proceso de despliegue de nuevas versiones de proyectos en su lugar de trabajo?
Fuente: habr.com
