

Con la base de datos Apache Cassandra y la necesidad de implementarla dentro de una infraestructura basada en Kubernetes, nos encontramos regularmente. En este material compartiremos nuestra visión de los pasos necesarios, criterios y soluciones existentes (incluyendo una revisión de operadores) para migrar Cassandra a K8s.
«Quien puede manejar a una mujer, también puede con un estado»
¿Quién es Cassandra? Es un sistema de almacenamiento distribuido diseñado para gestionar grandes volúmenes de datos, asegurando alta disponibilidad sin un único punto de fallo. El proyecto probablemente no necesita una larga presentación, así que solo mencionaré las características principales de Cassandra que serán relevantes en el contexto del artículo:
- Cassandra está escrita en Java.
- La topología de Cassandra incluye varios niveles:
- Node — una instancia desplegada de Cassandra;
- Rack — un grupo de instancias de Cassandra agrupadas por algún criterio, que se encuentra en un mismo centro de datos;
- Datacenter — la totalidad de todos los grupos de instancias de Cassandra que están en un mismo centro de datos;
- Cluster — la totalidad de todos los centros de datos.
- Para identificar un nodo, Cassandra utiliza la dirección IP.
- Para la rapidez de las operaciones de escritura y lectura, Cassandra almacena parte de los datos en la memoria RAM.
Ahora, al posible traslado a Kubernetes.
Check-list para la migración
Al hablar de la migración de Cassandra a Kubernetes, esperamos que con la mudanza sea más fácil gestionarla. ¿Qué se necesita para ello y en qué ayudará?
1. Almacenamiento para datos
Como ya se ha especificado, parte de los datos de Cassandra se almacenan en la memoria RAM — en Memtable. Pero hay otra parte de los datos que se guarda en disco, — en forma de SSTable. A estos datos se añade la entidad Commit Log — registros sobre todas las transacciones, que también se guardan en disco.
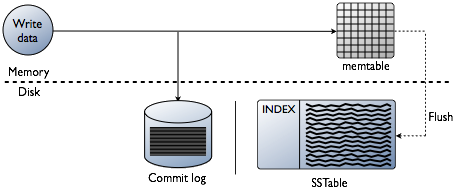
El esquema de transacciones de escritura en Cassandra
En Kubernetes, podemos utilizar PersistentVolume para almacenar datos. Gracias a mecanismos bien establecidos, trabajar con datos en Kubernetes se vuelve más sencillo cada año.
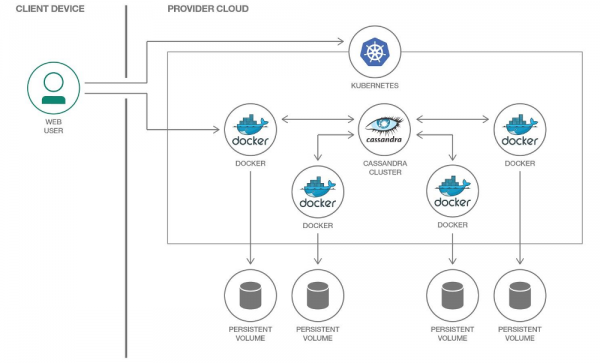
A cada pod de Cassandra le asignaremos su propio PersistentVolume
Es importante destacar que Cassandra, por sí misma, implica la replicación de datos, ofreciendo para ello mecanismos integrados. Por lo tanto, si estás construyendo un clúster de Cassandra con un gran número de nodos, no es necesario utilizar sistemas distribuidos para el almacenamiento de datos como Ceph o GlusterFS. En este caso, sería lógico almacenar los datos en el disco del nodo mediante o mediante montaje hostPath.
Otra cuestión es si deseas crear un entorno separado para los desarrolladores para cada rama de funciones. En este caso, el enfoque correcto sería levantar un nodo de Cassandra y almacenar los datos en un almacenamiento distribuido, es decir, los mencionados Ceph y GlusterFS serían tu opción. Entonces, el desarrollador estará seguro de que no perderá datos de prueba incluso si uno de los nodos del clúster de Kubernetes falla.
2. Monitoreo
Prácticamente, la elección sin alternativas para implementar monitoreo en Kubernetes es Prometheus (lo hemos explicado en detalle en ). ¿Qué tal está Cassandra con los exportadores de métricas para Prometheus? Y, lo que es aún más importante, ¿con los dashboards adecuados para Grafana?
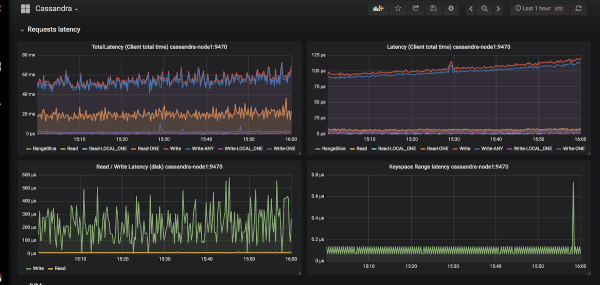
Ejemplo de la apariencia de los gráficos en Grafana para Cassandra
Hay solo dos exportadores: y .
Elegimos el primero porque:
- JMX Exporter está en crecimiento y desarrollo, mientras que Cassandra Exporter no ha logrado el apoyo adecuado de la comunidad. Cassandra Exporter aún no es compatible con la mayoría de las versiones de Cassandra.
- Se puede ejecutar como javaagent añadiendo el flag
-javaagent:<plugin-dir-name>\/cassandra-exporter.jar=--listen=:9180. - Para él hay , que no es compatible con Cassandra Exporter.
3. Selección de primitivas de Kubernetes
De acuerdo con la estructura del clúster de Cassandra expuesta anteriormente, intentemos traducir todo lo que se describe allí a la terminología de Kubernetes:
- Cassandra Node → Pod
- Cassandra Rack → StatefulSet
- Cassandra Datacenter → conjunto de StatefulSets
- Cassandra Cluster → ???
Parece que falta alguna entidad adicional para gestionar todo el clúster de Cassandra de una vez. Pero si algo falta, ¡podemos crearlo! En Kubernetes, existe un mecanismo para definir recursos propios — .
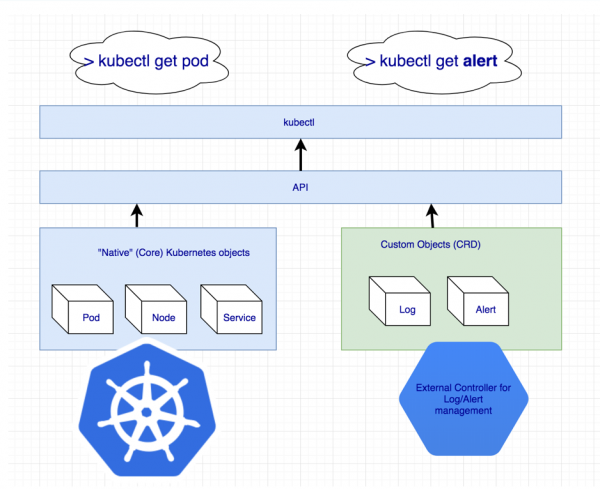
Declaración de recursos adicionales para logs y alertas
Pero un Resource Custom por sí solo no significa nada: ya que necesita un un controlador. Tal vez, debamos recurrir a la ayuda de …
4. Identificación de pods
En el punto anterior, acordamos que un nodo de Cassandra equivaldrá a un pod en Kubernetes. Pero las direcciones IP de los pods serán diferentes cada vez. Y la identificación de un nodo en Cassandra ocurre precisamente sobre la base de la dirección IP... Esto significa que después de cada eliminación de un pod, el clúster de Cassandra agregará un nuevo nodo.
Hay soluciones, y no solo una:
- Podemos llevar un registro por identificadores de hosts (UUIDs, que identifican de manera única las instancias de Cassandra) o por direcciones IP y guardar todo esto en alguna estructura/tablas. Este método tiene dos desventajas principales:
- El riesgo de que ocurra una condición de carrera si se caen dos nodos a la vez. Una vez que se levantan, los nodos de Cassandra solicitarán simultáneamente una dirección IP de la tabla y competirán por el mismo recurso.
- Si un nodo de Cassandra ha perdido sus datos, ya no podremos identificarlo.
- La segunda solución puede parecer un pequeño truco, pero aun así: podemos crear un Service con ClusterIP para cada nodo de Cassandra. Los problemas de esta implementación son:
- Si hay muchos nodos en el clúster de Cassandra, tendremos que crear muchos Services.
- La posibilidad del ClusterIP se implementa a través de iptables. Esto puede ser un problema si hay muchos nodos (1000… o incluso 100?) en el clúster de Cassandra. Aunque puede resolver este problema.
- La tercera solución es usar la red de nodos para los nodos de Cassandra en lugar de una red dedicada de pods mediante la activación de la configuración
hostNetwork: true. Este método impone ciertas restricciones:- A la sustitución de nodos. Es necesario que el nuevo nodo tenga necesariamente la misma dirección IP que el anterior (en nubes como AWS, GCP, esto es prácticamente imposible);
- Al usar la red de nodos del clúster, comenzamos a competir por los recursos de red. Por lo tanto, desplegar más de un pod de Cassandra en un solo nodo del clúster será problemático.
5. Copias de seguridad
Queremos guardar una versión completa de los datos de un nodo de Cassandra según un horario. Kubernetes ofrece una opción conveniente utilizando , pero aquí Cassandra misma nos presenta obstáculos.
Recordemos que parte de los datos de Cassandra se almacenan en memoria. Para hacer una copia de seguridad completa, se deben transferir los datos de la memoria (Memtables) al disco (SSTables). En este momento, el nodo de Cassandra deja de aceptar conexiones, quedando completamente fuera de operación en el clúster.
Después de esto, se realiza la copia de seguridad (snapshot) y se guarda el esquema (keyspace). Aquí se descubre que un simple backup no nos ayuda: es necesario conservar los identificadores de los datos por los que era responsable el nodo de Cassandra, que son tokens especiales.
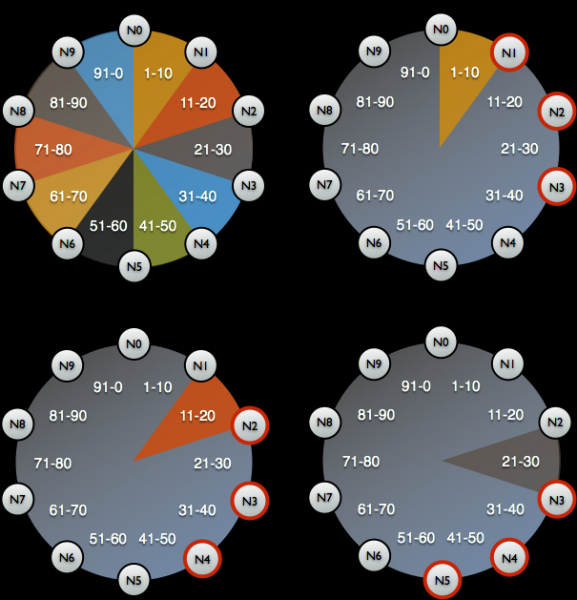
Distribución de tokens para identificar qué datos son responsabilidad de los nodos de Cassandra
Un ejemplo de script para realizar un backup de Cassandra desde Google en Kubernetes se puede encontrar en . El único detalle que no considera el script es el restablecimiento de datos en el nodo antes de tomar el snapshot. Es decir, el backup no se realiza para el estado actual, sino para un estado anterior. Pero esto evita sacar el nodo de funcionamiento, lo cual se considera muy lógico.
set -eu

if [[ -z "$1" ]]; then
  info "Por favor, proporciona un keyspace"
  exit 1
fi

KEYSPACE="$1"

result=$(nodetool snapshot "${KEYSPACE}")

if [[ $? -ne 0 ]]; then
  echo "Error al crear el snapshot"
  exit 1
fi

timestamp=$(echo "$result" | awk '/Directorio de snapshots: / { print $3 }')

mkdir -p /tmp/backup

for path in $(find "/var/lib/cassandra/data/${KEYSPACE}" -name $timestamp); do
  table=$(echo "${path}" | awk -F "[/-]" '{print $7}')
  mkdir /tmp/backup/$table
  mv $path /tmp/backup/$table
done


tar -zcf /tmp/backup.tar.gz -C /tmp/backup .

nodetool clearsnapshot "${KEYSPACE}"
Ejemplo de un script bash para realizar un backup desde un nodo de Cassandra
Soluciones listas para Cassandra en Kubernetes
¿Qué se utiliza actualmente para desplegar Cassandra en Kubernetes y qué de esto se adapta mejor a los requisitos establecidos?
1. Soluciones basadas en StatefulSet o Helm Charts
Usar las funciones básicas de StatefulSets para iniciar un clúster de Cassandra es una buena opción. Con un Helm Chart y plantillas de Go, se puede proporcionar al usuario una interfaz flexible para desplegar Cassandra.
Normalmente, esto funciona bien... hasta que ocurre algo inesperado, como que un nodo falle. Las herramientas estándar de Kubernetes simplemente no pueden tener en cuenta todas las características mencionadas anteriormente. Además, este enfoque es muy limitado en cuanto a su capacidad de expansión para un uso más complicado: reemplazo de nodos, backups, restauraciones, monitoreo, etc.
Representantes:
- ;
- .
Ambos charts son igualmente buenos, pero están sujetos a los problemas mencionados anteriormente.
2. Soluciones basadas en Kubernetes Operator
Estas opciones son más interesantes porque ofrecen amplias capacidades de gestión del clúster. Para diseñar un operador de Cassandra, al igual que con cualquier otra base de datos, un buen patrón se ve como Sidecar Controller CRD:
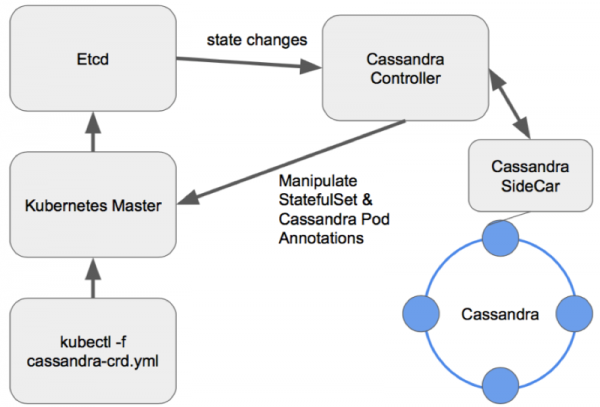
Esquema de gestión de nodos en un operador de Cassandra bien diseñado
Veamos los operadores existentes.
1. Cassandra-operator de instaclustr
- Estado: Alpha
- Licencia: Apache 2.0
- Implementado en: Java
Este es un proyecto muy prometedor en desarrollo activo por una empresa que ofrece implementaciones gestionadas de Cassandra. Como se describe arriba, utiliza un contenedor sidecar que recibe comandos a través de HTTP. Está escrito en Java, por lo que a veces le falta funcionalidad más avanzada de la biblioteca client-go. Además, el operador no soporta diferentes Racks para un solo Datacenter.
Sin embargo, el operador tiene ventajas como soporte para monitoreo, gestión de clústeres a alto nivel mediante CRD e incluso documentación sobre cómo realizar copias de seguridad.
2. Navigator de Jetstack
- Estado: Alpha
- Licencia: Apache 2.0
- Implementado en: Golang
Un operador diseñado para implementar DB-as-a-Service. Actualmente soporta dos bases de datos: Elasticsearch y Cassandra. Incluye soluciones interesantes como control de acceso a la base de datos a través de RBAC (para lo cual se levanta un servidor apiserver separado). Es un proyecto interesante que vale la pena considerar, aunque el último commit se realizó hace un año y medio, lo que claramente reduce su potencial.
3. Cassandra-operator de vgkowski
- Estado: Alpha
- Licencia: Apache 2.0
- Implementado en: Golang
No se consideró "en serio" ya que el último commit en el repositorio fue hace más de un año. El desarrollo del operador ha sido abandonado: la última versión de Kubernetes anunciada como soportada es la 1.9.
4. Cassandra-operator de Rook
- Estado: Alpha
- Licencia: Apache 2.0
- Implementado en: Golang
Un operador cuyo desarrollo no avanza tan rápido como se desearía. Tiene una estructura CRD bien pensada para gestionar el clúster, resuelve el problema de identificación de nodos mediante un Servicio con ClusterIP (ese es el "hack")… pero por ahora eso es todo. Actualmente no hay monitoreo ni copias de seguridad disponibles de forma nativa (por cierto, nosotros ). Un detalle interesante es que con este operador también se puede desplegar ScyllaDB.
NB: Este operador, con algunas modificaciones, lo hemos utilizado en uno de nuestros proyectos. No se han detectado problemas en el funcionamiento del operador durante todo el tiempo de explotación (~4 meses de funcionamiento).
5. CassKop de Orange
- Estado: Alpha
- Licencia: Apache 2.0
- Implementado en: Golang
El operador más joven de la lista: el primer commit se realizó el 23 de mayo de 2019. Ya tiene en su arsenal una gran cantidad de características de nuestra lista, que se pueden revisar en el repositorio del proyecto. El operador está construido sobre la popular operator-sdk. Soporta monitoreo "de forma nativa". La principal diferencia con otros operadores es el uso , implementado en Python y utilizado para la comunicación entre nodos de Cassandra.
Conclusiones
La cantidad de enfoques y opciones posibles para trasladar Cassandra a Kubernetes habla por sí misma: el tema es demandado.
En esta etapa, probar algo de lo anteriormente mencionado se hace bajo su propio riesgo: ningún desarrollador garantiza el funcionamiento al 100% de su solución en un entorno de producción. Sin embargo, ya muchos productos parecen prometedores para ser utilizados en entornos de desarrollo.
¡Creo que en el futuro esta mujer en el barco será muy útil!
P.D.
También puedes leer en nuestro blog:
- «»;
- «»;
- «»;
- «».
Fuente: habr.com
