

Hola a todos.
Soy administrador de sistemas Linux, me mudé de Rusia a Australia con una visa profesional independiente en 2015, pero este artículo no tratará sobre cómo un cerdito consigue un tractor. Ya hay suficientes artículos sobre eso (sin embargo, si hay interés, escribiré sobre ello), así que me gustaría contar cómo en mi trabajo en Australia como ingeniero de operaciones de Linux fui el iniciador de la migración de un sistema de monitoreo a otro. Específicamente, de Nagios a Icinga2.
El artículo es parcialmente técnico y parcialmente sobre la interacción con personas y los problemas relacionados con las diferencias culturales y métodos de trabajo.
Lamentablemente, la etiqueta «code» no resalta el código de Puppet y yaml, así que tuve que usar «plaintext».
Nada presagiaba problemas la mañana del 21 de diciembre de 2016. Como de costumbre, leía Habr como un anónimo no registrado en los primeros minutos de la jornada laboral, bebiendo café y me encontré con .
Dado que en mi empresa se utilizaba Nagios, sin pensarlo mucho, creé un ticket en Redmine y compartí el enlace en el chat general, ya que consideré que era importante. La iniciativa se castiga incluso en Australia, así que el ingeniero principal me asignó este problema, dado que yo lo había descubierto.
Captura de pantalla de Redmine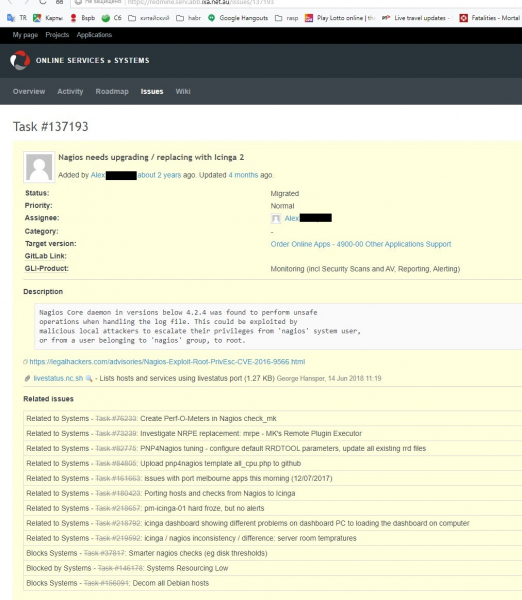
En nuestro departamento, antes de expresar nuestra opinión se espera que se proponga al menos una alternativa, incluso si la elección es obvia, así que comencé buscando en Google qué sistemas de monitoreo están actualmente en uso, ya que en mi último trabajo en Rusia tenía mi propio sistema hecho a mano, muy primitivo, pero aún así bastante funcional y cumplía con todas las tareas asignadas. Python, el Politécnico de Petersburgo y el metro dominan. No, el metro es un desastre. Esto es personal (11 años de trabajo) y merece un artículo aparte, pero no ahora.
Un poco sobre las reglas para realizar cambios en la configuración de infraestructura en mi actual puesto. Usamos Puppet, Gitlab y el principio de Infrastructure as Code, así que:
- No hay cambios manuales a través de SSH modificando archivos en máquinas virtuales. Durante tres años de trabajo, he recibido reprimendas por esto muchas veces, la última hace una semana, y no creo que sea la última. Bueno, en serio, corregir una línea en la configuración, reiniciar el servicio y ver si se resolvió el problema — 10 segundos. Crear una nueva rama en GitLab, subir los cambios, esperar a que r10k funcione en Puppetmaster, ejecutar Puppet —environment=mybranch y esperar un par de minutos para que todo esto se ejecute — al menos 5 minutos.
- Cualquier cambio se realiza mediante la creación de un Merge Request en GitLab, y se requiere la aprobación de al menos un miembro del equipo. Los cambios serios que requieren la decisión del líder del equipo necesitan dos o tres aprobaciones.
- Todos los cambios son de algún modo textuales (dado que los manifiestos de Puppet, los scripts y los datos de Hiera son texto), los archivos binarios son altamente desaconsejables y se necesitan razones de peso para la aprobación de tales archivos.
Así que, las opciones que consideré:
- Munin — si hay más de 10 servidores en la infraestructura, la administración se convierte en un infierno (de . No tenía un deseo especial de comprobarlo, así que lo creí sobre la palabra).
- Zabbix — lo he estado observando desde hace tiempo, incluso en Rusia, pero en ese entonces era excesivo para mis necesidades. Aquí, tuve que descartarlo debido al uso de Puppet como gestor de configuración y GitLab como sistema de control de versiones. En ese momento, por lo que entendí, Zabbix almacena toda la configuración en una base de datos, lo que lo hacía difícil de manejar en las condiciones actuales y complicado para rastrear cambios.
- Prometheus — hacia lo que eventualmente nos dirigiremos, según el estado de ánimo en el departamento, pero en ese momento no pude darle cabida y no pude demostrar un prototipo funcional (Proof of Concept), así que tuve que descartarlo.
- También hubo otras opciones que o bien requerían una reestructuración completa del sistema, o estaban en estado embrionario / abandonadas y por esta misma razón fueron rechazadas.
Al final, me decidí por Icinga2 por tres razones:
1 — compatibilidad con Nrpe (el servicio cliente que ejecuta verificaciones mediante comandos de Nagios). Esto era muy importante, ya que en ese momento teníamos 135 (ahora en 2019 son 165) máquinas virtuales con un montón de servicios/comprobaciones personalizados, y rehacer todo esto sería un verdadero dolor de cabeza.
2 — todos los archivos de configuración son de texto, lo que permite editarlos fácilmente y crear solicitudes de fusión con la posibilidad de ver qué se ha añadido o eliminado.
3 — es un proyecto OpenSource vivo y en desarrollo. Nos gusta mucho OpenSource y hacemos nuestra parte contribuyendo a él mediante la creación de Pull Requests e Issues para resolver problemas.
Así que, ¡vamos a ello, Icinga2!
Lo primero con lo que tuve que lidiar fue la inercia de mis colegas. Todos estaban acostumbrados a Nagios/Nadjius (aunque ni siquiera aquí pudimos llegar a un compromiso sobre cómo pronunciarlo) y a la interfaz de CheckMK. La interfaz de Icinga se ve muy diferente (ese fue un inconveniente), pero hay una opción de configuración flexible sobre lo que necesitas ver mediante filtros en casi cualquier parámetro (ese fue un punto a favor, pero luché mucho por ello).
Filtros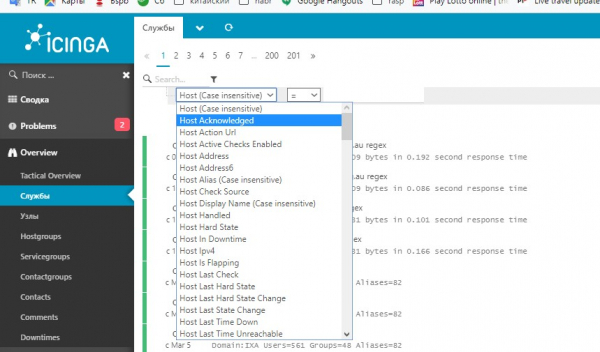
Evalúa la relación entre el tamaño de la barra de desplazamiento y el tamaño del área de desplazamiento.
En segundo lugar, todos estaban acostumbrados a ver toda la infraestructura en un solo monitor, porque CheckMk permite trabajar con varios hosts de Nagios, pero la interfaz de Icinga no podía hacerlo (en realidad podía, pero eso lo verás más abajo). La alternativa era una herramienta llamada Thruk, pero su diseño provocaba arcadas a todos los miembros del equipo, excepto a uno: el que la propuso (no fui yo).
Que se vaya Thruk — decisión unánime del equipo.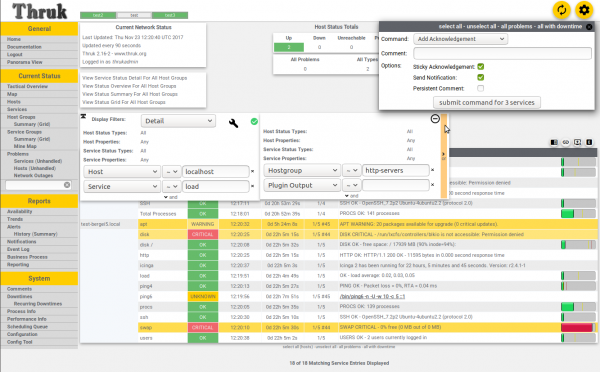
Después de un par de días de tormenta de ideas, propuse la idea de monitoreo en clúster, donde hay un maestro en la zona de producción y dos subordinados: uno en dev/test y otro externo, ubicado en otro proveedor, con el objetivo de monitorear nuestros servicios desde la perspectiva del cliente o un observador externo. Esta configuración permitía ver todos los problemas en una sola interfaz web y funcionaba bastante bien, pero Puppet... El problema con Puppet era que el maestro ahora debía conocer todos los hosts y servicios/revisiones en el sistema y tenía que distribuirlos entre las zonas (dev-test, staging-prod, ext), pero enviar cambios a través de la API de Icinga toma un par de segundos, mientras que la compilación del catálogo de Puppet de todos los servicios para todos los hosts toma un par de minutos. Aún se me culpa por esto, aunque ya lo he explicado varias veces cómo funciona todo y por qué lleva tanto tiempo.
En tercer lugar, un montón de SnowFlakes (copos de nieve) - cosas que se desvían del sistema general porque tienen algo especial, por lo que las reglas generales no se aplican a ellas. Esto se resolvía con un ataque frontal: si hay alertas pero, de hecho, todo está bien, significa que hay que investigar más a fondo para entender por qué está alertando, aunque no debería. O al revés, por qué Nagios está en pánico, y Icinga no.
En cuarto lugar, Nagios había estado aquí tres años antes que yo y se le tenía más confianza desde el principio que a mi moderna y hipster sistema, por lo que cada vez que Icinga generaba pánico, nadie hacía nada hasta que Nagios se alarmaba con la misma cuestión. Pero muy raramente Icinga emitía alertas reales antes que Nagios y considero esto un grave error, del que hablaré en la sección de “Conclusiones”.
Como resultado, la implementación se prolongó más de 5 meses (se planeaba para el 28 de junio de 2018, pero en realidad fue el 3 de diciembre de 2018), principalmente debido a la “verificación de paridad” - esa tontería, cuando hay varios servicios en Nagios, de los cuales nadie había oído hablar en los últimos años, pero JUSTO AHORA, demonios, emitieron crit sin ninguna razón y tuve que explicar por qué no estaban en mi panel y tuve que agregarlos a Icinga para que “la verificación de paridad se complete” (Todos los servicios/revisiones en Nagios coinciden con los servicios/revisiones en Icinga).
Implementación:
Primero, está la guerra entre Code y Data, al estilo Puppet. Todos los datos, absolutamente todos, deben estar en Hiera y nada más. Todo el código va en archivos .pp. Variables, abstracciones, funciones — todo va en pp.
Al final, tenemos un montón de máquinas virtuales (165 en el momento de escribir este artículo) y 68 aplicaciones web que necesitamos monitorear en términos de funcionalidad y validez de los certificados SSL. Pero debido a un lío histórico, la información para monitorear las aplicaciones proviene de un repositorio de gitlab separado y el formato de datos no ha cambiado desde Puppet 3, lo que crea dificultades adicionales en la configuración.
Código de Puppet para las aplicaciones, cuida tus ojos.
definir perfiles::servicios::monitoring::docker_apps(
  Hash $app_list,
  Hash $apps_accessible_from,
  Hash $apps_access_list,
  Hash $webhost_defaults,
  Hash $webcheck_defaults,
  Hash $service_overrides,
  Hash $targets,
  Hash $app_checks,
  )
{
#### APPS ####
  $zone = $name
  $app_list.each | String $app_name, Hash $app_data |
  {

    $notify_group = { 'notify_group' => ($webcheck_defaults[$zone]['notify_group'] + pick($app_data['notify_group'], {} )) } # agrega notificaciones para el grupo predeterminado (sistemas) + cualquier grupo definido en int/pm_docker_apps.eyaml

    $data = merge($webhost_defaults, $apps_accessible_from, $app_data)

    $site_domain = $app_data['site_domain']

    $regexp = pick($app_data['check_regex'], 'html')        # Seleccionar un regex para comprobar

    $check_url = $app_data['check_url'] ? {
      undef   => { 'http_uri' => ' / ' },
      default => { 'http_uri' => $app_data['check_url'] }
    }

    $check_regex = $regexp ?{
      'absent' => {},
      default  => {'http_expect_body_regex' => $regexp}
    }

    $site_domain.each | String $vhost, Hash $vdata | {        # Dividir una app por dominios si hay dos o más
      $vhost_name = {'http_vhost' => $vhost}

      $vars = $data['vars'] + $vhost_name + $check_regex + $check_url

      $web_ipaddress = is_array($vdata['web_ipaddress']) ? {  # Hacer que la dirección IP sea una matriz si no lo es, porque askizzy tiene 2 ips y es una matriz
        true  => $vdata['web_ipaddress'],
        false => [$vdata['web_ipaddress']],
      }

      $access_from_zones = [$zone] + $apps_access_list[$data['accessible_from']] # Combinar zona predeterminada (donde se define la app) y zonas adicionales si existen
      $web_ipaddress.each | String $ip_address | {            # Para cada IP (si tenemos múltiples)
        $suffix = length($web_ipaddress) ? {                  # Si tenemos más de una - agrega la IP como un sufijo a este hostname para evitar duplicar recursos
          1       => '',
          default => "_${ip_address}"
        }
        $octets = split($ip_address, '.')
        $ip_tag = "${octets[2]}.${octets[3]}" # Usar solo el último octeto causa una colisión entre nginx-vip 203.15.70.94 y ext. ip 49.255.194.94

        $access_from_zones.each | $zone_prefix |{
          $zone_target = $targets[$zone_prefix]

          $nginx_vip_name = "${zone_prefix}_nginx-vip-${ip_tag}" # Si es un host para ext - el prefijo se convierte en 'ext_' (ext_nginx-vip...)
          $nginx_host_vip = {
            $nginx_vip_name => {
              ensure        => present,
              target        => $zone_target,
              address       => $ip_address,
              check_command => 'hostalive',
              groups        => ['nginx_vip',],
            }
          }

          $ssl_vars = $app_checks['ssl']
          $regex_vars = $app_checks['http'] + $vars + $webcheck_defaults[$zone] + $notify_group

          if !defined( Profiles::Services::Monitoring::Host[$nginx_vip_name] ) {
          ensure_resources('profiles::services::monitoring::host', $nginx_host_vip)
          }

          if !defined( Icinga2::Object::Service["${nginx_vip_name}_ssl"] ) {
            icinga2::object::service {"${nginx_vip_name}_ssl":
              ensure         => $data['ensure'],
              assign         => ["host.name == $nginx_vip_name",],
              groups         => ['webchecks',],
              check_command  => 'ssl',
              check_interval => $service_overrides['ssl']['check_interval'],
              target         => $targets['services'],
              apply          => true,
              vars           => $ssl_vars
            }
          }
          if $regexp != 'absent'{
            if !defined(Icinga2::Object::Service["${vhost}${$suffix} regex"]){
              icinga2::object::service {"${vhost}${$suffix} regex":
                ensure          => $data['ensure'],
                assign          => ["match(*_nginx-vip-${ip_tag}, host.name)",],
                groups          => ['webchecks',],
                check_command   => 'http',
                check_interval  => $service_overrides['regex']['check_interval'],
                target          => $targets['services'],
                enable_flapping => true,
                apply           => true,
                vars            => $regex_vars
              }
            }
          }
        }
      }
    }
  }
}
El código de configuración de hosts y servicios también se ve horrible:
monitoring/config.pp
class profiles::services::monitoring::config(
  Array $default_config,
  Array $hostgroups,
  Hash $hosts = {},
  Hash $host_defaults,
  Hash $services,
  Hash $service_defaults,
  Hash $service_overrides,
  Hash $webcheck_defaults,
  Hash $servicegroups,
  String $servicegroup_target,
  Hash $user_defaults,
  Hash $users,
  Hash $oncall,
  Hash $usergroup_defaults,
  Hash $usergroups,
  Hash $notifications,
  Hash $notification_defaults,
  Hash $notification_commands,
  Hash $timeperiods,
  Hash $webhost_defaults,
  Hash $apps_access_list,
  Hash $check_commands,
  Hash $hosts_api = {},
  Hash $targets = {},
  Hash $host_api_defaults = {},
)
{

  # Profiles::Services::Monitoring::Hostgroup <> # se habilitará cuando nos cambiemos completamente a icinga
#### APPS ####
  case $location {
    'int', 'ext': {
      $apps_by_zone = {}
    }
    'pm': {
      $int_apps         = hiera('int_docker_apps')
      $int_app_defaults = hiera('int_docker_app_common')

      $st_apps          = hiera('staging_docker_apps')
      $srs_apps         = hiera('pm_docker_apps_srs')
      $pm_apps          = hiera('pm_docker_apps') + $st_apps + $srs_apps
      $pm_app_defaults  = hiera('pm_docker_app_common')

      $apps_by_zone = {
        'int' => $int_apps,
        'pm'  => $pm_apps,
      }

      $app_access_by_zone = {
        'int' => {'accessible_from' => $int_app_defaults['accessible_from']},
        'pm'  => {'accessible_from' => $pm_app_defaults['accessible_from']},
      }
    }

    default: {
      fail('Por favor asegúrese de que el nodo tenga el hecho $location establecido (int, pm, ext)')
    }
  }

  file { '/etc/icinga2/conf.d/':
    ensure  => directory,
    recurse => true,
    purge   => true,
    owner   => 'icinga',
    group   => 'icinga',
    mode    => '0750',
    notify  => Service['icinga2'],
  }

  $default_config.each | String $file_name |{
    file {"/etc/icinga2/conf.d/${file_name}":
      ensure => present,
      source => "puppet:///modules/profiles/services/monitoring/default_config/${file_name}",
      owner  => 'icinga',
      group  => 'icinga',
      mode    => '0640',
    }
  }

  $app_checks = {
    'ssl' => $services['webchecks']['checks']['ssl']['vars'],
    'http' => $services['webchecks']['checks']['http_regexp']['vars']
  }

  $apps_by_zone.each | String $zone, Hash $app_list | {
    profiles::services::monitoring::docker_apps{$zone:
      app_list             => $app_list,
      apps_accessible_from => $app_access_by_zone[$zone],
      apps_access_list     => $apps_access_list,
      webhost_defaults     => $webhost_defaults,
      webcheck_defaults    => $webcheck_defaults,
      service_overrides    => $service_overrides,
      targets              => $targets,
      app_checks           => $app_checks,
    }
  }

####    HOSTS    ####

  # Profiles::Services::Monitoring::Host <> # Esto es para la invasión de la nave espacial cuando esté lista.
  $hosts_has_large_disks = query_nodes('mountpoints.*.size_bytes >= 1099511627776')

  $hosts.each | String $hostgroup, Hash $list_of_hosts_with_settings | {           # Dividiendo listas de sitios por grupos de hosts - docker_host/gluster_host/etc
    $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
    $hostgroup_settings     = $list_of_hosts_with_settings['settings']
    $merged_hostgroup_settings = deep_merge($host_defaults, $list_of_hosts_with_settings['settings'])
    $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{  # Dividiendo listas de grupos por hosts
      # ¿Está este host en el array $hosts_has_large_disks? Si es así, establecer host.vars.has_large_disks
      if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
        $vars_has_large_disks = { 'has_large_disks' => true }
      } else {
        $vars_has_large_disks = {}
      }
      $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
      $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})
      $host_settings_vars = pick($host_settings['vars'], {})
      $host_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
      $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_notify_group}, $vars_has_large_disks)) # Fusionando vars por separado

      $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

      profiles::services::monitoring::host{$host_name:
        ensure             => $host_data['ensure'],
        display_name       => $host_data['display_name'],
        address            => $host_data['address'],
        groups             => $hostgroups,
        target             => $host_data['target'],
        check_command      => $host_data['check_command'],
        check_interval     => $host_data['check_interval'],
        max_check_attempts => $host_data['max_check_attempts'],
        vars               => $host_data_vars,
        template           => $host_data['template'],
      }
    }
  }
  if !empty($hosts_api){                                                                # Todos los hosts administrados por API
    $hosts_api.each | String $zone, Hash $hosts_api_zone | {                            # Dividiendo hosts de api por zonas
      $hosts_api_zone.each | String $hostgroup, Hash $list_of_hosts_with_settings | {   # Dividiendo listas de sitios por grupos de hosts - docker_host/gluster_host/etc
        $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
        $hostgroup_settings     = $list_of_hosts_with_settings['settings']
        $merged_hostgroup_settings = deep_merge($host_api_defaults, $list_of_hosts_with_settings['settings'])
        $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{        # Dividiendo listas de grupos por hosts
          # ¿Está este host en el array $hosts_has_large_disks? Si es así, establecer host.vars.has_large_disks
          if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
            $vars_has_large_disks = { 'has_large_disks' => true }
          } else {
            $vars_has_large_disks = {}
          }
          $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
          $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})

          $host_settings_vars = pick($host_settings['vars'], {})
          $host_api_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
          $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_api_notify_group}, $vars_has_large_disks))
          $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

          if defined(Profiles::Services::Monitoring::Host[$host_name]){
            $hostname = "${host_name}_from_${zone}"
          }
          else
          {
            $hostname = $host_name
          }
          profiles::services::monitoring::host{$hostname:
            ensure             => $host_data['ensure'],
            display_name       => $host_data['display_name'],
            address            => $host_data['address'],
            groups             => $hostgroups,
            target             => "${host_data['target_base']}/${zone}/hosts.conf",
            check_command      => $host_data['check_command'],
            check_interval     => $host_data['check_interval'],
            max_check_attempts => $host_data['max_check_attempts'],
            vars               => $host_data_vars,
            template           => $host_data['template'],
          }
        }
      }
    }
  }

#### FIN DE HOSTS ####

####   SERVICIOS   ####

  $services.each | String $service_group, Hash $s_list |{             # Grupo de servicios y lista de servicios en ese grupo
    $service_list = $s_list['checks']                                 # Lista de chequeos reales, separadamente de la configuración del SG
    $service_list.each | String $service_name, Hash $data |{

      $merged_defaults = merge($service_defaults, $s_list['settings']) # configuraciones estándares globales + configuraciones por grupo de servicio
      $merged_data = merge($merged_defaults, $data)

      $settings_vars = pick($s_list['settings']['vars'], {})
      $this_service_vars = pick($data['vars'], {})
      $all_service_vars = delete_undef_values($service_defaults['vars'] + $settings_vars + $this_service_vars)

      # Si sobreescribimos el check_timeout por defecto, pero no el nrpe_timeout, establecemos nrpe_timeout igual que check_timeout
      if ( $merged_data['check_timeout'] and ! $this_service_vars['nrpe_timeout'] ) {
        # NB: Icinga convertirá 1m a 60 automáticamente!
        $nrpe = { 'nrpe_timeout' => $merged_data['check_timeout'] }
      } else {
        $nrpe = {}
      }

      # Por defecto usamos nrpe y todos los comandos se ejecutan a través de nrpe. Por lo tanto, vars.nrpe_command = $service_name es un valor predeterminado
      # Si es un comando de Icinga del lado del servidor - no necesitamos 'nrpe_command'
      # pero no hay problema en tener esa variable y el código es más corto

      if $merged_data['check_command'] == 'nrpe'{
        $check_command = $merged_data['vars']['nrpe_command'] ? {
          undef   => { 'nrpe_command' => $service_name },
          default => { 'nrpe_command' => $merged_data['vars']['nrpe_command'] }
        }
      }else{
        $check_command = {}
      }

      # Armando $vars a partir de las configuraciones por defecto globales, configuraciones del grupo de servicios, configuraciones de este chequeo particular y no olvidemos las configuraciones de nrpe.
      if $all_service_vars['graphite_template'] {
        $graphite_template = {'check_command' => $all_service_vars['graphite_template']}
      }else{
        $graphite_template = {'check_command' => $service_name}
      }
      $service_notify = [] + pick($settings_vars['notify_group'], []) + pick($this_service_vars['notify_group'], []) # pick es requerido en todas partes, de lo contrario se convierte en "El valor '' no se puede convertir a numérico"

      $service_notify_group = $service_notify ? {
        []      => $service_defaults['vars']['notify_group'],
        default => $service_notify
      } # Asignar grupo por defecto (sistemas) si no se definen otros grupos

      $vars = $all_service_vars + $nrpe + $check_command + $graphite_template + {'notify_group' => $service_notify_group}

      # Esto necesita ser fusionado por separado, porque fusionarlo como parte de MERGED_DATA sobrescribe matrices en lugar de fusionarlas, así que perdemos algunos valores "asignar" e "ignorar"

      $assign = delete_undef_values($service_defaults['assign'] + $s_list['settings']['assign'] + $data['assign'])
      $ignore = delete_undef_values($service_defaults['ignore'] + $s_list['settings']['ignore'] + $data['ignore'])

      icinga2::object::service {$service_name:
        ensure             => $merged_data['ensure'],
        apply              => $merged_data['apply'],
        enable_flapping    => $merged_data['enable_flapping'],
        assign             => $assign,
        ignore             => $ignore,
        groups             => [$service_group],
        check_command      => $merged_data['check_command'],
        check_interval     => $merged_data['check_interval'],
        check_timeout      => $merged_data['check_timeout'],
        check_period       => $merged_data['check_period'],
        display_name       => $merged_data['display_name'],
        event_command      => $merged_data['event_command'],
        retry_interval     => $merged_data['retry_interval'],
        max_check_attempts => $merged_data['max_check_attempts'],
        target             => $merged_data['target'],
        vars               => $vars,
        template           => $merged_data['template'],
      }
    }
  }
#### FIN DE SERVICIOS ####

#### OTRAS COSAS ABURRIDAS ####

  $servicegroups.each | $servicegroup, $description |{
    icinga2::object::servicegroup{ $servicegroup:
      target       => $servicegroup_target,
      display_name => $description
    }
  }

  $hostgroups.each| String $hostgroup |{
    profiles::services::monitoring::hostgroup { $hostgroup:}
  }

  $notifications.each | String $name, Hash $settings |{

    $assign = pick($notification_defaults['assign'], []) + $settings['assign']
    $ignore = pick($notification_defaults['ignore'], []) + $settings['ignore']

    $merged_settings = $settings + $notification_defaults

    icinga2::object::notification{$name:
      target       => $merged_settings['target'],
      apply        => $merged_settings['apply'],
      apply_target => $merged_settings['apply_target'],
      command      => $merged_settings['command'],
      interval     => $merged_settings['interval'],
      states       => $merged_settings['states'],
      types        => $merged_settings['types'],
      assign       => delete_undef_values($assign),
      ignore       => delete_undef_values($ignore),
      user_groups  => $merged_settings['user_groups'],
      period       => $merged_settings['period'],
      vars         => $merged_settings['vars'],
    }
  }

  # Fusionando configuraciones de notificación para usuarios con otras configuraciones
  $users_oncall = deep_merge($users, $oncall)
  # Magia. No tocar.
  create_resources('icinga2::object::user', $users_oncall, $user_defaults)
  create_resources('icinga2::object::usergroup', $usergroups, $usergroup_defaults)
  create_resources('icinga2::object::timeperiod',$timeperiods)
  create_resources('icinga2::object::checkcommand', $check_commands)
  create_resources('icinga2::object::notificationcommand', $notification_commands)

  profiles::services::sudoers { 'icinga_runs_ping_l2':
    ensure            => present,
    sudoersd_template => 'profiles/os/redhat/centos7/sudoers/icinga.erb',
  }

}
Sigo trabajando en este código y mejorándolo siempre que puedo. Sin embargo, fue precisamente este tipo de código el que permitió utilizar una sintaxis simple y clara en Hiera:
Datos
profiles::services::monitoring::config::services:
  perf_checks:
    settings:
      check_interval: '2m'
      assign:
        - 'host.vars.type == linux'
    checks:
      procs: {}
      load: {}
      memory: {}
      disk:
        check_interval: '5m'
        vars:
          notification_period: '24x7'
      disk_iops:
        vars:
          notifications:
            - 'silent'
      cpu:
        vars:
          notifications:
            - 'silent'
      dns_fqdn:
        check_interval: '15m'
        ignore:
          - 'xenserver in host.groups'
        vars:
          notifications:
            - 'silent'
      iftraffic_nrpe:
        vars:
          notifications:
            - 'silent'
  logging:
    settings:
      assign:
        - 'logserver in host.groups'
    checks:
       rsyslog: {}
      nginx_limit_req_other: {}
      nginx_limit_req_s2s: {}
      nginx_limit_req_s2x: {}
      nginx_limit_req_srs: {}
     logstash: {}
      logstash_api:
        vars:
          notifications:
            - 'silent'
Todas las verificaciones están divididas en grupos, y cada grupo tiene configuraciones predeterminadas sobre dónde y con qué frecuencia ejecutar estas verificaciones, qué notificaciones enviar y a quién.
En cada verificación se puede anular cualquier opción, y todo esto se combina con las configuraciones predeterminadas de todas las verificaciones en general. Por eso en config.pp hay un código tan complejo: ahí se fusionan todas las configuraciones predeterminadas con las de los grupos y luego también con cada verificación individual.
Un cambio muy importante fue la posibilidad de usar funciones en las configuraciones, por ejemplo, una función para cambiar el puerto, la dirección y la URL para la verificación http_regex.
http_regexp:
  assign:
    - 'host.vars.http_regex'
    - 'static_sites in host.groups'
  check_command: 'http'
  check_interval: '1m'
  retry_interval: '20s'
  max_check_attempts: 6
  http_port: '{{ if(host.vars.http_port) { return host.vars.http_port } else { return 443 } }}'
  vars:
    notification_period: 'host.vars.notification_period'
    http_vhost: '{{ if(host.vars.http_vhost) { return host.vars.http_vhost } else { return host.name } }}'
    http_ssl: '{{ if(host.vars.http_ssl) { return false } else { return true } }}'
    http_expect_body_regex: 'host.vars.http_regex'
    http_uri: '{{ if(host.vars.http_uri) { return host.vars.http_uri } else { return "\/" } }}'
    http_onredirect: 'follow'
    http_warn_time: 8
    http_critical_time: 15
    http_timeout: 30
    http_sni: true
Esto significa que, si hay una variable en la definición del host http_port debemos usarla, de lo contrario, se usará 443. Por ejemplo, la interfaz web de jabber se encuentra en 9090, y Unifi en 7443.
http_vhost significa ignorar DNS y usar esta dirección.
Si en el host se especifica un uri, se utilizará ese, de lo contrario, se tomará "/".
Con http_ssl, surgió una historia curiosa: no podía desactivarse a pedido. Estuve mucho tiempo confundido con esta línea hasta que me di cuenta de que en la variable de definición del host:
http_ssl: falseSe inserta en la expresión
if(host.vars.http_ssl) { return false } else { return true }cómo false y al final se obtiene
if(false) { return false } else { return true }es decir, la verificación ssl siempre está activa. Se resolvió cambiando la sintaxis:
http_ssl: noConclusiones:
Pros:
- Ahora tenemos un solo sistema de monitoreo, y no dos como en los últimos 7-8 meses, o uno que estaba desactualizado y era vulnerable.
- La estructura de datos de hosts / servicios (verificaciones) ahora es, en mi opinión, mucho más legible y comprensible. Para otros no fue tan obvio, así que tuvimos que crear un par de páginas en la wiki local para aclarar cómo funciona todo y qué se debe modificar.
- Hay posibilidad de configuración flexible de las verificaciones mediante variables y funciones; por ejemplo, para verificar http_regexp, se pueden definir el patrón buscado, el código de retorno, la URL y el puerto en la configuración del host.
- Hay varios paneles (dashboards), cada uno de los cuales puede tener su propia lista de alertas mostradas y gestionar todo eso a través de Puppet y merge requests.
Desventajas:
- Inercia de los miembros del equipo — Nagios trabajó, trabajó y trabajó, mientras que tu Icinga constantemente falla y se congela. ¿Y cómo se ve el historial? Ah, maldición, ¡no se actualiza! (Un problema real — el historial de alertas no se actualiza automáticamente, solo al presionar F5)
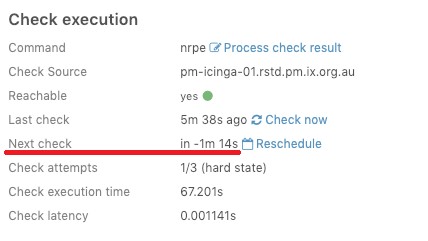
- Inercia del sistema — cuando hago clic en 'actualizar' (check now) en la interfaz web, el resultado depende del clima en Marte, especialmente en los servicios complejos que requieren decenas de segundos para completarse. Un resultado así es lo normal.

- En general, por la estadística semestral del funcionamiento de ambos sistemas lado a lado, Nagios siempre respondía más rápido que Icinga, y eso me irritaba mucho. Creo que allí hay algo raro con los temporizadores y la verificación cada cinco minutos en realidad ocurre cada 5:30 o algo así.
- Si reinicias el servicio en cualquier momento (systemctl restart icinga2), todas las verificaciones que estaban en proceso devolverán una alarma critical <terminated by signal 15> en la pantalla, y desde afuera parece que todo ha caído ().
Pero en general — funciona.
Fuente: habr.com
