

¡Hola a todos! Soy desarrollador de CV en KROK. Durante 3 años hemos estado implementando proyectos en el área de CV. En este tiempo hemos hecho de todo, por ejemplo: monitoreamos a los conductores para asegurarnos de que no beban, no fumen, no hablen por teléfono ni miren al cielo o a las nubes mientras conducen; registramos a los que utilizan carriles especiales o que ocupan varios espacios en el estacionamiento; aseguramos que los empleados usen casco, guantes, etc.; identificamos a los empleados que desean ingresar a un recinto; contabilizamos todo lo que se pueda.
¿A qué voy con todo esto?
Durante la implementación de proyectos hemos aprendido por las malas, muchas lecciones; algunos de los problemas ustedes ya conocen, y otros los conocerán en el futuro.
Modelamos una situación
Supongamos que hemos sido contratados por una joven empresa 'N', cuya actividad está relacionada con ML. Estamos trabajando en un proyecto de ML (DL, CV) y, por alguna razón, cambiamos a otro trabajo, en fin, tomamos un descanso y luego volvemos a nuestra o a otra red neuronal.
- Llega el momento de la verdad, necesitamos recordar en qué punto nos quedamos, qué hiperparámetros probamos y, lo más importante, qué resultados obtuvimos. Puede haber múltiples formas de cómo cada uno almacenó la información sobre todas las ejecuciones: en la mente, en configuraciones, en un cuaderno, en un entorno de trabajo en la nube. He visto un caso donde los hiperparámetros se almacenaron como líneas comentadas en el código; en resumen, un vuelo de fantasía. Y ahora imaginen que no volvieron a su proyecto, sino al proyecto de alguien que dejó la empresa y ustedes se quedaron con el código y un modelo llamado model_1.pb. Para completar el cuadro y transmitir todo el dolor, supongamos que ustedes también son un especialista principiante.
- Avancemos. Para ejecutar el código, necesitamos crear un entorno, y todos los que trabajarán con él también lo necesitan. A menudo sucede que este entorno no nos fue dejado por alguna razón. Este también puede ser un desafío no trivial. No queremos perder tiempo en este paso, ¿verdad?
- Entrenamos un modelo (por ejemplo, un detector de automóviles). Llegamos al punto en que se vuelve bastante decente, es hora de guardar el resultado. Lo llamaremos car_detection_v1.pb. Luego entrenamos otro — car_detection_v2.pb. Un tiempo después, nuestros colegas o nosotros mismos entrenamos más y más, utilizando diversas arquitecturas. Al final, se forma un montón de artefactos, cuya información debemos recopilar meticulosamente (pero lo haremos más tarde, ya que tenemos asuntos más prioritarios).
- ¡Y eso es todo! ¡Tenemos un modelo! Podemos comenzar a entrenar el siguiente modelo, desarrollar la arquitectura para resolver una nueva tarea o, ¿podemos ir a tomar un té? ¿Pero quién se encargará del despliegue?
Identificando problemas
El trabajo en un proyecto o producto es el esfuerzo de muchas personas. Con el tiempo, algunas personas se van y otras llegan, los proyectos aumentan en número y se vuelven más complejos. De una forma u otra, las situaciones descritas en el ciclo anterior (y no solo) se encontrarán en diversas combinaciones de iteración en iteración. Todo esto se traduce en pérdida de tiempo, confusión, nervios, posiblemente, descontento del cliente y, al final, en dinero perdido. Aunque a menudo repetimos los mismos errores, creo que nadie quiere vivir estos momentos una y otra vez.
Así que hemos pasado por un ciclo de desarrollo y vemos que hay problemas que necesitamos resolver. Para ello, necesitamos:
- almacenar cómodamente los resultados del trabajo;
- facilitar el proceso de involucrar a nuevos empleados;
- simplificar el proceso de despliegue del entorno de desarrollo;
- configurar el proceso de versionado de modelos;
- tener una forma conveniente de validar modelos;
- encontrar una herramienta para gestionar el estado de los modelos;
- encontrar una manera de entregar modelos a producción.
Parece que es necesario idear un flujo de trabajo que permita gestionar cómodamente este ciclo de vida. Esta práctica se llama MLOps.
MLOps, o DevOps para el aprendizaje automático, permite a los equipos de especialistas en procesamiento y análisis de datos y a los profesionales de TI colaborar, además de aumentar la velocidad de desarrollo y despliegue de modelos mediante monitoreo, validación y un sistema de gestión para modelos de aprendizaje automático.
Puedes , lo que piensan al respecto los chicos de Google. Por el artículo, queda claro que MLOps es algo bastante amplio.
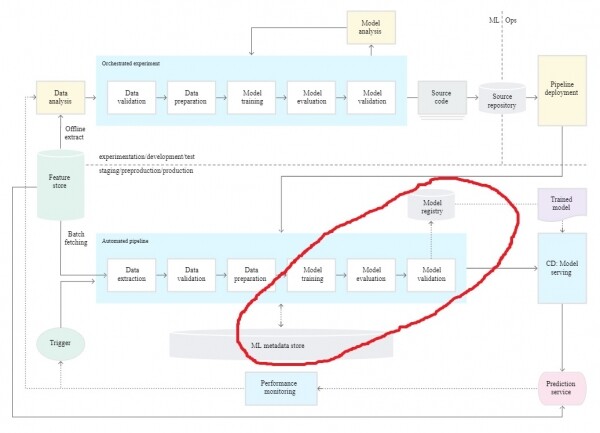
En el siguiente artículo describiré solo una parte del proceso. Para llevarlo a cabo, utilizaré la herramienta MLflow, ya que es un proyecto de código abierto, requiere un poco de código para conectarse y tiene integración con marcos de trabajo de ML populares. Puedes buscar en la web otras herramientas, como Kubeflow, SageMaker, Trains, etc., y posiblemente encontrar la que mejor se adapte a tus necesidades.
"Construimos" MLOps a partir del uso de la herramienta MLFlow
MLFlow es una plataforma de código abierto para la gestión del ciclo de vida de modelos de ML ().
MLflow incluye cuatro componentes:
- MLflow Tracking se encarga de registrar los resultados y los parámetros que llevaron a esos resultados;
- MLflow Project permite empaquetar el código y reproducirlo en cualquier plataforma;
- MLflow Models es responsable del despliegue de modelos en producción;
- MLflow Registry permite almacenar modelos y gestionar su estado en un repositorio centralizado.
MLflow opera con dos entidades:
- una ejecución es el ciclo completo de entrenamiento, parámetros y métricas que queremos registrar;
- un experimento es el "tema" que une las ejecuciones.
Todos los pasos del ejemplo se han implementado en el sistema operativo Ubuntu 18.04.
1. Desplegamos el servidor
Para poder gestionar nuestro proyecto fácilmente y obtener toda la información necesaria, desplegaremos un servidor. El servidor de seguimiento de MLflow tiene dos componentes principales:
- backend store se encarga de almacenar información sobre los modelos registrados (soporta 4 bases de datos: mysql, mssql, sqlite y postgresql);
- artifact store se encarga de almacenar artefactos (soporta 7 tipos de almacenamiento: Amazon S3, Azure Blob Storage, Google Cloud Storage, servidor FTP, servidor SFTP, NFS, HDFS).
Como artifact store para simplificar, tomaremos un servidor SFTP.
- creamos un grupo
$ sudo groupadd sftpg - agregamos un usuario y le asignamos una contraseña
$ sudo useradd -g sftpg mlflowsftp $ sudo passwd mlflowsftp - ajustamos un par de configuraciones de acceso
$ sudo mkdir -p /data/mlflowsftp/upload $ sudo chown -R root.sftpg /data/mlflowsftp $ sudo chown -R mlflowsftp.sftpg /data/mlflowsftp/upload - agregamos algunas líneas en /etc/ssh/sshd_config
Match Group sftpg ChrootDirectory /data/%u ForceCommand internal-sftp - reiniciamos el servicio
$ sudo systemctl restart sshd
Como backend store tomaremos postgresql.
$ sudo apt update
$ sudo apt-get install -y postgresql postgresql-contrib postgresql-server-dev-all
$ sudo apt install gcc
$ pip install psycopg2
$ sudo -u postgres -i
# Crear nuevo usuario: mlflow_user
[postgres@user_name~]$ createuser --interactive -P
Ingrese el nombre del rol a agregar: mlflow_user
Ingrese la contraseña para el nuevo rol: mlflow
Ingrese de nuevo: mlflow
¿Debería el nuevo rol ser un superusuario? (s/n) n
¿Debería el nuevo rol tener permiso para crear bases de datos? (s/n) n
¿Debería el nuevo rol tener permiso para crear más nuevos roles? (s/n) n
# Crear base de datos mlflow_bd propiedad de mlflow_user
$ createdb -O mlflow_user mlflow_db
Para ejecutar el servidor es necesario instalar los siguientes paquetes de python (se recomienda crear un entorno virtual separado):
pip install mlflow
pip install pysftp
Iniciamos nuestro servidor
$ mlflow server
                 --backend-store-uri postgresql://mlflow_user:mlflow@localhost/mlflow_db
                 --default-artifact-root sftp://mlflowsftp:mlflow@sftp_host/upload
                --host server_host
                --port server_port
2. Añadimos el tracking
Para que los resultados de nuestros entrenamientos no se pierdan, las futuras generaciones de desarrolladores entiendan lo que ocurrió y los compañeros y tú podáis analizar el proceso de entrenamiento tranquilamente, necesitamos añadir tracking. El tracking implica guardar parámetros, métricas, artefactos y cualquier información adicional sobre la ejecución del entrenamiento, en nuestro caso, en el servidor.
Como ejemplo, he creado un pequeño sobre Keras para la segmentación de todo lo que hay en . Para agregar el tracking, he creado un archivo mlflow_training.py.
Aquí están las líneas donde ocurre lo más interesante:
def run(self, epochs, lr, experiment_name):
        # obteniendo el id del experimento, creando un experimento en su ausencia
        remote_experiment_id = self.remote_server.get_experiment_id(name=experiment_name)
        # creando un "run" y obteniendo su id
        remote_run_id = self.remote_server.get_run_id(remote_experiment_id)

        # indicar que queremos guardar los resultados en un servidor remoto
        mlflow.set_tracking_uri(self.tracking_uri)
        mlflow.set_experiment(experiment_name)

        with mlflow.start_run(run_id=remote_run_id, nested=False):
            mlflow.keras.autolog()
            self.train_pipeline.train(lr=lr, epochs=epochs)

        try:
            self.log_tags_and_params(remote_run_id)
        except mlflow.exceptions.RestException as e:
            print(e)
Aquí, self.remote_server es un pequeño envoltorio alrededor de los métodos mlflow.tracking.MlflowClient (lo hice para comodidad), a través de los cuales creo el experimento y la ejecución en el servidor. Luego indico a dónde deben enviarse los resultados de la ejecución (mlflow.set_tracking_uri(self.tracking_uri)). Conecto el registro automático mlflow.keras.autolog(). Hasta ahora, MLflow Tracking admite el registro automático para TensorFlow, Keras, Gluon XGBoost, LightGBM, Spark. Si no encuentras tu marco o biblioteca, siempre puedes registrar explícitamente. Iniciamos el entrenamiento. Registramos etiquetas y parámetros de entrada en el servidor remoto.
Un par de líneas y tú, como todos los interesados, tendrás acceso a la información sobre todas las ejecuciones. ¿Genial?
3. Estructuramos el proyecto
Ahora haremos que lanzar el proyecto sea pan comido. Para esto, añadiremos un archivo MLproject y conda.yaml en la raíz del proyecto.
MLproject
name: flow_segmentation
conda_env: conda.yaml

entry_points:
  main:
    parameters:
        categories: {help: 'lista de categorías del conjunto de datos coco'}
        epochs: {type: int, help: 'número de epochs en el entrenamiento'}

        lr: {type: float, default: 0.001, help: 'tasa de aprendizaje'}
        batch_size: {type: int, default: 8}
        model_name: {type: str, default: 'Unet', help: 'Unet, PSPNet, Linknet, FPN'}
        backbone_name: {type: str, default: 'resnet18', help: 'ejemplo resnet18, resnet50, mobilenetv2 ...'}

        tracking_uri: {type: str, help: 'la dirección del servidor'}
        experiment_name: {type: str, default: 'My_experiment', help: 'nombre del experimento remoto y local'}
    command: "python mlflow_training.py
            --epochs={epochs}
            --categories={categories}
            --lr={lr}
            --tracking_uri={tracking_uri}
            --model_name={model_name}
            --backbone_name={backbone_name}
            --batch_size={batch_size}
            --experiment_name={experiment_name}"
El proyecto MLflow tiene varias propiedades:
- Name — el nombre de tu proyecto;
- Environment — en mi caso, conda_env indica que se utiliza Anaconda para la ejecución y la descripción de las dependencias se encuentra en el archivo conda.yaml;
- Entry Points — indica qué archivos se pueden ejecutar y con qué parámetros (todos los parámetros al iniciar el entrenamiento se registran automáticamente)
conda.yaml
name: flow_segmentation
channels:
  - defaults
  - anaconda
dependencies:
  - python==3.7
  - pip:
    - mlflow==1.8.0
    - pysftp==0.2.9
    - Cython==0.29.19
    - numpy==1.18.4
    - pycocotools==2.0.0
    - requests==2.23.0
    - matplotlib==3.2.1
    - segmentation-models==1.0.1
    - Keras==2.3.1
    - imgaug==0.4.0
    - tqdm==4.46.0
    - tensorflow-gpu==1.14.0
Como entorno de ejecución, puedes utilizar docker, para más información, consulta .
4. Iniciamos el entrenamiento
Clonamos el proyecto y accedemos al directorio del proyecto:
git clone https://github.com/simbakot/mlflow_example.git
cd mlflow_example/
Para ejecutarlo, necesitas instalar las bibliotecas
pip install mlflow
pip install pysftp
Dado que en el ejemplo uso conda_env, Anaconda debe estar instalada en su computadora (aunque también se puede sortear esto instalando todos los paquetes necesarios manualmente y jugando con los parámetros de inicio).
Todos los pasos de preparación han terminado y podemos comenzar el entrenamiento. Desde la raíz del proyecto:
$ mlflow run -P epochs=10 -P categories=cat,dog -P tracking_uri=http://server_host:server_port .Después de ingresar el comando, se creará automáticamente el entorno conda y comenzará el entrenamiento.
En el ejemplo anterior, pasé el número de épocas para el entrenamiento, las categorías a las que queremos segmentar (la lista completa se puede ver ) y la dirección de nuestro servidor remoto.
La lista completa de parámetros posibles se puede ver en el archivo MLproject.
5. Evaluamos los resultados del entrenamiento
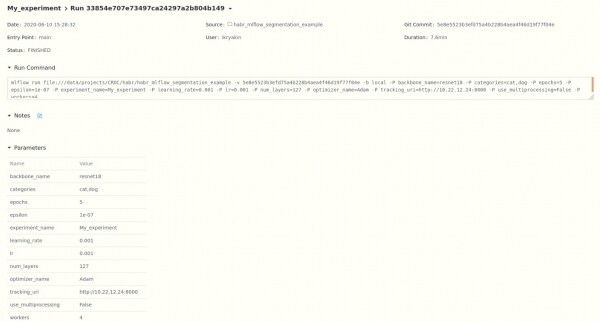
Después de finalizar el entrenamiento, podemos ir en el navegador a la dirección de nuestro servidor
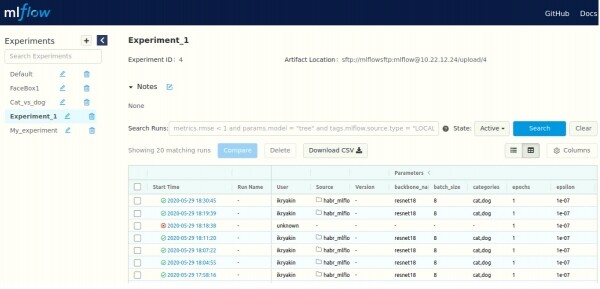
Aquí vemos la lista de todos los experimentos (en la esquina superior izquierda), así como la información sobre los lanzamientos (en el medio). Podemos ver información más detallada (parámetros, métricas, artefactos y algo de información adicional) sobre cada lanzamiento.
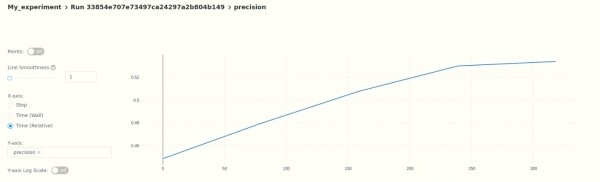
Para cada métrica, podemos observar la historia de cambios.
Es decir, en este momento podemos analizar los resultados en modo 'manual', también puedes configurar la validación automática utilizando la API de MLflow.
6. Registramos el modelo
Después de que hayamos analizado nuestro modelo y decidamos que está listo para entrar en acción, procedemos a registrarlo; para ello seleccionamos el lanzamiento que necesitamos (como se muestra en el punto anterior) y bajamos.
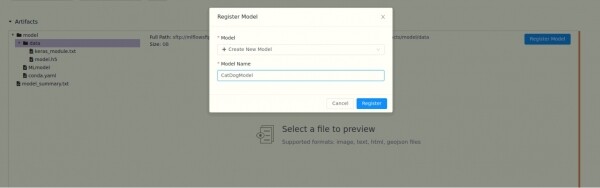
Una vez que hemos dado un nombre a nuestro modelo, se le asigna una versión. Al guardar otro modelo con el mismo nombre, la versión se incrementará automáticamente.
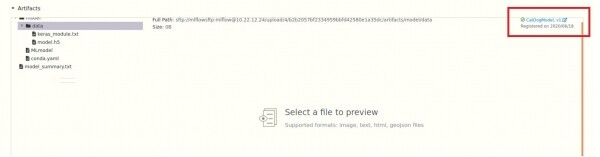
Para cada modelo, podemos agregar una descripción y elegir uno de tres estados (Staging, Production, Archived), lo que, junto con la gestión de versiones, proporciona flexibilidad adicional a la hora de acceder a estos estados mediante la API.
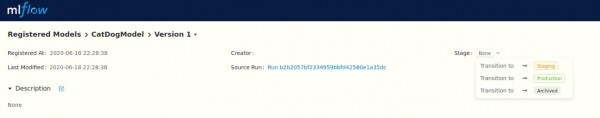
También tenemos acceso fácil a todos los modelos
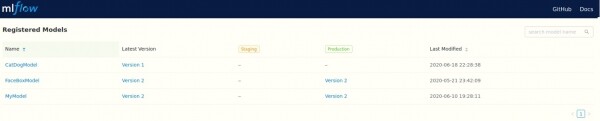
y sus versiones.
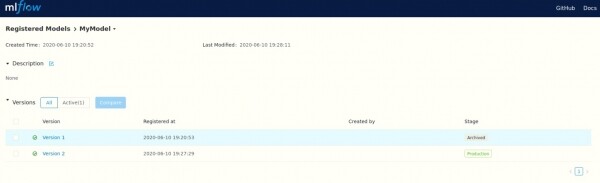
Al igual que en el punto anterior, todas las operaciones se pueden realizar utilizando la API.
7. Desplegamos el modelo
En esta etapa, ya tenemos un modelo entrenado (keras). Ejemplo de cómo se puede usar:
class SegmentationModel:
    def __init__(self, tracking_uri, model_name):

        self.registry = RemoteRegistry(tracking_uri=tracking_uri)
        self.model_name = model_name
        self.model = self.build_model(model_name)

    def get_latest_model(self, model_name):
        registered_models = self.registry.get_registered_model(model_name)
        last_model = self.registry.get_last_model(registered_models)
        local_path = self.registry.download_artifact(last_model.run_id, 'model', '.\/')
        return local_path

    def build_model(self, model_name):
        local_path = self.get_latest_model(model_name)

        return mlflow.keras.load_model(local_path)

    def predict(self, image):
        image = self.preprocess(image)
        result = self.model.predict(image)
        return self.postprocess(result)

    def preprocess(self, image):
        image = cv2.resize(image, (256, 256))
        image = image / 255.
        image = np.expand_dims(image, 0)
        return image

    def postprocess(self, result):
        return result
Aquí, self.registry es nuevamente un pequeño envoltorio sobre mlflow.tracking.MlflowClient, para mayor comodidad. La esencia es que me estoy comunicando con un servidor remoto y buscando un modelo con el nombre especificado, además, la última versión de producción. Luego descargo el artefacto localmente en la carpeta .\/model y construyo el modelo desde ese directorio mlflow.keras.load_model(local_path). Ahora podemos utilizar nuestro modelo. Los desarrolladores de CV (ML) pueden seguir mejorando el modelo y publicar nuevas versiones.
En conclusión
He presentado un sistema que permite:
- almacenar de manera centralizada información sobre modelos de ML, el progreso y los resultados del entrenamiento;
- desplegar rápidamente un entorno de desarrollo;
- monitorear y analizar el progreso del trabajo en los modelos;
- llevar un control de versiones y gestionar el estado de los modelos;
- desplegar fácilmente los modelos obtenidos.
Este ejemplo es un juguete y sirve como punto de partida para construir su propio sistema, que quizás incluya la automatización de la evaluación de resultados y el registro de modelos (p.5 y p.6 respectivamente) o que agregue el versionado de conjuntos de datos, o tal vez algo más. Intenté transmitir la idea de que necesita MLOps en general, MLflow es solo un medio para alcanzar el objetivo.
¿Qué problemas ha enfrentado que no he reflejado?
¿Qué añadiría al sistema para que satisfaga sus necesidades?
¿Qué herramientas y enfoques utiliza para abordar todos o parte de los problemas?
P.D. Dejaré un par de enlaces:
proyecto de github —
MLflow —
Mi correo de trabajo para preguntas — ikryakin@croc.ru
En nuestra empresa, de forma periódica, organizamos diversos eventos para profesionales de TI; por ejemplo, el 8 de julio a las 19:00 hora de Moscú, se llevará a cabo un meetup sobre CV en formato online. Si estás interesado, puedes participar, registration .
Fuente: habr.com
