

En este artículo, hablaré sobre una situación que ocurrió recientemente con uno de los servidores de nuestra nube VPS, dejándome perplejo durante varias horas. He estado configurando y solucionando problemas en servidores Linux durante aproximadamente 15 años, pero este caso no se ajusta a mi experiencia: hice algunas suposiciones erróneas y me sentí un poco desesperado antes de poder identificar correctamente la causa del problema y resolverlo.
Preámbulo
Operamos una nube de tamaño mediano que construimos sobre servidores estándar con la siguiente configuración: 32 núcleos, 256 GB de RAM y un disco NVMe PCI-E Intel P4500 de 4TB. Nos gusta mucho esta configuración porque nos permite no preocuparnos por la falta de I/O, asegurando un límite adecuado a nivel de tipos de instancias (VM). Dado que el NVMe Intel ofrece un rendimiento impresionante, podemos proporcionar simultáneamente tanto el total de IOPS a las máquinas como respaldar el almacenamiento en un servidor de copias de seguridad con cero IOWAIT.
Nos consideramos los antiguos que no utilizan SDN hiperconvergentes ni otras cosas modernas y elegantes para el almacenamiento de volúmenes de VM, creyendo que cuanto más simple es el sistema, más fácil es solucionar problemas en condiciones de "el gran gurú se fue a las montañas". En resumen, almacenamos volúmenes de VM en formato QCOW2 en XFS o EXT4, que está desplegado sobre LVM2.
El uso de QCOW2 también está dictado por el producto que utilizamos para la orquestación: Apache CloudStack.
Para realizar las copias de seguridad, tomamos una imagen completa del volumen, como una instantánea de LVM2 (sí, sabemos que las instantáneas de LVM2 son lentas, pero el Intel P4500 también nos ayuda aquí). Hacemos lvmcreate -s .. y con ayuda de dd enviamos la copia de seguridad a un servidor remoto con almacenamiento ZFS. Aquí aún somos un poco progresivos: ZFS puede almacenar datos en formato comprimido, y podemos recuperarlos rápidamente usando ataques DD o extraer volúmenes de VM individuales con mount -o loop ....
Por supuesto, también se puede tomar no solo la imagen completa del volumen LVM2, sino montar el sistema de archivos en modo
ROy copiar las imágenes QCOW2 en sí, sin embargo, hemos tenido problemas con XFS que se volvían inestables, no de inmediato, sino de manera impredecible. No nos gusta cuando los hosts hipervisores "se cuelgan" de repente los fines de semana, por la noche o en días festivos debido a errores que pueden producirse en cualquier momento. Por lo tanto, para XFS no utilizamos el montaje de instantáneas en modoROpara extraer volúmenes, simplemente copiamos todo el volumen LVM2.
La velocidad de respaldo en el servidor de copias de seguridad depende en nuestro caso del rendimiento del servidor de respaldo, que es de aproximadamente 600-800 MB/s para datos no comprimidos, y el limitante adicional es el canal de 10Gbit/s, al que está conectado el servidor de copias de seguridad en el clúster.
En un servidor de copias de seguridad, se vuelcan simultáneamente las copias de seguridad de 8 servidores hipervisores. Así, los subsistemas de disco y red del servidor de copias de seguridad, siendo más lentos, evitan sobrecargar los subsistemas de disco de los hosts hipervisores, ya que simplemente no pueden manejar, digamos, 8 GB/s, que los hosts hipervisores pueden proporcionar sin esfuerzo.
El proceso de copia descrito anteriormente es muy importante para la narrativa que sigue, incluyendo detalles como el uso del rápido almacenamiento Intel P4500, el uso de NFS y, probablemente, el uso de ZFS.
Historia de la copia de seguridad
En cada nodo hipervisor tenemos una pequeña partición SWAP de 8 GB, y el propio nodo hipervisor lo "desplegamos" utilizando ataques DD una imagen base. Para la partición del sistema en los servidores utilizamos 2xSATA SSD RAID1 o 2xSAS HDD RAID1 en un controlador de hardware LSI o HP. En general, no nos importa qué hay dentro, ya que la partición del sistema funciona en modo "casi solo lectura", excepto por el SWAP. Y dado que tenemos mucha RAM en el servidor y está 30-40% libre, no pensamos en el SWAP.
Proceso de creación de copia de seguridad. Esta tarea se ve aproximadamente así:
#!/bin/bash

mkdir -p /mnt/backups/volumes

DIR=/mnt/images-snap
VOL=images/volume
DATE=$(date "+%d")
HOSTNAME=$(hostname)

lvcreate -s -n $VOL-snap -l100%FREE $VOL
ionice -c3 dd iflag=direct if=/dev/$VOL-snap bs=1M of=/mnt/backups/volumes/$HOSTNAME-$DATE.raw
lvremove -f $VOL-snap
Presta atención a ionice -c3, de hecho, esta cosa es completamente inútil para dispositivos NVMe, ya que el programador de IO para ellos está establecido como:
cat /sys/block/nvme0n1/queue/scheduler
[none]
Sin embargo, tenemos una serie de nodos legacy con RAID de SSD comunes, para ellos esto es relevante, así que se traslada AS IS. En general, es solo un fragmento interesante de código que explica la futilidad ionice en caso de tal configuración.
Presta atención a la bandera iflag=direct para ataques DD. Utilizamos direct IO para evitar reemplazos innecesarios de los buffers IO durante la lectura. Sin embargo, oflag=direct no lo hacemos, ya que hemos encontrado problemas de rendimiento con ZFS al usarlo.
Este esquema ha sido utilizado por nosotros con éxito durante varios años sin problemas.
Y aquí comenzó… Descubrimos que la copia de seguridad para uno de los nodos dejó de ejecutarse, y la anterior se había realizado con un monstruoso IOWAIT de casi 50%. Al intentar entender por qué no se realizaba la copia de seguridad, nos encontramos con el fenómeno:
Grupo de volúmenes "images" no encontradoComenzamos a pensar en "ha llegado el fin para el Intel P4500", sin embargo, antes de apagar el servidor para reemplazar el dispositivo, era necesario realizar la copia de seguridad. Reparamos LVM2 con la recuperación de metadatos desde la copia de seguridad de LVM2:
vgcfgrestore imagesIniciamos la copia de seguridad y vimos esta imagen:
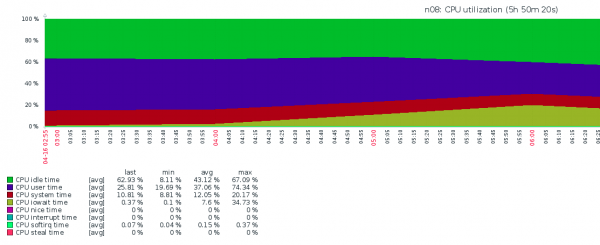
Volvimos a entristecernos mucho — estaba claro que no podríamos vivir así, ya que todos los VPS sufrirían, y eso significaba que nosotros también sufriríamos. Lo que estaba sucediendo no era del todo claro — iostat mostraba tristes IOPS y un IOWAIT altísimo. No teníamos ideas, excepto "reemplacemos el NVMe", pero de repente tuvimos una epifanía.
Análisis de la situación paso a paso
Registro histórico. Unos días antes, en este servidor se necesitaba crear un gran VPS con 128 GB de RAM. La memoria parecía ser suficiente, pero para precaución se asignaron otros 32 GB para la partición de intercambio. Se creó el VPS, cumplió su tarea con éxito y el incidente fue olvidado, pero la partición SWAP permaneció.
Características de la configuración. Para todos los servidores en la nube, el valor de vm.swappiness se estableció en el valor predeterminado 60. Y el SWAP fue creado en un RAID1 de discos duros SAS.
Lo que estaba sucediendo (en opinión de la redacción). Durante la copia de seguridad ataques DD produjo muchos datos para escribir, que se almacenaron en los buffers de RAM antes de escribir en NFS. El núcleo del sistema, siguiendo la política de swappiness, movía muchas páginas de memoria del VPS a la partición de intercambio, que estaba en el volumen lento de HDD RAID1. Esto hacía que el IOWAIT aumentara considerablemente, pero no por IO NVMe, sino por IO HDD RAID1.
Cómo se resolvió el problema. Se desactivó la partición de intercambio de 32 GB. Esto tomó 16 horas, sobre cómo y por qué se desactiva tan lentamente el SWAP se puede leer por separado. Se cambiaron los parámetros swappiness a un valor igual 5 en toda la nube.
Cómo pudo suceder esto. En primer lugar, si el SWAP estuviera en un dispositivo SSD RAID o NVMe, en segundo lugar, si no hubiera un dispositivo NVMe, sino un dispositivo más lento que no pudiera manejar tal volumen de datos; irónicamente, el problema ocurrió porque el NVMe es demasiado rápido.
Después de esto, todo volvió a funcionar como antes, con cero IOWAIT.
Fuente: habr.com
