

Quiero compartir con ustedes mi primera experiencia exitosa en la restauración de la plena operatividad de una base de datos Postgres. Con el sistema de gestión de bases de datos Postgres me familiaricé hace medio año, antes de esta experiencia no tenía ninguna trayectoria en la administración de bases de datos.
Trabajo como medio ingeniero DevOps en una gran empresa de TI. Nuestra empresa se dedica al desarrollo de software para servicios de alta carga, y yo soy responsable del funcionamiento, mantenimiento y despliegue. Me asignaron una tarea estándar: actualizar una aplicación en un servidor. La aplicación está escrita en Django, durante la actualización se realizan migraciones (cambios en la estructura de la base de datos), y antes de este proceso hacemos un volcado completo de la base de datos a través del programa estándar pg_dump, por si acaso.
Durante la creación del volcado ocurrió un error imprevisto (versión de Postgres – 9.5):
pg_dump: Oumping the contents of table “ws_log_smevlog” failed: PQgetResult() failed.
pg_dump: Error message from server: ERROR: invalid page in block 4123007 of relatton base/16490/21396989
pg_dump: The command was: COPY public.ws_log_smevlog [...]
pg_dunp: [parallel archtver] a worker process dled unexpectedly
Error «invalid page in block» indica problemas a nivel del sistema de archivos, lo cual es muy preocupante. En varios foros se sugirió hacer FULL VACUUM con la opción zero_damaged_pages para resolver este problema. Bueno, vamos a intentarlo...
Preparativos para la recuperación
¡ATENCIÓN! Asegúrese de hacer una copia de seguridad de Postgres antes de cualquier intento de restaurar la base de datos. Si tiene una máquina virtual, detenga la base de datos y haga un snapshot. Si no es posible hacer un snapshot, detenga la base y copie el contenido del directorio de Postgres (incluidos los archivos wal) en un lugar seguro. Lo principal en nuestro trabajo es no empeorar las cosas. Lea .
Dado que en general mi base funcionaba, me limité a hacer un volcado de la base de datos, pero excluí la tabla con los datos dañados (opción -T, —exclude-table=TABLE en pg_dump).
El servidor era físico, no era posible hacer un snapshot. La copia de seguridad se realizó, sigamos adelante.
Verificación del sistema de archivos
Antes de intentar recuperar la base de datos, es necesario asegurarse de que todo esté en orden con el sistema de archivos. Y en caso de errores, corregirlos, ya que de lo contrario solo se puede empeorar la situación.
En mi caso, el sistema de archivos con la base de datos estaba montado en «/srv» y el tipo era ext4.
Detenemos la base de datos: systemctl stop postgresql@9.5-main.service y verificamos que el sistema de archivos no está siendo utilizado por nadie y se puede desmontar con el comando lsof:
lsof +D /srv
Tuve que detener también la base de datos redis, ya que también la utilizaba. «/srv»Luego, la desmonté /srv (umount).
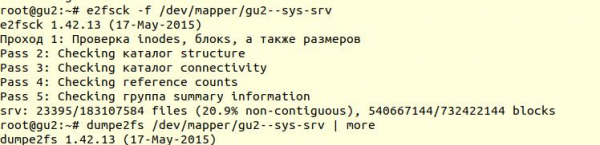
La verificación del sistema de archivos se realizó con la herramienta e2fsck con la clave -f (Verifica forzosamente incluso si el sistema de archivos está marcado como limpio):
Luego, con la herramienta dumpe2fs (sudo dumpe2fs /dev/mapper/gu2—sys-srv | grep checked) se puede confirmar que realmente se realizó la verificación:
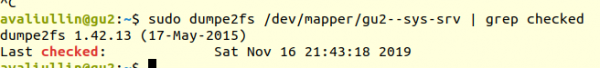
e2fsck indica que no se encontraron problemas a nivel de sistema de archivos ext4, lo que significa que podemos continuar los intentos de restaurar la base de datos, o mejor dicho, volver a vacuum full (por supuesto, es necesario montar el sistema de archivos de nuevo y reiniciar la base de datos).
Si tiene un servidor físico, asegúrese de verificar el estado de los discos (a través de smartctl -a /dev/XXX) o del controlador RAID para asegurarse de que el problema no está a nivel de hardware. En mi caso, el RAID resultó ser "hardware", por lo que le pedí al administrador local que verificara el estado del RAID (el servidor estaba a varios cientos de kilómetros de distancia). Dijo que no había errores, lo que significa que definitivamente podemos comenzar la restauración.
Intento 1: zero_damaged_pages
Nos conectamos a la base de datos a través de psql con una cuenta que tiene derechos de superusuario. Necesitamos un superusuario porque solo él puede cambiar la opción zero_damaged_pages . En mi caso, este es postgres:
psql -h 127.0.0.1 -U postgres -s [database_name]
La opción zero_damaged_pages necesaria para ignorar errores de lectura (desde el sitio postgrespro):
Al detectar un encabezado de página dañado, Postgres Pro generalmente informa un error y aborta la transacción actual. Si el parámetro zero_damaged_pages está habilitado, el sistema emite una advertencia, restablece la página dañada en la memoria y continúa el procesamiento. Este comportamiento destruye los datos, es decir, todas las filas en la página dañada.
Activamos la opción y tratamos de realizar un vacuum completo de la tabla:
VACUUM FULL VERBOSE 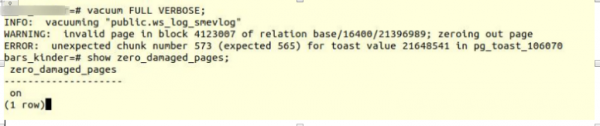
Desafortunadamente, fracasamos.
Nos encontramos con un error similar:
INFO: vacuuming "“public.ws_log_smevlog”
WARNING: invalid page in block 4123007 of relation base/16400/21396989; zeroing out page
ERROR: unexpected chunk number 573 (expected 565) for toast value 21648541 in pg_toast_106070– mecanismo de almacenamiento de "datos largos" en Postgres, si no caben en una página (por defecto 8kB).
Intento 2: reindex
El primer consejo de Google no funcionó. Después de unos minutos de búsqueda encontré un segundo consejo: hacer reindex tabla dañada. Este consejo lo he encontrado en muchos lugares, pero no me daba confianza. Haremos reindex:
reindexar la tabla ws_log_smevlog 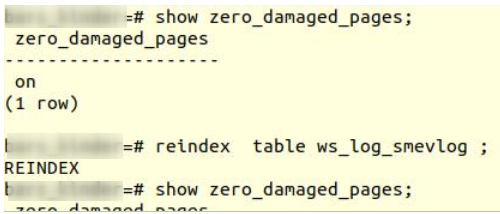
reindex finalizó sin problemas.
Sin embargo, esto no ayudó, VACUUM FULL terminó de manera análoga con el mismo error. Como estaba acostumbrado a los fracasos, seguí buscando consejos en Internet y encontré algo bastante interesante .
Intento 3: SELECT, LIMIT, OFFSET
En el artículo anterior se sugería revisar la tabla fila por fila y eliminar los datos problemáticos. Para empezar, era necesario revisar todas las filas:
for ((i=0; i /dev/null || echo $i; doneEn mi caso, la tabla contenía 1 628 991 filas! En realidad, debía haberme ocupado de , pero este es un tema para otra discusión. Era sábado, ejecuté este comando en tmux y me fui a dormir:
for ((i=0; i /dev/null || echo $i; donePor la mañana decidí verificar cómo iban las cosas. Para mi sorpresa, descubrí que durante 20 horas solo se había escaneado el 2% de los datos. No quería esperar 50 días. Otro fracaso total.
Pero no me rendí. Me empezó a interesar por qué el escaneo estaba tardando tanto. De la documentación (una vez más en postgrespro) aprendí que:
OFFSET indica que se deben omitir el número especificado de filas antes de comenzar a devolver filas.
Si se especifiquen tanto OFFSET como LIMIT, el sistema primero omite las filas de OFFSET y luego empieza a contar las filas para el límite de LIMIT.Al aplicar LIMIT, es importante usar también la cláusula ORDER BY, para que las filas devueltas aparezcan en un orden determinado. De lo contrario, se devolverán subconjuntos de filas impredecibles.
Es evidente que el comando mencionado anteriormente era erróneo: primero, no había order by, el resultado podría haber sido erróneo. En segundo lugar, Postgres primero tendría que escanear y omitir las filas de OFFSET, y a medida que aumentaba OFFSET la disminución del rendimiento sería aún mayor.
Intento 4: tomar un volcado en formato texto
Luego se me ocurrió una idea que parecía brillante: tomar un volcado en formato texto y analizar la última fila registrada.
Pero primero, familiaricémonos con la estructura de la tabla ws_log_smevlog:
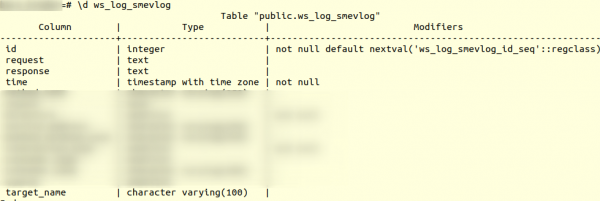
En nuestro caso, tenemos una columna "id", que contenía un identificador único (contador) para cada fila. El plan era el siguiente:
- Comenzamos a tomar un volcado en formato texto (en forma de comandos SQL)
- En un momento determinado, la extracción de la copia de seguridad se detendría debido a un error, pero el archivo de texto aún se habría guardado en el disco.
- Miremos el final del archivo de texto, de este modo encontramos el identificador (id) de la última línea que se extrajo con éxito.
Comencé a extraer la copia de seguridad en forma de texto:
pg_dump -U my_user -d my_database -F p -t ws_log_smevlog -f ./my_dump.dumpLa extracción de la copia de seguridad, como se esperaba, se interrumpió con el mismo error:
pg_dump: Mensaje de error del servidor: ERROR: página inválida en el bloque 4123007 de la base de datos relation base/16490/21396989 Luego, a través de tail revisé el final de la copia de seguridad (tail -5 ./my_dump.dump) descubrí que la copia se interrumpió en la línea con id 186 525. "Entonces, el problema está en la línea con id 186 526, está corrupta, ¡eso es lo que hay que eliminar!" - pensé. Pero, al hacer una consulta a la base de datos:
«select * from ws_log_smevlog where id=186529resultó que todo estaba bien con esa línea... Las líneas con índices 186 530 — 186 540 también funcionaron sin problemas. Otra "idea brillante" fracasó. Más tarde entendí por qué sucedió esto: al eliminar o modificar datos de la tabla, no se eliminan físicamente, sino que se marcan como "tuplas muertas", luego llega autovacuum y marca esas líneas como eliminadas y permite reutilizar esas líneas. Para entender, si los datos en la tabla cambian y autovacuum está habilitado, entonces no se almacenan de manera continua.
Intento 5: SELECT, FROM, WHERE id=
Los fracasos nos hacen más fuertes. Nunca hay que rendirse, hay que seguir hasta el final y creer en uno mismo y en nuestras capacidades. Por eso decidí intentar una vez más: simplemente revisar todas las entradas en la base de datos una a una. Sabiendo la estructura de mi tabla (ver arriba), tenemos un campo id, que es único (clave primaria). En la tabla tenemos 1 628 991 filas y id van en orden, lo que significa que simplemente podemos revisarlas una por una:
for ((i=1; i /dev/null || echo $i; doneSi alguien no entiende, el comando funciona de la siguiente manera: revisa la tabla línea por línea y envía stdout a /dev/null, pero si el comando SELECT falla, se imprime el texto del error (stderr se envía a la consola) y se imprime la línea que contiene el error (gracias a ||, que indica que hubo problemas con el select (el código de retorno del comando no es 0)).
Tuve suerte, tenía índices creados en el campo id:
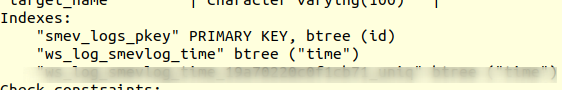
Eso significa que encontrar la línea con el id adecuado no debería tomar mucho tiempo. Teóricamente debería funcionar. Bueno, lanzamos el comando en tmux y nos vamos a dormir.
Por la mañana descubrí que se habían revisado alrededor de 90,000 registros, lo que representa poco más del 5%. ¡Un excelente resultado en comparación con el método anterior (2%)! Pero no quería esperar 20 días...
Intento 6: SELECT, FROM, WHERE id >= and id <
El cliente asignó un excelente servidor para la base de datos: de doble procesador Intel Xeon E5-2697 v2, ¡teníamos nada menos que 48 hilos! La carga en el servidor era promedio, podíamos manejar sin problemas alrededor de 20 hilos. También había suficiente memoria RAM: ¡384 gigabytes!
Por lo tanto, era necesario paralelizar el comando:
for ((i=1; i /dev/null || echo $i; donePodría haber escrito un script bonito y elegante, pero elegí el método más rápido para la paralelización: dividir manualmente el rango de 0 a 1,628,991 en intervalos de 100,000 registros y lanzar 16 comandos del tipo:
for ((i=N; i/dev/null || echo $i; donePero eso no es todo. En teoría, conectar a la base de datos también consume tiempo y recursos del sistema. Conectar 1,628,991 no era muy razonable, ¿no crees? Así que, en una sola conexión, extraigamos 1,000 filas en lugar de una. Al final, el comando quedó así:
for ((i=N; i=$i and id/dev/null || echo $i; doneAbrimos 16 ventanas en una sesión de tmux y lanzamos los comandos:
1) for ((i=0; i=$i and id/dev/null || echo $i; done
2) for ((i=100000; i=$i and id/dev/null || echo $i; done
…
15) for ((i=1400000; i=$i and id/dev/null || echo $i; done
16) for ((i=1500000; i=$i and id/dev/null || echo $i; done
¡Al día siguiente recibí los primeros resultados! A saber (los valores XXX y ZZZ ya no se guardaron):
ERROR: missing chunk number 0 for toast value 37837571 in pg_toast_106070
829000
ERROR: missing chunk number 0 for toast value XXX in pg_toast_106070
829000
ERROR: missing chunk number 0 for toast value ZZZ in pg_toast_106070
146000
Esto significa que tenemos tres filas que contienen un error. El id del primer y segundo registro problemático se encontraban entre 829,000 y 830,000, el id del tercero – entre 146,000 y 147,000. A continuación, simplemente teníamos que encontrar el valor exacto del id de los registros problemáticos. Para ello, revisamos nuestro rango con registros problemáticos paso a paso y identificamos el id:
for ((i=829000; i/dev/null || echo $i; done
829417
ERROR: número de fragmento inesperado 2 (se esperaba 0) para el valor toast 37837843 en pg_toast_106070
829449
for ((i=146000; i/dev/null || echo $i; done
829417
ERROR: número de fragmento inesperado ZZZ (se esperaba 0) para el valor toast XXX en pg_toast_106070
146911
Final feliz
Hemos encontrado líneas problemáticas. Accedemos a la base de datos a través de psql e intentamos eliminarlas:
my_database=# delete from ws_log_smevlog where id=829417;
DELETE 1
my_database=# delete from ws_log_smevlog where id=829449;
DELETE 1
my_database=# delete from ws_log_smevlog where id=146911;
DELETE 1
Para mi sorpresa, los registros se eliminaron sin problemas, incluso sin la opción zero_damaged_pages.
Luego me conecté a la base, hice VACUUM FULL (creo que no era necesario hacerlo), y, finalmente, pude hacer una copia de seguridad con éxito utilizando pg_dump. ¡La copia de seguridad se realizó sin ningún error! El problema se logró resolver de esta manera tan simple. ¡La alegría fue inmensa, después de tantos fracasos encontré una solución!
Agradecimientos y conclusión
Así fue como resultó mi primera experiencia recuperando una base de datos real de Postgres. Esta experiencia la recordaré por mucho tiempo.
Y por último, me gustaría agradecer a la empresa PostgresPro por la documentación traducida al ruso y por , que me ayudaron muchísimo durante el análisis del problema.
Fuente: habr.com
