

La creación del sistema de monitoreo fue una idea que surgió en la etapa de formación de los equipos de producto. Se hizo evidente que nuestras operaciones no estaban integradas en esos equipos. ¿Por qué es así?
La cuestión es que todos nuestros equipos están organizados en torno a sistemas de información individuales, microservicios y frontends, por lo que el estado general de salud del sistema completo no es visible para ellos. Por ejemplo, pueden no estar al tanto de cómo una pequeña parte en el backend profundo afecta a la parte frontal. Su interés se limita a los sistemas con los que su sistema está integrado. Si el equipo y su servicio A no tienen prácticamente ninguna conexión con el servicio B, entonces este último es prácticamente invisible para el equipo.
Nuestro equipo, por su parte, trabaja con sistemas que están muy integrados entre sí: existen numerosas conexiones entre ellos, es una infraestructura bastante grande. Y el funcionamiento de todas estas sistemas (de los cuales, por cierto, tenemos una gran cantidad) depende del funcionamiento de la tienda en línea.
Así que resulta que nuestro departamento no forma parte de ningún equipo y se encuentra un poco al margen. En toda esta historia, nuestra tarea es entender en su conjunto cómo funcionan los sistemas de información, su funcionalidad, integraciones, software, red, hardware, y cómo todo esto se relaciona entre sí.
La plataforma sobre la que operan nuestras tiendas en línea se ve así:
- front
- middle-office
- back-office
Por mucho que nos gustaría, no hay manera de que todos los sistemas funcionen de manera fluida y perfecta. Esto se debe, nuevamente, a la cantidad de sistemas e integraciones; con un entorno como el nuestro, algunos incidentes son inevitables, a pesar de la calidad de las pruebas. Esto se aplica tanto a cualquier sistema individual como a su integración. Y es necesario monitorear el estado de toda la plataforma de manera integral, no solo de alguna de sus partes.
Idealmente, la vigilancia del estado de salud de toda la plataforma debería automatizarse. Y hemos llegado a considerar el monitoreo como una parte inevitable de este proceso. Inicialmente, se construyó solamente para la parte frontal, mientras que los propios sistemas de monitoreo por capas existían y existen para los equipos de redes, administradores de software y hardware. Todas estas personas monitoreaban solo en su nivel, y no había un entendimiento integral.
Por ejemplo, si una máquina virtual cae, en la mayoría de los casos solo lo sabe el administrador responsable del hardware y de la máquina virtual. El equipo de frontend, en tales casos, vio solo el hecho de que la aplicación había caído, pero no tenía datos sobre la caída de la máquina virtual. Además, el administrador puede saber quién es el cliente y tener una idea de lo que está ocurriendo en esa máquina virtual, siempre que se trate de un proyecto grande. Probablemente no sepa nada sobre proyectos pequeños. En cualquier caso, el administrador necesita acudir al propietario para preguntar qué había en esa máquina, qué necesita ser restaurado y qué debe ser cambiado. Y si algo serio estaba fallando, comenzaba una carrera en círculo, porque nadie veía el sistema en su conjunto.
En última instancia, estas historias dispares afectan a todo el frontend, a los usuarios y a nuestra función comercial principal: las ventas en línea. Dado que no formamos parte de los equipos y nos ocupamos de la operación de todas las aplicaciones de comercio electrónico dentro de la tienda en línea, asumimos la tarea de crear un sistema integral de monitoreo para la plataforma de comercio electrónico.
Estructura del sistema y stack
Comenzamos por identificar varias capas de monitoreo para nuestros sistemas, en torno a las cuales necesitaremos recopilar métricas. Y todo esto debía integrarse, lo que hicimos en la primera etapa. Ahora en esta fase estamos refinando la recolección de métricas de la mejor calidad en todas nuestras capas, para establecer correlaciones y entender cómo los sistemas influyen entre sí.
La falta de un monitoreo integral en las etapas iniciales del lanzamiento de aplicaciones (ya que comenzamos a construirlo cuando la mayoría de los sistemas ya estaban en operación) resultó en una carga técnica significativa relacionada con la configuración del monitoreo de toda la plataforma. No podíamos permitirnos enfocarnos en la configuración de monitoreo de un solo sistema de información y trabajar en detalle en su monitoreo, ya que los demás sistemas quedarían sin monitoreo por un tiempo. Para abordar este problema, definimos una lista de métricas esenciales para evaluar el estado del sistema de información por capas y comenzamos a implementarlas.
Por lo tanto, decidimos abordar el problema poco a poco.
Nuestro sistema consta de:
- hardware;
- sistema operativo;
- software;
- Partes de la interfaz de la aplicación de monitoreo;
- métricas empresariales;
- aplicaciones de integración;
- seguridad de la información;
- redes;
- equilibrador de carga.
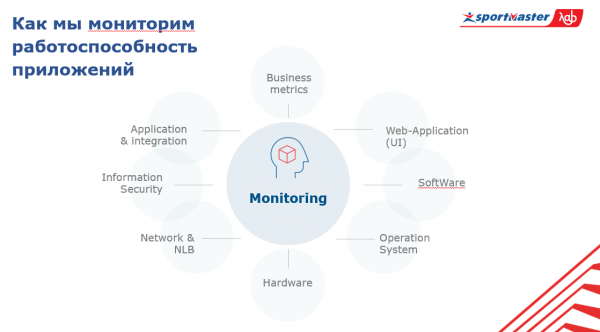
En el centro de este sistema está el monitoreo en sí. Para comprender el estado general del sistema, es necesario saber qué está sucediendo con las aplicaciones en todos estos niveles y en el contexto de la multitud de aplicaciones.
Así que, acerca de la pila.
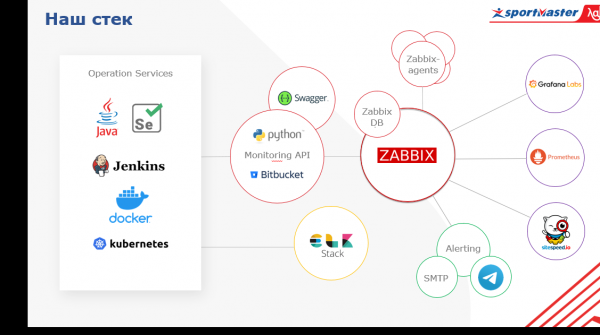
Utilizamos software de código abierto. En el centro tenemos Zabbix, que utilizamos principalmente como sistema de alertas. Es bien sabido que es ideal para monitorear la infraestructura. ¿Qué significa esto exactamente? Se refiere a las métricas de bajo nivel que tiene cada empresa que tiene su propio centro de datos (y Sportmaster tiene sus propios centros de datos): temperatura del servidor, estado de la memoria, del RAID, métricas de dispositivos de red.
Hemos integrado Zabbix con el mensajero Telegram y Microsoft Teams, que son ampliamente utilizados en los equipos. Zabbix cubre la capa de la red real, hardware y parcialmente software, pero esto no es una panacea. Enriquecemos estos datos con algunos otros servicios. Por ejemplo, en lo que respecta al hardware, nos conectamos directamente a través de la API en nuestro sistema de virtualización y recuperamos datos.
Además de Zabbix, utilizamos Prometheus, que permite monitorear las métricas en aplicaciones de entornos dinámicos. Es decir, podemos obtener métricas de la aplicación a través del endpoint HTTP y no preocuparnos sobre qué métricas incluir y cuáles no. Con base en estos datos, podemos formular consultas analíticas.
Las fuentes de datos para las demás capas, por ejemplo, las métricas empresariales, se dividen en tres componentes.
En primer lugar, son sistemas empresariales externos, Google Analytics, de donde recopilamos métricas de los registros. De ellos obtenemos datos sobre usuarios activos, conversiones y todo lo relacionado con el negocio. En segundo lugar, está el sistema de monitoreo UI, del cual deberíamos hablar más en detalle.
En un principio, comenzamos con pruebas manuales y evolucionaron hacia pruebas automáticas de funcionalidad e integraciones. A partir de esto, creamos el monitoreo, manteniendo solo la funcionalidad principal, y nos vinculamos a marcadores que son lo más estables posible y no cambian con frecuencia con el tiempo.
La nueva estructura de equipos implica que toda la actividad relacionada con las aplicaciones se centraliza en equipos de producto, por lo que hemos dejado de realizar pruebas puras. En su lugar, transformamos las pruebas en un monitoreo de UI, escrito en Java, Selenium y Jenkins (que se usa como sistema de lanzamiento y generación de informes).
Teníamos muchas pruebas, pero al final decidimos enfocarnos en la vía principal, la métrica de alto nivel. Y si tuviéramos muchas pruebas específicas, sería complicado mantener la actualidad de los datos. Cada lanzamiento subsiguiente rompería significativamente todo el sistema y solo nos dedicaríamos a repararlo. Por lo tanto, hemos quedado centrados en aspectos completamente fundamentales que cambian raramente y solo monitoreamos esos.
Finalmente, en tercer lugar, la fuente de datos es un sistema de registro centralizado. Para los registros utilizamos Elastic Stack, y luego podemos arrastrar esos datos a nuestro sistema de monitoreo de métricas empresariales. Además de todo esto, funciona nuestro propio servicio Monitoring API, escrito en Python, que interroga a través de API cualquier servicio y recopila datos en Zabbix.
Otro atributo indispensable del monitoreo es la visualización. La nuestra se construye sobre Grafana. Entre otros sistemas de visualización, se destaca porque en el dashboard se pueden visualizar métricas de diferentes fuentes de datos. Podemos reunir métricas de alto nivel de la tienda online, por ejemplo, el número de pedidos realizados en la última hora de la base de datos, métricas de rendimiento del sistema operativo en el que se ejecuta esta tienda en línea, de Zabbix, y métricas de las instancias de esta aplicación, de Prometheus. Y todo esto estará en un solo dashboard. Claramente y accesiblemente.
Quiero mencionar la seguridad: actualmente estamos mejorando el sistema, que posteriormente integraremos con el sistema de monitoreo global. En mi opinión, los principales problemas que enfrenta el comercio electrónico en el ámbito de la seguridad de la información están relacionados con bots, raspadores y ataques de fuerza bruta. Es necesario supervisar esto, ya que todo esto puede afectar críticamente tanto el funcionamiento de nuestras aplicaciones como la reputación desde el punto de vista empresarial. Y con la pila seleccionada, estamos cubriendo estas tareas con éxito.
Otro aspecto importante es que el nivel de aplicaciones se recopila por Prometheus. También está integrado con Zabbix. Además, tenemos sitespeed, un servicio que nos permite ver parámetros como la velocidad de carga de nuestra página, cuellos de botella, renderizado de la página, carga de scripts, entre otros, que también está integrado por API. Así que las métricas se recopilan en Zabbix, y también generamos alertas desde allí. Todas las alertas se envían por los métodos principales (por ahora, email y telegram, y recientemente conectamos MS Teams). Estamos planeando mejorar el sistema de alertas para que los bots inteligentes funcionen como un servicio y proporcionen información sobre monitoreo a todos los equipos de producto interesados.
Nos importan las métricas no solo de sistemas informáticos individuales, sino también métricas generales de toda la infraestructura que utilizan las aplicaciones: clústeres servidores físicos, donde se ejecutan máquinas virtuales, equilibradores de carga, Network Load Balancers, la red misma, la utilización de los canales de comunicación. Además, tenemos métricas sobre nuestros propios centros de datos (tenemos varios y la infraestructura es bastante extensa).
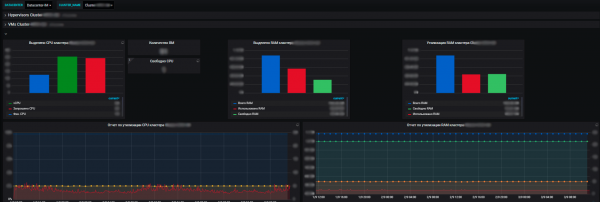
Las ventajas de nuestro sistema de monitoreo son que, a través de él, podemos ver el estado operativo de todos los sistemas, podemos evaluar cómo influyen unos en otros y en los recursos generales. Y, en última instancia, permite la planificación de recursos, que también es parte de nuestra responsabilidad. Gestionamos los recursos del servidor: un pool en el marco del comercio electrónico, introducimos y retiramos de explotación nuevo equipo, compramos nuevo, realizamos auditorías de utilización de recursos, entre otros. Cada año, los equipos planifican nuevos proyectos y desarrollan sus sistemas, y es importante para nosotros proporcionarles recursos.
Y a través de métricas vemos la tendencia de consumo de recursos por nuestros sistemas informáticos. Y ya en base a eso, podemos planificar. A nivel de virtualización, recopilamos datos y vemos información sobre la cantidad de recursos disponibles en términos de centros de datos. Y ya dentro del centro de datos se puede ver tanto la utilización como la distribución y consumo real de recursos. Esto abarca tanto servidores independientes como máquinas virtuales y clústeres de servidores físicos, donde todas estas máquinas virtuales funcionan con agilidad.
Perspectivas
Actualmente tenemos el núcleo del sistema en general, pero todavía hay varios aspectos en los que necesitamos trabajar. Al menos, esto incluye la capa de seguridad de la información, pero también es importante abordar la red, desarrollar la alerta y resolver el tema de la correlación. Tenemos muchas capas y sistemas, y en cada capa hay muchas métricas. Es como una matrioshka a la potencia de una matrioshka.
Nuestra tarea es, en última instancia, hacer las alertas correctas. Por ejemplo, si hay un problema con el hardware, de nuevo, con la máquina virtual, y allí había una aplicación importante, y el servicio no estaba reservado de ninguna manera. Nos enteraremos de que la máquina virtual ha fallado. Luego se generarán alertas sobre métricas de negocio: los usuarios han desaparecido, no hay conversiones, la interfaz de usuario no está disponible, el software y los servicios también han fallado.
Con este escenario recibiremos spam de alertas, y eso ya no se ajusta al formato de un sistema de monitoreo adecuado. Surge la cuestión de la correlación. Por lo tanto, idealmente, nuestro sistema de monitoreo debería decir: "Chicos, su máquina física ha fallado, y junto con ella, esta aplicación y estas métricas", con una sola alerta en lugar de inundarnos con cientos de alertas. Debe comunicar lo principal: la causa, lo que facilita la rápida resolución del problema gracias a su localización.
Nuestro sistema de avisos y el tratamiento de alertas está construido en torno a un servicio de línea directa que opera las 24 horas. Todas las alertas que consideramos imprescindibles y que están en la lista de verificación se envían allí. Cada alerta debe tener necesariamente una descripción: qué ocurrió, qué significa, a qué afecta. Además, debe incluir un enlace al panel de control y una instrucción sobre qué hacer en este caso.
Eso es todo lo que respecta a los requisitos para la construcción de alertas. Luego, la situación puede desarrollarse en dos direcciones: o hay un problema que necesita ser resuelto, o ha ocurrido una falla en el sistema de monitoreo. Pero en cualquier caso, hay que investigar y resolver.
Actualmente, en promedio, recibimos alrededor de un centenar de alertas por día, considerando que la correlación de alertas aún no está configurada adecuadamente. Y si necesitamos realizar trabajos técnicos y desactivamos algo manualmente, su número se multiplica por varios.
Además de la monitorización de los sistemas que explotamos y la recopilación de métricas que consideramos importantes, el sistema de monitoreo permite recopilar datos para los equipos de productos. Ellos pueden influir en la composición de las métricas dentro de los sistemas de información que supervisamos.
Un colega puede venir y pedir que añadamos alguna métrica que sea útil tanto para nosotros como para el equipo. O, por ejemplo, el equipo puede sentir que las métricas básicas que tenemos no son suficientes, y necesitan rastrear algo específico. En Grafana, creamos un espacio para cada equipo y otorgamos derechos de administrador. Además, si el equipo necesita tableros, pero no puede o no sabe cómo hacerlo, les ayudamos.
Como estamos fuera del flujo de generación de valor del equipo, sus lanzamientos y planificación, poco a poco llegamos a que los lanzamientos de todos los sistemas sean continuos y se puedan desplegar diariamente sin necesidad de coordinación con nosotros. Para nosotros es importante rastrear estos lanzamientos, porque potencialmente pueden afectar el funcionamiento de la aplicación y romper algo, lo cual es crítico. Para gestionar los lanzamientos, utilizamos Bamboo, desde donde obtenemos datos a través de API y podemos ver qué lanzamientos han salido en qué sistemas de información y su estado. Y lo más importante, a qué hora. Marcamos los lanzamientos en las métricas críticas principales, lo que visualmente es bastante indicativo en caso de problemas.
De esta manera, podemos ver la correlación entre los nuevos lanzamientos y los problemas que surgen. La idea principal es entender cómo funciona el sistema en todos los niveles, localizar rápidamente el problema y resolverlo igualmente rápido. A menudo, se pierde más tiempo no en resolver el problema, sino en buscar la causa.
En este sentido, queremos centrarnos en la proactividad en el futuro. Idealmente, nos gustaría conocer de antemano los problemas que se avecinan, en lugar de hacerlo después, para poder prevenirlos en lugar de resolverlos. A veces, el sistema de monitoreo puede dar falsas alarmas, ya sea por error humano o por cambios en la aplicación. Estamos trabajando en esto, afinando el sistema y tratando de advertir a los usuarios que lo utilizan junto con nosotros sobre cualquier manipulación que se realice en el sistema de monitoreo, o realizando estas actividades en horarios de mantenimiento.
Así que el sistema ha sido lanzado y ha estado funcionando con éxito desde principios de primavera... y está mostrando un beneficio bastante real. Por supuesto, esta no es su versión final, seguiremos implementando muchas más funcionalidades. Pero en este momento, con la gran cantidad de integraciones y aplicaciones, la automatización del monitoreo es realmente indispensable.
Si tú también monitoreas grandes proyectos con un número significativo de integraciones, comparte en los comentarios cuál es la 'bala de plata' que encontraste para esto.
Fuente: habr.com
