

Nuestra empresa se dedica desde 2008 principalmente a la gestión de infraestructuras y al soporte técnico 24/7 de proyectos web: tenemos más de 400 clientes, alrededor del 15% del comercio electrónico en Rusia. Por lo tanto, el soporte implica una arquitectura muy diversa. Si algo falla, tenemos la obligación de repararlo en 15 minutos. Pero para entender que ha ocurrido una avería, es necesario monitorear el proyecto y reaccionar ante los incidentes. ¿Y cómo se hace esto?
Considero que en la organización de un sistema de monitoreo adecuado se producen problemas. Si no hubiera problemas, entonces mi discurso consistiría en un solo punto: «Por favor, instalen Prometheus + Grafana y los complementos 1, 2, 3». Desafortunadamente, ahora no funciona así. Y el principal problema es que todos siguen creyendo en algo que existía en 2008, desde el punto de vista de los componentes de software.
En relación con la organización del sistema de monitoreo, me atrevería a decir que... no existen proyectos con un monitoreo adecuado. La situación es tan mala que si algo cae, existe el riesgo de que pase desapercibido; todos creen que «todo está siendo monitoreado».
Puede que todo esté siendo monitoreado. Pero, ¿cómo?
Todos hemos enfrentado una historia similar a la siguiente: trabaja un devops, un admin, y llega el equipo de desarrolladores y dice: «Hemos lanzado, ahora monitores». ¿Qué monitorar? ¿Cómo funciona esto?
Está bien. Monitorizamos a la antigua. Pero ya ha cambiado y resulta que estabas monitoreando el servicio A, que se convirtió en el servicio B, que interactúa con el servicio C. Pero el equipo de desarrolladores te dice: «Instala el software, ¡se supone que debe monitorearlo todo!»
¿Entonces, qué ha cambiado? — ¡Todo ha cambiado!
Año 2008. Todo es perfecto.
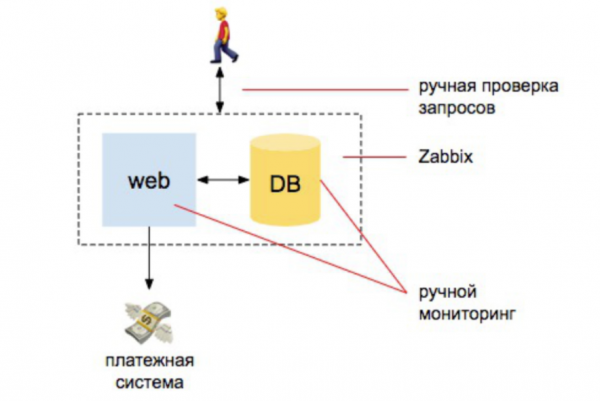
Hay un par de desarrolladores, un servidor, un servidor de base de datos. Todo comienza aquí. Tenemos cierta información, instalamos zabbix, Nagios, cacti. Y luego configuramos alertas claras para la CPU, el funcionamiento de los discos, el espacio en los discos. También hacemos un par de comprobaciones manuales para asegurarnos de que el sitio responde, que los pedidos llegan a la base de datos. Y eso es todo: estamos más o menos protegidos.
Si comparamos la cantidad de trabajo que hacía el administrador para asegurar el monitoreo, el 98% era automático: la persona encargada del monitoreo debe entender cómo instalar Zabbix, configurarlo y ajustar las alertas. Y el 2% son verificaciones externas: que el sitio responde y hace consultas a la base de datos, que han llegado nuevos pedidos.
Año 2010. Aumenta la carga
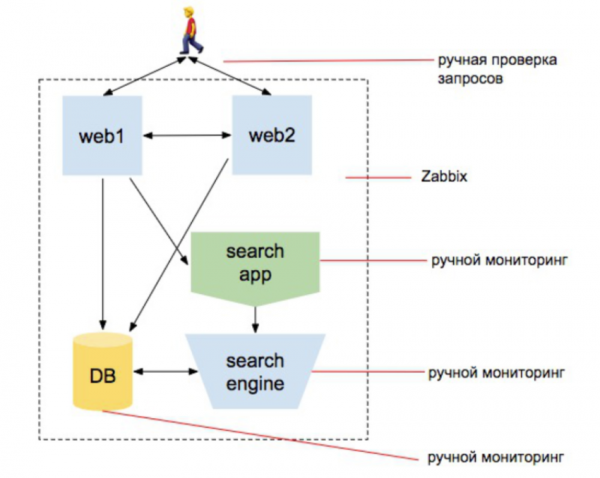
Comenzamos a escalar los webs, agregamos un motor de búsqueda. Queremos estar seguros de que el catálogo de productos incluye todos los artículos. Y que la búsqueda de productos funciona. Que la base de datos está operativa, que se están realizando pedidos, que el sitio responde externamente y responde desde dos servidores y el usuario no es expulsado del sitio mientras se rebalancea en otro servidor, etc. Las entidades están aumentando.
Y la entidad relacionada con la infraestructura sigue siendo la más importante en la mente del gerente. Aún persiste la idea de que la persona encargada del monitoreo es quien instala Zabbix y puede configurarlo.
Sin embargo, surgen tareas relacionadas con la realización de verificaciones externas, la creación de un conjunto de scripts para las consultas del indexador de búsqueda, un conjunto de scripts para verificar que la búsqueda cambia durante el proceso de indexación, un conjunto de scripts que comprueban que los productos se entregan al servicio, etc.
Nota: he escrito "conjunto de scripts" tres veces. Es decir, la persona responsable del monitoreo ya no es solo quien instala Zabbix. Es alguien que comienza a programar. Pero en la mente del equipo, nada aún ha cambiado.
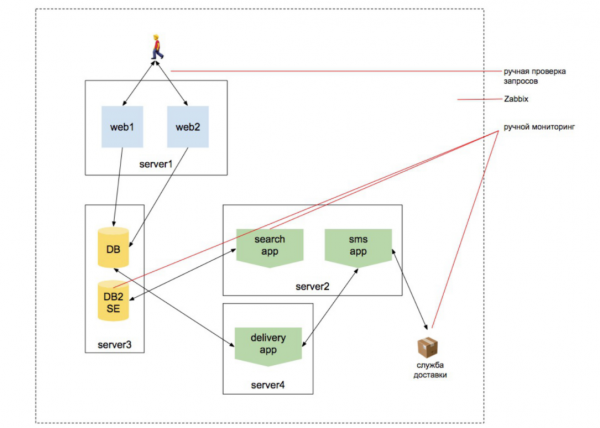
Sin embargo, el mundo cambia, volviéndose cada vez más complejo. Se agrega una capa de virtualización, varios nuevos sistemas. Comienzan a interactuar entre sí. ¿Quién dijo "huele a microservicios?" Pero cada servicio, aún por separado, se ve como un sitio. Podemos acceder a él y entender que proporciona la información necesaria y funciona por sí mismo. Y si eres un administrador que ha estado trabajando en un proyecto que ha evolucionado 5-7-10 años, este conocimiento se acumula: aparece un nuevo nivel, lo asimilas, aparece otro nivel, lo asimilas…
Pero rara vez alguien mantiene un proyecto durante 10 años.
Resumen del monitor de sistema
Supongamos que llegaste a una nueva startup que rápidamente reunió a 20 desarrolladores y escribió 15 microservicios, y tú eres el administrador al que le dicen: "Construye CI/CD. Por favor". Construiste CI/CD y de repente oyes: "Es difícil trabajar con producción en el 'cubo', sin entender cómo funcionará la aplicación allí. Haznos una sandbox en este mismo 'cubo'.
Creas una sandbox en este cubo. Te dicen de inmediato: "Queremos una base de datos de staging que se actualice todos los días desde producción, para entender que funciona en esa base de datos, pero sin estropear la base de datos de producción".
Vives en todo esto. Quedan 2 semanas para el lanzamiento y te dicen: "Ahora debemos monitorear todo esto…" Es decir, monitorear la infraestructura en clúster, monitorear la arquitectura de microservicios, monitorear la interacción con servicios externos…
Y los colegas sacan de la cabeza un esquema familiar y dicen: "¡Pero aquí todo es claro! Instala un programa que lo monitoree todo". Sí, sí: Prometheus + Grafana + plugins.
Y añaden: "Tienes un par de semanas, haz que todo sea confiable".
En un montón de proyectos que vemos, se asigna a una persona para el monitoreo. Imagina que queremos contratar a alguien por 2 semanas para que se ocupe del monitoreo, y le estamos armando su currículum. ¿Qué habilidades debería tener esta persona, considerando todo lo que hemos dicho antes?
- Debería entender el monitoreo y la especificidad del funcionamiento de la infraestructura física.
- Debería comprender la especificidad del monitoreo de Kubernetes (todo el mundo quiere estar en el 'cubo', porque se puede abstraer de todo, esconderse, ya que el administrador se encargará del resto), entender su infraestructura y saber cómo monitorear aplicaciones dentro de ella.
- Debería entender que los servicios se comunican entre sí de maneras particulares, y conocer las especificidades de la interacción entre servicios. Es bastante posible ver un proyecto donde parte de los servicios se comunican de manera sincrónica, porque de otra forma no funciona. Por ejemplo, el backend accede a REST, a gRPC en el servicio de catálogo, obtiene la lista de productos y devuelve. Aquí no se puede esperar. Y con otros servicios trabaja de manera asincrónica. Pasar un pedido al servicio de entrega, enviar un correo, etc.
¿Ya te has perdido con todo esto? Pues el administrador que necesita monitorearlo se ha perdido aún más. - Debe ser capaz de planificar y hacerlo correctamente, ya que el trabajo está aumentando cada vez más.
- Por lo tanto, debe crear una estrategia a partir del servicio creado para entender cómo se puede monitorizar específicamente. Necesita comprender la arquitectura del proyecto y su desarrollo, además de conocer las tecnologías utilizadas en el desarrollo.
Recordemos un caso completamente normal: parte de los servicios en PHP, parte en Go, parte en JS. Trabajan de alguna manera entre sí. De ahí proviene el término "microservicio": se han vuelto tantas las sistemas individuales que los desarrolladores no pueden entender el proyecto en su conjunto. Una parte del equipo crea servicios en JS, que funcionan por sí solos y no saben cómo funciona el resto del sistema. Otra parte desarrolla servicios en Python y no se involucra en cómo funcionan otros servicios, están aislados en su área. Tercera parte: desarrolla servicios en PHP o en algo más.
Estas 20 personas están divididas en 15 servicios, y solo hay un administrador que debe entender todo esto. ¡Espera! Acabamos de dividir el sistema en 15 microservicios, porque 20 personas no pueden comprender todo el sistema.
Sin embargo, hay que monitorizarlo de alguna manera...
¿Cuál es el resultado? Al final, hay una persona que comprende todo lo que no puede entender un equipo entero de desarrolladores, y además debe conocer y manejar lo que hemos señalado antes: la infraestructura del hardware, la infraestructura de Kubernetes, etc.
¿Qué se puede decir aquí... Houston, tenemos un problema.
La monitorización de un proyecto de software moderno es, en sí misma, un proyecto de software.
De la falsa confianza de que la monitorización es solo software, surge la creencia en los milagros. Y los milagros, lamentablemente, no ocurren. No se puede instalar Zabbix y esperar que todo funcione. No tiene sentido poner Grafana y esperar que todo esté bien. La mayor parte del tiempo se dedicará a organizar las verificaciones del funcionamiento de los servicios y su interacción entre sí, además de las verificaciones de cómo funcionan los sistemas externos. De hecho, el 90% del tiempo no se dedicará a escribir scripts, sino al desarrollo de software. Y esto debe hacerlo un equipo que comprenda el funcionamiento del proyecto.
Si en esta situación se deja a una sola persona a cargo de la monitorización, habrá problemas. Y eso es lo que sucede en todas partes.
Por ejemplo, hay varios servicios que se comunican entre sí a través de Kafka. Llega un pedido, enviamos un mensaje sobre el pedido a Kafka. Hay un servicio que escucha la información sobre el pedido y lleva a cabo la entrega del producto. Hay otro servicio que escucha la información sobre el pedido y envía un correo al usuario. Luego surgen otros muchos servicios y comenzamos a confundirnos.
Y si además se lo entregas al administrador y a los desarrolladores en una etapa en la que queda poco tiempo para el lanzamiento, la persona tendrá que entender todo este protocolo. Es decir, un proyecto de tal magnitud toma un tiempo considerable, y esto debe estar contemplado en el desarrollo del sistema.
Sin embargo, muy a menudo, especialmente en las startups, vemos cómo se pospone la monitorización. "Ahora haremos una prueba de concepto, la lanzaremos, que se caiga – estamos dispuestos a sacrificar. Y luego monitorizaremos todo esto". Cuando (o si) el proyecto comienza a generar ingresos, el negocio quiere desarrollar aún más funciones, ¡porque ha comenzado a funcionar, así que hay que seguir avanzando! Y tú te encuentras en un punto en el que al principio necesitas monitorizar todo lo anterior, lo cual no toma el 1% del tiempo, sino significativamente más. Y, por cierto, para la monitorización necesitarás desarrolladores, y es más fácil dedicarles a nuevas funciones. Al final, se desarrollan nuevas funciones, todo se complica, y te encuentras en un deadlock infinito.
Entonces, ¿cómo monitorizar un proyecto desde el principio, y qué hacer si te encuentras con un proyecto que necesita ser monitorizado y no sabes por dónde empezar?
En primer lugar, es necesario planificar.
Una digresión lírica: a menudo se comienza con la monitorización de la infraestructura. Por ejemplo, tenemos Kubernetes. Empezamos instalando Prometheus con Grafana, implementamos complementos para monitorizar los 'cubos'. No solo los desarrolladores, sino también los administradores tienen la lamentable práctica: "Instalamos este complemento y probablemente el complemento sepa cómo hacerlo". A la gente le gusta comenzar con acciones simples y comprensibles, en lugar de con acciones importantes. Y la monitorización de la infraestructura es simplemente eso.
Primero, decide qué y cómo quieres monitorear, y luego elige la herramienta, porque otras personas no pueden pensar por ti. ¿Y deberían? Otras personas pensaron en sí mismas, en un sistema universal, o ni siquiera pensaron cuando escribieron este plugin. Y que este plugin tenga 5000 usuarios no significa que ofrezca algún beneficio. Es posible que tú seas el 5001, simplemente porque ya había 5000 personas antes que tú.
Si comenzaste a monitorear la infraestructura y el backend de tu aplicación dejó de responder, todos los usuarios perderán la conexión con la aplicación móvil. Aparecerá un error. Vendrán a ti y dirán: “La aplicación no funciona, ¿qué están haciendo aquí?” — “Estamos monitoreando.” — “¿Cómo monitorean si no ven que la aplicación no funciona?!”
- Creo que se debe comenzar a monitorear desde el punto de entrada del usuario. Si el usuario no ve que la aplicación funciona, eso es un fracaso. Y el sistema de monitoreo debe alertar de esto en primer lugar.
- Solo entonces podemos monitorear la infraestructura. O hacerlo en paralelo. Con la infraestructura es más sencillo; aquí, finalmente, podemos simplemente instalar Zabbix.
- Ahora necesitamos profundizar en las raíces de la aplicación para entender qué no está funcionando.
Mi idea principal es que el monitoreo debe ir en paralelo con el proceso de desarrollo. Si separas al equipo de monitoreo para otras tareas (creación de CI/CD, sandbox, reorganización de la infraestructura), el monitoreo comenzará a quedarse atrás y tal vez nunca alcances el desarrollo (o tarde o temprano tendrás que detenerlo).
Todo por niveles
Así es como veo la organización del sistema de monitoreo.
1) Nivel de la aplicación:
- monitoreo de la lógica empresarial de la aplicación;
- monitoreo de métricas de salud de los servicios;
- monitoreo de integración.
2) Nivel de infraestructura:
- monitoreo del nivel de orquestación;
- monitoreo del software del sistema;
- monitoreo del nivel de hardware.
3) Nuevamente el nivel de la aplicación, pero ya como producto ingenieril:
- recopilación y observación de registros de la aplicación;
- APM;
- trazado.
4) Alertas:
- organización del sistema de notificación;
- organización del sistema de turnos;
- organización de la 'base de conocimientos' y el flujo de trabajo para el manejo de incidentes.
Importante: ¡Llegamos al alerting no después, sino de inmediato! No hay que iniciar el monitoreo y luego pensar «en algún momento» a quién se le enviarán las alertas. La tarea del monitoreo es entender dónde hay problemas en el sistema y hacer que las personas adecuadas lo sepan. Si se deja para el final, las personas adecuadas solo se darán cuenta de que algo no va bien cuando reciban la llamada de «nada está funcionando en nuestra parte».
Nivel de la aplicación — monitoreo de la lógica del negocio
Aquí se trata de verificar el funcionamiento del aplicativo para el usuario.
Este nivel debe implementarse en la etapa de desarrollo. Por ejemplo, tenemos un Prometheus hipotético: se conecta al servidor que realiza las verificaciones, llama a un endpoint, y ese endpoint verifica el API.
Cuando a menudo se solicita monitorear la página principal para asegurarse de que el sitio está funcionando, los programadores proporcionan un handle que se puede llamar cada vez que se necesita verificar que el API está funcionando. Y en ese momento, los programadores también crean /api/test/helloworld.
¿La única forma de asegurarse de que todo funciona? — ¡No!
- Crear estas verificaciones es, en esencia, tarea de los desarrolladores. Las pruebas unitarias deben ser redactadas por los programadores que escriben el código. Porque, si se lo delegas al administrador con «Oye, aquí tienes la lista de protocolos API de todas las 25 funciones, ¡por favor, monitorea todo!» — no funcionará.
- Si haces print “hello world”, nadie se enterará nunca de que el API debería y realmente funciona. Cada cambio en el API debe conllevar un cambio en las verificaciones.
- Si ya tienes ese problema — detén las características y asigna desarrolladores para que escriban estas verificaciones, o acepta las pérdidas, resignándote a que nada se está chequeando y que se caerá.
Consejos técnicos:
- Asegúrate de organizar un servidor externo para las verificaciones — debes estar seguro de que tu proyecto es accesible para el mundo exterior.
- Organiza la verificación a través de todo el protocolo API, y no solo en endpoints individuales.
- Crea un endpoint de Prometheus con los resultados de las verificaciones.
Nivel de la aplicación — monitoreo de métricas de salud
Ahora se trata de métricas de salud externas de los servicios.
Decidimos que todos los "puntos" de la aplicación se monitorean mediante comprobaciones externas que invocamos desde un sistema de monitoreo externo. Pero estos son precisamente los "puntos" que "ve" el usuario. Queremos asegurarnos de que nuestros servicios estén funcionando. Aquí la historia es mejor: en K8s hay verificaciones de salud para que al menos el mismo "cubito" se convenza de que el servicio funciona. Pero la mitad de las comprobaciones que he visto son simplemente un `print` de "hola mundo". Es decir, él lo invoca una vez después del despliegue, recibe la respuesta de que todo está bien, y ya. Y, si un servicio proporciona su API a través de REST, hay una cantidad enorme de puntos de entrada de esa misma API que también deben ser monitoreados, porque queremos saber que está funcionando. Y lo monitoreamos ya internamente.
Cómo implementar esto correctamente desde el punto de vista técnico: cada servicio publica un endpoint sobre su estado actual de operatividad, y en los gráficos de Grafana (o cualquier otra aplicación) vemos el estado de todos los servicios.
- Cada cambio en la API debe conllevar un cambio en las comprobaciones.
- Cree el nuevo servicio inmediatamente con métricas de salud.
- El administrador puede acercarse a los desarrolladores y pedirles que "añadan un par de funciones para que yo entienda todo y pueda agregar esta información a mi sistema de monitoreo". Pero los desarrolladores normalmente responden: "No vamos a añadir nada dos semanas antes del lanzamiento".
Deje que los gerentes de desarrollo sepan que habrá tales pérdidas, y que la dirección de los gerentes de desarrollo también lo sepa. Porque, cuando todo falle, alguien llamará y exigirá monitorear el "servicio que cae constantemente" (c). - Por cierto, asignen desarrolladores para escribir plugins para Grafana; eso será una gran ayuda para los administradores.
Nivel de aplicación — Monitoreo integrador
El monitoreo integrador se centra en la supervisión de la comunicación entre sistemas críticos para el negocio.
Por ejemplo, hay 15 servicios que se comunican entre sí. Ya no son sitios separados. Es decir, no podemos invocar un servicio en particular, obtener /helloworld y entender que el servicio está funcionando. Porque el servicio de gestión de pedidos debe enviar la información del pedido a un bus — desde el bus, el servicio de gestión de inventarios debe recibir ese mensaje y trabajar con él. Y el servicio de envío de correos electrónicos debe procesarlo de alguna manera, etc.
Por lo tanto, no podemos entender simplemente interactuando con cada servicio, cómo está funcionando todo. Porque tenemos un tipo de bus a través del cual todo se comunica e interactúa.
Este paso debe simbolizar la etapa de prueba de los servicios en interacción con otros servicios. No se puede establecer un monitoreo solo del broker de mensajes y esperar monitorear la comunicación. Si hay un servicio que emite datos y otro que los recibe, al monitorear el broker solo veremos los datos que circulan de un lado a otro. Incluso si logramos monitorear de alguna manera esta interacción de datos —que un productor publica datos, alguien los lee, y el flujo sigue en Kafka—, eso todavía no nos proporcionará información si un servicio envió un mensaje en una versión y el otro no esperaba esa versión y lo perdió. No lo sabremos, ya que los servicios nos dirán que todo funciona.
Recomiendo hacer lo siguiente:
- Para comunicación sincrónica: el endpoint realiza solicitudes a los servicios relacionados. Es decir, tomamos este endpoint, ejecutamos un pequeño script dentro del servicio que revisa todos los puntos y dice: 'puedo consultar aquí, y puedo consultar allá, puedo consultar…'
- Para comunicación asincrónica: mensajes entrantes — el endpoint revisa el bus en busca de mensajes de prueba y emite un estado de procesamiento.
- Para comunicación asincrónica: mensajes salientes — el endpoint envía mensajes de prueba al bus.
Como suele suceder: tenemos un servicio que envía datos al bus. Vamos a este servicio y pedimos que nos informe sobre su salud de integración. Si el servicio debe producir un mensaje hacia adelante (WebApp), entonces produce este mensaje de prueba. Y si estamos llamando al servicio en el lado de OrderProcessing, primero publica lo que puede publicar de forma independiente, y si hay cosas dependientes, lee del bus un conjunto de mensajes de prueba, entiende qué puede procesar, lo comunica y, si es necesario, los publica más adelante, y de eso nos dice: 'todo está bien, estoy vivo.'
A menudo escuchamos la pregunta “¿cómo podemos probar esto con datos de producción?”. Por ejemplo, se refiere al servicio de pedidos. El pedido envía mensajes al almacén, donde se descuentan los productos: ¡no podemos probar esto con datos reales, porque “¡se me descontarán los productos!”. La solución: en la etapa inicial, planifique toda esta prueba. Ya tiene pruebas unitarias que realizan simulaciones. Así que hágalo en un nivel más profundo, donde haya un canal de comunicación que no dañe la operación del negocio.
Nivel de infraestructura
El monitoreo de infraestructura se considera desde hace tiempo como el monitoreo en sí.
- El monitoreo de infraestructura se puede y debe iniciar como un proceso separado.
- No se debe comenzar con el monitoreo de infraestructura en un proyecto en funcionamiento, incluso si se tiene muchas ganas. Este es un problema para todos los DevOps. “Primero monitorearé el clúster, monitorearé la infraestructura”, es decir, primero monitoreará lo que está por debajo, y no se adentrará en la aplicación. Porque la aplicación es algo confuso para el DevOps. Se lo entregaron y no entiende cómo funciona. Pero él entiende la infraestructura y comienza por ahí. Pero no, siempre se debe monitorear primero la aplicación.
- No exageres con la cantidad de alertas. Dada la complejidad de los sistemas modernos, las alertas llegan constantemente, y uno tiene que lidiar con esta montaña de alertas. Una persona de guardia, al ver un centenar de alertas, decidirá “no quiero pensar en esto”. Las alertas deben notificar solo sobre cosas críticas.
Nivel de aplicación como unidad de negocio
Puntos clave:
- ELK. Este es el estándar industrial. Si por alguna razón no está agregando logs, comience a hacerlo urgentemente.
- APM. APM externos como una forma rápida de cerrar el monitoreo de la aplicación (NewRelic, BlackFire, Datadog). Puede implementar temporalmente esta herramienta para entender, aunque sea un poco, lo que está ocurriendo.
- Trazado. En decenas de microservicios, debe trazar todo, porque una solicitud ya no vive por sí sola. Es muy difícil añadirlo después, por lo que es mejor planificar el trazado en el desarrollo desde el principio: es trabajo y herramienta para los desarrolladores. Si aún no lo ha implementado, ¡impleméntelo! Ver Jaeger/Zipkin.
Alerting
- Organización del sistema de alertas: en un entorno de monitoreo de múltiples elementos, debe existir un sistema unificado para el envío de alertas. Se puede utilizar Grafana. En Occidente, todos utilizan PagerDuty. Las alertas deben ser claras (por ejemplo, de dónde provienen…). Y es deseable controlar que las alertas realmente lleguen.
- Organización del sistema de guardias: las alertas no deben llegar a todos (de lo contrario, todos reaccionarán en grupo o nadie reaccionará). Los desarrolladores también deben estar en la lista de guardias: asegúrese de definir claramente las áreas de responsabilidad, elabore instrucciones precisas y especifique a quién contactar el lunes y el miércoles, y a quién el martes y el viernes (de lo contrario, nadie llamará incluso ante una gran emergencia; temerán despertar a otros: a la gente no le gusta llamar y molestar a los demás, especialmente por la noche). Y explique que pedir ayuda no es un signo de incompetencia ("si pido ayuda, eso significa que soy un mal trabajador"), fomente las solicitudes de ayuda.
- Organización de la "base de conocimientos" y flujo de trabajo para el manejo de incidentes: para cada incidente serio, se debe planificar un post-mortem; como medida temporal, deben registrarse las acciones que resuelvan el incidente. Además, establezca la práctica de que las alertas recurrentes son un pecado; deben solucionarse en el código o en el trabajo de infraestructura.
Stack tecnológico
Imaginemos que nuestra pila es la siguiente:
- recopilación de datos — Prometheus + Grafana;
- análisis de logs — ELK;
- para APM o trazabilidad — Jaeger (Zipkin).

La elección de las opciones no es crítica. Porque, si al principio entendió cómo monitorear el sistema y elaboró un plan, luego comenzará a seleccionar herramientas según sus requisitos. La cuestión es qué eligió monitorear al principio. Porque, posiblemente, la herramienta que escogió al principio no se adapta a sus necesidades.
Algunos puntos técnicos que he observado últimamente:
¡Prometheus se está integrando en Kubernetes — ¿quién fue el que pensó en esto?! Si su clúster falla, ¿qué hará? Si tiene un clúster complejo en su interior, debe haber algún sistema de monitoreo dentro del clúster, y otro externo que recoja datos de dentro del clúster.
Dentro del clúster estamos recogiendo logs y todo lo demás. Pero el sistema de monitoreo debe estar externo. Muy a menudo en un clúster donde hay Prometheus, que se instaló internamente, también hay sistemas que realizan verificaciones externas del funcionamiento del sitio. ¿Y si su conexión al mundo exterior se cae y la aplicación no funciona? Así que, internamente todo está bien, pero eso no ayuda a los usuarios.
Conclusiones
- El desarrollo de monitoreo no es la instalación de herramientas, sino el desarrollo de un producto de software. El 98% del monitoreo actual es codificación. Codificación en servicios, codificación de verificaciones externas, verificación de servicios externos, y todo, todo, todo.
- No escatimen tiempo de los desarrolladores en monitoreo: puede llevar hasta el 30% de su trabajo, pero vale la pena.
- DevOps, no se preocupen porque no pueden monitorear algo, porque algunas cosas requieren una mentalidad completamente diferente. Ustedes no eran programadores, y el trabajo de monitoreo es precisamente su trabajo.
- Si el proyecto ya está en funcionamiento y no se ha monitoreado (y ustedes son el gerente) — destinen recursos para el monitoreo.
- Si el producto ya está en producción y ustedes son el DevOps al que le dijeron "configura el monitoreo" — intenten explicar a la dirección lo que he expuesto aquí.
Esta es una versión extendida de la presentación en la conferencia Saint Highload++.
Si están interesados en mis ideas y reflexiones sobre temas de TI y afines, pueden 🙂
Fuente: habr.com
