

Antecedentes
Existen máquinas expendedoras de desarrollo propio. En su interior hay una Raspberry Pi y un poco de cableado en una placa separada. Están conectados un aceptador de monedas, un aceptador de billetes, un terminal bancario… Todo es controlado por un programa hecho a medida. Toda la historia de trabajo se registra en un archivo en una memoria USB (MicroSD), que luego se transmite a través de Internet (con un módem USB) a un servidor, donde se almacena en una base de datos. La información sobre las ventas se carga en 1C, también hay una interfaz web sencilla para monitoreo, etc.
Es decir, el registro es vital — para la contabilidad (ahí están los ingresos, las ventas, etc.), el monitoreo (cualquier fallo y otros imprevistos); esto es, se puede decir, toda la información que tenemos sobre esta máquina.
Problema
Las memorias USB se muestran como dispositivos muy poco fiables. Fallan con una frecuencia notable. Esto conduce a paradas en las máquinas y, si por alguna razón el registro no pudo ser transmitido en línea, a pérdidas de datos.
Esta no es la primera experiencia con memorias USB; antes hubo otro proyecto con más de un centenar de dispositivos, donde el registro se almacenaba en memorias USB, y ahí también hubo problemas de fiabilidad, a veces el número de fallos al mes se contaba por decenas. Se probaron diferentes memorias, incluidas algunas de marcas conocidas con memoria SLC: algunas modelos son más fiables que otros, pero la sustitución de las memorias no resolvió el problema de manera drástica.
¡Atención! ¡Un largo artículo! Si no te interesa el 'por qué' y solo el 'cómo', puedes ir directamente artículo.
Solución
Lo primero que se me ocurre: renunciar a MicroSD, poner, por ejemplo, un SSD y arrancar desde él. Teóricamente es posible, probablemente, pero relativamente caro y no tan fiable (se añade un adaptador USB-SATA; la estadística de fallos de los SSD económicos tampoco es muy alentadora).
Un disco duro USB tampoco parece ser una solución muy atractiva.
Así que llegamos a la siguiente opción: mantener el arranque desde MicroSD, pero utilizarlas en modo de solo lectura, y almacenar el registro de trabajo (y otra información exclusiva para cada dispositivo, como el número de serie, las calibraciones de los sensores, etc.) en otro lugar.
El tema del sistema de archivos en modo solo lectura para Raspberry Pi ya ha sido explorado a fondo, no me detendré en los detalles de implementación en este artículo. (pero si hay interés, quizás escriba un mini-artículo sobre este tema). Hay un punto que merece ser mencionado: tanto por experiencia personal como por los testimonios de quienes ya han implementado la mejora en fiabilidad, es evidente. Sí, es imposible eliminar por completo las averías, pero reducir su frecuencia es absolutamente viable. Además, las tarjetas se estandarizan, lo que simplifica notablemente el reemplazo para el personal de mantenimiento.
Parte de hardware
No hubo dudas especiales sobre la elección del tipo de memoria: NOR Flash.
Argumentos:
- conexión simple (la mayoría de las veces mediante el bus SPI, con el que ya hay experiencia, por lo que no se prevén problemas 'de hardware');
- precio ridículo;
- protocolo de operación estándar (la implementación ya está en el núcleo de Linux, si se desea, se puede usar uno externo que también está disponible, o incluso escribir el propio, ya que todo es simple);
- fiabilidad y recurso:
del típico datasheet: los datos se almacenan durante 20 años, 100,000 ciclos de borrado por cada bloque;
de fuentes externas: una tasa de error extremadamente baja, se postula que no hay necesidad de códigos de corrección de errores (en algunos trabajos se considera ECC para NOR, pero generalmente se refieren a MLC NOR, eso también ocurre).
Vamos a estimar los requerimientos de volumen y recurso.
Quiero garantizar que los datos se mantengan durante varios días. Esto es necesario para que, en caso de algún problema con la conexión, no se pierda el historial de ventas. Vamos a orientarnos a 5 días, en este período (incluso considerando fines de semana y festivos) se puede resolver el problema.
Actualmente acumulamos alrededor de 100kb de registros en un día (3-4 mil entradas), sin embargo, esta cifra va en aumento: se incrementa la detallización, se añaden nuevos eventos. Además, a veces hay picos (algún sensor comienza a enviar alertas falsas, por ejemplo). Calcularemos sobre 10,000 entradas de 100 bytes — un megabyte al día.
En total, se obtienen 5Mb de datos limpios (bien comprimibles). A ellos se suman (estimación grosera) 1Mb de datos de servicio.
Es decir, necesitamos un chip de 8Mb si no utilizamos compresión, o de 4Mb si la usamos. Cifras totalmente realistas para este tipo de memoria.
En cuanto al recurso: si planeamos que la memoria se sobrescriba completamente no más de una vez cada 5 días, durante 10 años de vida útil obtendremos menos de mil ciclos de regrabación.
Recuerden, el fabricante promete cien mil.
Un poco sobre NOR vs NAND
Hoy en día, por supuesto, la memoria NAND es mucho más popular, pero para este proyecto no la utilizaría: NAND, a diferencia de NOR, siempre requiere el uso de códigos de corrección de errores, tablas de bloques defectuosos, etc., y además, las patas de los chips NAND suelen ser bastante más numerosas.
Como desventajas de NOR se pueden mencionar:
- bajo volumen (y, por ende, alto precio por megabyte);
- baja velocidad de intercambio (en gran parte debido a que se utiliza una interfaz secuencial, generalmente SPI o I2C);
- borrado lento (dependiendo del tamaño del bloque, puede tomar desde fracciones de segundo hasta varios segundos).
Parece que no hay nada crítico para nosotros, así que continuemos.
Si te interesan los detalles, se eligió el chip (aunque esto es irrelevante, hay un montón de análogos en el mercado que son compatibles en cuanto a la disposición de pines y el sistema de comandos; incluso si quisiéramos instalar un chip de otro fabricante y/o de otro volumen, funcionará sin necesidad de modificar el código).
Estoy utilizando el controlador incorporado en el núcleo de Linux, en Raspberry gracias al soporte de overlay de device tree es muy sencillo: solo hay que colocar el overlay compilado en /boot/overlays y modificar un poco /boot/config.txt.
Ejemplo de archivo dts
Honestamente, no estoy seguro de que esté escrito sin errores, pero funciona.
/*
 * Device tree overlay for at25 at spi0.1
 */

/dts-v1/;
/plugin/;

/ {
    compatible = "brcm,bcm2835", "brcm,bcm2836", "brcm,bcm2708", "brcm,bcm2709";

    /* disable spi-dev for spi0.1 */
    fragment@0 {
        target = <&spi0>;
        __overlay__ {
            status = "okay";
            spidev@1{
                status = "disabled";
            };
        };
    };

    /* the spi config of the at25 */
    fragment@1 {
        target = <&spi0>;
        __overlay__ {
            #address-cells = <1>;
            #size-cells = <0>;
            flash: m25p80@1 {
                    compatible = "atmel,at25df321a";
                    reg = <1>;
                    spi-max-frequency = <50000000>;

                    /* default to false:
                    m25p,fast-read ;
                    */
            };
        };
    };

    __overrides__ {
        spimaxfrequency = <&flash>,"spi-max-frequency:0";
        fastread = <&flash>,"m25p,fast-read?";
    };
};
Y otra línea en config.txt
dtoverlay=at25:spimaxfrequency=50000000Omitiré la descripción de cómo conectar el chip a Raspberry Pi. Por un lado, no soy un especialista en electrónica, y por otro, aquí todo es bastante sencillo incluso para mí: el chip tiene solo 8 pines, de los cuales necesitamos tierra, alimentación, SPI (CS, SI, SO, SCK); los niveles coinciden con los de Raspberry Pi, no se necesita ninguna conexión adicional: simplemente conectamos los 6 pines mencionados.
Planteamiento del problema
Como suele ser, el planteamiento del problema pasa por varias iteraciones, creo que ya es hora de una nueva. Así que detengámonos, reunamos todo lo que ya se ha escrito y aclaremos los detalles que quedan en la sombra.
Así que hemos decidido que el registro se almacenará en SPI NOR Flash.
Qué es NOR Flash para quienes no lo saben
Es una memoria no volátil que permite realizar tres operaciones:
- Lectura:
La lectura más común: enviamos la dirección y leemos tantos bytes como necesitemos; - Grabación:
La escritura en memoria NOR flash se ve como una normal, pero tiene una peculiaridad: solo se puede cambiar un 1 por un 0, pero no al revés. Por ejemplo, si en nuestra celda de memoria teníamos 0x55, después de escribirle 0x0f ya se almacenará como 0x05. (ver tabla un poco más abajo); - Borrar:
Por supuesto, también necesitamos poder realizar la operación inversa: cambiar un 0 por un 1, y para eso existe la operación de borrado. A diferencia de las dos anteriores, opera no con bytes, sino con bloques (el tamaño mínimo del bloque de borrado en el chip seleccionado es de 4 KB). Borrar destruye todo el bloque en su totalidad y es la única manera de cambiar un 0 por un 1. Por lo tanto, al trabajar con memoria flash, a menudo se deben alinear las estructuras de datos al borde del bloque de borrado.
Escritura en NOR Flash:
Datos binarios
Era
01010101
Escribimos
00001111
Se volvió
00000101
El registro en sí representa una secuencia de entradas de longitud variable. La longitud típica de una entrada es de aproximadamente 30 bytes (aunque a veces hay entradas de varios kilobytes). En este caso, trabajamos con ellos simplemente como un conjunto de bytes, pero, si es interesante, dentro de las entradas se utiliza CBOR.
Además del registro, necesitamos almacenar cierta información de "configuración", tanto actualizada como no: un cierto ID del dispositivo, calibraciones de sensores, una bandera de "dispositivo apagado temporalmente", etc.
Esta información consiste en un conjunto de registros clave-valor, que también se almacenan en CBOR. No tenemos mucha de esta información (máximo unos pocos kilobytes) y no se actualiza con frecuencia.
A partir de ahora la llamaremos contexto.
Si recordamos de dónde comenzó este artículo, es muy importante garantizar la fiabilidad del almacenamiento de datos y, de ser posible, la continuidad del trabajo incluso en caso de fallos de hardware / corrupción de datos.
¿Qué fuentes de problemas se pueden considerar?
- Corte de energía en el momento de las operaciones de escritura / borrado. Esto es de la categoría de 'no hay remedio contra una palanca'.
Información de en stackexchange: al cortar la energía en el momento de trabajar con flash, tanto el borrado (establecimiento en 1), como la escritura (establecimiento en 0) llevan a un comportamiento indefinido: los datos pueden escribirse, escribirse parcialmente (digamos, que enviamos 10 bytes / 80 bits, y se lograron escribir solo 45 bits), no es descartable que parte de los bits quede en un estado 'intermedio' (la lectura puede dar tanto 0 como 1); - Errores de la propia memoria flash.
Aunque la BER es muy baja, no puede ser igual a cero; - Errores en el bus
Los datos transmitidos a través de SPI no están protegidos de ninguna manera; pueden ocurrir tanto errores de bit aislados como errores de sincronización — pérdida o inserción de bits (lo que lleva a distorsiones masivas de datos); - Otros errores/fallos
Errores en el código, 'bugs' de Raspberry, intervención de extraterrestres…
He formulado los requisitos, cuyo cumplimiento considero necesario para garantizar la fiabilidad:
- las grabaciones deben ir directamente a la memoria flash, no se considera la escritura diferida; - si ocurre un error, debe detectarse y manejarse lo antes posible; - el sistema debe restaurar su funcionamiento tras los errores siempre que sea posible.
(un ejemplo de la vida real de 'cómo no debe ser', con el que creo que todos nos hemos encontrado: tras un reinicio inesperado, el sistema de archivos se 'estropeó' y el sistema operativo no arranca)
Ideas, enfoques, reflexiones
Cuando empecé a pensar en esta tarea, me pasaron por la cabeza muchas ideas, por ejemplo:
- utilizar compresión de datos;
- usar estructuras de datos ingeniosas, por ejemplo, almacenar los encabezados de los registros por separado de los propios registros, para que en caso de error en alguno de ellos se puedan leer sin problemas los demás;
- usar campos de bits para controlar la finalización del registro al cortar la alimentación;
- almacenar sumas de verificación para todo y para todos;
- usar alguna variante de codificación de corrección de errores.
Parte de estas ideas se utilizó, y se decidió desechar otras. Vamos por partes.
Compresión de datos
Los propios eventos que registramos en el diario son bastante homogéneos y repetitivos ('lanzamos una moneda de 5 rublos', 'presionamos el botón para recibir el cambio', …). Por lo tanto, la compresión debería resultar bastante efectiva.
Los gastos generales de compresión son insignificantes (tenemos un procesador bastante potente, incluso en el primer Pi había un núcleo con una frecuencia de 700MHz, en los modelos actuales hay varios núcleos con frecuencia superior a un gigahercio), la velocidad de intercambio con el almacenamiento no es alta (varios megabytes por segundo), el tamaño de los registros es pequeño. En general, si la compresión afecta el rendimiento, solo será de manera positiva (absolutamente no crítico, solo lo constato). Además, no tenemos un embedded real, sino un Linux normal, por lo que la implementación no debería requerir mucho esfuerzo (basta con enlazar la biblioteca y usar algunas funciones de ella).
Se tomó una parte del registro de un dispositivo en funcionamiento (1.7 Mb, 70 mil registros) y se verificó inicialmente su compresibilidad utilizando gzip, lz4, lzop, bzip2, xz, zstd que teníamos en la computadora.
- gzip, xz, zstd mostraron resultados similares (40 Kb).
Me sorprendió que el famoso xz se comportara aquí al nivel de gzip o zstd; - lzip con la configuración predeterminada dio un resultado ligeramente peor;
- lz4 y lzop mostraron un resultado no muy bueno (150 Kb);
- bzip2 mostró un resultado sorprendentemente bueno (18 Kb).
Así que los datos se comprimen muy bien.
Así que (si no encontramos defectos fatales) ¡habrá compresión! Simplemente porque se podrá almacenar más datos en la misma memoria flash.
Pensemos en las desventajas.
El primer problema: ya hemos acordado que cada registro debe ir inmediatamente a la memoria flash. Normalmente, un compresor acumula datos del flujo de entrada hasta que decide que es hora de escribir en la salida. Pero nosotros necesitamos obtener inmediatamente un bloque de datos comprimidos y guardarlo en memoria no volátil.
Veo tres caminos:
- Comprimir cada registro usando compresión de diccionario en lugar de los algoritmos mencionados anteriormente.
Es una opción factible, pero no me gusta. Para garantizar un nivel de compresión más o menos aceptable, el diccionario debe estar "ajustado" a los datos específicos, cualquier cambio llevará a que el nivel de compresión caiga drásticamente. Sí, el problema se resuelve creando una nueva versión del diccionario, pero eso es un dolor de cabeza: necesitaremos almacenar todas las versiones del diccionario; en cada registro necesitaremos indicar con qué versión del diccionario fue comprimido… - Comprimir cada registro con algoritmos "clásicos", pero de forma independiente de los demás.
Los algoritmos de compresión considerados no están diseñados para trabajar con registros de este tamaño (decenas de bytes), el coeficiente de compresión será claramente inferior a 1 (es decir, el volumen de datos aumentará en lugar de comprimirse); - Hacer un FLUSH después de cada registro.
En muchas bibliotecas de compresión hay soporte para FLUSH. Este es un comando (o un parámetro para el procedimiento de compresión), que al recibirlo, el compresor forma un flujo comprimido de tal manera que con base en él se pueden reconstruir cargas de trabajo dejarán de funcionar! los datos no comprimidos que ya se han recibido. Tal análogosyncen sistemas de archivos ocommiten sql.
Es importante que las operaciones de compresión posteriores pueden usar el diccionario acumulado y el grado de compresión no se verá tan afectado como en la opción anterior.
Creo que es obvio que elegí la tercera opción, así que nos detendremos en ella más en detalle.
Encontrado sobre FLUSH en zlib.
Hice una prueba basada en un artículo, tomé 70 mil registros de un registro de un dispositivo real, con un tamaño de página de 60Kb (volvemos al tamaño de la página más tarde) recibí:
Datos de entrada
Compresión gzip -9 (sin FLUSH)
zlib con Z_PARTIAL_FLUSH
zlib con Z_SYNC_FLUSH
Tamaño, Kb
1692
40
352
604
A primera vista, el costo de FLUSH parece excesivo, sin embargo, en realidad tenemos una selección limitada: o no comprimir en absoluto, o comprimir (y de manera bastante efectiva) con FLUSH. No olvidemos que tenemos 70 mil registros, la redundancia introducida por Z_PARTIAL_FLUSH es solo de 4-5 bytes por registro. Y el coeficiente de compresión resultó ser casi 5:1, lo cual es más que un excelente resultado.
Puede parecer sorprendente, pero en realidad Z_SYNC_FLUSH es un método más efectivo para hacer FLUSH.
En el caso de usar Z_SYNC_FLUSH, los 4 últimos bytes de cada registro siempre serán 0x00, 0x00, 0xff, 0xff. Y si los conocemos, podemos no almacenarlos, por lo que el tamaño final resulta ser solo 324Kb.
En el artículo al que me refiero, hay una explicación:
Se añade un nuevo bloque de tipo 0 con contenidos vacíos.
Un bloque de tipo 0 con contenidos vacíos consiste en:
- el encabezado de bloque de tres bits;
- 0 a 7 bits iguales a cero, para lograr la alineación de bytes;
- la secuencia de cuatro bytes 00 00 FF FF.
Como es fácil de notar, en el último bloque antes de estos 4 bytes hay entre 3 y 10 bits nulos. Sin embargo, la práctica ha mostrado que los bits nulos son en realidad un mínimo de 10.
Resulta que bloques de datos tan cortos suelen (¿siempre?) codificarse utilizando un bloque de tipo 1 (bloque fijo), que necesariamente termina con 7 bits nulos, por lo que obtenemos entre 10 y 17 bits nulos garantizados (y los demás serán nulos con una probabilidad de alrededor del 50%).
Así que, en los datos de prueba, en el 100% de los casos, antes de 0x00, 0x00, 0xff, 0xff hay un byte nulo, y en más de un tercio de los casos hay dos bytes nulos. (posiblemente, se deba a que estoy usando CBOR binario, y al usar JSON de texto, se encontrarían más bloques de tipo 2 — bloques dinámicos, por lo tanto habría bloques sin bytes nulos adicionales antes de 0x00, 0x00, 0xff, 0xff).
En total, en los datos de prueba existentes se puede comprimirse en menos de 250Kb de datos comprimidos.
Se puede ahorrar un poco más al practicar el malabarismo de bits: ahora estamos ignorando la presencia de varios ceros al final del bloque, varios bits al principio del bloque también permanecen sin cambios...
Pero aquí tomé la decisión de detenerme, de lo contrario, a este ritmo podría llegar a desarrollar mi propio compresor.
En total, de mis datos de prueba obtuve entre 3 y 4 bytes por escritura, la tasa de compresión resultó ser de más de 6:1. Honestamente, no esperaba tal resultado; en mi opinión, todo lo que sea mejor que 2:1 ya justifica el uso de compresión.
Todo está genial, pero zlib (deflate) sigue siendo un algoritmo de compresión un tanto arcaico y un poco anticuado. Solo el hecho de que se utilicen los últimos 32 KB del flujo de datos sin comprimir como diccionario se ve extraño hoy en día (es decir, si algún bloque de datos es muy parecido a lo que estuvo en el flujo de entrada hace 40 KB, empezará a ser comprimido de nuevo, en lugar de hacer referencia a la entrada pasada). En los compresores modernos de moda, el tamaño del diccionario suele medirse en megabytes, no en kilobytes.
Así que continuamos nuestra mini-investigación sobre compresores.
El siguiente fue bzip2 (recuerden, sin FLUSH mostró un grado de compresión fantástico, casi 100:1). Lamentablemente, con FLUSH se comportó muy mal, el tamaño de los datos comprimidos resultó ser mayor que el de los datos sin comprimir.
Mis suposiciones sobre las razones del fracaso
Libbz2 ofrece solo una opción de flush, que parece limpiar el diccionario (análogo a Z_FULL_FLUSH en zlib), no se puede hablar de una compresión efectiva después de esto.
Y el último que probé fue zstd. Dependiendo de los parámetros, comprime ya sea al nivel de gzip, pero mucho más rápido, o mejor que gzip.
Lamentablemente, con FLUSH también se mostró 'no muy bien': el tamaño de los datos comprimidos fue de aproximadamente 700 KB.
Yo en la página del proyecto en github, recibí la respuesta de que se debe considerar hasta 10 bytes de datos de servicio por cada bloque de datos comprimidos, lo que se acerca a los resultados obtenidos; no se logrará superar a deflate.
En este punto decidí detenerme en los experimentos con compresores (recuerden, xz, lzip, lzo, lz4 tampoco mostraron buenos resultados en las pruebas sin FLUSH, y no consideré algoritmos de compresión más exóticos).
Volvemos a los problemas de la archivación.
El segundo problema (como se dice, en orden y no por importancia) es que los datos comprimidos se presentan en un único flujo, en el que constantemente hay referencias a secciones anteriores. Así, al dañar una parte de los datos comprimidos, no solo perdemos el bloque de datos descomprimidos asociado, sino también todos los siguientes.
Hay enfoques para resolver este problema:
- Prevenir la aparición del problema: añadir redundancia a los datos comprimidos que permita identificar y corregir errores; de esto hablaremos más adelante;
- Minimizar las consecuencias en caso de que ocurra un problema
Ya hemos mencionado antes que se pueden comprimir cada bloque de datos de manera independiente, lo que hará que el problema se resuelva por sí mismo (la corrupción de datos de un bloque conducirá a la pérdida de datos solo de ese bloque). Sin embargo, este es un caso extremo, en el que la compresión de datos será ineficaz. El extremo opuesto: usar los 4MB de nuestro chip como un único archivo comprimido, lo que nos dará una excelente compresión, pero consecuencias catastróficas en caso de corrupción de datos.
Sí, se necesita un compromiso en términos de fiabilidad. Pero hay que recordar que estamos desarrollando un formato de almacenamiento de datos para memoria no volátil con un BER extremadamente bajo y un tiempo de retención de datos declarado de 20 años.
En el transcurso de los experimentos, descubrí que las pérdidas de nivel de compresión más o menos notables comienzan en bloques de datos comprimidos de menos de 10KB.
Se mencionó anteriormente que la memoria utilizada tiene una organización paginada; no veo razones para no utilizar la correspondencia "una página - un bloque de datos comprimidos".
Es decir, el tamaño mínimo razonable de una página es de 16KB (con un margen para la información de servicio). Sin embargo, un tamaño de página tan pequeño impone limitaciones significativas al tamaño máximo de los registros.
Aunque por ahora no prevengo registros de más de unos kilobytes en formato comprimido, decidí usar páginas de 32KB (en total, eso significa 128 páginas por chip).
Resumen:
- Los datos los almacenamos comprimidos usando zlib (deflate);
- Para cada registro, establecemos Z_SYNC_FLUSH;
- A cada registro comprimido le recortamos los bytes finales (por ejemplo, 0x00, 0x00, 0xff, 0xff); en el encabezado indicamos cuántos bytes hemos recortado;
- Los datos se almacenan en páginas de 32 KB; dentro de la página hay un flujo continuo de datos comprimidos; en cada página comenzamos la compresión desde cero.
Y, antes de terminar con la compresión, me gustaría señalar que obtenemos solo unos pocos bytes de información comprimida por registro, por lo que es crucial no inflar la información de control; cada byte cuenta aquí.
Almacenamiento de encabezados de datos
Dado que tenemos registros de longitud variable, necesitamos alguna forma de determinar la ubicación/límites de los registros.
Conozco tres enfoques:
- Todos los registros se almacenan en un flujo continuo, primero va el encabezado del registro, que contiene la longitud, y luego el propio registro.
En esta variante, tanto los encabezados como los datos pueden tener longitud variable.
De hecho, tenemos una lista enlazada que se utiliza con frecuencia; - Los encabezados y los registros se almacenan en flujos separados.
Al usar encabezados de longitud fija, logramos que la corrupción de un encabezado no afecte a los demás.
Este enfoque se utiliza, por ejemplo, en muchos sistemas de archivos; - Los registros se almacenan en un flujo continuo, el límite del registro se determina por un marcador (símbolo/secuencia de símbolos que están prohibidos dentro de los bloques de datos). Si dentro de un registro encontramos un marcador, lo sustituimos por una cierta secuencia (lo escapamos).
Este enfoque se utiliza, por ejemplo, en el protocolo PPP.
Lo ilustraré.
Opción 1:
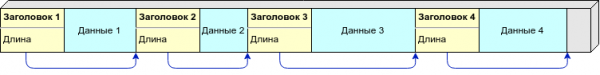
Aquí todo es muy sencillo: sabiendo la longitud del registro, podemos calcular la dirección del siguiente encabezado. Así nos movemos a través de los encabezados hasta que encontramos un área llena de 0xff (área libre) o el final de la página.
Opción 2:
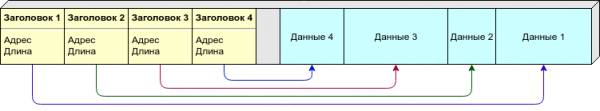
Debido a la longitud variable de los registros, no podemos decir de antemano cuántos registros (y por lo tanto encabezados) necesitaremos en una página. Podemos distribuir los encabezados y los datos en diferentes páginas, pero prefiero otro enfoque: tanto los encabezados (de tamaño fijo) como los datos (de longitud variable) se colocan en una sola página, sin embargo, los encabezados van desde el principio de la página, mientras que los datos van desde el final. Tan pronto como 'se encuentren' (no haya suficiente espacio libre para un nuevo registro) — consideramos que esta página está llena.
Opción 3:

No es necesario almacenar la longitud u otra información sobre la ubicación de los datos en el encabezado; es suficiente con los marcadores que indican los límites de los registros. Sin embargo, los datos deben ser procesados durante la escritura/lectura.
Como marcador, usaría 0xff (que llena la página después de borrar), de esa manera el área libre no se interpretará como datos.
Tabla comparativa:
Opción 1
Opción 2
Opción 3
Resistencia a errores
—
+
+
Compactación
+
—
+
Complejidad de implementación
*
**
**
La opción 1 tiene una desventaja fatal: si se daña alguno de los encabezados, se destruye toda la cadena subsiguiente. Las otras opciones permiten recuperar parte de los datos incluso en caso de daños masivos.
Sin embargo, es pertinente recordar que decidimos almacenar los datos en forma comprimida, así que de todas formas perderemos todos los datos en la página después de un registro "dañado", por lo que aunque haya un menos en la tabla, no lo tenemos en cuenta.
Compactación:
- En la primera opción solo necesitamos almacenar la longitud en el encabezado; si usamos variables de longitud variable, en la mayoría de los casos podemos arreglarnos con un solo byte;
- En la segunda opción necesitamos almacenar la dirección inicial y la longitud; la escritura debe ser de tamaño fijo, lo estimo en 4 bytes por entrada (dos bytes para el desplazamiento y dos bytes para la longitud);
- A la tercera opción le basta con un solo carácter para indicar el inicio de la entrada, más la propia entrada aumentará debido a la escapación en un 1-2%. En general, hay una paridad aproximada con la primera opción.
Inicialmente consideré la segunda opción como la principal (e incluso escribí una implementación). Solo renuncié a ella cuando decidí definitivamente usar compresión.
Puede que en algún momento utilice una opción de este tipo. Por ejemplo, si tuviera que gestionar el almacenamiento de datos para una nave que viaja entre la Tierra y Marte — los requisitos de fiabilidad son muy diferentes, radiación espacial, …
En cuanto a la tercera opción: le di dos estrellas por la dificultad de implementación simplemente porque no me gusta lidiar con la escapación, el cambio de longitud en el proceso, etc. Sí, puede que sea prejuicioso, pero seré yo quien deba escribir el código — ¿por qué obligarme a hacer algo que no me gusta?
Resumen: Elegimos la opción de almacenamiento en forma de cadenas "encabezado con longitud — datos de longitud variable" debido a la eficiencia y simplicidad de implementación.
Uso de campos de bits para controlar el éxito de las operaciones de escritura
Ya no recuerdo dónde vi la idea, pero se ve más o menos así:
Para cada registro, se asignan varios bits para almacenar indicadores.
Como mencionamos anteriormente, después de borrar, todos los bits están llenos de 1, y podemos cambiar 1 a 0, pero no al revés. Así que usamos 1 para 'indicador no establecido' y 0 para 'indicador establecido'.
Así es como puede verse la colocación de un registro de longitud variable en Flash:
- Establecemos el indicador 'la escritura de longitud ha comenzado';
- Escribimos la longitud;
- Establecemos el indicador 'la escritura de datos ha comenzado';
- Escribimos los datos;
- Establecemos el indicador 'la escritura ha terminado'.
Además de esto, tendremos un indicador 'ha ocurrido un error', es decir, 4 indicadores de bits.
En este caso, tenemos dos estados estables '1111' — la escritura no ha comenzado y '1000' — la escritura ha sido exitosa; en caso de una interrupción inesperada del proceso de escritura, obtendremos estados intermedios que luego podremos detectar y manejar.
El enfoque es interesante, pero solo protege contra un corte repentino de energía y fallos similares, lo cual es importante, sin embargo, no es la única (y ni siquiera la principal) causa de posibles fallos.
Resumen: Sigamos adelante en busca de una buena solución.
Sumas de verificación
Las sumas de verificación también permiten asegurarnos (con suficiente probabilidad) de que estamos leyendo exactamente lo que se debería haber grabado. Y, a diferencia de los campos de bits considerados anteriormente, siempre funcionan.
Si consideramos la lista de posibles fuentes de problemas que mencionamos anteriormente, la suma de verificación puede detectar el error independientemente de su origen (salvo, quizás, por alienígenas malintencionados — ellos pueden falsificar la suma de verificación también).
Así que, si nuestro objetivo es verificar que los datos son íntegros, las sumas de verificación son una excelente idea.
La elección del algoritmo para calcular la suma de verificación no generó dudas: CRC. Por un lado, las propiedades matemáticas permiten capturar errores de ciertos tipos al 100%, y por otro lado, en datos aleatorios, este algoritmo suele mostrar una probabilidad de colisiones no mucho mayor que el límite teórico.  . Aunque no sea el algoritmo más rápido, ni siempre el que minimiza el número de colisiones, tiene una cualidad muy importante: en las pruebas que he encontrado, no he visto patrones donde claramente falle. La estabilidad es la principal cualidad en este caso.
Ejemplo de un estudio voluminoso: , (enlaces a narod.ru, disculpen).
Sin embargo, el problema de elegir el valor de control no está completo; CRC es toda una familia de valores de control. Hay que decidir la longitud y luego elegir el polinomio.
La elección de la longitud del valor de control no es una cuestión tan sencilla como parece a primera vista.
Ilustro:
Supongamos que tenemos una probabilidad de error en cada byte  y un valor de control ideal, calculemos el número promedio de errores en un millón de registros:
Datos, byte
Valor de control, byte
Errores no detectados
Falsos positivos
Total de activaciones incorrectas
1
0
1000
0
1000
1
1
4
999
1003
1
2
≈0
1997
1997
1
4
≈0
3990
3990
10
0
9955
0
9955
10
1
39
990
1029
10
2
≈0
1979
1979
10
4
≈0
3954
3954
1000
0
632305
0
632305
1000
1
2470
368
2838
1000
2
10
735
745
1000
4
≈0
1469
1469
Aparentemente, todo es simple: elige la longitud del valor de control según la longitud de los datos protegidos, con un mínimo de activaciones incorrectas, y el asunto está resuelto.
Sin embargo, con valores de control cortos surge un problema: aunque detectan bien errores de bits individuales, pueden aceptar, con una probabilidad bastante alta, datos completamente aleatorios como correctos. Ya hubo un artículo en Habr que describía .
Por lo tanto, para hacer prácticamente imposible la coincidencia aleatoria del valor de control, se deben usar valores de control de 32 bits o más. (para longitudes superiores a 64 bits, generalmente se utilizan funciones hash criptográficas).
A pesar de que antes mencioné que se debe ahorrar espacio por todos los medios, aún así utilizaremos un valor de control de 32 bits (16 bits son demasiado pocos, la probabilidad de colisión es superior al 0.01%; y 24 bits, como se dice, no son ni aquí ni allí).
Aquí puede surgir una objeción: ¿para qué hemos ahorrado cada byte al elegir la compresión, para ahora dar 4 bytes a la vez? ¿No sería mejor no comprimir y no añadir el valor de control? Por supuesto que no, la falta de compresión no significa, que la verificación de la integridad no sea necesaria.
No vamos a inventar la rueda en cuanto a la elección del polinomio, y tomaremos el popular CRC-32C.
Este código detecta 6 errores de bits en paquetes de hasta 22 bytes (quizás el caso más común para nosotros), 4 errores de bits en paquetes de hasta 655 bytes (también un caso frecuente para nosotros), 2 o cualquier número impar de errores de bits en paquetes de cualquier longitud razonable.
Si a alguien le interesan los detalles
sobre CRC.
en — quizás el principal especialista en CRC en el planeta.
En hay , que proporciona parámetros ligeramente mejores para las longitudes de paquetes relevantes para nosotros, pero no consideré que la diferencia fuera significativa, y me siento lo suficientemente competente para elegir un código personalizado en vez del estándar y bien investigado.
Además, dado que nuestros datos están comprimidos, surge la pregunta: ¿deberíamos calcular la suma de verificación sobre los datos comprimidos o no comprimidos?
Argumentos a favor del cálculo de la suma de verificación sobre datos no comprimidos:
- al final, necesitamos verificar la integridad del almacenamiento de datos — así que lo estamos verificando directamente (además, se verificarán posibles errores en la implementación de compresión/descompresión, daños causados por memoria defectuosa, etc.);
- el algoritmo deflate en zlib tiene una implementación bastante madura y no debería fallar ante datos de entrada "erróneos", de hecho, a menudo es capaz de detectar errores en el flujo de entrada, reduciendo así la probabilidad general de no detectar un error (realicé una prueba invirtiendo un solo bit en un registro corto, zlib detectó el error aproximadamente en un tercio de los casos).
Argumentos en contra del cálculo de la suma de verificación sobre datos no comprimidos:
- CRC está diseñado precisamente para unos pocos errores de bits, que son característicos de la memoria flash (un error de bit en un flujo comprimido puede causar un cambio masivo en el flujo de salida, en el que, teóricamente, podríamos "atrapar" una colisión);
- no me gusta mucho la idea de pasar datos potencialmente corruptos al descompresor, , cómo reaccionará.
En este proyecto decidí alejarme de la práctica común de almacenar la suma de verificación de los datos no comprimidos.
Resumen: utilizamos CRC-32C, la suma de verificación se calcula a partir de los datos en la forma en que se almacenan en la flash (después de la compresión).
Redundancia
El uso de codificación redundante no elimina, por supuesto, la posibilidad de pérdida de datos, sin embargo, puede reducir significativamente (a menudo en varios órdenes de magnitud) la probabilidad de una pérdida de datos irrecuperable.
Podemos utilizar diferentes tipos de redundancia para corregir errores.
Los códigos de Hamming pueden corregir errores de un solo bit, los códigos de Reed-Solomon son simbólicos, varias copias de datos junto con sumas de comprobación o codificación como RAID-6 pueden ayudar a recuperar datos incluso en caso de daños masivos.
Inicialmente estaba predispuesto a un uso amplio de la codificación resistente a fallos, pero luego comprendí que primero necesitamos tener una idea clara de qué errores queremos proteger y luego elegir la codificación.
Hemos mencionado antes que los errores deben detectarse lo antes posible. ¿En qué momentos podemos encontrarnos con errores?
- Grabación incompleta (por alguna razón, se apagó la alimentación durante la grabación, Raspberry se quedó colgado, ...)
Lamentablemente, en caso de tal error, solo queda ignorar las grabaciones no válidas y considerar los datos perdidos; - Errores de escritura (por alguna razón, se grabó en la memoria flash algo diferente a lo que se estaba escribiendo)
Podemos detectar tales errores de inmediato si realizamos una lectura de comprobación justo después de la escritura; - Distorsión de datos en la memoria durante el almacenamiento;
- Errores de lectura
Para corregir, basta con repetir la lectura varias veces en caso de discrepancia en la suma de comprobación.
Es decir, solo los errores de tipo tres (degradación espontánea de los datos durante el almacenamiento) no pueden ser corregidos sin codificación resistente a fallos. Se piensa que tales errores son extremadamente poco probables.
Resumen: Se decidió renunciar a la codificación redundante, pero si la operación demuestra que esta decisión es errónea, se volverá a considerar la cuestión (con estadística acumulada sobre fallos que permitirá elegir el tipo óptimo de codificación).
Otros
Por supuesto, el formato del artículo no permite justificar cada bit en el formato (y ya me he quedado sin fuerzas), por lo que pasaré brevemente por algunos aspectos que no se han mencionado anteriormente.
- Se decidió que todas las páginas sean "equivalentes".
Es decir, no habrá páginas especiales con metadatos, flujos separados, etc., en su lugar, habrá un flujo único que reescribirá todas las páginas por turno.
Esto asegura un desgaste uniforme de las páginas, la ausencia de un único punto de fallo, y simplemente gusta; - Es fundamental prever la versión del formato.
¡Un formato sin número de versión en el encabezado es un desastre!
Basta con añadir al encabezado de la página un campo con un número mágico (firma) que indique la versión del formato utilizado. (no creo que en la práctica haya incluso diez).; - Utilizar para las entradas (que son muchas) un encabezado de longitud variable, tratando en la mayoría de los casos de hacer su longitud de 1 byte;
- Para codificar la longitud del encabezado y la longitud de la parte truncada de la entrada comprimida, utilizar códigos binarios de longitud variable.
Ayudó mucho de códigos Huffman. En cuestión de minutos, fue posible encontrar los códigos de longitud variable necesarios.
Descripción del formato de almacenamiento de datos
Orden de bytes
Los campos de tamaño superior a un byte se almacenan en formato big-endian (orden de bytes de red), es decir, 0x1234 se almacena como 0x12, 0x34.
División en páginas
Toda la memoria flash está dividida en páginas de tamaño igual.
El tamaño de la página por defecto es de 32 KB, pero no más de 1/4 del tamaño total del chip de memoria (para un chip de 4 MB, eso equivale a 128 páginas).
Cada página almacena datos de manera independiente de las demás (es decir, los datos de una página no hacen referencia a los datos de otra página).
Todas las páginas están numeradas en orden natural (en orden creciente de direcciones), comenzando desde el número 0 (la página cero comienza en la dirección 0, la primera en 32 KB, la segunda en 64 KB, etc.).
El chip de memoria se utiliza como un búfer cíclico (ring buffer), es decir, primero se escribe en la página número 0, luego en la número 1, …, cuando llenamos la última página, comienza un nuevo ciclo y la escritura continúa desde la página cero.
Dentro de la página
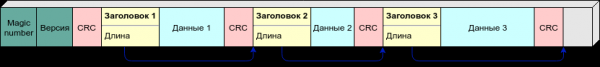
Al principio de la página se almacena un encabezado de 4 bytes, luego un chequeo de suma de control del encabezado (CRC-32C), y a continuación se almacenan las entradas en el formato "encabezado, datos, suma de control".
El encabezado de la página (en el esquema de color verde sucio) consiste en:
- un campo de dos bytes de número mágico (también es el indicador de la versión del formato)
para la versión actual del formato se considera como0xed00 ⊕ número de página; - contador de dos bytes «Versión de la página» (número de ciclo de reescritura de memoria).
Las entradas en la página se almacenan en formato comprimido (se utiliza el algoritmo deflate). Todas las entradas en una sola página se comprimen en un solo flujo (se utiliza un diccionario común), en cada nueva página la compresión comienza de nuevo. Es decir, para descomprimir cualquier entrada se requieren todas las entradas anteriores de esa página (y solo de esa).
Cada entrada se comprimirá con la bandera Z_SYNC_FLUSH, al final del flujo comprimido hay 4 bytes 0x00, 0x00, 0xff, 0xff, precedidos, posiblemente, por uno o dos bytes cero.
Esta secuencia (de longitud 4, 5 o 6 bytes) se descarta al escribir en la memoria flash.
El encabezado de la entrada consiste en 1, 2 o 3 bytes, que contienen:
- un bit (T) que indica el tipo de entrada: 0 — contexto, 1 — registro;
- un campo de longitud variable (S) de 1 a 7 bits, que determina la longitud del encabezado y el «rabo» que se debe añadir a la entrada para la descompresión;
- la longitud de la entrada (L).
Tabla de valores S:
S
Longitud del encabezado, bytes
Se descarta al escribir, bytes
0
1
5 (00 00 00 ff ff)
10
1
6 (00 00 00 00 ff ff)
110
2
4 (00 00 ff ff)
1110
2
5 (00 00 00 ff ff)
11110
2
6 (00 00 00 00 ff ff)
1111100
3
4 (00 00 ff ff)
1111101
3
5 (00 00 00 ff ff)
1111110
3
6 (00 00 00 00 ff ff)
He tratado de ilustrar, no sé cuán claro ha quedado:
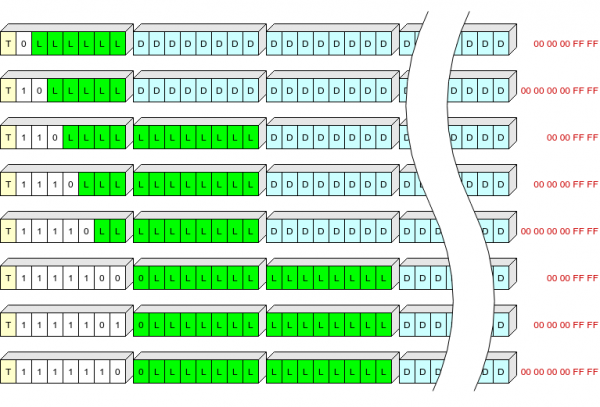
En amarillo aquí se indica el campo T, en blanco el campo S, en verde L (longitud de los datos comprimidos en bytes), en azul los datos comprimidos, en rojo los bytes finales de los datos comprimidos que no se escriben en la memoria flash.
Así, los encabezados de las entradas de longitud más común (hasta 63+5 bytes en formato comprimido) podremos escribir con un solo byte.
Después de cada entrada se almacena una suma de verificación CRC-32C, cuya valor inicial (init) es el valor invertido de la suma de verificación anterior.
El CRC tiene la propiedad de «continuidad», funciona (más o menos, invirtiendo bits en el proceso) de tal manera:  .
Es decir, en realidad calculamos el CRC de todos los bytes anteriores de encabezados y datos en esta página.
Inmediatamente después de la suma de verificación está el encabezado de la siguiente entrada.
El encabezado está diseñado de tal manera que su primer byte siempre sea diferente de 0x00 y 0xff (si en lugar del primer byte del encabezado encontramos 0xff, eso significa que es un área aún no utilizada; 0x00 señala un error).
Algoritmos aproximados
Lectura de la memoria flash
Cualquier lectura se realiza con verificación de suma de verificación.
Si la suma de comprobación no coincide, la lectura se repite varias veces con la esperanza de leer los datos correctos.
(tiene sentido, Linux no almacena en caché la lectura de NOR Flash, probado)
Escritura en la memoria flash
Escribiendo datos.
Leyéndolos.
Si los datos leídos no coinciden con los escritos, rellenamos el área con ceros y señalizamos un error.
Preparación de un nuevo chip para su funcionamiento
Para la inicialización, se escribe un encabezado con la versión 1 en la primera (más precisamente, la cero) página.
Después de eso, se escribe el contexto inicial en esta página (contiene el UUID del dispositivo y configuraciones predeterminadas).
Todo listo, la memoria flash está lista para trabajar.
Carga del dispositivo
Al cargar, se leen los primeros 8 bytes de cada página (encabezado + CRC), se ignoran las páginas con un Magic Number desconocido o un CRC incorrecto.
De las páginas 'correctas', se seleccionan las páginas con la versión máxima, de las cuales se toma la página con el número más alto.
Se lee la primera entrada, se verifica la validez del CRC y la presencia de la bandera 'contexto'. Si todo está bien, esta página se considera actual. Si no, retrocedemos a la anterior hasta encontrar una página 'viviente'.
Y en la página encontrada leemos todas las entradas, aplicamos aquellas con la bandera 'contexto'.
Guardamos el diccionario zlib (será necesario para la reescritura en esta página).
Listo, la carga ha finalizado, el contexto se ha restaurado, se puede trabajar.
Añadiendo una entrada al registro
Comprimimos la entrada con el diccionario correcto, indicando Z_SYNC_FLUSH. Verificamos si la entrada comprimida cabe en la página actual.
Si no cabe (o hubo errores de CRC en la página), comenzamos una nueva página (ver más abajo).
Escribimos la entrada y el CRC. Si ocurre un error, comenzamos una nueva página.
Nueva página
Seleccionamos una página libre con el número mínimo (consideramos libre aquella que tiene una suma de comprobación incorrecta en el encabezado o con una versión inferior a la actual). Si no hay tales páginas, seleccionamos la página con el número mínimo de aquellas que tienen la versión igual a la actual.
Hacemos que la página seleccionada sea borrada. Comparar el contenido con 0xff. Si algo no está bien, tomamos la siguiente página libre, etc.
En la página borrada escribimos el encabezado, como primera entrada el estado actual del contexto, y como siguiente, la entrada no escrita del registro (si hay una).
Aplicabilidad del formato
En mi opinión, se ha logrado un formato decente para almacenar cualquier flujo de información más o menos comprimible (texto simple, JSON, MessagePack, CBOR, posiblemente protobuf) en NOR Flash.
Por supuesto, el formato está "adaptado" para SLC NOR Flash.
No se debe usar con medios que tengan un alto BER, como NAND o MLC NOR. (¿hay memoria como esa a la venta? Solo he visto menciones en trabajos sobre códigos de corrección)..
Además, no se debe utilizar con dispositivos que tengan su propio FTL: USB flash, SD, MicroSD, etc. (para esa memoria, hice un formato con un tamaño de página de 512 bytes, con una firma al principio de cada página y números únicos para las entradas; a veces, con solo una lectura secuencial de una flash "con fallos" se lograba recuperar todos los datos)..
Dependiendo de las tareas, el formato se puede utilizar sin cambios en memorias flash de 128Kbit (16Kb) a 1Gbit (128Mb). Si se desea, se puede usar en chips de mayor volumen, solo que probablemente será necesario ajustar el tamaño de la página. (Pero aquí surge la cuestión de la viabilidad económica, el precio de NOR Flash de gran capacidad no es alentador)..
Si alguien encuentra el formato interesante y quiere usarlo en un proyecto abierto, escríbeme, intentaré encontrar tiempo, ajustar el código y publicarlo en github.
Conclusión
Como podemos ver, al final el formato resultó ser simple. e incluso aburrido..
En el artículo es difícil reflejar la evolución de mi punto de vista, pero créanme: al principio quería crear algo complejo, indestructible, capaz de sobrevivir incluso tras una explosión nuclear cercana. Sin embargo, la razón (espero) ha prevalecido y poco a poco las prioridades se han desplazado hacia la simplicidad y la compactación.
¿Puede ser que me haya equivocado? Sí, claro. Podría suceder, por ejemplo, que hayamos comprado un lote de chips de mala calidad. O, por alguna otra razón, el equipo no cumpla con las expectativas de fiabilidad.
¿Tengo un plan para este caso? Creo que tras leer el artículo no duden de que tengo un plan. E incluso más de uno.
Si hablamos un poco más en serio, el formato se desarrolló al mismo tiempo como una opción de trabajo y como un "banco de pruebas".
En este momento, todo funciona bien en la mesa, literalmente en unos días la solución será desplegada. (aproximadamente) en cientos de dispositivos, veremos cómo se comporta en la «explotación» real (espero que el formato permita detectar fallos de manera fiable; así que podremos recopilar estadísticas completas). En unos meses se podrán sacar conclusiones. (y si no tengo suerte, tal vez antes).
Si al final del uso se detectan problemas graves y se requieren mejoras, definitivamente escribiré sobre ello.
Literatura
No quería hacer una larga y aburrida lista de trabajos utilizados; al fin y al cabo, todos tienen Google.
Aquí decidí dejar una lista de hallazgos que me parecieron especialmente interesantes, sin embargo, con el tiempo se trasladaron directamente al texto del artículo, quedando solo un ítem en la lista:
- Utilidad del autor zlib. Muestra de forma comprensible el contenido de archivos deflate/zlib/gzip. Si necesitas entender el formato deflate (o gzip), lo recomiendo encarecidamente.
Fuente: habr.com
