

¡Hola a todos! Me llamo Nikolai Golov. Anteriormente trabajé en Avito y durante seis años dirigí la Data Platform, es decir, me encargué de todas las bases de datos: analíticas (Vertica, ClickHouse), en flujo y OLTP (Redis, Tarantool, VoltDB, MongoDB, PostgreSQL). Durante este tiempo, me familiaricé con una gran variedad de bases de datos, las más diversas y peculiares, así como con casos de uso no estándar.
Actualmente trabajo en ManyChat. En esencia, es una startup: nueva, ambiciosa y de rápido crecimiento. Y cuando recién ingresé a la empresa, surgió la clásica pregunta: "¿Qué debe elegir ahora una joven startup en el mercado de SGBD y bases de datos?".
En este artículo, basado en mi presentación en , responderé a esta pregunta. La versión en video de la presentación está disponible en .
Las bases de datos más conocidas de 2020
Estamos en el año 2020, miré a mi alrededor y vi tres tipos de bases de datos.
El primer tipo es las bases de datos OLTP clásicas: PostgreSQL, SQL Server, Oracle, MySQL. Fueron escritas hace mucho tiempo, pero siguen siendo relevantes porque son bien conocidas por la comunidad de desarrolladores.
El segundo tipo es las bases de datos de la década de 2000. Intentaron alejarse de los patrones clásicos al renunciar a SQL, las estructuras tradicionales y ACID, añadiendo fragmentación incorporada y otras características atractivas. Por ejemplo, estas son Cassandra, MongoDB, Redis o Tarantool. Todas estas soluciones querían ofrecer al mercado algo radicalmente nuevo y han encontrado su nicho, ya que se volvieron extremadamente convenientes en ciertas tareas. Estas bases las denominaré con el término general NOSQL.
Los 2000 han terminado, nos hemos acostumbrado a las bases NOSQL, y el mundo, desde mi punto de vista, ha dado el siguiente paso: hacia las bases de datos gestionadas. Estas bases tienen un núcleo similar al de las bases de datos OLTP clásicas o los nuevos NoSQL. Pero no requieren DBA ni DevOps, y funcionan en hardware gestionado en la nube. Para el desarrollador, es simplemente "una base de datos" que opera en algún lugar, y cómo se instaló en el servidor, quién configuró el servidor y quién lo actualiza, a nadie le importa.
Ejemplos de tales bases son:
- AWS RDS: capa gestionada sobre PostgreSQL/MySQL.
- DynamoDB: el equivalente de AWS basado en documentos, similar a Redis y MongoDB.
- Amazon Redshift: base de datos analítica gestionada.
Se basa en bases antiguas, pero implementadas en un entorno gestionado, sin necesidad de trabajar con el hardware.
Nota: Los ejemplos se han tomado para el entorno de AWS, pero sus análogos también existen en Microsoft Azure, Google Cloud o Yandex.Cloud.
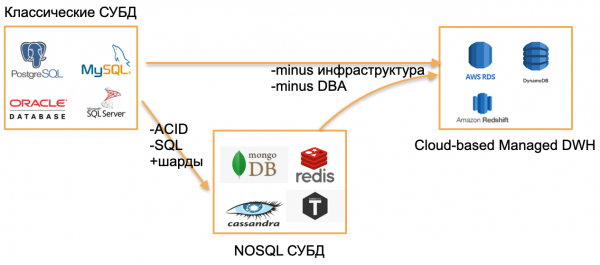
¿Qué hay de nuevo en todo esto? En 2020, nada de esto.
El concepto de Serverless
Realmente nuevo en el mercado en 2020 — son las soluciones sin servidor o serverless.
Trataré de explicar qué significa esto a través de un servicio común o una aplicación de backend.
Para desplegar una aplicación de backend común, compramos o alquilamos un servidor, copiamos el código en él, publicamos un endpoint hacia afuera y pagamos regularmente por el alquiler, la electricidad y los servicios del centro de datos. Este es el esquema estándar.
¿Se puede hacer de otra manera? Con los servicios sin servidor, sí.
¿Cuál es el truco de este enfoque? No hay servidor, ni siquiera alquiler de una instancia virtual en la nube. Para desplegar el servicio, copiamos el código (funciones) en un repositorio y publicamos un endpoint hacia afuera. Luego, simplemente pagamos por cada llamada a esta función, ignorando por completo el hardware en el que se ejecuta.
Trataré de ilustrar este enfoque con imágenes.
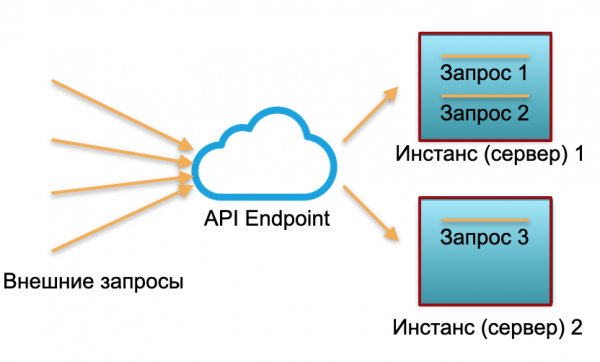
Despliegue clásico. Tenemos un servicio con una carga determinada. Elevamos dos instancias: servidores físicos o instancias en AWS. A estas instancias se dirigen las solicitudes externas, que son procesadas allí.
Como se puede ver en la imagen, los servidores no están utilizados de manera uniforme. Uno está utilizado al 100%, con dos solicitudes, mientras que el otro solo al 50% — está parcialmente inactivo. Si llegan no tres solicitudes, sino 30, el sistema no podrá soportar la carga y comenzará a fallar.
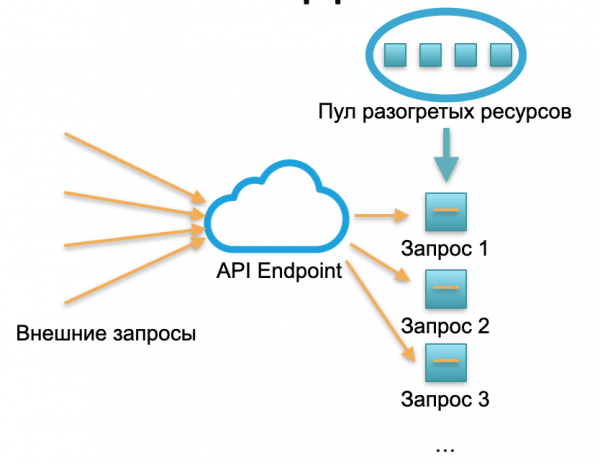
Despliegue sin servidor. En un entorno sin servidor, este tipo de servicio no tiene instancias ni servidores. Hay un cierto grupo de recursos calentados — pequeños contenedores Docker preparados con el código de la función desplegada. El sistema recibe solicitudes externas y para cada una de ellas, el marco sin servidor levanta un pequeño contenedor con el código: procesa exactamente esta solicitud y mata el contenedor.
Una solicitud — un contenedor levantado, 1000 solicitudes — 1000 contenedores. Y el despliegue en servidores físicos ya es trabajo del proveedor de la nube. Esto está completamente oculto por el marco sin servidor. En este concepto, pagamos por cada llamada. Por ejemplo, si llega una llamada al día — pagamos por una llamada, si llegan un millón por minuto — pagamos por un millón. O por segundo, eso también ocurre.
La idea de publicar funciones sin servidor es adecuada para un servicio sin estado. Pero si necesita un servicio con estado, entonces añadimos una base de datos al servicio. En este caso, cuando se trata de trabajar con el estado, cada función con estado simplemente escribe y lee desde la base de datos. Y puede ser de cualquiera de los tres tipos de bases de datos descritos al principio del artículo.
¿Cuál es la limitación común de todas estas bases de datos? Son los costos asociados con un servidor en la nube o un servidor físico (o varios servidores) que se utilizan constantemente. No importa si utilizamos una base de datos clásica o una gestionada, si hay DevOps y un administrador o no, siempre pagamos 24/7 por el hardware, la electricidad y el alquiler del centro de datos. Si tenemos una base de datos clásica, pagamos por el maestro y el esclavo. Si es una base de datos shardada de alto rendimiento, pagamos por 10, 20 o 30 servidores, y pagamos de forma continua.
La inclusión de servidores reservados en la estructura de costos antes se percibía como un mal inevitable. Las bases de datos normales también tienen otras complicaciones, como límites en el número de conexiones, restricciones de escalabilidad y consenso geodistribuido; algunas se pueden resolver en ciertas bases de datos, pero no todas a la vez y no de manera perfecta.
Base de datos sin servidor - teoría
La pregunta del 2020: ¿se puede hacer que una base de datos también sea sin servidor? Todos han oído hablar del backend sin servidor... ¿y si intentamos hacer que la base de datos sea sin servidor?
Esto suena extraño, porque una base de datos es un servicio con estado, que no se adapta muy bien a la infraestructura sin servidor. Además, el estado de la base de datos es muy grande: gigabytes, terabytes y en bases de datos analíticas, incluso petabytes. No se puede levantar fácilmente en contenedores ligeros de Docker.
Por otro lado, casi todas las bases de datos modernas son una gran cantidad de lógica y componentes: transacciones, consenso de integridad, procedimientos, dependencias relacionales y mucha lógica. Una parte considerable de la lógica de la base de datos necesita un estado pequeño. Gigabytes y terabytes son utilizados directamente solo por una pequeña parte de la lógica de la base de datos relacionada con la ejecución directa de las consultas.
Por lo tanto, la idea es: si parte de la lógica permite una ejecución sin estado, ¿por qué no dividir la base de datos en partes con estado y sin estado?
Sin servidor para soluciones OLAP
Veamos cómo podría ser la división de una base de datos en partes con estado y sin estado mediante ejemplos prácticos.
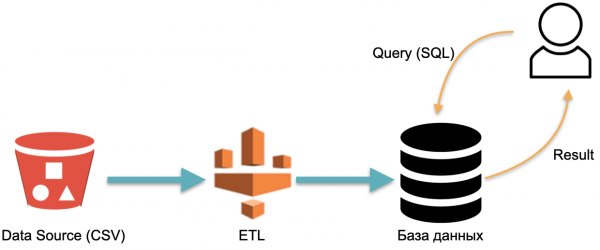
Por ejemplo, tenemos una base de datos analítica: datos externos (cilindro rojo a la izquierda), un proceso ETL que carga datos en la base, y un analista que envía consultas SQL a la base. Este es el esquema clásico de funcionamiento de un almacén de datos.
En este esquema, el ETL se ejecuta una vez. Luego, se deben pagar continuamente los servidores en los que funciona la base de datos con los datos cargados por el ETL, para que haya un lugar donde enviar las consultas.
Consideremos un enfoque alternativo, implementado en la base de datos AWS Athena Serverless. Aquí no hay hardware asignado de forma permanente donde se almacenen los datos cargados. En su lugar:
- El usuario envía una consulta SQL a Athena. El optimizador de Athena analiza la consulta SQL y busca en el almacenamiento de metadatos los datos específicos necesarios para ejecutar la consulta.
- El optimizador, basándose en los datos recopilados, extrae los datos necesarios de fuentes externas a un almacenamiento temporal (base de datos temporal).
- En el almacenamiento temporal se ejecuta la consulta SQL del usuario, y el resultado se devuelve al usuario.
- El almacenamiento temporal se limpia, y los recursos se liberan.
En esta arquitectura, solo pagamos por el proceso de ejecución de la consulta. No hay consultas, no hay gastos.
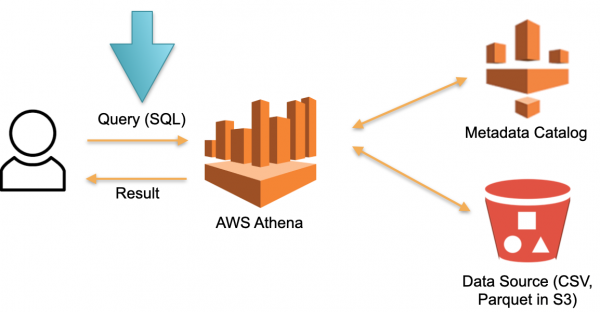
Este es un enfoque funcional y se implementa no solo en Athena Serverless, sino también en Redshift Spectrum (en AWS).
El ejemplo de Athena muestra que la base de datos Serverless funciona con consultas reales con decenas y cientos de Terabytes de datos. Para cientos de Terabytes se necesitarían cientos de servidores, pero no necesitamos pagarlos: pagamos por las consultas. La velocidad de cada consulta es (muy) baja en comparación con bases de datos analíticas especializadas como Vertica, pero no pagamos por períodos de inactividad.
Esta base de datos es aplicable para consultas analíticas ad-hoc raras. Por ejemplo, cuando decidimos espontáneamente verificar una hipótesis sobre un volumen gigantesco de datos. Para estos casos, Athena es perfecta. Para consultas regulares, este sistema resulta costoso. En este caso, almacene en caché los datos en alguna solución especializada.
Serverless para soluciones OLTP
En el ejemplo anterior, se consideraron tareas OLAP (analíticas). Ahora analicemos las tareas OLTP.
Imaginemos un PostgreSQL o MySQL escalable. Vamos a levantar una instancia administrada de PostgreSQL o MySQL con recursos mínimos. Cuando la instancia reciba más carga, conectaremos réplicas adicionales a las que distribuiremos parte de la carga de lectura. Si no hay solicitudes ni carga, desactivamos las réplicas. La primera instancia es el maestro, y las demás son réplicas.
Esta idea se implementa en una base llamada Aurora Serverless de AWS. El principio es simple: un proxy fleet recibe las solicitudes de aplicaciones externas. Al observar un aumento en la carga, asigna recursos computacionales de instancias mínimas previamente calentadas, realizando la conexión lo más rápido posible. La desconexión de instancias ocurre de la misma manera.
Dentro de Aurora existe el concepto de Aurora Capacity Unit, ACU. Esto es (aproximadamente) una instancia (servidor). Cada ACU específico puede ser maestro o esclavo. Cada Capacity Unit tiene su propia memoria RAM, procesador y disco mínimo. Así, hay un maestro y las demás son réplicas de solo lectura.
La cantidad de Aurora Capacity Units en funcionamiento es un parámetro configurable. El número mínimo puede ser uno o cero (en este caso, la base no funciona si no hay solicitudes).
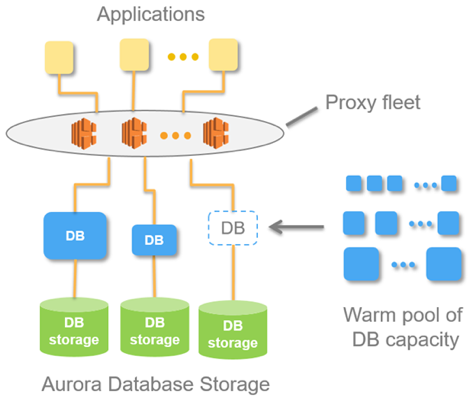
Cuando la base recibe solicitudes, el proxy fleet activa Aurora Capacity Units, aumentando los recursos de rendimiento del sistema. La capacidad de aumentar y disminuir recursos permite que el sistema "juggle" recursos: desactivar automáticamente ACUs individuales (reemplazándolos por nuevos) y aplicar todas las actualizaciones necesarias a los recursos desactivados.
La base Aurora Serverless puede escalar la carga de lectura. Pero esto no se menciona explícitamente en la documentación. Puede dar la impresión de que pueden levantar un multi-master. Sin embargo, no hay magia en esto.
Esta base es ideal para no gastar grandes sumas de dinero en sistemas con acceso impredecible. Por ejemplo, al crear un MVP o sitios web de presentación, generalmente no esperamos una carga estable. Por lo tanto, en ausencia de acceso, no pagamos por las instancias. Cuando surge una carga inesperada, como después de una conferencia o una campaña publicitaria, un gran número de personas accede al sitio y la carga aumenta drásticamente. Aurora Serverless maneja automáticamente esta carga y conecta rápidamente los recursos faltantes (ACU). Luego, cuando la conferencia termina, todos olvidan el prototipo, los servidores (ACU) se apagan y los gastos caen a cero: es conveniente.
Esta solución no es adecuada para cargas altas y estables, porque no puede escalar la carga de escritura. Todas estas conexiones y desconexiones de recursos ocurren en el momento del llamado 'punto de escala', que es cuando la base de datos no está siendo mantenida por transacciones ni tablas temporales. Por ejemplo, durante una semana puede que no ocurra ningún punto de escala, y la base opera con los mismos recursos, incapaz de expandirse o contraerse.
No hay magia: es un PostgreSQL ordinario. Pero el proceso de añadir y desconectar máquinas está parcialmente automatizado.
Serverless por diseño
Aurora Serverless es una base de datos antigua reescrita para la nube, aprovechando las ventajas del enfoque serverless. Ahora, les hablaré de una base de datos que fue diseñada desde el principio para la nube, con un enfoque serverless: Serverless-by-design. Se desarrolló sin la suposición de que funcionaría en servidores físicos.
Esta base de datos se llama Snowflake. Tiene tres bloques clave.
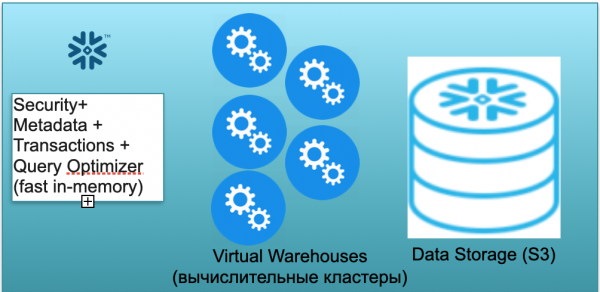
El primero es el bloque de metadatos. Este es un servicio rápido en memoria que se encarga de cuestiones de seguridad, metadatos, transacciones y optimización de consultas (en la ilustración a la izquierda).
El segundo bloque consiste en múltiples clústeres de computación virtual para cálculos (en la ilustración, un conjunto de círculos azules).
El tercer bloque es un sistema de almacenamiento de datos basado en S3. S3 es un almacenamiento de objetos a escala en AWS, similar a un Dropbox ilimitado para negocios.
Veamos cómo funciona Snowflake, asumiendo un inicio en frío. Es decir, la base de datos está creada, los datos han sido cargados, y no hay consultas activas. En consecuencia, si no hay consultas a la base de datos, se ha levantado un servicio de Metadata en memoria rápida (el primer bloque). Y tenemos un almacenamiento S3, donde se encuentran los datos de las tablas, divididos en lo que se llaman microparticiones. Para simplificar: si en la tabla se encuentran transacciones, las microparticiones son días de transacciones. Cada día representa una micropartición, un archivo separado. Y cuando la base de datos funciona en este modo, solo pagas por el espacio que ocupan los datos. Además, la tarifa por el espacio es muy baja (especialmente teniendo en cuenta la compresión significativa). El servicio de metadatos también funciona constantemente, pero para optimizar las consultas no se requieren muchos recursos, y se puede considerar que el servicio es prácticamente gratuito.
Ahora imaginemos que un usuario llega a nuestra base de datos y lanza una consulta SQL. La consulta SQL se envía inmediatamente al servicio de Metadata para su procesamiento. Por lo tanto, al recibir la consulta, este servicio analiza la misma, los datos disponibles, los privilegios del usuario y, si todo está bien, elabora un plan de procesamiento de la consulta.
Luego, el servicio inicia el arranque del clúster de computación. Un clúster de computación es un conjunto de servidores que realizan cálculos. Es decir, es un clúster que puede contener 1 servidor, 2 servidores, 4, 8, 16, 32—¡cuantos desees! Envías la consulta y, para ella, se inicia instantáneamente el arranque de este clúster. Esto realmente toma unos segundos.
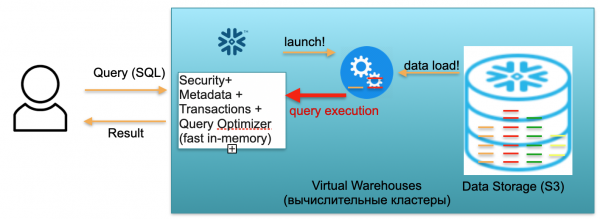
Después de que el clúster se ha iniciado, las micro-particiones necesarias para procesar su consulta se copian desde S3 al clúster. Supongamos que se necesitan dos particiones de una tabla y una de otra para ejecutar una consulta SQL. En ese caso, solo se copiarán tres particiones necesarias al clúster, no todas las tablas en su totalidad. Esta eficiencia se debe a que todo está dentro de un mismo centro de datos y conectado a través de canales muy rápidos, por lo que todo el proceso de transferencia se realiza rápidamente: en segundos, raramente en minutos, salvo en casos de consultas extraordinarias. Las micro-particiones se copian al clúster de cómputo y, una vez completada la transferencia, se ejecuta la consulta SQL en este clúster. El resultado de esta consulta puede ser una fila, varias filas o una tabla — se envían al usuario para que las descargue, las visualice en su herramienta BI, o las utilice de alguna otra manera.
Cada consulta SQL puede no solo sumarizar datos previamente cargados, sino también cargar/formar nuevos datos en la base. Esto puede ser una consulta que, por ejemplo, inserta nuevos registros en otra tabla, lo que provoca la creación de una nueva partición en el clúster de cómputo, que, a su vez, se guarda automáticamente en el almacenamiento S3.
El escenario descrito anteriormente, desde la llegada del usuario hasta el inicio del clúster, la carga de datos, la ejecución de consultas y la obtención de resultados, se factura por las minutos de uso del clúster de cómputo virtual levantado, el warehouse virtual. La tarifa varía según la zona de AWS y el tamaño del clúster, pero, en promedio, cuesta varios dólares por hora. Un clúster de cuatro máquinas cuesta el doble que uno de dos máquinas, y uno de ocho máquinas cuesta el doble de eso. Hay opciones de 16, 32 máquinas, dependiendo de la complejidad de las consultas. Pero solo pagas por los minutos en que el clúster está realmente funcionando, porque cuando no hay consultas, puedes quitar las manos; después de 5-10 minutos de espera (parametrizable), se apaga automáticamente, libera recursos y se vuelve gratuito.
Es un escenario completamente realista en el que envías una solicitud, el clúster se activa, por así decirlo, en un minuto, cuenta durante otro minuto, luego cinco minutos para apagarse, y al final pagas por siete minutos de funcionamiento de ese clúster, y no por meses o años.
El primer escenario describía el uso de Snowflake en una variante de un solo usuario. Ahora imaginemos que hay muchos usuarios, que se acerca más a un escenario real.
Supongamos que tenemos muchos analistas y reportes de Tableau que constantemente están bombardeando nuestra base de datos con una gran cantidad de consultas SQL analíticas simples.
Además de eso, supongamos que tenemos científicos de datos ingeniosos que intentan hacer cosas monstruosas con los datos, operando con decenas de Terabytes, analizando miles de millones y billones de filas de datos.
Para los dos tipos de carga descritos anteriormente, Snowflake permite levantar varios clústeres de computación independientes de diferente capacidad. Y estos clústeres de computación funcionan de manera independiente, pero con datos coherentes compartidos.
Para una gran cantidad de consultas ligeras, se pueden levantar 2-3 clústeres pequeños, de un tamaño, digamos, de 2 máquinas cada uno. Este comportamiento se puede implementar, entre otras cosas, con configuraciones automáticas. Es decir, le dices: "Snowflake, levanta un clúster pequeño. Si la carga en él supera un parámetro determinado, levanta un segundo o un tercero similar. Cuando la carga comience a disminuir, apaga los adicionales". Para que, independientemente de cuántos analistas lleguen y comiencen a ver los reportes, haya recursos suficientes para todos.
Al mismo tiempo, si los analistas están durmiendo y nadie está mirando los reportes, los clústeres pueden apagarse completamente, y dejas de pagar por ellos.
Al mismo tiempo, para consultas pesadas (por parte de los científicos de datos), puedes levantar un clúster muy grande con, digamos, 32 máquinas. Este clúster también se cobrará solo por los minutos y horas en que tu gigantesca consulta esté en funcionamiento.
La posibilidad descrita anteriormente permite separar en clústeres no solo 2, sino más tipos de carga (ETL, monitoreo, materialización de reportes, …).
Hagamos un resumen sobre Snowflake. La base combina una idea atractiva con una implementación funcional. En ManyChat utilizamos Snowflake para la analítica de todos los datos disponibles. No tenemos tres clústeres como en el ejemplo, sino entre 5 y 9, de diferentes tamaños. Disponemos de clústeres de 16 máquinas, de 2 máquinas, así como muy pequeños de 1 máquina para algunas tareas. Distribuyen la carga de manera efectiva y nos permiten ahorrar significativamente.
La base escala con éxito la carga de lectura y escritura. Esta es una gran diferencia y un gran avance en comparación con la 'Aurora', que solo manejaba la carga de lectura. Snowflake permite escalar la carga de escritura utilizando esos clústeres computacionales. Es decir, como mencioné, en ManyChat usamos varios clústeres, los pequeños y superpequeños se utilizan principalmente para ETL, para la carga de datos. En cambio, los analistas trabajan en clústeres medianos, que no se ven afectados por la carga ETL, por lo que funcionan muy rápido.
En consecuencia, la base es adecuada para tareas OLAP. Sin embargo, desafortunadamente, todavía no es aplicable a cargas OLTP. En primer lugar, esta base es columnar, con todas las consecuencias que eso conlleva. En segundo lugar, el enfoque mismo, donde se levanta un clúster computacional para cada solicitud según sea necesario y se le inunda con datos, aún es insuficientemente rápido para las cargas OLTP. Segundos de espera para tareas OLAP son normales, pero inaceptables para tareas OLTP; preferiríamos 100 ms, y aún mejor, 10 ms.
Summary
La base de datos sin servidor es posible gracias a la separación de la base de datos en partes Stateless y Stateful. Debe haber notado que en todos los ejemplos dados, la parte Stateful es, por así decirlo, el almacenamiento de micro-particiones en S3, mientras que Stateless es el optimizador, el manejo de los metadatos, y el tratamiento de cuestiones de seguridad que pueden ser levantadas como servicios livianos Stateless independientes.
La ejecución de consultas SQL también puede considerarse como servicios con un ligero estado, que pueden desplegarse en modo sin servidor, como los clústeres computacionales de Snowflake, descargar solo los datos necesarios, ejecutar la consulta y 'apagarse'.
Las bases de datos serverless de nivel productivo ya están disponibles para su uso, están en funcionamiento. Estas bases de datos serverless ya están preparadas para manejar tareas OLAP. Desafortunadamente, para las tareas OLTP se utilizan... con matices, ya que hay limitaciones. Por un lado, esto es una desventaja. Pero, por otro lado, es una oportunidad. Quizás alguno de los lectores encuentre la manera de hacer que una base de datos OLTP sea completamente serverless, sin limitaciones de Aurora.
Espero que haya sido interesante para ustedes. Hacia un futuro sin servidor 🙂
Fuente: habr.com
