

En True Engineering hemos configurado el proceso de entrega continua de actualizaciones en los servidores del cliente y queremos compartir esta experiencia.
Para empezar, desarrollamos un sistema en línea para el cliente y lo desplegamos en nuestro propio clúster de Kubernetes. Ahora nuestra solución de alta carga se ha trasladado a la plataforma del cliente, para lo cual hemos configurado un proceso completamente automático de Continuous Deployment. Gracias a esto, hemos acelerado el time-to-market, llevando los cambios al entorno de producción.
En este artículo, compartiremos todas las etapas del proceso de Continuous Deployment (CD) o entrega de actualizaciones en la plataforma del cliente:
- cómo comienza este proceso,
- sincronización con el repositorio Git del cliente,
- compilación del backend y frontend,
- despliegue automático de la aplicación en el entorno de pruebas,
- despliegue automático en producción.
Durante el proceso compartiremos los detalles de la configuración.
1. Inicio del CD
El Continuous Deployment comienza cuando el desarrollador sube los cambios a la rama de release de nuestro repositorio Git.
Nuestra aplicación se basa en una arquitectura de microservicios, y todos sus componentes se almacenan en un solo repositorio. Gracias a esto, todos los microservicios se compilan e instalan, incluso si solo uno de ellos ha cambiado.
Hemos organizado el trabajo a través de un solo repositorio por varias razones:
- Conveniencia en el desarrollo: la aplicación está en constante evolución, por lo que se puede trabajar con todo el código a la vez.
- Una única pipeline CI/CD que garantiza que la aplicación, como un sistema único, pase todas las pruebas y se entregue en el entorno de producción del cliente.
- Eliminamos la confusión en las versiones: no tenemos que mantener un mapa de versiones de microservicios y describir la configuración de cada microservicio en scripts de Helm.
2. Sincronización con el repositorio Git del código fuente del cliente
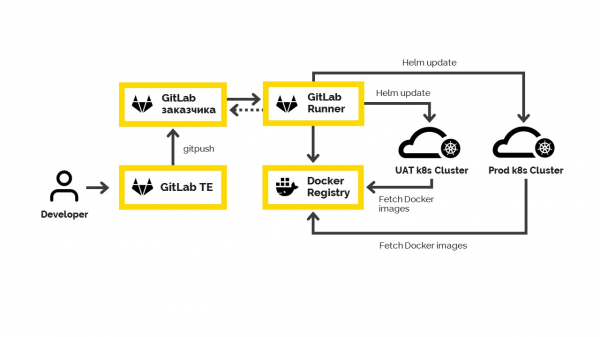
Los cambios realizados se sincronizan automáticamente con el repositorio Git del cliente. Allí se ha configurado la compilación de la aplicación, que se inicia después de la actualización de la rama, y el despliegue en producción. Ambos procesos ocurren en su entorno desde el repositorio Git.
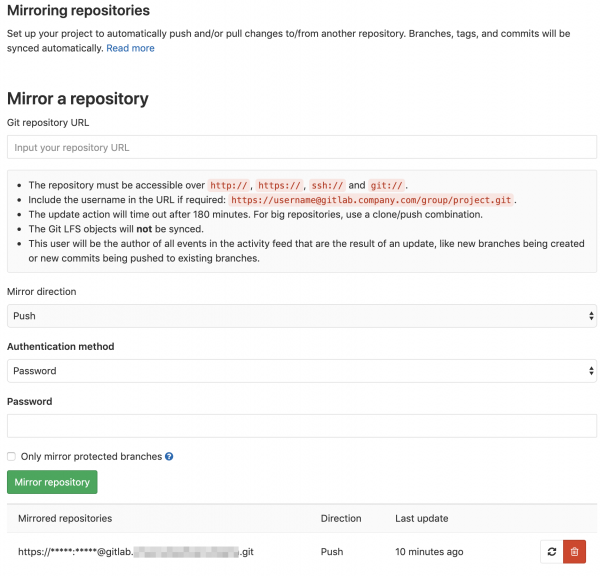
No podemos trabajar directamente con el repositorio del cliente, ya que necesitamos nuestros propios entornos para desarrollo y pruebas. Utilizamos para estos fines nuestro repositorio de Git, que está sincronizado con su repositorio de Git. Tan pronto como el desarrollador sube cambios a la rama correspondiente de nuestro repositorio, GitLab envía inmediatamente esos cambios al cliente.
Después de eso, es necesario realizar la construcción. Esta consta de varias etapas: la construcción del backend y frontend, pruebas y despliegue en producción.
3. Construcción del backend y frontend
La construcción del backend y frontend son dos tareas paralelas que se realizan en el sistema GitLab Runner. La configuración de la construcción inicial se encuentra en este mismo repositorio.
.
GitLab Runner toma el código del repositorio correspondiente, construye la aplicación Java usando el comando de construcción y la envía al registro de Docker. Aquí construimos el backend y el frontend, obtenemos imágenes de Docker que almacenamos en el repositorio del lado del cliente. Para gestionar las imágenes de Docker usamos .
Sincronizamos las versiones de nuestras imágenes con la versión de lanzamiento que será publicada en Docker. Para un funcionamiento fluido, hemos implementado algunas configuraciones:
1. Entre el entorno de prueba y el entorno de producción, los contenedores no se reconstruyen. Hicimos parametrizaciones para que el mismo contenedor pueda funcionar sin reconstrucción con todas las configuraciones, variables de entorno y servicios tanto en el entorno de prueba como en producción.
2. Para actualizar la aplicación a través de Helm, es necesario indicar su versión. Nuestra construcción del backend, frontend y la actualización de la aplicación son tres tareas diferentes, por lo que es importante usar la misma versión de la aplicación en todas partes. Para esta tarea, utilizamos datos del historial de Git, ya que tenemos la configuración del clúster de K8S y la aplicación en el mismo repositorio de Git.
Obtenemos la versión de la aplicación a partir de los resultados de la ejecución del comando
git describe --tags --abbrev=7.
4. Despliegue automático de todos los cambios en el entorno de prueba (UAT)
La siguiente etapa en este script de construcción implica la actualización automática del clúster de K8S. Esto ocurre siempre que toda la aplicación se haya construido y todos los artefactos se hayan publicado en Docker Registry. Después de esto, se inicia la actualización del entorno de prueba.
La actualización del clúster se inicia utilizando . Si algo no sale como se planeó, Helm automáticamente revertirá todos sus cambios. No es necesario monitorear su funcionamiento.
Proporcionamos junto con la compilación la configuración del clúster K8S. Por lo tanto, el siguiente paso es actualizarlo: configMaps, despliegues, servicios, secretos y cualquier otra configuración K8S que hayamos modificado.
Después de esto, Helm inicia la actualización RollOut de la propia aplicación en el entorno de pruebas. Esto se hace antes de que la aplicación se despliegue en producción, para que los usuarios puedan verificar manualmente las características comerciales que hemos implementado en el entorno de pruebas.
5. Despliegue automático de todos los cambios en Prod
Para desplegar la actualización en el entorno de producción, solo queda presionar un botón en GitLab, y los contenedores se entregan directamente al entorno de producción.
La misma aplicación puede funcionar sin recompilación en diferentes entornos: pruebas y producción. Utilizamos los mismos artefactos sin cambiar nada en la aplicación, y los parámetros se definen externamente.
La flexible parametrización de la configuración de la aplicación depende del entorno en el que se ejecute. Hemos extraído todas las configuraciones del entorno externas: todo se parametriza a través de la configuración de K8S y los parámetros de Helm. Cuando Helm despliega la compilación en el entorno de pruebas, se aplican parámetros de prueba, y en el entorno de producción, se aplican parámetros de producción.
Lo más complicado fue parametrizar todos los servicios y variables utilizadas que dependen del entorno, y trasladarlas a variables de entorno y descripción-configuración de parámetros del entorno para Helm.
En los parámetros de la aplicación se utilizan variables de entorno. Sus valores se asignan en los contenedores mediante K8S configmap, que se plantilla utilizando plantillas de Go. Por ejemplo, se puede establecer una variable de entorno para el nombre de dominio de la siguiente manera:
APP_EXTERNAL_DOMAIN: {{ (pluck .Values.global.env .Values.app.properties.app_external_domain | first) }}
.Values.global.env – en esta variable se almacena el nombre del entorno (prod, stage, UAT).
.Values.app.properties.app_external_domain – en esta variable definimos el dominio deseado en el archivo .Values.yaml
Al actualizar la aplicación, Helm crea a partir de las plantillas el archivo configmap.yaml y rellena el valor APP_EXTERNAL_DOMAIN con el valor necesario según el entorno en el que se inicia la actualización de la aplicación. Esta variable se establece ya en el contenedor. El acceso a ella está disponible desde la aplicación, por lo tanto, en cada entorno de la aplicación tendrá un valor diferente esta variable.
Recientemente en Spring Cloud se ha añadido soporte para K8S, incluyendo la gestión de configMaps: . Mientras el proyecto se desarrolla activamente y cambia drásticamente, no podemos usarlo en producción. Pero lo monitorizamos activamente y lo utilizamos en configuraciones de DEV. Una vez que se estabilice, comenzaremos a cambiar de usar variables de entorno a él.
Total
Así que, Continuous Deployment está configurado y funcionando. Todas las actualizaciones se realizan con solo presionar un botón. La entrega de cambios al entorno de producción es automática. Y, lo que es importante, las actualizaciones no detienen el funcionamiento del sistema.
Planes futuros: migración automática de la base
Hemos estado considerando actualizar la base y la posibilidad de revertir estos cambios. Dado que actualmente están funcionando dos versiones diferentes de la aplicación: la antigua está activa y la nueva se está levantando. Solo apagaremos la antigua cuando estemos seguros de que la nueva versión funciona. La migración de la base debe permitir operar con ambas versiones de la aplicación.
Por lo tanto, no podemos simplemente cambiar el nombre de la columna u otros datos. Pero podemos crear una nueva columna, copiar los datos de la columna antigua en ella y escribir disparadores que, al actualizar los datos, también los copiarán y actualizarán en la otra columna. Y después del despliegue exitoso de la nueva versión de la aplicación, tras el período de soporte posterior al lanzamiento, podremos eliminar la columna antigua y el disparador que ya no es necesario.
Si la nueva versión de la aplicación no funciona correctamente, podemos revertir a la versión anterior, incluyendo la versión anterior de la base. En resumen, nuestros cambios permitirán trabajar simultáneamente con varias versiones de la aplicación.
Planeamos automatizar la migración de la base a través de K8S job, integrándola en el proceso de CD. Y compartiremos esta experiencia en Habr.
Fuente: habr.com
