

Nota de traducción.: Este ciclo se dedicó a familiarizarse con las capacidades de Istio y demostrar su funcionamiento en acción. Ahora abordaremos aspectos más complejos de la configuración y el uso de esta malla de servicios, en particular, la configuración detallada de la enrutamiento y la gestión del tráfico de red.
También recordamos que en el artículo se utilizan configuraciones (manifiestos para Kubernetes e Istio) del repositorio .
Gestión del tráfico
Con Istio en el clúster aparecen nuevas oportunidades que permiten asegurar:
- Enrutamiento dinámico de solicitudes: despliegues canarios, pruebas A/B;
- Balanceo de carga: simple y coherente, basada en hashes;
- Recuperación ante caídas: tiempos de espera, reintentos, circuit breakers;
- Inyección de fallos: retrasos, interrupciones de solicitudes, etc.
A lo largo del artículo, estas capacidades se mostrarán mediante un ejemplo de una aplicación seleccionada y se presentarán nuevas conceptos. El primero de estos conceptos será DestinationRules (es decir, reglas sobre el destinatario del tráfico / solicitudes — nota del traductor), mediante las cuales activamos la prueba A/B.
Prueba A/B: DestinationRules en la práctica
La prueba A/B se aplica en casos donde existen dos versiones de una aplicación (por lo general, difieren visualmente) y no estamos 100% seguros de cuál de ellas mejorará la interacción del usuario. Por lo tanto, lanzamos ambas versiones simultáneamente y recopilamos métricas.
Para desplegar la segunda versión del frontend, necesaria para la demostración de la prueba A/B, ejecuta el siguiente comando:
$ kubectl apply -f resource-manifests/kube/ab-testing/sa-frontend-green-deployment.yaml
department.extensions/sa-frontend-green created
El manifiesto del despliegue para la "versión verde" difiere en dos lugares:
- La imagen se basa en un tag diferente —
istio-green, - Los pods tienen la etiqueta
version: green.
Dado que ambos despliegues tienen la etiqueta app: sa-frontend, las solicitudes enrutadas por el servicio virtual sa-external-services al servicio sa-frontend, se redirigirán a todas sus instancias y la carga se distribuirá mediante , lo que resultará en la siguiente situación:
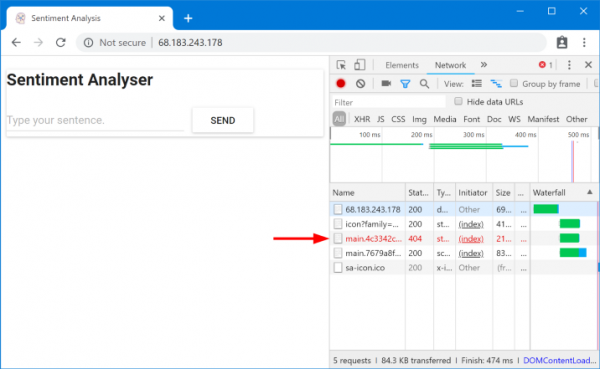
Archivos solicitados no encontrados
Estos archivos no fueron encontrados porque tienen nombres diferentes en las distintas versiones de la aplicación. Asegurémonos de esto:
$ curl --silent http://$EXTERNAL_IP/ | tr '"' 'n' | grep main
/static/css/main.c7071b22.css
/static/js/main.059f8e9c.js
$ curl --silent http://$EXTERNAL_IP/ | tr '"' 'n' | grep main
/static/css/main.f87cd8c9.css
/static/js/main.f7659dbb.js
Esto significa que index.html, que solicita una versión de archivos estáticos, puede ser enviado por el balanceador de carga a pods que tienen otra versión, donde, por razones obvias, tales archivos no existen. Por lo tanto, para que la aplicación funcione, necesitamos establecer un límite: «la misma versión de la aplicación que devolvió index.html debe atender también solicitudes posteriores».
Lograremos el objetivo con un balanceo de carga coherente basado en hashes (Balanceo de Carga con Hash Consistente). En este caso las solicitudes de un mismo cliente se envían a una misma instancia de backend, para lo cual se utiliza una propiedad predefinida, por ejemplo, un encabezado HTTP. Se implementa a través de DestinationRules.
DestinationRules
Después de que VirtualService dirigió la solicitud al servicio adecuado, con DestinationRules podemos definir políticas que se aplicarán al tráfico destinado a las instancias de este servicio:
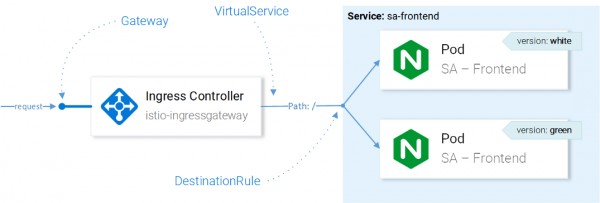
Gestión del tráfico con recursos de Istio
Nota: El impacto de los recursos de Istio en el tráfico de red se presenta aquí de una manera simplificada. Para ser precisos, la decisión sobre a qué instancia enviar la solicitud la toma Envoy en el Ingress Gateway, configurado en CRD.
A través de Destination Rules podemos configurar el balanceo de carga para que se utilicen hashes coherentes y se garanticen respuestas de la misma instancia del servicio a un mismo usuario. La siguiente configuración permite lograr esto ():
apiVersion: networking.istio.io/v1alpha3
kind: DestinationRule
metadata:
  name: sa-frontend
spec:
  host: sa-frontend
  trafficPolicy:
    loadBalancer:
      consistentHash:
        httpHeaderName: version   # 1
1 — el hash se generará en base al contenido del encabezado HTTP version.
Aplica la configuración con el siguiente comando:
$ kubectl apply -f resource-manifests/istio/ab-testing/destinationrule-sa-frontend.yaml
destinationrule.networking.istio.io/sa-frontend creado
Ahora ejecuta el comando abajo y asegúrate de que obtienes los archivos correctos al especificar el encabezado version:
$ curl --silent -H "version: yogo" http://$EXTERNAL_IP/ | tr '"' 'n' | grep mainNota: Para agregar diferentes valores en el encabezado y probar los resultados directamente en el navegador, puedes usar para Chrome (o para Firefox — nota del traductor).
En general, DestinationRules tiene más capacidades en el área de balanceo de carga; para más detalles, consulta .
Antes de profundizar en VirtualService, eliminaremos la "versión verde" de la aplicación y la regla correspondiente para el enrutamiento del tráfico, ejecutando los siguientes comandos:
$ kubectl delete -f resource-manifests/kube/ab-testing/sa-frontend-green-deployment.yaml
deployment.extensions "sa-frontend-green" eliminado
$ kubectl delete -f resource-manifests/istio/ab-testing/destinationrule-sa-frontend.yaml
destinationrule.networking.istio.io "sa-frontend" eliminado
Espejeo: Virtual Services en la práctica
Shadowing ("espejeo") o Mirroring ("espejo") se aplica en situaciones donde queremos probar un cambio en producción sin afectar a los usuarios finales: para ello, duplicamos ("espejeamos") las solicitudes a una segunda instancia donde se han realizado los cambios necesarios, y observamos las consecuencias. En términos simples, es cuando tu colega elige el issue más crítico y hace un pull request en forma de un enorme bulto de suciedad que nadie puede realmente revisar.
Para probar este escenario en acción, crearemos una segunda instancia de SA-Logic con errores (buggy), ejecutando el siguiente comando:
$ kubectl apply -f resource-manifests/kube/shadowing/sa-logic-service-buggy.yaml
deployment.extensions/sa-logic-buggy creado
Y ahora ejecutaremos un comando para asegurarnos de que todas las instancias con app=sa-logic tengan también etiquetas con las versiones correspondientes:
$ kubectl get pods -l app=sa-logic --show-labels
NAME                              READY   LABELS
sa-logic-568498cb4d-2sjwj         2/2     app=sa-logic,version=v1
sa-logic-568498cb4d-p4f8c         2/2     app=sa-logic,version=v1
sa-logic-buggy-76dff55847-2fl66   2/2     app=sa-logic,version=v2
sa-logic-buggy-76dff55847-kx8zz   2/2     app=sa-logic,version=v2
El servicio sa-logic apunta a los pods con la etiqueta app=sa-logic, por lo que todas las solicitudes se distribuirán entre todas las instancias:
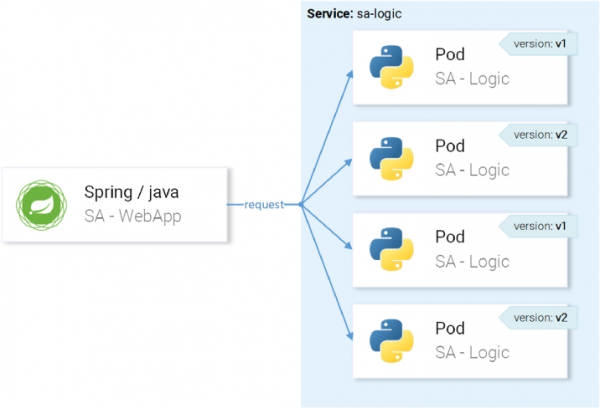
… pero queremos que las solicitudes se dirijan a las instancias con la versión v1 y se espejeen a las instancias con la versión v2:
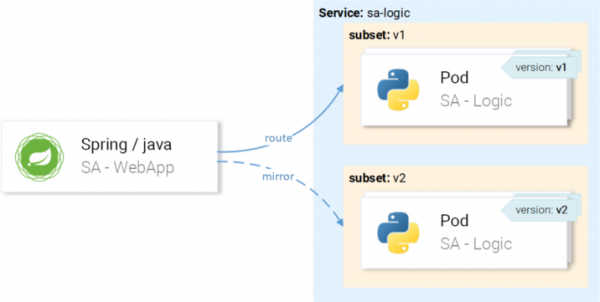
Lograremos esto a través de VirtualService en combinación con DestinationRule, donde las reglas determinarán subconjuntos y rutas de VirtualService a un subconjunto específico.
Definición de subconjuntos en las Destination Rules
Subconjuntos (subsets) se definen con la siguiente configuración ():
apiVersion: networking.istio.io/v1alpha3
kind: DestinationRule
metadata:
  name: sa-logic
spec:
  host: sa-logic    # 1
  subsets:
  - name: v1        # 2
    labels:
      version: v1   # 3
  - name: v2
    labels:
version: v2- El host (
host) define que esta regla se aplica solo a los casos donde la ruta va hacia el serviciosa-logic; - Los nombres (
name) de los subconjuntos se utilizan al enrutar a las instancias del subconjunto; - La etiqueta (
label) define pares clave-valor que deben cumplir las instancias para formar parte de un subconjunto.
Aplica la configuración con el siguiente comando:
$ kubectl apply -f resource-manifests/istio/shadowing/sa-logic-subsets-destinationrule.yaml
destinationrule.networking.istio.io/sa-logic creado
Ahora que se han definido los subconjuntos, podemos avanzar y configurar el VirtualService para aplicar reglas a las solicitudes a sa-logic, de modo que:
- Se enruten al subconjunto
v1, - Se reflejen al subconjunto
v2.
El siguiente manifiesto permite lograr el propósito ():
apiVersion: networking.istio.io/v1alpha3
kind: VirtualService
metadata:
  name: sa-logic
spec:
  hosts:
    - sa-logic
  http:
  - route:
    - destination:
        host: sa-logic
        subset: v1
    mirror:
      host: sa-logic
      subset: v2
No se requieren explicaciones aquí, así que veamos simplemente cómo funciona:
$ kubectl apply -f resource-manifests/istio/shadowing/sa-logic-subsets-shadowing-vs.yaml
virtualservice.networking.istio.io/sa-logic creado
Agreguemos carga con el siguiente comando:
$ while true; do curl -v http://$EXTERNAL_IP/sentiment
    -H "Content-type: application/json"
    -d '{"sentence": "Me encanta yogobella"}';
    sleep .8; done
Veamos los resultados en Grafana, donde se puede observar que la versión con errores (buggy) provoca fallos en aproximadamente el 60 % de las solicitudes, pero ninguno de estos fallos afecta a los usuarios finales, ya que les responde el servicio en funcionamiento.
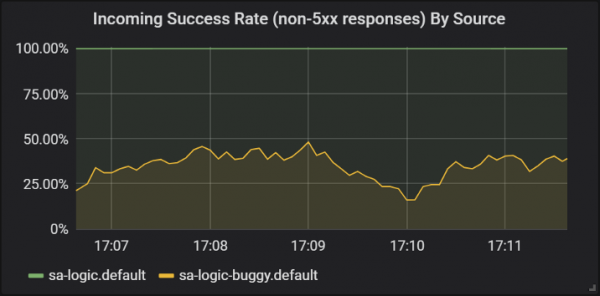
Éxito de las respuestas de las diferentes versiones del servicio sa-logic
Aquí hemos visto por primera vez cómo se aplica VirtualService en relación a los Envoy de nuestros servicios: cuando sa-web-app hace una solicitud a sa-logic, pasa a través del sidecar Envoy, que está configurado a través de VirtualService para enrutar la solicitud al subconjunto v1 y reflejar la solicitud al subconjunto v2 del servicio. sa-logic.
Sé que ya has pensado que los Servicios Virtuales son simples. En la próxima sección ampliaremos esta opinión mostrando que también son realmente magníficos.
Implementaciones canarias
El Canary Deployment es el proceso de desplegar una nueva versión de una aplicación para un pequeño número de usuarios. Se utiliza para asegurarse de que no hay problemas en el lanzamiento y solo después de eso, estando ya seguro de su calidad adecuada, se extiende a unamayor audiencia.Para demostrar las implementaciones canarias, continuaremos trabajando con el subconjunto
No escatimaremos y enviaremos inmediatamente el 20 % de los usuarios a la versión con errores (que representará nuestro lanzamiento canario), y el 80 % restante a el servicio normal. Para esto aplicaremos el siguiente VirtualService ( buggy sa-logic-subsets-canary-vs.yaml sa-logic.
No seamos tacaños y enviemos inmediatamente al 20 % de los usuarios a la versión con errores (que representará nuestro lanzamiento canario), y el 80 % restante a un servicio normal. Para esto, aplicaremos el siguiente VirtualService ("):
apiVersion: networking.istio.io/v1alpha3
kind: VirtualService
metadata:
  name: sa-logic
spec:
  hosts:
    - sa-logic
  http:
  - route:
    - destination:
        host: sa-logic
        subset: v1
      weight: 80         # 1
    - destination:
        host: sa-logic
        subset: v2
      weight: 20 # 1
1 — este es el peso (peso), que determina el porcentaje de solicitudes que se dirigirá al receptor o subconjunto del receptor.
Actualizaremos la configuración anterior de VirtualService con sa-logic el siguiente comando:
$ kubectl apply -f resource-manifests/istio/canary/sa-logic-subsets-canary-vs.yaml
virtualservice.networking.istio.io/sa-logic configurado
… y de inmediato veremos que parte de las solicitudes provocan errores:
$ while true; do
   curl -i http://$EXTERNAL_IP/sentiment
   -H "Content-type: application/json"
   -d '{"sentence": "I love yogobella"}'
   --silent -w "Time: %{time_total}s t Status: %{http_code}n"
   -o /dev/null; sleep .1; done
Time: 0.153075s Status: 200
Time: 0.137581s Status: 200
Time: 0.139345s Status: 200
Time: 30.291806s Status: 500
Los VirtualServices activan despliegues canarios: en este caso, hemos reducido las posibles consecuencias de los problemas al 20% de la base de usuarios. ¡Excelente! Ahora, cada vez que no estemos seguros de nuestro código (en otras palabras, siempre…), podemos usar el enrutamiento espejo y los despliegues canarios.
Tiempos de espera y reintentos
Pero no siempre los errores están en el código. En la lista de "", el error más común es el de pensar que "la red es confiable". En realidad, la red no es confiable, y por esta razón necesitamos tiempos de espera (timeouts) y reintentos (retries).
Para la demostración, continuaremos usando la misma versión del problema sa-logic (buggy), mientras que la falta de fiabilidad de la red será simulada con fallos aleatorios.
Supongamos que nuestro servicio con errores tiene 1/3 de probabilidad de una respuesta demasiado larga, 1/3 de probabilidad de fallar con un error de servidor interno y 1/3 de probabilidad de entregar la página con éxito.
Para mitigar las consecuencias de tales problemas y mejorar la experiencia del usuario, podemos:
- agregar un tiempo de espera si el servicio responde por más de 8 segundos,
- intentar reintentar si la solicitud falla.
Para implementar esto, utilizaremos la siguiente definición de recurso ():
apiVersion: networking.istio.io/v1alpha3
kind: VirtualService
metadata:
  name: sa-logic
spec:
  hosts:
    - sa-logic
  http:
  - route:
    - destination:
        host: sa-logic
        subset: v1
      weight: 50
    - destination:
        host: sa-logic
        subset: v2
      weight: 50
    timeout: 8s           # 1
    retries:
      attempts: 3         # 2
perTryTimeout: 3s # 3- El tiempo de espera para la solicitud se establece en 8 segundos;
- Los reintentos de las solicitudes se realizan 3 veces;
- Y cada intento se considera fallido si el tiempo de respuesta excede los 3 segundos.
Así logramos la optimización, ya que el usuario no tendrá que esperar más de 8 segundos y haremos tres nuevos intentos de obtener una respuesta en caso de fallos, aumentando la posibilidad de una respuesta exitosa.
Aplique la configuración actualizada con el siguiente comando:
$ kubectl apply -f resource-manifests/istio/retries/sa-logic-retries-timeouts-vs.yaml
virtualservice.networking.istio.io/sa-logic configurado
Y verifique en los gráficos de Grafana que el número de respuestas exitosas ha aumentado a más de:
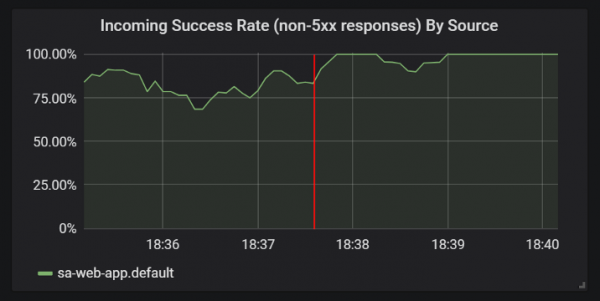
Mejoras en las estadísticas de respuestas exitosas después de añadir tiempos de espera y reintentos
Antes de pasar a la siguiente sección (o más exactamente, a la siguiente parte del artículo, ya que en esta ya no habrá experimentos prácticos — nota del traductor), elimine sa-logic-buggy y VirtualService, ejecutando los siguientes comandos:
$ kubectl delete deployment sa-logic-buggy
deployment.extensions “sa-logic-buggy” eliminado
$ kubectl delete virtualservice sa-logic
virtualservice.networking.istio.io “sa-logic” eliminado
Patrones Circuit Breaker y Bulkhead
Estamos hablando de dos patrones importantes en la arquitectura de microservicios que permiten la autorrecuperación (self-healing) de los servicios.
Circuit Breaker («disyuntor») se utiliza para detener las solicitudes que llegan a una instancia de servicio que se considera no saludable, y su recuperación mientras las solicitudes de los clientes se redirigen a instancias saludables de ese servicio (lo que aumenta el porcentaje de respuestas exitosas). (Nota del traductor: Una descripción más detallada del patrón se puede encontrar, por ejemplo, .)
Bulkhead («tabique») aísla fallos en los servicios del colapso de todo el sistema. Por ejemplo, si el servicio B está roto y otro servicio (cliente del servicio B) hace una solicitud al servicio B, este consumirá su grupo de hilos y no podrá atender otras solicitudes (incluso si no están relacionadas con el servicio B). (Nota del traductor: Una descripción más detallada del patrón se puede encontrar, por ejemplo, .)
Dejaré de lado los detalles sobre la implementación de estos patrones, ya que son fáciles de encontrar en , además de que ya tengo muchas ganas de mostrar la autenticación y autorización, que será el tema de la siguiente parte del artículo.
P.D. del traductor
También puedes leer en nuestro blog:
- «Regreso a los microservicios junto con Istio»: , ;
- «»;
- «».
Fuente: habr.com
